
讓模型自己生成訓練資料、自己改寫提示詞、自己修復程式碼,這條路線被稱為:
遞迴自我改進(Recursive Self-Improvement,RSI)。
但幾乎所有RSI系統都是同一套結構:一個固定不變的改處理程序序,反覆作用於模型。並往往只從Harness、Data或Model RSI的單一視角切入。
為了回應這一難題,CosmosMind聯合史丹佛、伯克利、MIT、清華、北大等十余家海內外高校發佈MetaRSI-v1。
這是全球首個統一Model-RSI、Data-RSI、Harness-RSI的元遞迴架構,能夠改進“自我改進的過程”。
RSI由此進入“平方時代”。
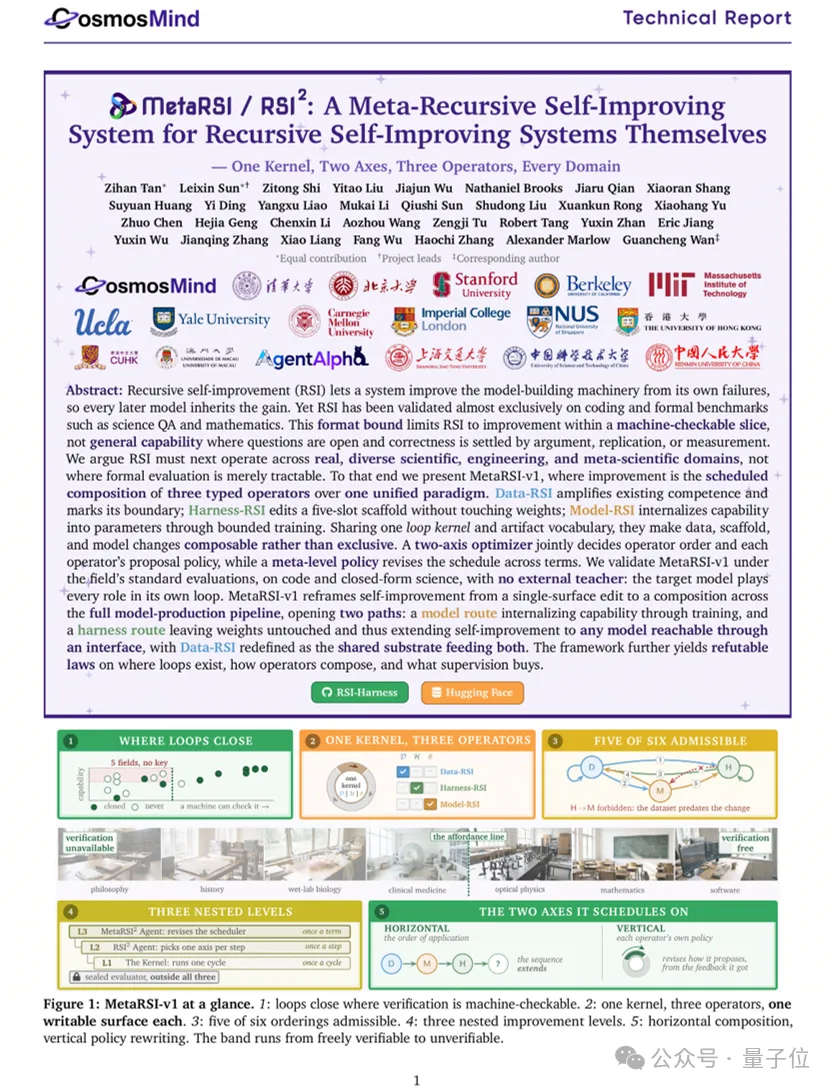
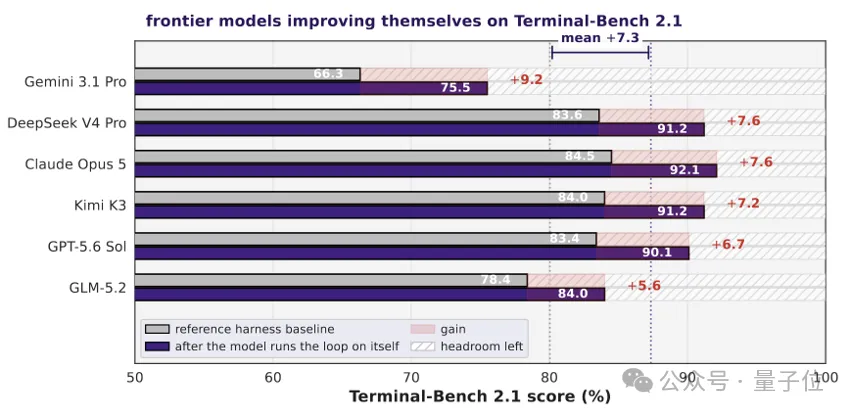
在沒有任何外部教師模型參與下,MetaRSI-v1使得一個僅30億啟動參數的小模型,在四項基準上平均自我提升10.9分;並且讓GPT-5.6、Claude Opus 5等六款前沿旗艦模型,平均提升7.3分。
更重要的是數字背後, MetaRSI-v1是一套試圖統一整個RSI領域的架構語言:包括一個核心、兩條編排軸、三個算子、整個元RSI層,以及五大定律。
首次被統一的Loop Kernel範式
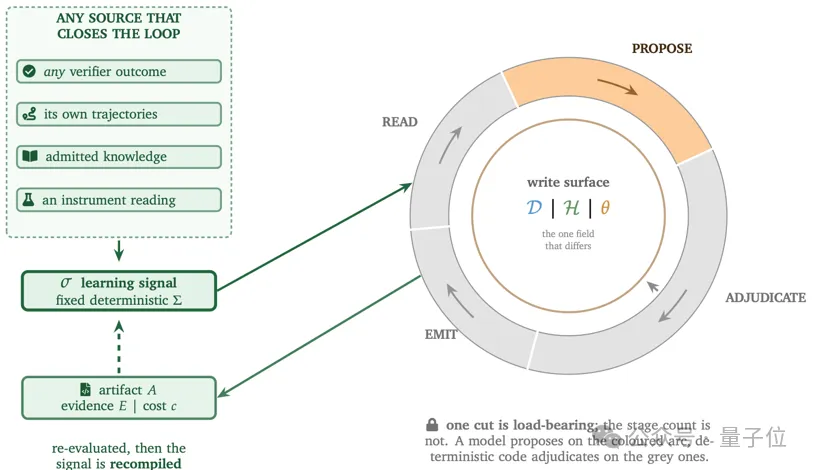
Loop Kernel是MetaRSI-v1首次提出的自我改進統一形式。
它第一次把“進步如何發生”抽象成一條與對象無關的閉環:消費反饋得到的學習訊號,在Data、Harness、Model上提出改動,交由驗證器裁決,並將結果回流為下一輪訊號。
Data、Harness、Model從此開始能夠被統一成同一Kernel的不同實例化算子,可組合、可統一調度,自我改進由此第一次擁有了統一、可復用的底層骨架。
改進空間:Data-RSI、Harness-RSI、Model-RSI
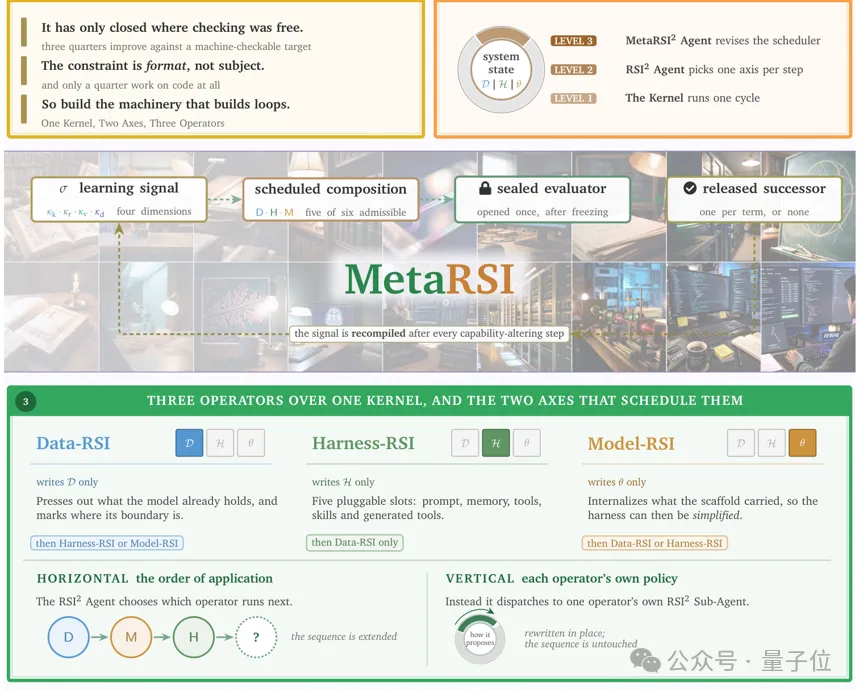
沿用同一個Loop Kernel,自我改進在三個空間上展開,分別由Data-RSI、Harness-RSI、Model-RSI三個算子承擔並協同完成。
- Data-RSI:從自身運行軌跡提取學習訊號,經校驗用於合成資料交由下游消費,標定並放大模型正向能力與負向能力邊界。
- Harness-RSI:利用學習反饋訊號,在Harness拆分出的System Prompt、Skill、MCP、Tools、Memory五個可插拔槽位上生成改進,做加法與減法。
- Model-RSI:更新模型自身的參數與結構,把反覆驗證有效的行為內化進模型。
縱橫之間:讓改進自己找到最優路徑
- 橫軸(horizontal orchestration)編排算子的應用順序:RSI² Agent在每個決策點根據訊號反饋選定下一個算子,再把該算子有機銜接編排送入RSI Loop Kernel執行。
- 縱軸(vertical optimization)最佳化算子的內部策略:RSI² Agent向目標算子專屬的RSI² Sub-Agent下發指令,後者根據學習訊號與環境反饋等改寫算子本身的RSI規則,最佳化RSI系統本身。
遞迴之上的遞迴:三層改進與“元層”的誕生
整套架構由四個Agent協調運作,並且均能被人類專家局部替換形成human-in-the-loop系統。
- MetaRSI² Agent:學習如何進行合適的縱橫最佳化,最佳化RSI² Agent的策略學習。
- RSI² Agent:在每個決策點選擇進行橫軸(指定下一個算子)或縱軸(向Sub-Agent下發策略改寫指令)最佳化。
- RSI² Sub-Agent:在縱向最佳化中,接受來自RSI² Agent的執行指令,對算子內部的RSI策略進行調整。
- Transition Agent:負責銜接橫向編排中上游算子的產物與下一個算子對產物的消費。
四個Agent對應形成三個RSI最佳化Level:算子改進目標系統,雙軸編排改進算子用法,元層改進雙軸編排策略本身。
實驗:小模型與前沿模型均實現自我進化
實驗沿兩條路線展開:
- 小模型路線使用可訓練的開源模型,Data、Harness、Model三個算子全部啟用;
- 前沿模型路線面向Claude Opus 5,GPT-5.6 sol,Kimi K3等頂級模型,這類模型參數巨大或為閉源模型,僅啟用Data與Harness算子。
路線一:小模型的自我改進
目標模型為Qwen3.5-35B-A3B(35B總參、3B啟動),在Terminal-Bench 2.1、SWE-bench Pro、GPQA-Diamond高難度子集、AIME四項基準上評測。
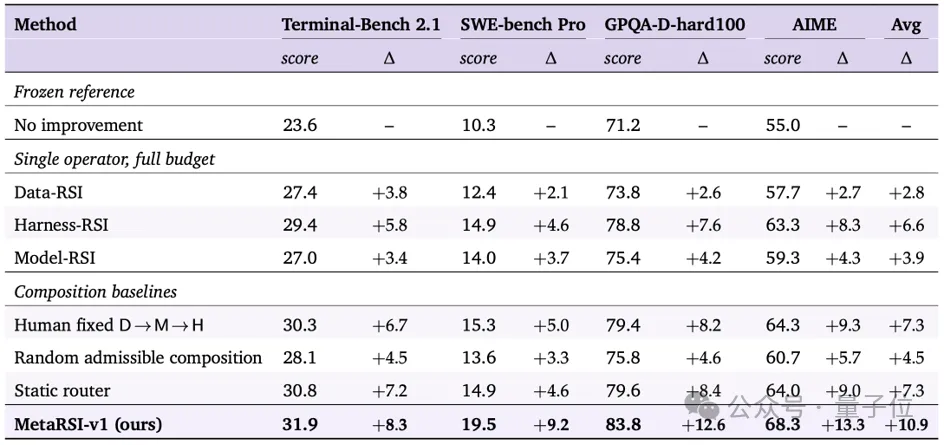
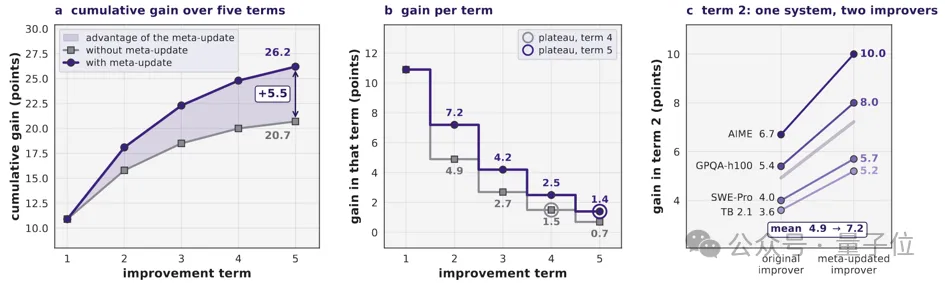
MetaRSI-v1平均提升10.9分,SWE-bench Pro解決率接近翻倍,Meta層為RSI帶來更高的天花板,連續自進化的累計增益提升顯著。
路線二:前沿模型的自我改進
多款前沿模型在Terminal-Bench 2.1上平均提升7.3分,說明MetaRSI範式對前沿模型同樣成立,旗艦模型同樣留有可觀的自我改進空間。
五條定律:為“機器如何進步”立法
MetaRSI梳理出兩條互補的改進路線:Harness-RSI保持權重不變,讓自我改進覆蓋任何可通過介面呼叫的模型;Model-RSI通過訓練把能力內化進模型。
且MetaRSI首次重新定義了Data-RSI,作為模型的能力邊界探測與放大器,通過對執行軌跡與外界反饋learning-signal的聯合分析得到經過驗證的經驗並scale為可復用的資料,並標定這些經驗能夠支撐到那裡,框定模型能力的正、負邊界。
Data-RSI的產物同時供給Harness-RSI與Model-RSI消費,兩條路線的改動結果又能夠流回Data-RSI,重新標定能力邊界、驅動下一輪,能力由此逐輪披露、累積。
在這一過程中,Harness不僅能做加法還能做減法:Data-RSI放大暴露的問題經Model-RSI內化之後,原本吸納在Harness中的知識會變成冗餘,Harness-RSI系統在回放校驗下將其刪除,能力留下,成本退場。
在此之上,MetaRSI提煉出五條定律。
定律一:驗證決定自我改進的前沿。
一個領域能不能形成自改進閉環,取決於該領域任務能否被檢驗,是否有合適的verifier。
定律二:自我認知會過期,重新發現能力邊界是速率瓶頸,RSI改變agent能力,其原本舊的系統描述隨即失效。
定律三:能力與載體無關但成本與載體有關。
例如同一項能力放在Harness裡每次推理都要重付成本,內化進Model只需付一次,成熟循環能夠持續把能力遷移到更便宜的載體。
定律四:可信度由不可寫面度量。
在閉環內部,真正能力變強和放寬成功標準會得到完全相同的分數,而且這種偏差從內部無法察覺、也無法靠統計糾正。
定律五:循環不憑空創造能力,一切增益本質上都是外部資訊熵的輸入或能力的激發。
自改進只能重新組織、放大並固化模型已經具備的潛力。因此每次提升都要分清兩部分:那些是把已有能力放大出來的,那些是真正從外部新引入的。
環環相扣,終成文明:讓每個科學領域都擁有進化閉環
人類歷史每一次的躍遷,都源於“生產答案的方式被重新發明”。
MetaRSI要在AI時代把這件事再做一遍。
它背後的CosmosMind團隊,是一支由清華/北大/史丹佛等海內外名校碩博、頭部大廠基模核心組研究員、著名產業方領軍人物組成的小而精的團隊,長期從事大規模模型訓練/RSI/智能體/科學計算等工作,在頂會頂刊上發表過諸多有影響力的論文。
這一次,他們沒有選擇再做一個更大的模型,而是把全部精力押在了“改進改進本身”這件事上。
團隊同步了開源RSI-Harness,這是一個能自我學習、自我迭代的Harness,並可以在使用中為不同科學領域與工程實踐沉澱出可移植的Harness Genome。
Cosmosmind已經把目光投向了閉環觸碰物理世界:可程式設計儀器、自動化實驗室成為執行器和驗證器,模擬、台架實驗、真實儀器可以像三級火箭一樣逐級推進,把不可逆的昂貴操作放到最後——第一個在物理世界關上的進化循環,很可能不會出現在開放環境裡,而會出現在自動化實驗室中。
研究者面對的不再是一堆待驗證的猜測。人類只需負責定義問題與價值判斷,而機器負責讓“從假設到驗證”的循環,以過去無法想像的速度開始轉動。
相信在MetaRSI的後時代,AI將會從解題工具走向文明級的進化引擎。 (量子位)