
中國99%的普通磨床的批次加工精度只能維持在1微米左右,根本無法進入高端算力供應鏈。
全球大模型持續迭代,驅動著AI算力規模呈指數級擴張,萬卡、十萬卡等級智算叢集加速落地。隨著800G/1.6T高速可插拔光模組大規模普及,高速叢集互聯成為算力釋放的核心瓶頸。在光通訊產業鏈中,行業目光大多聚焦於光模組、CPO共封裝等熱點賽道,而MPO多芯跳線卻常常是容易被忽略的一環。但高密度、低損耗的MPO多芯光纖跳線,恰恰是支撐高速算力網路的關鍵基石,AI伺服器需要配套大量MPO跳線完成GPU之間、伺服器與交換機之間的資料互動,因此它的性能與良率同樣卡住了整個光通訊速率提升的脖子。
今年8月,輝達正式宣佈其Spectrum-X乙太網路矽光交換機進入全面量產階段。這是全球首款量產的200G/lane共封裝光學(CPO)交換機系統。官方給出的資料頗為亮眼:與傳統可插拔光模組方案相比,雷射器數量減少75%,整機功耗降低約80%,平均故障間隔時間提升10倍,鏈路損耗從最高約22分貝壓到約4分貝。隨著CPO共封裝光學架構的產業化推進,將新增海量的機箱內部光互聯場景,進一步打開MPO及微型MT類連接器的成長天花板,將其推向了市場加速爆發的風口。
2026年,業內普遍將這一年定義為“CPO量產元年”。當光引擎與交換晶片封裝在一起、當光纖從機櫃外部走到機櫃內部甚至走進封裝時,那些負責把幾十根光纖精準對接起來的連接器件的需求量也在不斷攀升。但就是這麼一個看似不起眼的MPO連接器,其製造難度極大,這其中涉及整個光通訊產業鏈,而在鏈上最不起眼、也是最關鍵的一環,是一根直徑只有0.1263毫米的細針。
01. 為什麼AI算力叢集離不開“光”?
說到AI算力,就不能不提GPU。很多人以為GPU就是承載AI算力的最終載體,卻忽略了關鍵:一塊GPU並不能撐起AI算力需求。AI算力的本質,是成千上萬張GPU協同工作。一張卡再強,如果卡與卡之間的資訊傳不過去,叢集就是一堆昂貴的擺設。
如今,萬卡叢集已經屢見不鮮,十萬卡甚至更多卡的叢集也在不斷湧現。萬卡、十萬卡等級的GPU叢集,依靠的是成千上萬台伺服器之間的協同工作。如果伺服器之間的資料傳輸跟不上,再強的GPU也只能空轉。對此,西安拽亙弗萊工業自動化科技有限公司(DragonflyAutomationSoftware,以下簡稱“DAS”)董事長、國家“千人計畫”專家何衛東表示,“現在的AI算力已經進入到光通訊賽道的角逐,叢集算力效應受到了頻寬的瓶頸制約。”
通訊用什麼?過去很長一段時間,資料中心內部大量使用銅纜。但銅纜有一個天生的短板——只適合短距離傳輸,“在幾個釐米以內,銅的訊號傳輸確實比較穩定,但長距離就不行了。”何衛東指出。在AI算力叢集動輒跨越整棟資料中心的規模下,銅纜的傳輸損耗和體積重量都成為致命約束。
光纖的優勢是壓倒性的。頻寬可達數十THz級,傳輸損耗低至約0.2dB/km,中繼距離可達數十公里,不受電磁干擾,體積重量僅為銅纜的零頭。更重要的是,AI叢集需要的不再是一根光纖,而是一束光纖。
傳統的資料傳輸場景,一根光纖就夠了。但AI算力叢集中,單台GPU伺服器的MPO跳線配比可達1:3,三層互聯僅MPO線纜就需超過2.4萬根。一根光纖承載不了一個萬卡叢集的通訊需求。行業正在從單芯光纖走向多芯光纖,8芯、12芯、16芯,“未來還將走向32芯、64芯。”何衛東強調道。
根據LightCounting的統計,2025年全球光模組及相關產品銷售額達到268億美元,同比增長74%;2026年第一季度,光模組和AOC銷售額約100億美元,同比大漲90%。工信部《高速光模組產業發展白皮書》則預計,2026年全球1.6T光模組市場規模將達45億美元。國內廠商在其中的份量越來越重,2026年上半年,中際旭創營收同比增長182%,新易盛增長100%,這條產業鏈的景氣度已經用財務報表驗證過了。
而在光模組之後,另一條極具爆發力的賽道,MPO光纖連接器,正在被同樣的力量推到台前。多芯光纖的連接,靠的就是MPO連接器(多芯推入式連接器)。一個MPO插頭可以同時對接12、16、24、32,甚至64根光纖,把幾十路光訊號的精準對接壓縮到一個指甲蓋大小的介面裡。在800G、1.6T光模組時代,傳統單芯連接器(如LC)已經無法滿足密度和布線需求,MPO光纖跳線成了AI資料中心、葉脊網路、CPO、NPO架構的“唯一標準化高速互聯介面方案”。
市場研究機構GlobalGrowthInsights的資料顯示,2025年全球MPO光纖連接器市場規模約10.4億美元,預計2026年達12.4億美元,2035年將增至58.4億美元,年複合增長率約18.8%,其中超過65%的需求來自AI資料中心的升級。
市場反應也印證了MPO的火熱。今年1月,康寧與Meta簽署了一份多年期、價值高達60億美元的協議,向Meta供應光纖、光纜及連接解決方案;6月,國內企業中天科技公告中標某網際網路企業資料中心MPO光纖跳線集采項目,金額約15.18億元。
AIDC行業的“光進銅退”已經不只是趨勢,而是正在發生的現實。
"算力叢集的競爭,正在從單卡算力的比拚,轉向系統互聯效率的比拚。"何衛東表示,"過去十幾年我們在高端裝備控制系統上做的所有積累,本質上都在解決同一個問題——把高端裝備的核心控制和工藝定義權,從國外廠商手裡拿回來。MPO超低損細針磨床不是一次偶然的跨界,而是這條主線走到今天,恰好遇上了AI算力給出的歷史性窗口。"
02. 一根針卡住了叢集算力的發展
如果說MPO連接器是AI算力叢集的“路口”,那麼MT插芯就是這個路口的“地基”。
MT插芯是MPO連接器內部的核心零件,一塊指甲蓋大小的精密塑料或陶瓷件,上面密佈著12~64個光纖微孔。光纖從這些微孔中穿過,完成精準對接。
而這些微孔並不是“鑽”出來的,而是“注”出來的。生產過程中,一組極細的金屬針被固定在模具型腔內,熔融的塑膠或陶瓷材料填充模具、包裹住針,等材料固化後把針拔出來,針留下的痕跡就是光纖微孔。而這根針行業內稱為“細針”。
細針的直徑只有0.1263毫米(跟頭髮絲粗細相當)。而它的精度要求,是直徑公差、圓度、圓柱度全維度≤0.2微米,表面粗糙度Ra≤0.02微米。0.2微米是什麼概念?1毫米的五千分之一,大約是普通紙張厚度的五百分之一。
為什麼需要這麼高的精度?因為在800G、1.6T的AI高速傳輸場景下,光訊號傳輸速率呈指數級提升,細針精度的微小偏差會被無限放大。0.2微米級細針可以把MPO插損控制在0.15dB以內;而一旦精度掉到0.3微米以上,插損就會超標,無法適配高速算力場景。
在低速傳輸時代,微孔的些許偏差可以通過後期研磨、端面微調來彌補,民用寬頻對插損的容忍度也寬裕得多。但AI叢集不一樣。萬卡規模的GPU靠海量光訊號平行調度,傳輸頻率極高、頻寬極大,多芯光纖裡只要有一路損耗超標,整個叢集就會出現串擾、誤碼,輕則降頻卡頓,重則斷聯停機。
行業也對細針精度有著一套專屬的分級標準:大於1微米則只能用於民用寬頻;0.3到0.8微米是“商用級”,只能用於400G及以下的普通資料中心;≤0.2微米才能適配800G/1.6T智算中心。
三個等級之間,市場價值天差地別。DAS董事總經理韓煒介紹,一根普通民用細針的市場售價也就是幾十元,然而精度小於0.2微米應用於AI光通訊算力的細針竟可以達到數百元。“這個價格買的就是那0.2微米以內的超高精度。”韓煒如是說。
而這,恰恰指向了整條產業鏈上最上游、也最容易被忽視的一環:能把一根硬質合金棒料磨成0.1毫米直徑、0.2微米精度細針的超精密磨床。
高精密磨床在機床體系裡的地位本身就特殊。車、銑、刨、磨,磨是最後一道工序,只有精度要求極高的工件才會上磨床,它因此被業內稱作“工業母機皇冠上的明珠”。而MPO細針磨床所需求的超高奈米級精度磨床則是其中最耀眼的一顆。
要在比頭髮絲般粗細的鎢鋼棒料上,把直徑公差、圓度、圓柱度、刃口跳動全部控制在0.2微米以內,表面粗糙度Ra不超過0.02微米。0.2微米大約是一張普通紙厚度的五百分之一。熱脹冷縮、砂輪磨損、主軸震動,任何一個環節出現微小偏差,精度就歸零,磨床必須全程恆溫恆濕,砂輪需要線上修整、線上檢測,溫度要做全域補償。韓煒坦言:“這個精度已經進入了奈米級精度等級,即便是國際最高水平的頂級磨床,良品率也是行業公認的難題。”
其次是陣列一致性的問題。MPO細針是12到64根形成陣列,任何一根針的偏差都會導致整組報廢。這對磨削演算法和運動控制提出了極高的協同要求。
最難的還不是硬體,是核心的“大腦”。高精密磨床的數控系統、磨削模擬演算法、運動控制補償演算法、CAM工藝軟體,才是真正的技術核心。國內絕大多數高精密磨床的數控系統都依賴西門子、FANUC、NUM等海外品牌,由於它們均屬於標準化系統,因此在0.2微米級應用場景下無法針對MPO陣列加工深度定製。
目前全球能夠穩定量產0.2微米級細針的超精密磨床,長期被瑞士、德國、美國及日本等少數國家的裝備廠商壟斷。進口裝置單價400到550萬元。同時,當下光通訊賽道熱度高漲,產品供不應求,進口裝置交付周期都超過1年,數控系統和核心演算法全部閉源。而國內99%的普通磨床的批次加工精度只能維持在1微米左右,根本無法進入高端算力供應鏈。
03. 國產磨床的18年長跑
就在高端磨床都被國際巨頭壟斷的困局下,DAS實現了破局。
2026年9月9日,在第26屆中國國際光電博覽會(CIOE)開幕當日,DAS宣佈其自主研發的NanoGrind-N200超精密陣列細針專用磨床已實現批次交付,成為國內少數可穩定量產0.2微米級MPO細針的高端磨床裝備。
這一切,要從一場“機緣巧合”講起。
2008年,國內最大的硬質合金刀具企業某國企鎢業集團面對一個現實:每年從國外採購頂級磨床要花十幾億到二十幾億元,刀具行業用來加工車刀、銑刀、鑽頭的裝置全部依賴進口。於是這家國企萌生了國產化替代的念頭,買回國外磨床整機拆解、測繪、1:1仿製。硬體可以仿製,但軟體和演算法難以復刻,於是該國企找到了當時一直深耕高端數控系統研發的DAS團隊,請其承擔“逆工程”的角色,推導裝置的核心控制邏輯和演算法,實現頂級國外磨床的國產化替代。
在合作的七八年過程中,雙方先後聯合攻關了包括五軸高精密刀具磨床在內的五種高端磨床。更重要的是,DAS因此成為國內極少數掌握高精密磨床核心控制軟體和工藝的廠商,而這才是DAS核心的競爭力,市面上絕大多數國產磨床的數控系統都依賴西門子、FANUC等海外品牌整合,沒有自主的“大腦”,就無法實現工藝的自主迭代。
2025年前後,AI算力以及光通訊的爆發將MPO陣列細針這一個全新的應用場景送到了這台裝置面前。原本這台磨床的目標客戶是刀具行業,市場相對小眾;但現在,精度要求更高的光通訊細針需求讓DAS研發的高精密磨床有了用武之地。團隊又經過了大約一年半的技術與磨削精度的持續迭代,在2026年實現了批次交付。DAS專為MPO超低損細針定製的NanoGrindN200的超精密專用磨床:可穩定研磨直徑0.1263毫米的細針,公差控制在±0.1微米,真圓度控制在0.2微米以內,達到超低損MPO細針的量產水準。
值得一提的是,與國外動輒400~550萬一台的磨床裝置相比,
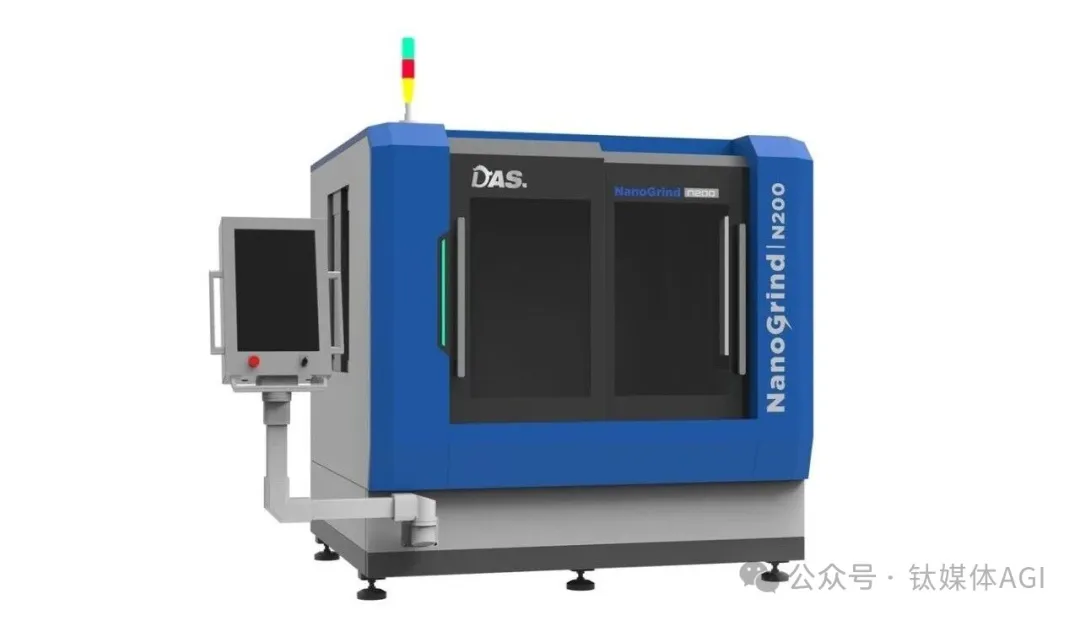
將裝置單價大幅拉低,且交付周期也從1年以上,縮短到了3個月左右。在良品率方面,韓煒教授也如實指出,目前即便全球最頂級的Rollomatic磨床,在奈米級精度這個等級,成品率同樣都是巨大的挑戰,微米以下的世界裡,一點震動、一絲溫漂都是致命的。全球的優秀磨床廠商目前都將目光聚焦到這個賽道,不斷實現技術突破,提升機器的精度和性能。
DAS在國內少數具備量產能力的的磨床也體現在了業務增長上。據韓煒介紹,DAS今年上半年磨床業務增長了863%,裝置已經交付部分國內頭部MPO廠商(受行業敏感性限制,客戶資訊暫處於保密階段),其終端產品最終流向輝達、康寧、台積電等全球產業鏈的核心玩家。產能同樣供不應求,全年的排產已被訂完。
當然,磨床雖然是MPO連接器最大的卡點,但除細針磨床之外,產業鏈還有另一個關鍵裝置是日本沙迪克(Sodick)的高精密全電動注塑機(負責把熔融樹脂以微米級精度注射進模具),單台價格150~200萬元以上,如今其產能同樣被頭部廠商壟斷,國內廠商技術水平尚有差距,還無法實現整機的國產化替代。據韓煒教授介紹,DAS已就此啟動技術調研,憑藉注塑控制軟體和工藝等核心技術多年的積累,不排除未來切入這第二個堡壘的可能。
把視線再放遠一點,這個故事的意義不止於一家公司。CPO的量產只是開始。根據TrendForce等機構的預測,CPO在2026年的滲透率約為0.5%,2027年預計放量至20萬到30萬台,2028到2029年進入大規模商用階段。每一台CPO交換機內部新增的數百顆插芯、每一個新建智算機房裡數以萬計的細針需求,都在沿著“磨床、細針、插芯、跳線”這條精度逐級傳遞的鏈條,向最上游傳導壓力。而這條鏈路的規律從未改變:下游組裝門檻低、競爭激烈,越往上遊走,玩家越少、壁壘越高、利潤越厚。誰掌握了這個精度上限,誰就握住了整條光通訊產業鏈的能力邊界。
"MPO細針只是一個起點。"何衛東表示,"當CPO真正進入大規模商用,光互聯會像今天的電源管理一樣,滲透進每一台計算裝置的內部。DAS要做的,是在這條精度鏈條的最上游,為中國的光通訊產業守住一個可靠的支點,讓世界看到來自中國的高端工業控制產品。"
受訪企業背景介紹
DAS成立於2011年,總部及研發中心位於西安高新區,是專注於工業自動化高端裝備與核心控制系統研發及國產化替代的國家高新技術企業。公司由國家重大人才工程入選者("千人計畫")、資深控制系統專家何衛東,與陝西省高層次海外歸國留學人員韓煒教授共同創立,現有員工百餘人,研發人員佔比超過40%,累計擁有自主智慧財產權130余項,並在常州、湖州、廈門等地建有多個生產基地。 (鈦媒體AGI)