
過去幾周發生了不少事。我想現在大家最關心的,應該就是 OpenAI 的 GPT-6 Astra——尤其是它的性能表現、循環 Transformer(循環深度)這一部分,以及關於 Astra 在“隱藏”自己推理軌跡(也就是思維鏈)的傳聞。
所以在這篇文章裡,我想先談談對 Astra 的一些初步印象,以及我對這一切走向的看法。接著,我會詳細講講 “循環 Transformer” 到底是什麼,以及它與隱藏思維鏈有什麼關係——或者說,究竟是否有關係。
最後,在介紹完循環 Transformer 的基礎原理之後,我還想分享近期相關研究論文中的一些新見解。
1. GPT-6 Astra 初印象
先說最要緊的。在進入架構傳聞和相關研究文獻之前,我先簡單總結一下自己對 GPT-6 Astra 的一些觀察和零散發現。
上周,OpenAI 的新模型 GPT-6 Astra 高調發佈。過去幾天我一直在用它,它確實是個非常出色的模型,大概是我寫下這篇文章時用過最好的一個。那麼,它究竟提升了什麼,又是怎麼做到的?
1.1 Astra 的基準測試
Astra 是我目前用過最好的模型,而且它在 3D 渲染和動畫任務上好得有點“不成比例”(相對於其他模型而言)。我的意思是,它雖然在幾乎所有類別上(寫作、數學、程式設計等等)都超越了前代 GPT-5.6,但在圖形類演示上的領先尤其明顯。
這一點在基準測試裡也能看到。比如 GPT-6 Astra 在數學和程式設計上表現相當強,如下圖所示。
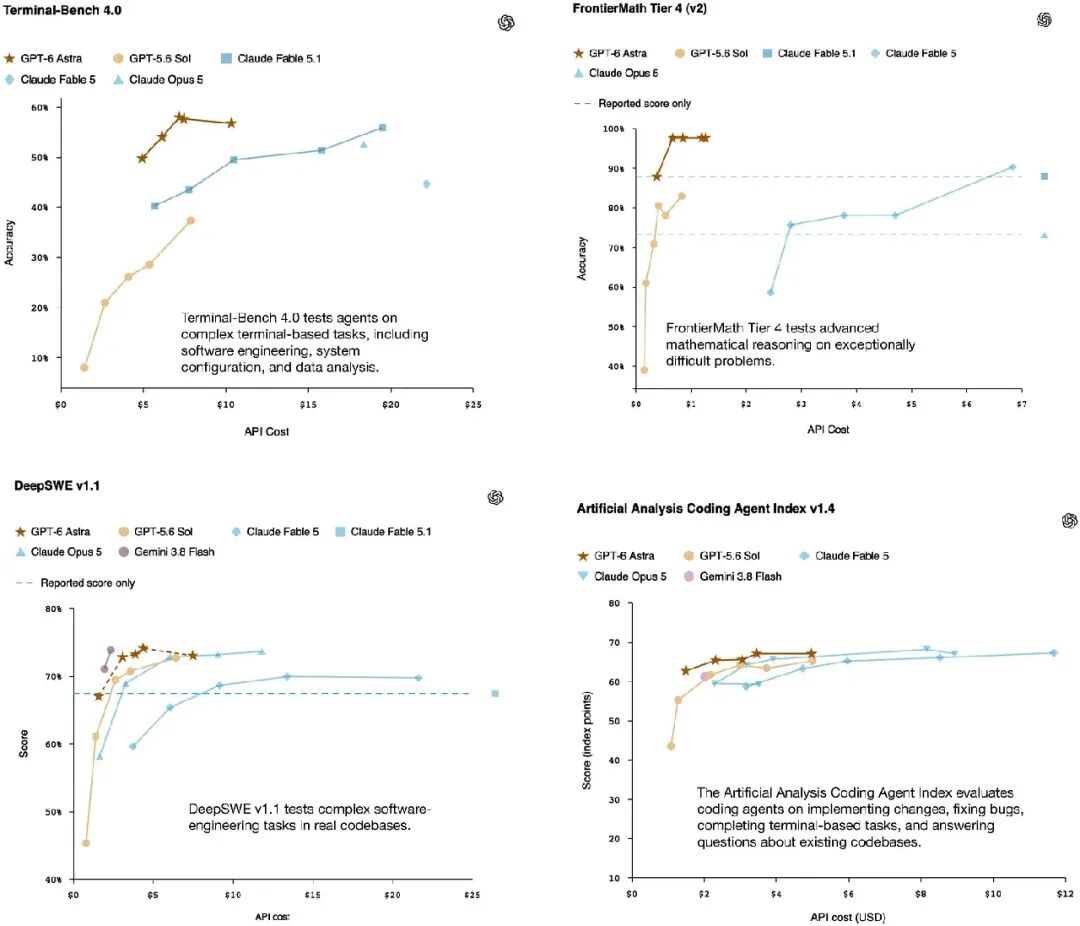
其中一個亮點(圖中未展示)是,Astra 在 ARC-AGI-3 基準上拿到了 99.9%(GPT-5.6 Sol 只有 7.8%),這個基準衡量的是解邏輯謎題與泛化能力的綜合表現。不過,數學、程式設計和電腦操作類基準更有意思,因為它們更接近真實使用場景。
回到前面那張圖右下角的 Artificial Analysis 程式設計智能體指數 v1.4,它混合了多項智能體程式設計任務。可以看到,GPT-6 Astra 明顯處在前沿,但並沒有大幅拉開差距。這一點在下面這個更綜合的 Artificial Analysis 智能指數中也能看到,該指數混合了不同類型的任務,而不只是程式設計任務。
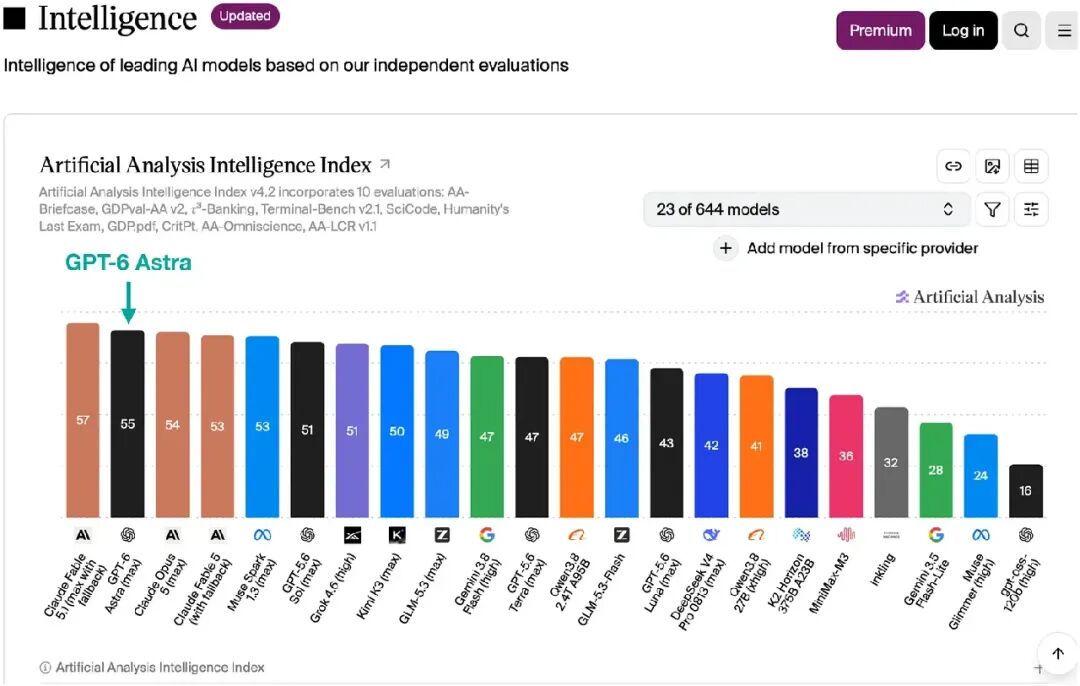
Artificial Analysis 這類基準最大的優勢在於它們是獨立第三方,因此可能比模型開發方自測的基準更可信一些。
harness 的搭建方式取決於具體基準。比如 GDPval-AA 和 AA-Briefcase 在對比不同 LLM 時,統一使用他們開放原始碼的極簡 harness Stirrup。在上面展示的智能指數 v4.2 中,Terminal-Bench v2.1 用的是 Terminus 2,τ³-Banking 用的是 τ-Bench harness。單獨的程式設計智能體指數還專門對比了不同的程式設計智能體 harness。
對於共用同一 harness 的評測,模型之間的對比更接近“同一標準下的比較”。同時,模型在訓練階段通常會以某一個主力 harness 為目標來開發(在其他 harness 上的微調較少)。而且,主力 harness 往往也是為了貼合併放大該模型的長處而設計的。
所以,有些智能體類評測可能低估了 Astra 在它自己主力 harness 下的表現。這對它的智能指數分數影響有多大,需要在相同任務上跨 harness 對比 Astra 才能知道。
順帶一提,正如一位同事最近向我建議的(Claude Code 負責人也有類似建議),把你現有的AGENTS.md內容和SKILL.md檔案刪掉(或歸檔)一部分,或許並不是壞主意——新一代 LLM 在理解提示和解決手頭問題上已經更高效了。額外的“手把手”說明可能會不必要地束縛新模型,反而帶來更差的結果。
當然,我不是說以後再也不用SKILL.md檔案了。對某些工作流來說,復用這些檔案確實能提升效率,模型不必每次都重新摸索一遍。我想說的是,有些工作流其實不需要描述,而“舊”的描述可能已經不再是最優的,LLM 或許能給出更好的方案。所以,也許是時候更新或重新生成這些說明檔案了。
1.2 電腦操作能力
GPT-6 Astra 在圖像和渲染任務上似乎格外強。當這些任務涉及與圖形介面互動時,也就同時體現出了電腦操作(computer use)能力——即模型通過 Codex/ChatGPT 應用來操作你本地電腦上的軟體。
電腦操作是這個模型相比其他模型真正出彩的地方,而且任何與圖形相關的東西都很適合做成社交平台上直觀、有意思的演示。網上已經有大量令人印象深刻的例子,從用 Blender 渲染紐約市,到虛擬看房導覽。
舉一個例子,下面這段對比裡,我讓 GPT-6 Astra 的 Medium 和 High 兩檔用我電腦上的滑鼠,在網頁版 MS Paint 裡重畫我的一張照片(沒用 Extra High 和 Max,因為不想把 token 全花掉 :))。
這不僅展示了模型的作畫能力,更重要的是它使用你電腦上工具的能力(這裡是 Paint,你可以看到模型通過滑鼠游標操作介面)。
這並不是第一個能在 harness 內實現通用電腦操作的模型。比如從今年早些時候起,我就用 GPT 模型完成過一些介面類任務(例如在 Excel 裡處理報銷相關的事情)等等。不過,電腦操作是一項相對新的能力,由 harness 提供支援,用起來通常還感覺不太成熟。這也說得通:LLM 本質上是文字模型,所以更容易摘到的果子自然是寫作、程式設計、呼叫 API 和命令列。
同時,還有很多工具和軟體(目前)並不提供命令列介面,與其等著有人來設計這個介面,不如直接提升模型操作圖形介面的能力(而且如前所述,這樣的演示本來就好看又抓人)。這有點像正在興起的人形機器人。誠然,人形機器人並不是最高效的機器人,比如在已有專用裝置的流水線上;但它們足夠通用。
所以我預計,接下來幾個月(或幾年)也會是電腦操作在 LLM 和智能體 harness 這兩層上不斷打磨的時期。也就是說,除了現有能力以及繼續擴展數學和程式設計能力之外,模型的訓練會越來越多地把電腦操作考慮進來。這也會讓 LLM 在科技圈之外的日常電腦任務中更容易被用起來(“嘿 ChatGPT,幫我報個稅吧” :))。
1.3 電腦操作的訓練
電腦操作這個趨勢,也和最近的報導相吻合——OpenAI 為強化學習採購了數萬台 Mac Mini 和 Mac Studio。所以這些 Mac 並不是真的用來訓練模型(那件事更適合用 GPU),而是在模型訓練期間把 macOS 暴露給模型,讓模型學會使用這個作業系統以及其中的工具。
那麼,在這些 Mac 上的電腦操作訓練是怎麼進行的?簡單說,Mac(更準確地說是它們的 macOS 作業系統)充當一個環境,模型在訓練過程中可以與之互動。
基本流程如下:
- 給模型一個任務作為提示,比如“打開某個應用 xyz 並完成 abc”。
- 向它提供 macOS 介面的截圖(這通常由 harness 完成)。
- LLM 隨後預測滑鼠 / 鍵盤動作(點選、按鍵、滾動等)。
- 在 Mac 上執行這些動作(同樣由 harness 完成)。
- 執行上一步動作之後,把更新後環境的新截圖喂給模型。
- 重複第 2–5 步,直到任務成功或失敗。
- 把成功 / 失敗訊號和驗證器(或評分器)作為訓練反饋,包括在後訓練階段引入強化學習;這與常規的 “可驗證獎勵強化學習”(RLVR)類似。
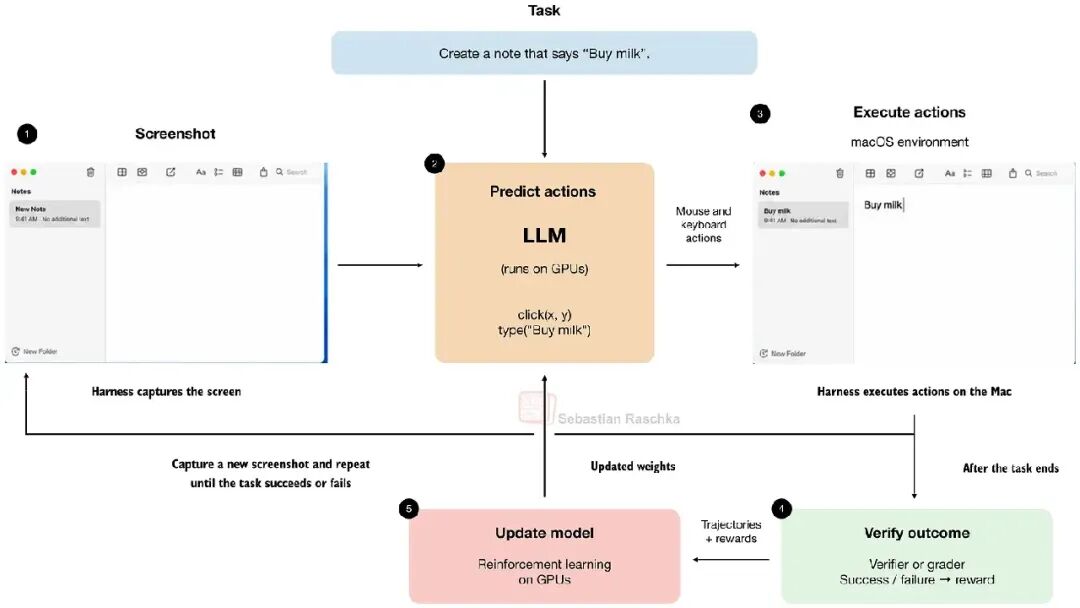
再強調一次,這裡的 Mac 主要是環境,而不是訓練期間運行或更新模型的機器。模型很可能跑在 NVIDIA 的 GPU 上,再通過 API 與這些 Mac 互動。順帶一提,NVIDIA 的 CEO 提到,GPT-6 Astra 是在約 10 萬塊 Grace Blackwell GPU 上訓練的。
1.4 GPT-6 Astra 仍然是推理模型
上一節講的以電腦操作為重點的訓練,並不是訓練流程上的根本範式轉變。GPT-6 Astra(以及可預見未來的幾乎任何 LLM)仍然是推理模型。這意味著這個 LLM 依然用可驗證獎勵強化學習(RLVR)來訓練,並會產生中間推理軌跡(思維鏈)。
不過,關於 GPT-6 Astra 作為推理模型的部分(特別是隱藏思維鏈),我會在本文後面再討論。
2. 循環 Transformer
話說回來,在模型正式發佈前大約兩天,新聞雜誌 The Information 發表了一篇文章,援引一些內部消息稱,Astra 使用了一種叫做“循環深度”或“循環 Transformer(looped transformers)”的概念。
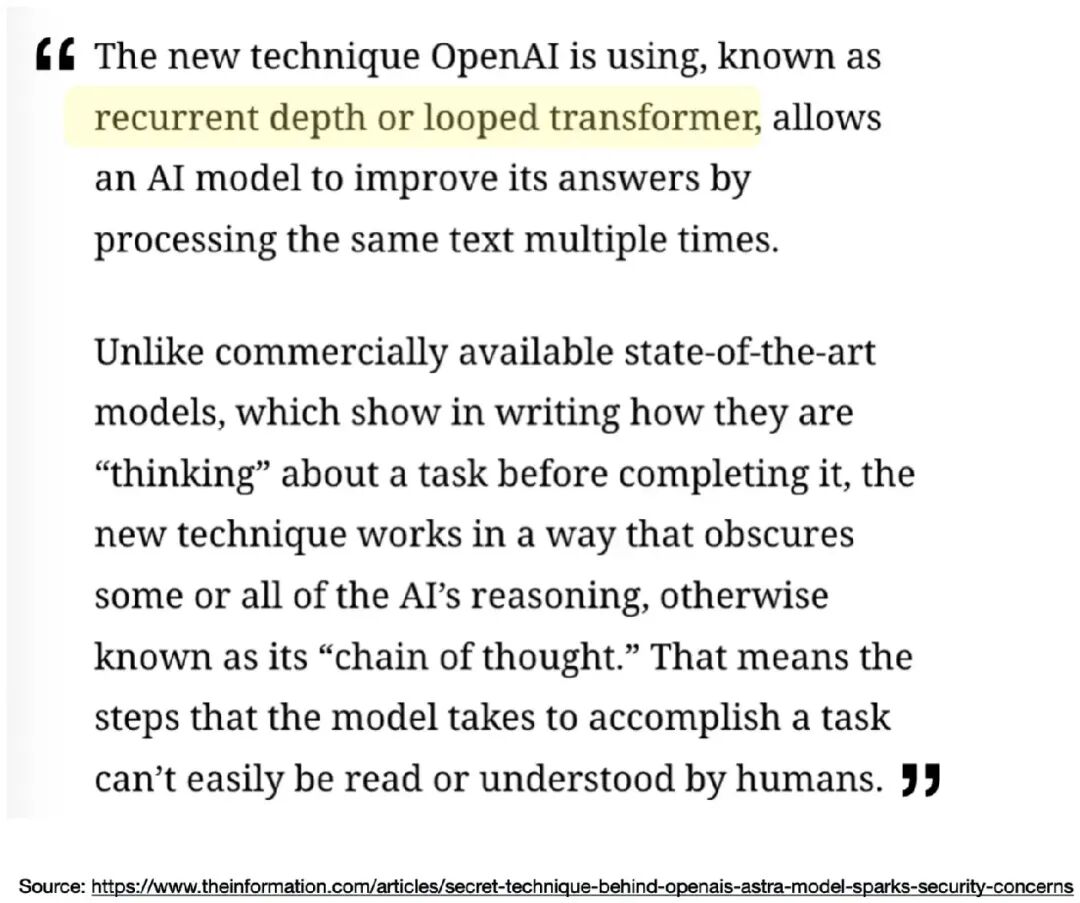
接下來幾個小節裡,我會先解釋什麼是循環 Transformer,關於隱藏思維鏈的那段說法留到本文後面再談。
(循環 Transformer 的解釋可能顯得有點長,但我確實認為它有助於建立對這項技術的基礎理解,而這對判斷 “它掩蓋了推理軌跡或思維鏈” 這一說法很有用。)
2.1 復用 Transformer 模組
那麼,什麼是循環 Transformer?
循環 Transformer 本質上是一處架構上的小改動,核心思想是讓中間表示多次(而不是只一次)經過同一批 Transformer 模組。與單純增加模組數量相比,這裡的 “ 竅門” 在於:這些模組的權重在多次經過時保持不變。
術語與說明
本文會用到以下術語:
- Transformer 模組(transformer block):包含注意力、前饋模組、歸一化和殘差連接的單元。論文中常稱為 "Transformer 層 "。
- 堆疊(stack):指一串順序排列的 Transformer 模組。
- 模組應用(block application):指輸入資料經過一個 Transformer 模組一次。
循環 Transformer 並不是新東西,這個基本思路早在 2018 年的Universal Transformers論文裡就出現過。不過在討論 Universal Transformer 之前,我們先從一個更簡單的例子說起,Nanbeige4.2-3B,這是今年七月發佈的一個開放權重 LLM。
下圖中的 Nanbeige 架構,看起來基本就是個常規 Transformer。不過請注意,它多了一條(橙色)箭頭,繞回到 Transformer 堆疊的起點。
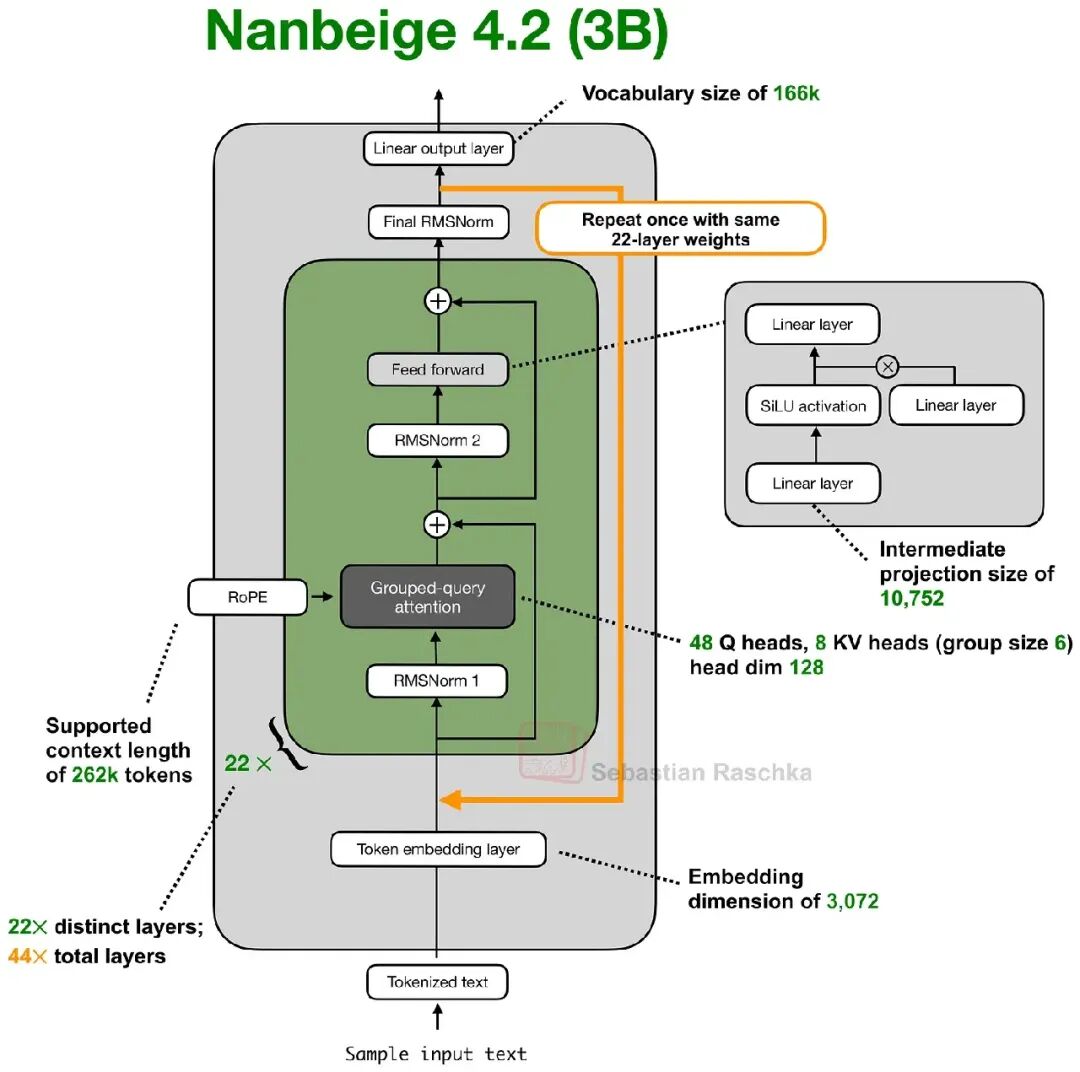
我們從下往上過一遍。首先,和其他基於 Transformer 的 LLM 一樣,輸入文字先被分詞,再轉成嵌入向量。這些向量接著經過 22 個 Transformer 模組,每個模組都有自己的權重。
而這裡的循環之處在於:第一遍走完之後,隱藏狀態會被送回這同樣的 22 個模組。也就是說,模組 1 再被應用一次,接著是模組 2,一直到模組 22。
如果把這個計算展開,總共是 44 次模組應用。不過,與擁有 44 個各自獨立模組的常規 Transformer 相比,後 22 次模組應用復用的是前 22 個模組的權重。例如,第 23 次模組應用用的是模組 1 的權重,第 24 次用的是模組 2 的權重,以此類推。
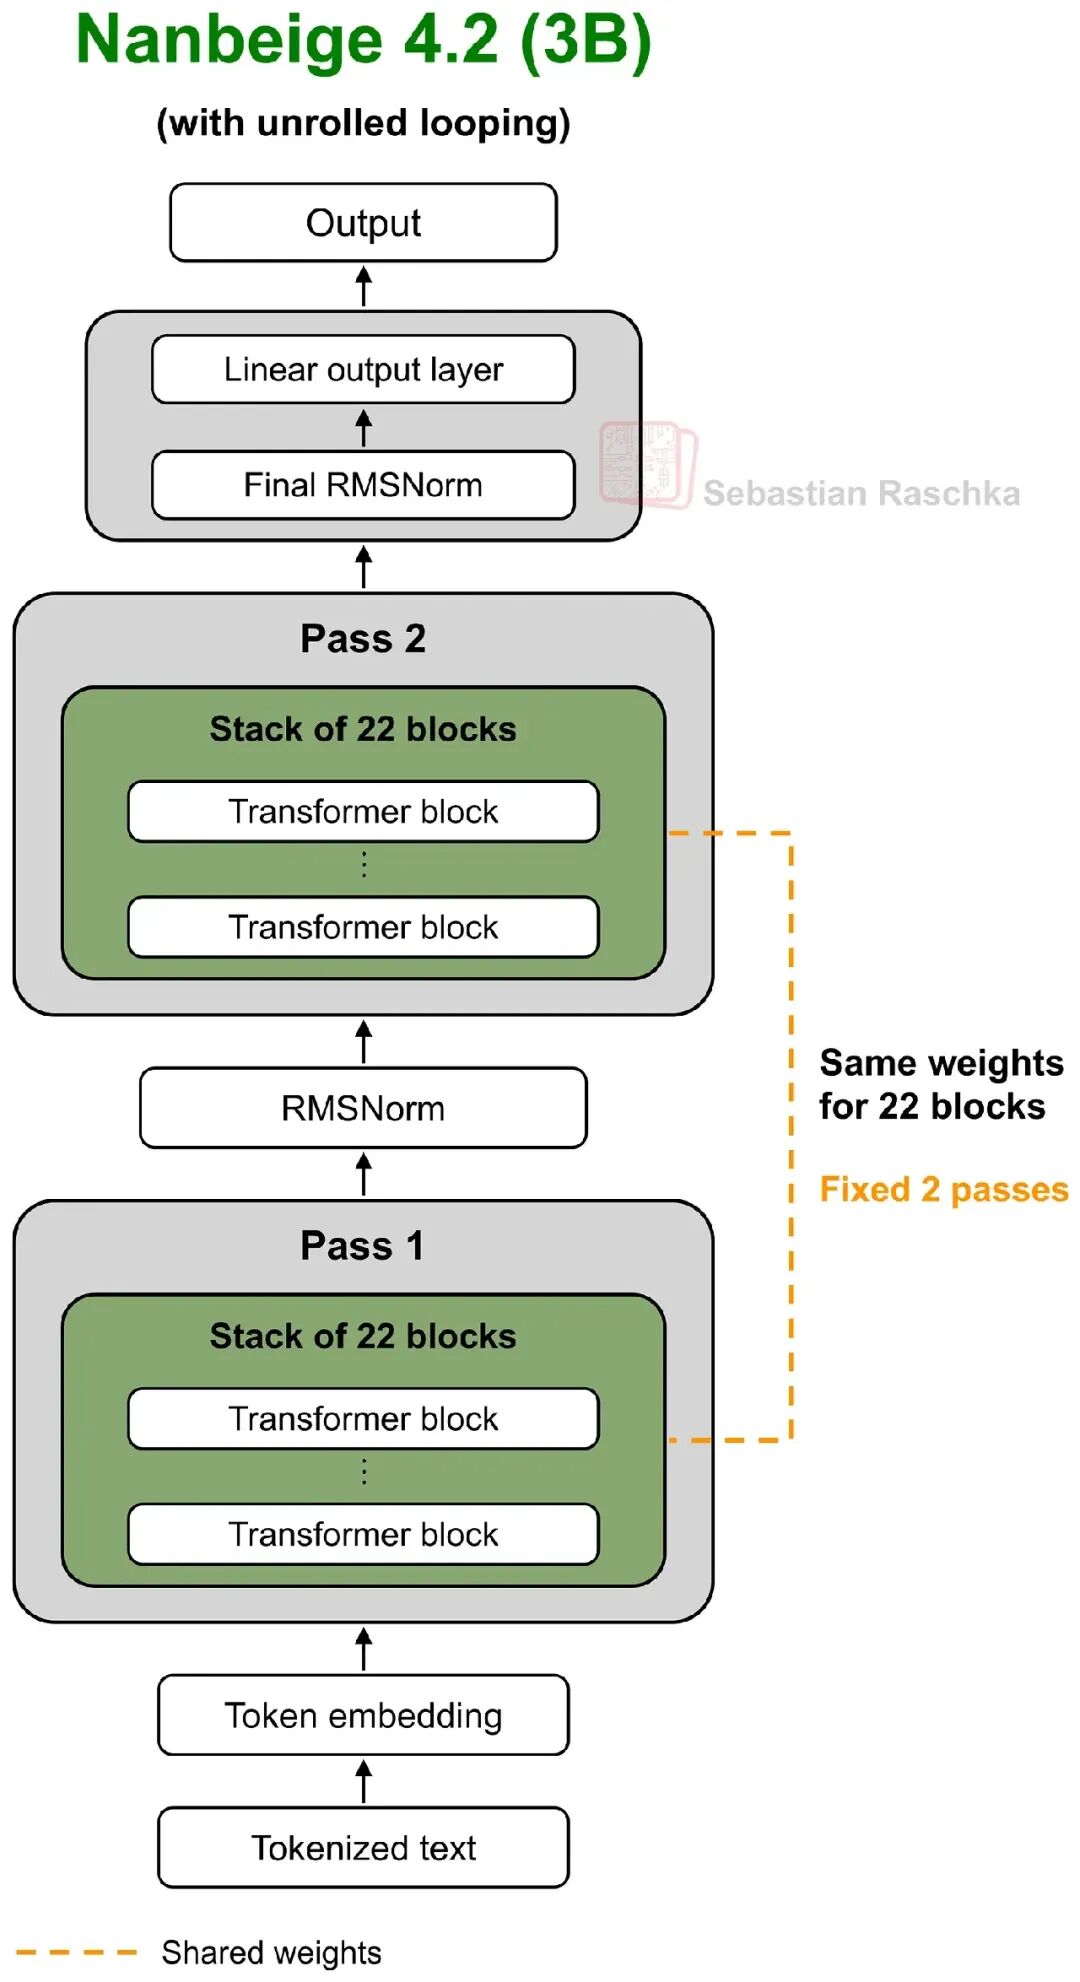
所以整個思路就是:在不增加另一套 Transformer 權重的前提下,把有效深度從 22 次模組應用提升到 44 次。
順帶一提,為什麼是 2 遍,而不是 3 遍、4 遍或更多?Nanbeige 論文裡細節不多,但他們表示這基本上是效率最高的設定。把循環從 2 增加到 3 能提升建模表現,但額外的計算開銷並不值得。
2.2 循環的代價
那麼,總體上我們為什麼要做這種循環?它本質上是“通過增加 Transformer 模組把模型做大”的一種替代方案。
舉例來說,把 22 個 Transformer 模組用兩次的模型,其(Transformer 模組部分的)參數量大約只有擁有 44 個常規模組的模型的一半。
這也就減少了記憶體權重所需的記憶體。順帶說明一下,嵌入層和輸出層通常很大、在總參數中佔相當一部分,它們不在這個比較之內。(以 Nanbeige 4.2 3B 為例,嵌入層和輸出層約佔 30 億總參數的 25%;如果這兩層之間做權重共享,可以降到 12.5%。)
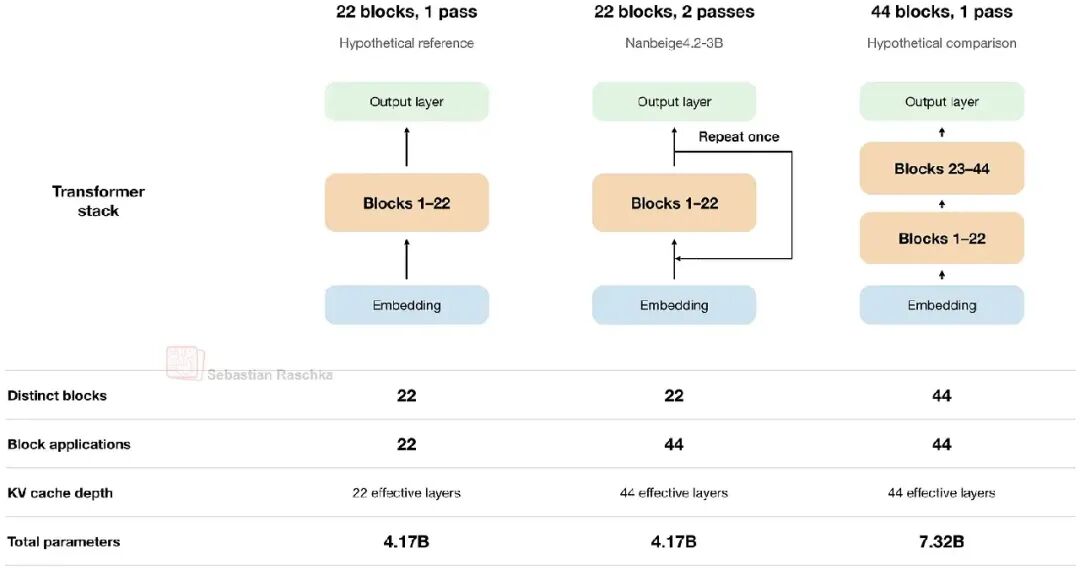
當然,在循環中復用同一批模組,計算量並不會因此減少。更準確地說,前向傳播時,中間輸入要經過 44 次模組應用;訓練時,梯度也要在共享堆疊的兩遍中反向流動。因此,相比只用一次這 22 個模組,這增加了相當多的計算量。實際上,它的開銷和擁有 44 個獨立模組差不多(只是最佳化器需要更新的獨立參數更少;反向傳播依然要走完全部 44 次模組應用)。
還有 KV 快取。它會存下先前 token 的注意力鍵和值,以便在常規 Transformer 和循環 Transformer 生成下一個 token 時復用。
循環 Transformer 裡雖然有權重共享,但第二遍進入某個模組的中間狀態是不同的。因此在 KV 快取中,這兩遍 Transformer 堆疊得到的鍵和值也不同(和不做循環的情況一樣)。所以 KV 快取這邊也省不下來。
說得更具體些,比如第 1 次和第 23 次模組應用都用到了循環設定中的模組 1,但每一次應用仍然需要自己的 KV 快取條目。既然兩遍都必須各自保留快取,那麼 “22 個模組重複兩遍” 的 KV 快取需求,就和擁有 44 個獨立模組的常規 Transformer 一樣。
有意思的是,Nanbeige 的研究者在論文中提到,他們試過在兩遍之間共享 KV 快取。這當然讓 KV 快取大小減半,但模型表現比快取分開的版本更差(他們最終發佈的是快取分開的版本)。
在往下看其他循環 Transformer 設計之前,先把 Nanbeige 的討論補完。他們的技術報告還討論了另外兩個選擇或權衡:
從零訓練這個循環架構,效果好於把已經預訓練好的 Transformer 通過 upcycling(升級改造)轉換過來。
- 如上一節所述,兩遍是他們更傾向的權衡。更多遍只帶來很小的額外收益,同時會拖慢訓練,並讓最佳化變得不那麼穩定。
所以,循環遍數是我們必須做的另一個架構選擇。如前所述,Nanbeige 把它固定為兩遍。不過我們也可以讓它取決於 token,接下來就會看到。
2.3 Universal Transformer 與靈活的循環次數
現在回到Universal Transformers,在 Nanbeige 裡,我們把一組 22 個 Transformer 模組的堆疊應用兩次。而在 2018 年的 Universal Transformer 論文裡,被反覆應用的是同一個 Transformer 模組,而不是重複一整個堆疊。不過主要思路是類似的。
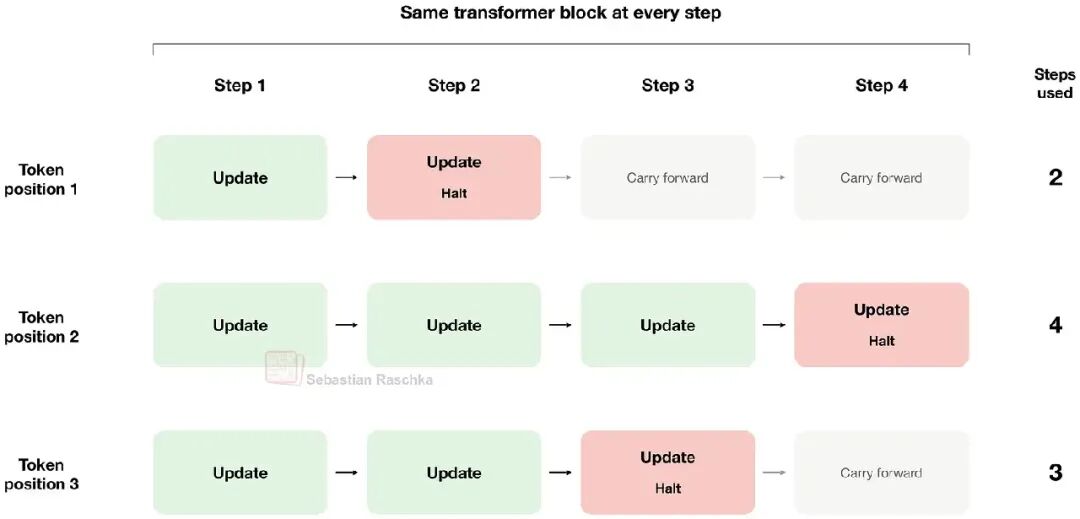
另外,步數可以是固定的,但論文也探索了自適應終止(adaptive halting)。比如,某個位置上的 token 可能只走一兩次循環,另一個 token 可能走三四次,以此類推。這讓模型可以靈活地把計算分配給那些能從額外計算中受益的 token。
循環次數是怎麼定的?這裡模型用了一個小的、訓練得到的函數,在每一步為每個位置輸出一個所謂的“終止機率”。它把這些機率在連續的循環中累加,一旦某個位置的累加值超過閾值,就停止在該位置繼續循環。此外還設有一個最大循環次數,以防萬一限制住計算量。
另一個循環 Transformer 的例子是字節跳動的Ouro,比如 Ouro-Thinking 2.6B 會把同一組 48 個 Transformer 模組應用四次。這就是 192 次模組應用,而只需記憶體 48 個獨立模組的權重。基本上,這比 Nanbeige 更極端。此外,一個學習得到的出口門控會為不同出口分配機率,再用累計機率的閾值決定由那一遍提供輸出。所以它也借用了 Universal Transformer 的自適應終止思路,而 Nanbeige 沒有採用這一點。(不過這裡有個實際的注意點:已發佈的 Hugging Face 實現會先算完所有配置好的遍數再選輸出,所以循環次數看起來實際上被硬編碼成了 4。)
2.4 用路由決定靈活的循環次數
另一種做法是《Mixture-of-Recursions》,這是 2025 年的一篇論文,本質上是前面討論的Universal Transformer的更精細版本。和 Universal Transformer 類似,單個 token 會一次或多次經過 Transformer 模組,如下圖所示。而它的創新之處在於,這個循環次數是如何按每個 token 分別確定的。
在下面這張出自論文的圖中,被循環(重複)的堆疊在這裡叫做遞迴塊。它包含若干 Transformer 模組,並被夾在獨立的首、尾兩個 Transformer 模組之間(圖中標為 Layer 0 和 Layer L-1)。
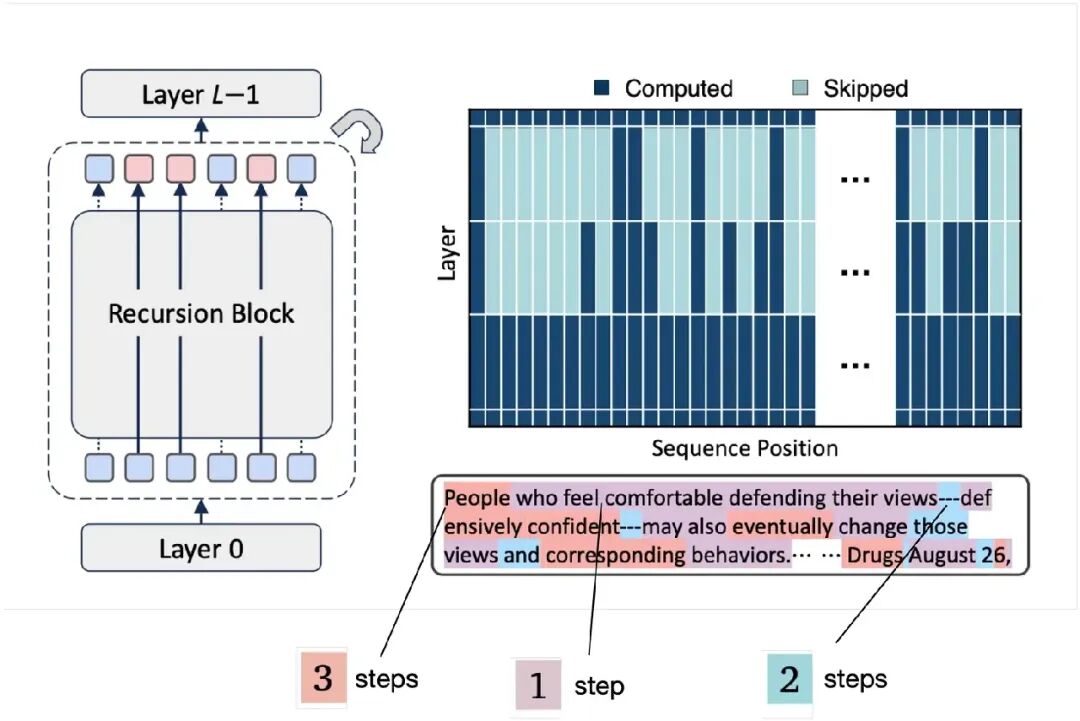
模型怎麼決定一個 token 該經過遞迴塊幾次?在前面討論的 Universal Transformer 裡,靠的是每一步學習得到的終止機率。而 Mixture-of-Recursions 這裡用的是一個小的、學習得到的路由器。這與混合專家(mixture-of-experts)模型裡的路由思路類似,只不過這裡的路由決策決定的是共享堆疊要應用多少次。
路由器作用在 token 的隱藏表示上,而這個表示也包含了它的上下文資訊。所以我們不應該把它理解成“某個特定 token 每次出現都會被分配同樣的遍數”(也就是說,上圖中的 “People” 並不總是走 3 遍循環)。這個決策會隨著該詞出現的位置以及它前面的內容而變化。
那麼路由具體是怎麼工作的?論文探索了兩種做出這一路由決策的方式,如下圖所示。
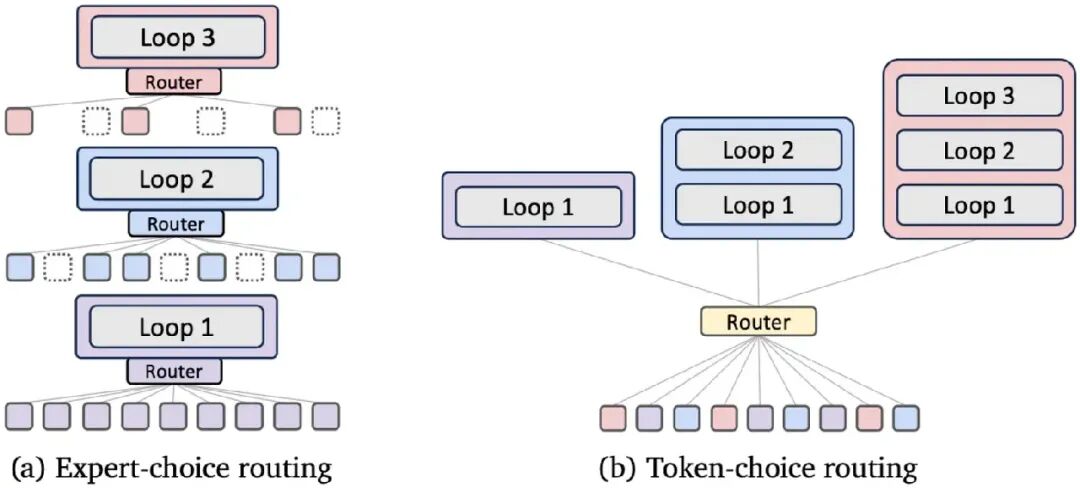
在專家選擇路由(expert-choice routing,上圖左側)中,每一步遞迴自行選出它要處理的 token,退出的 token 不再參與後續步驟。在token 選擇路由(token-choice routing,右側)中,路由器在一開始只做一次決策,把每個 token 分配到走 1 遍、2 遍或 3 遍的路徑上。
兩種方式下,Transformer 權重都在各遍之間復用,這和 Nanbeige 等做法類似。而額外的靈活性來自“每個 token 獲得多少計算”這一選擇。模型和它的路由器是一起訓練的,所以模型會在訓練中學會使用這些不同的路徑。
2.5 效果怎麼樣?
下面這張出自 Mixture-of-Recursions 論文的圖,比較了常規 Transformer(Vanilla)、固定遞迴的 Transformer(Recursive)和 Mixture-of-Recursions(MoR)在不同模型規模和計算預算(橫軸)下的表現。
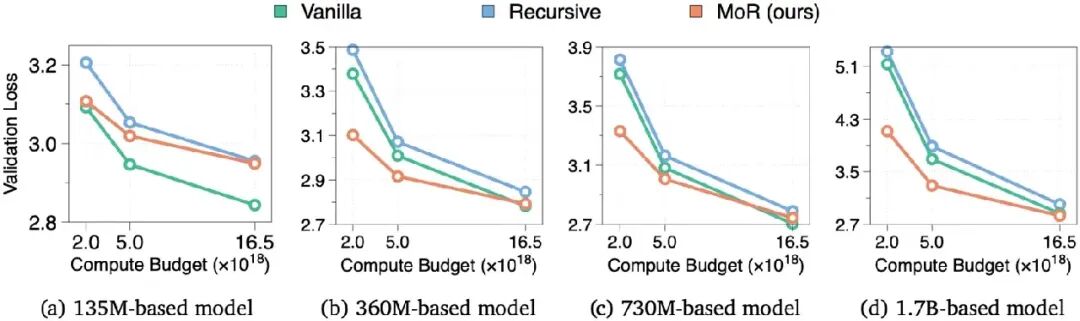
在最小的模型規模上,常規 Transformer 表現最好。在更大的模型上,Mixture-of-Recursions 追了上來,並且往往表現更好,在訓練預算較小時尤其如此。在預算最大時,有幾條曲線已經非常接近。所以,優勢取決於模型規模,以及我們在訓練上花了多少計算。
這裡還有個細節:訓練計算量相同,並不一定意味著訓練 token 數相同。由於可以跳過一部分計算,Mixture-of-Recursions 能在同樣的預算內處理更多 token。
我覺得這是個有意思的例子,因為它說明循環 Transformer 這個思路里還有好幾個選擇,也就是每個位置循環多少次、以及這件事由什麼來決定。
所以簡單說,如果模型足夠大,使用循環 Transformer 可以在固定計算預算下提升模型質量。(這也說明了做一些規模化實驗的重要性;比如只看 1.35 億參數的那個較小模型,我們會得出完全相反的結論。)
3. 題外話:循環神經網路(RNN)
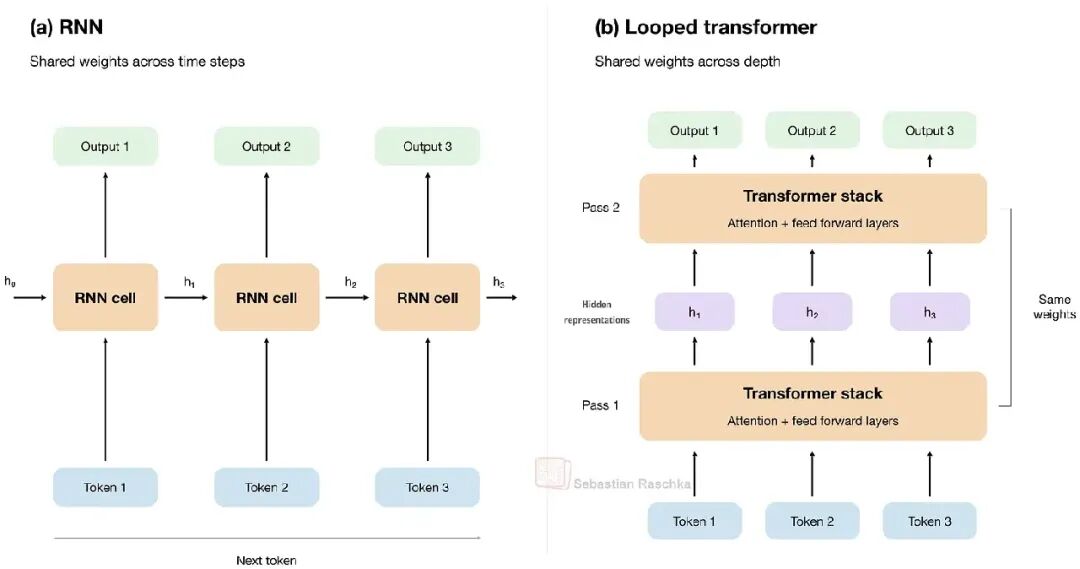
順帶一提,如果你有深度學習背景(甚至可以追溯到 1990 年代的人工神經網路),那麼循環或 “循環深度” 這個想法應該不會太陌生。還記得循環神經網路(RNN)嗎?RNN 的全部思路就是復用上一次迭代的層(權重)。
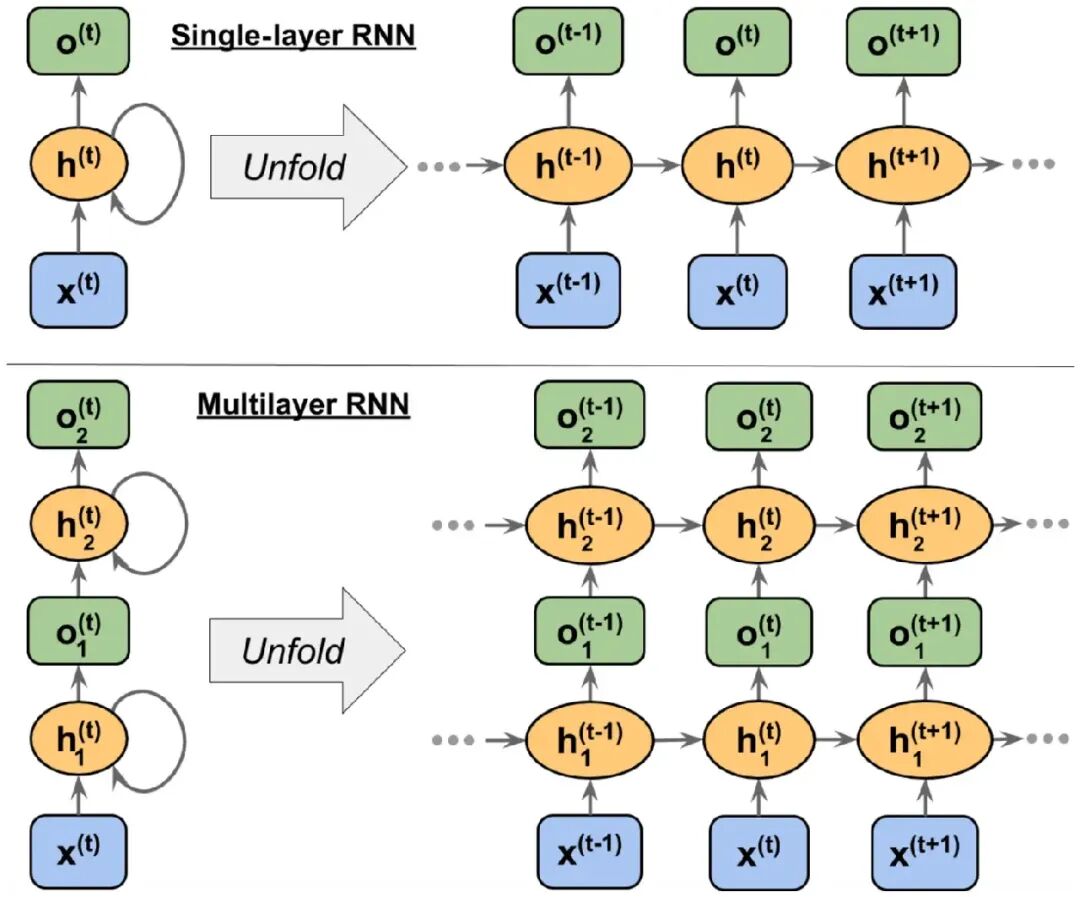
兩者的主要區別在於,RNN 是在時間步之間復用權重,也就是把隱藏狀態從一個 token 傳遞到下一個 token;而在循環 Transformer 中,一個 token 的循環發生在架構的深度方向上。
或者換個說法:在常規 RNN 中,每一步接收輸入序列中的下一個元素,以及上一步的隱藏狀態。所以當 RNN 處理一段文字時,它一次讀一個詞或 token,並通過隱藏狀態把前面詞的資訊往後傳。
而在循環 Transformer 中,某個 token 的中間表示會多次經過 Transformer 堆疊。模型仍然靠注意力在 token 之間傳遞資訊。
如果這個類比讓你有點暈,那也不必太在意。理解循環 Transformer 也許更簡單的方式是:把它看成復用 Transformer 模組——類似於把模型做大,只是權重是共享的。
4. Astra 到底用了循環 Transformer 嗎?
在討論循環 Transformer 機制是否掩蓋了推理軌跡(正如前面 The Information 引文所傳的那樣)之前,先問一句:GPT-6 Astra 到底有沒有用循環 Transformer 的概念?
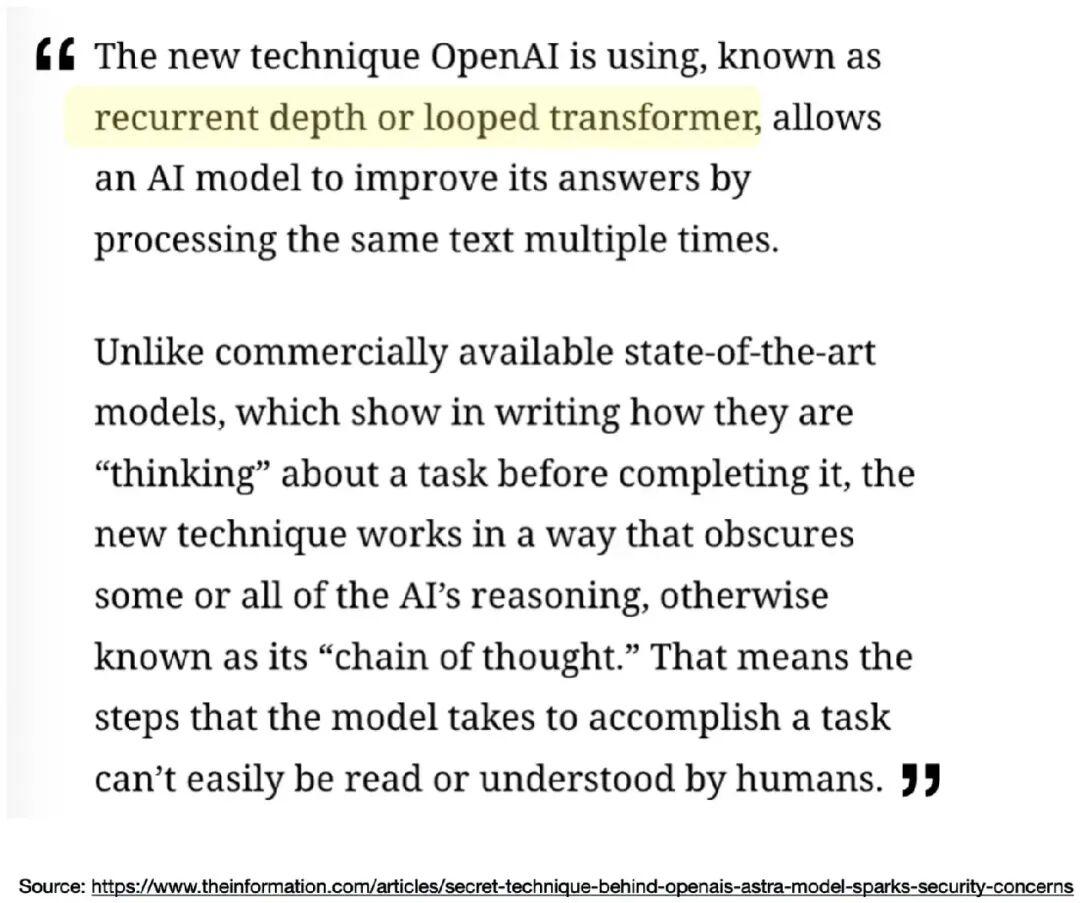
我們得記住,這目前仍然只是傳聞或獨家爆料,沒有官方確認。如果這個模型是開放權重的,我們當然可以自己核實一下,但眼下只能依賴未經證實的報導。
不過,我認為 GPT-6 Astra 很可能用到了循環 Transformer 的某些做法。第一,有上面提到的報導。第二,這是一項在過往研究中已顯示出潛力的技術(前面已討論),那為什麼不用呢?第三,OpenAI 的首席科學家說過下面這段話:
[...] 我們當前前沿模型(包括 Astra)的計算圖深度,與 GPT-4 相差不超過兩倍。 [...]
不過,這並沒有明確確認循環 Transformer 架構,它也可能只是意味著他們用了兩倍數量的常規 Transformer 模組。
在我看來,Astra 的成功(即良好的建模表現)背後很可能主要是別的原因,也就是更好的訓練配方和訓練資料。
循環 Transformer 這處改動或許有一點幫助,但我認為 The Information 高估了它的貢獻。
5. 隱藏思維鏈
接下來,我們終於要面對那個誰都不願先提的問題:循環 Transformer 會掩蓋推理軌跡嗎?
首先,從 OpenAI o1 起,OpenAI 就一直對使用者隱藏(大部分)推理軌跡。所以對終端使用者來說,應該不會有太大差別。
因此,可解釋性方面的擔憂主要是針對模型開發者的。
無論如何,我並不認為循環 Transformer 是隱藏或掩蓋思維鏈的重要原因。為了說明我的推理過程(這裡沒有玩雙關的意思),我們先退一步,講講推理模型是怎麼工作的。
5.1 推理簡述
推理模型通常會在給出最終答案之前生成一些中間步驟。這些步驟使用的是普通文字 token(在某些使用者介面中可以選擇對使用者隱藏),被稱為推理軌跡或思維鏈。
舉個例子,假設我們要找兩個數,和為 10、積為 21。在下圖中,模型一開始試了 5 和 5。和是對的,但積是 25,不是 21。接著它又試了 3 和 7,並再次檢查這兩個條件。
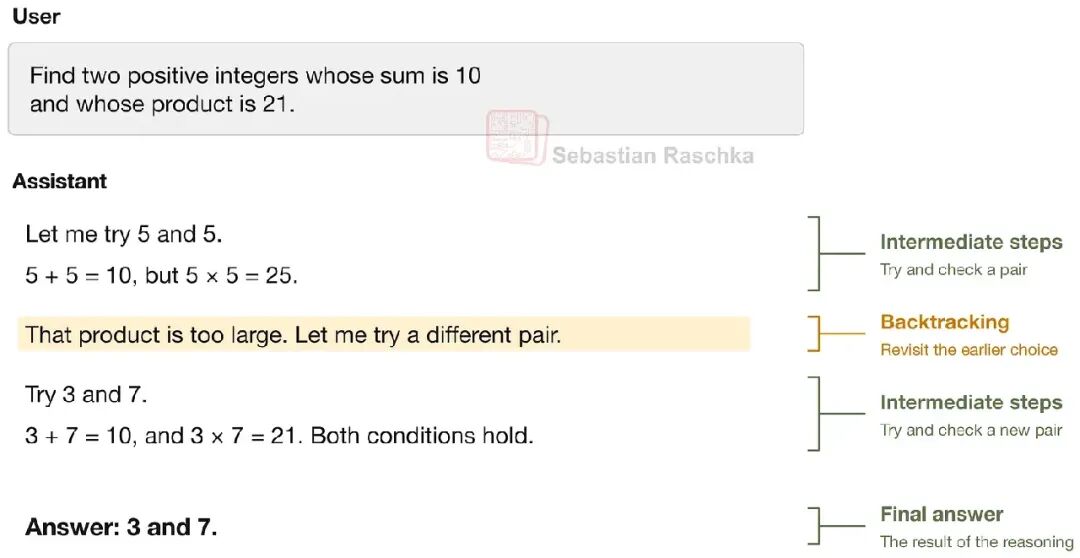
這張圖展示了推理模型是怎麼“推理”的,包括回溯。也就是說,模型注意到一處錯誤,回到先前的某個選擇,然後換一種做法繼續。
注意,模型仍然是一次生成一個 token,並把提示詞和前面的 token 作為上下文。所以這些中間步驟起的是草稿紙的作用,在最終答案之前增加了計算。
如上面這個例子所示,最終答案可以比它前面的推理軌跡短得多。(OpenAI 往往會對使用者隱藏大部分推理軌跡。)
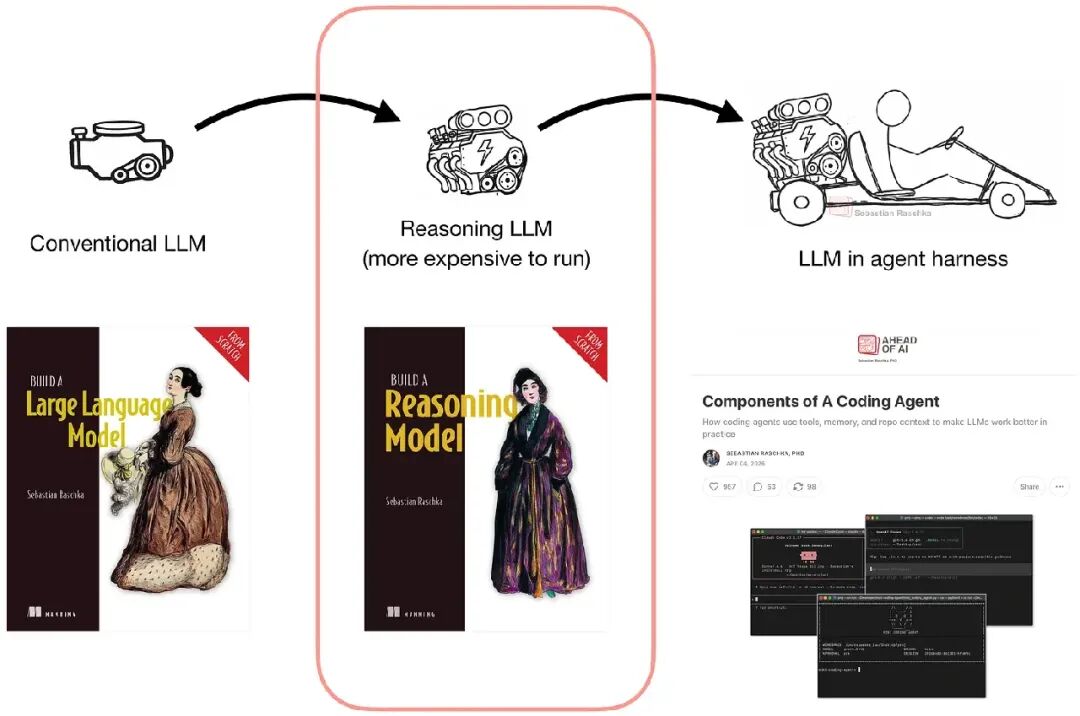
關於推理模型的理解與開發,更多細節推薦我的書《從零建構推理模型》(圖靈即將出版)。
5.2 token 用量與更短的思維鏈
推理軌跡裡多出來的 token 會帶來更多計算。循環 Transformer 也會帶來更多計算,因為 token 要經過更多 Transformer 模組。有人可能會說,一個帶循環的模型在內部用了更多計算,那它就不需要那麼多對外可見的“思考 token”。
下面是部分GPT-6 基準測試,橫軸是輸出 token 數。
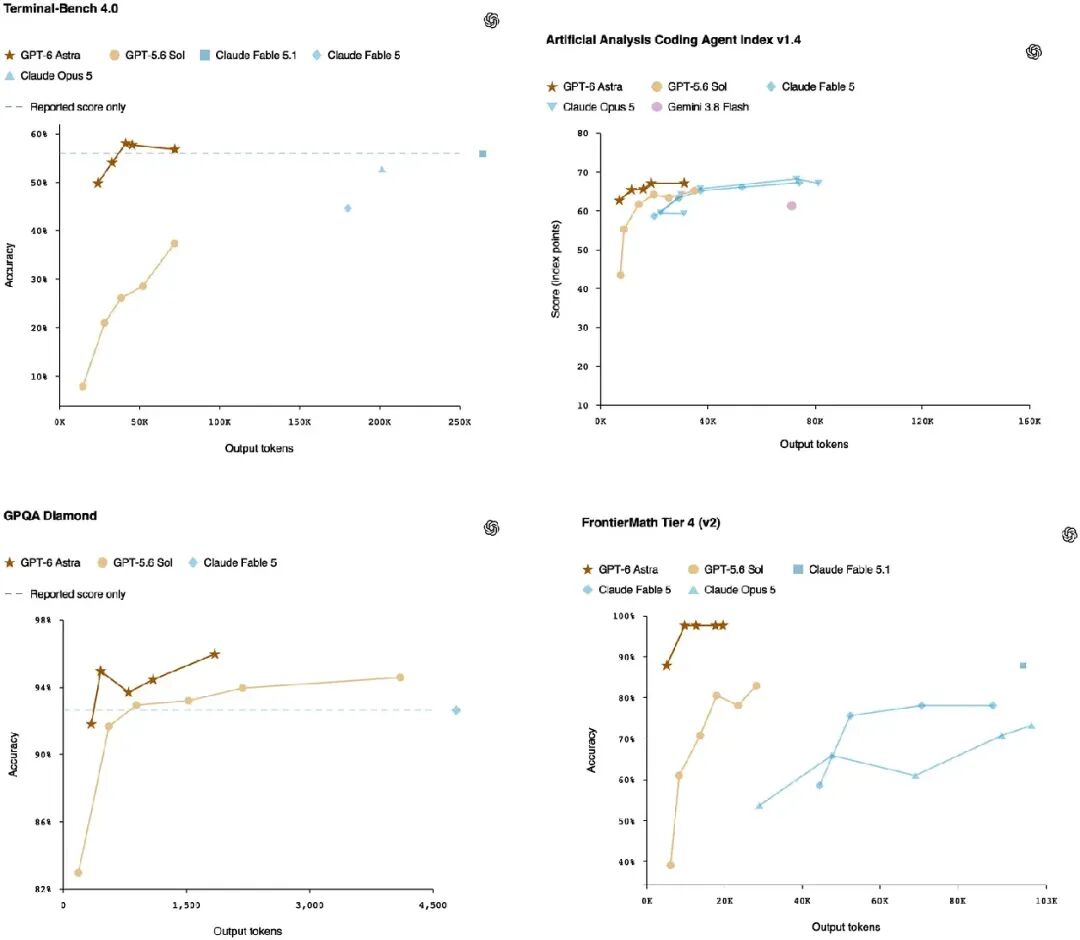
可以看到,在各個 effort(推理強度)檔位上整體來看,GPT-6 Astra 用的 token 並不一定比前代 GPT 5.6 Sol 更少。不過,在相同精準率下,GPT-6 Astra 用的 token 確實比 GPT 5.6 Sol 少。
這是可解釋性方面的隱患嗎?不一定。token 用得更少,可能只是意味著模型更強、犯的錯更少、回溯更少,等等。也就是說,它可能更多地一次就答對了。對我來說,這並不會立刻引發對可解釋性的擔憂。
我的意思是,以前的模型也一樣。我不認為有誰會強烈擔心 GPT 5.6 Sol 的可解釋性遠遜於更小的 GPT 5.6 Luna——後者在同等任務表現下要用多得多的 token,如下圖所示。
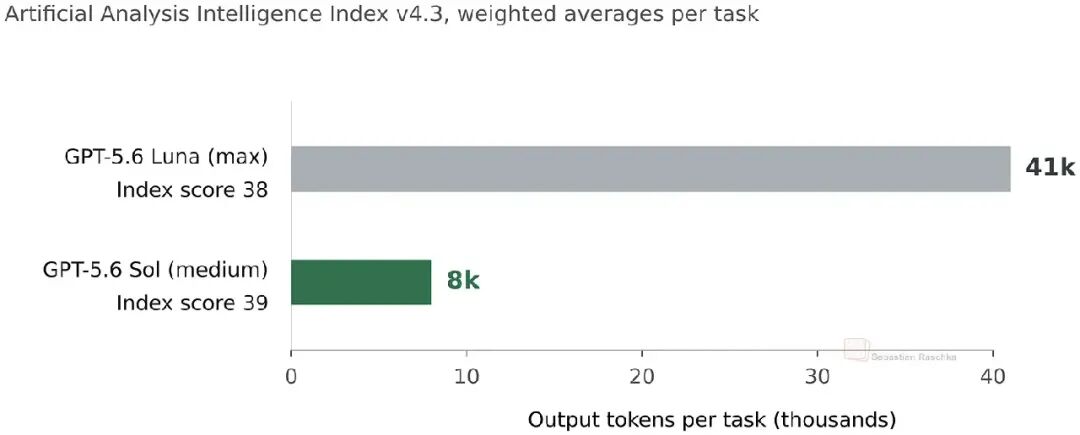
事實上,我們可以看到,在建模表現相近的情況下,Luna 比 Sol 多用了 80% 的 token。這是否就意味著 Sol 的可解釋性差了那麼多?
更合理的解釋是:更強的模型(更大、訓練更好、用了更多計算)能更高效地解決問題,這裡的“高效”指的是用更少的 token。
另外也值得記住,推理軌跡並不保證忠實地描述模型內部發生的一切。在我看來,唯一站得住腳的擔憂是:循環 Transformer 會比常規 Transformer 更頻繁地給出“偽造”的推理軌跡,從而有意誤導使用者。但我認為我們並沒有什麼有力證據表明這正在發生。
至於 Astra 的系統卡,它確實提到有證據顯示其推理軌跡的可監控性下降了,相對 Sol 有一些退步。這主要與更短、資訊更少的軌跡相關。但同樣,這並不能確立循環就是根本原因。它也可能只是源於整體上更短的長度,就像上面 Luna 與 Sol 的例子那樣。
在我分享了關於循環 Transformer 與隱藏推理鏈的看法之後幾個小時,OpenAI 首席科學家 Jakub Pachocki 也給出了如下澄清:
我想避免因為混亂的報導而引發一場“衝向不可監控性”的競賽。我們當前前沿模型(包括 Astra)的計算圖深度,與 GPT-4 相差不超過兩倍。從我們最早的推理模型開始,OpenAI 就一直在努力保留並利用思維鏈監控。我們非常看重這項技術,因為它能讓我們看到模型對齊是如何從訓練分佈中泛化出來的。我確實認為它很脆弱,而且遺憾的是正朝著不好的方向發展,其原因並不取決於架構變化,我很快會寫文章說明。不過我們有辦法加強它,這也是我們當前研究計畫的一個核心目標。
這裡說的“混亂的報導”,很可能指的就是前面 The Information 那一段,也就是在暗示循環這一點與思維鏈的變化沒有關係。
6. 循環 Transformer 相關研究
最後,除了前面已經討論過的,我還想分享幾篇與循環 Transformer 架構相關的有意思的論文。
6.1 潛在推理
與 Universal Transformer 相關,2025 年的論文《Scaling up Test-Time Compute with Latent Reasoning: A Recurrent Depth Approach》研究了模型如何在推理階段使用額外的循環。為此,他們用 8000 億 token 訓練了一個 35 億參數的模型——規模不大,但也不算極小。
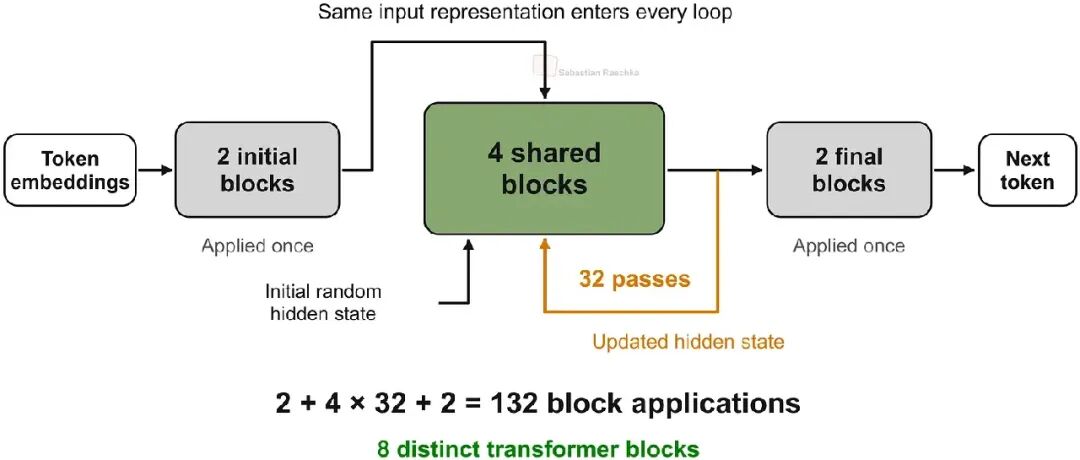
它不像 Universal Transformer 那樣反覆復用同一個模組,而是像 Nanbeige 那樣重複一個堆疊;不過與 Nanbeige 不同的是,它把這個由四個模組組成的共享堆疊,夾在 2 個起始模組和 2 個末尾模組之間。
另一個與 Nanbeige 不同的地方是:共享堆疊在每次循環開始時,除了上一次循環的隱藏狀態之外,還會接收起始模組的輸出。兩者先被拼接,再經過一個學習得到的線性投影,然後進入這四個共享模組。你可以把這理解為:讓堆疊在每一遍都能拿到同樣的初始輸入表示。整體結構總結在下圖中。
所以簡單說,這是循環 Transformer 的另一個有意思的變體。
一個有意思的細節是,研究者在訓練時會改變循環次數。這讓模型做好準備,在推理時應對不同的計算量。
具體來說,訓練時循環次數是隨機採樣的;推理時,由運行模型的人選定一個固定預算,比如 8、32 或 64 次循環。此外,他們還基於下一個 token 的機率分佈,為每個 token 設計了自適應停止機制:如果連續兩輪之間的 KL 散度低於某個閾值,也就是兩個分佈過於接近,就停止循環。
整體收益取決於任務。在他們的評測中,HellaSwag 的表現在大約八次循環後基本趨平,而 GSM8K 和 HumanEval 則能從更多循環中受益。
不過,儘管論文標題裡提到 “潛在推理”,這個模型依然可以生成文字形式的思維鏈。循環只是在每個輸出 token 之前給了它額外的計算。
6.2 知識檢索與推理的區別
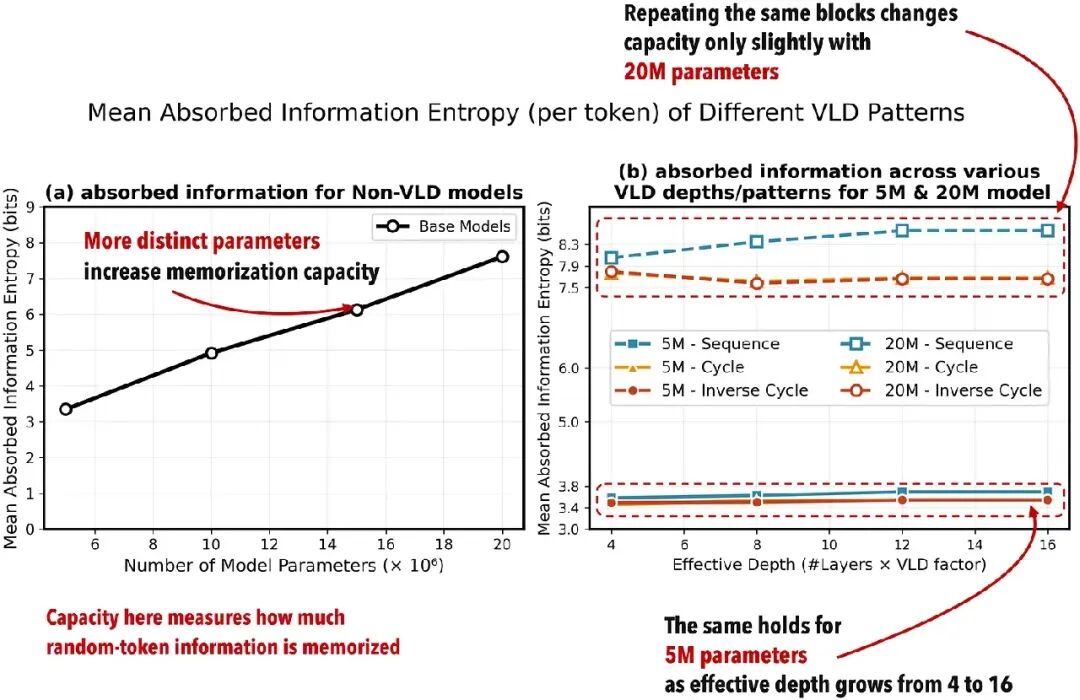
“記憶體資訊”和“用資訊解決問題”之間有一個有用的區分。比如 2025 年 6 月的論文《Beyond Parameters: Exploring Virtual Logic Depth for Scaling Laws》就分別測量了 LLM 的記憶能力和推理能力。
首先,在記憶實驗中,參數量固定時,循環幾乎不會改變模型記憶體的資訊量。而增加獨立參數的數量確實能提升這一容量。由此我們可以得出:循環並不會讓模型存下或檢索到更多知識。這也說得通——資訊一旦存好,檢索本身是個相對簡單的任務。另外,循環本身是一種電腦制,而不是 “記憶體” 機制。
其次,在另外單獨的推理實驗中,復用模組能在不增加參數的情況下提升多步數學題上的表現。這很有意思。這裡我們可以得出:即使模型並沒有更多空間來記憶體資訊,額外的計算也能幫它解決問題。當然,更大的模型同樣能提升推理能力(只是它們也增加了參數)。
6.3 相同計算預算下的循環
剛剛發佈的 2026 年 9 月論文《SMELT: Scaling Laws for Compute-Matched MoE Looped Transformers》回到了 2.2 節的成本對比。如果我們讓循環 Transformer 和常規 Transformer 在每 token 計算量、非嵌入總參數量以及 KV 快取需求上都大致相同,會發生什麼?
研究者使用混合專家(MoE)架構,把 Transformer 中間那一半的模組應用兩次,有點像 Nanbeige,只是加上了 Latent Reasoning 裡的夾心結構。
不過,為了補償額外模組應用所需的計算,他們縮小了隱藏維度。而這會讓參數量變少,於是他們又增加專家數量把總參數量補回來。他們還調整了注意力頭的配置,以保持 KV 快取相當。
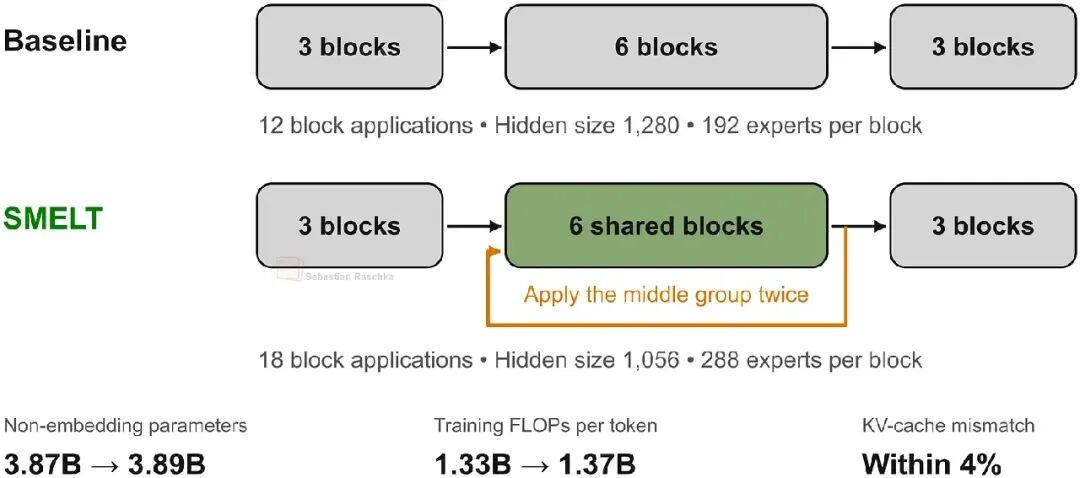
實驗規模最高做到 540 億非嵌入參數等。隨後,研究者通過擬合的規模曲線估計:在所研究的計算範圍內,SMELT 達到同樣的驗證損失所需的訓練計算量少約 6.8%–18%。
所以這就回答了“循環 Transformer 在計算上值不值”這個問題:值!在使用同樣的計算預算時,它們能給我們一個略好一些的模型。
6.4 Full-bandwidth Transformer
最後,同樣很新的 2026 年 8 月論文《Full-bandwidth transformer》研究的是跨 token 位置的循環。在每一步解碼時,它通過一個學習得到的門控,把上一個 token 的最終隱藏狀態與新採樣 token 的嵌入結合起來,作為下一次前向傳播的輸入。
於是,下一個 token 的計算在堆疊底部就能獲得上一個 token 的最終表示,這和 Latent Reasoning 有些相似。
在使用 10 億參數的基礎模型時,他們發現這種潛在反饋方法在 MATH500 上會輸出更短的推理軌跡,同時精準率保持不變甚至有所提升。不過,這種變短的效果在指令微調之後就消失了。
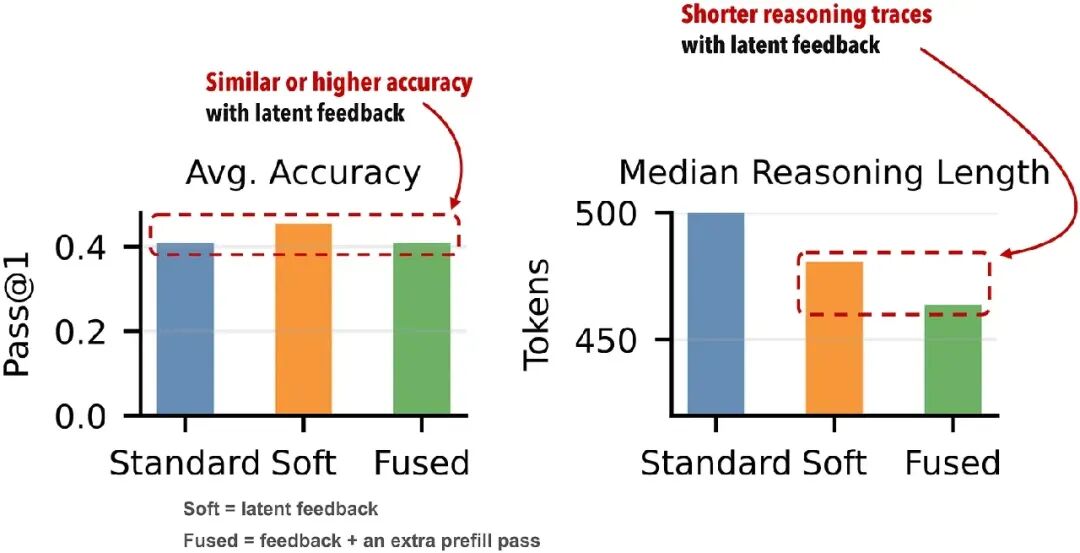
總之,這一點很有意思,因為它直接關聯到前面關於“循環是否會讓推理軌跡變短”的討論。當然,結果既取決於反饋機制,也取決於模型是怎麼訓練的。另外,這個實驗並沒有確立這些更短的軌跡是否更不忠實。
還有,這項研究的一大注意點是:他們沒有測試用常規方式增大模型(增加 Transformer 模組而不是循環)是否會對推理軌跡長度產生類似影響。
結語
總結一下:是的,OpenAI 的 GPT-6 Astra 是個非常強的模型,而且它在電腦操作上邁出了特別大的一步。我相信,接下來幾個月裡,電腦操作會是開源和閉源 harness 的下一個重點方向。在電腦操作這件事上,我覺得開源尤其重要,因為“能力越大,責任越大”——在把我主力電腦的訪問權交出去之前,能先審查這個 harness,是件讓人安心的事。
此外,GPT-6 Astra 很可能使用了循環 Transformer 的某種變體。循環 Transformer 就是能在固定計算預算下帶來更好的建模表現。
另外,更好的建模表現可能會讓推理鏈變短。但這不是什麼新趨勢。在同一模型家族裡、不同規模的模型之間,我們一直都能看到這一點(比如 GPT 5.6 Luna 與 Sol 的對比)。
在我看來,推理軌跡變短是模型更“聰明”、更強的一個副作用:它們犯的錯更少,並且能在架構內部呼叫更多計算,而不必把推理軌跡當草稿紙用。某種意義上,人也是這樣。線上下的大學數學考試裡,一個聰明且準備充分的學生大概會更少用到草稿紙,也更少需要回頭重算,等等。
感謝閱讀,如果你想學著自己建構推理模型,可以期待我的新書《從零建構推理模型》(圖靈即將出版)。我們從一個預訓練好的 LLM 出發,一步步加上推理能力,配有你可以運行和試驗的程式碼。這件事既有意思也有收穫,也是一筆投資——為將來的自己打好基礎,跟上 AI 領域的發展。
另外,如果你讀過我的《從零建構大模型》,我會很感謝你在各個平台留下一段簡短、誠實的評價。書評能幫助其他讀者判斷一本書是否適合自己,也是支援作者的一種簡單方式。
(圖靈編輯部)