
一年前,中國視訊模型在國際權威模型評測競技場上還只是零星出現。到2026年9月,字節Seedance2.0/2.5、MiniMax H3、阿里Wan 3.0和智象HiDream-O1-Video-1.0(下文簡稱HiDream V1)已相繼進入全球視訊生成模型頭部方陣。三個月內,四款模型密集上新,意味著中國力量正從單點突圍轉向叢集式上行。
但進入同一梯隊,並不意味著走的是同一條路。當畫質、時長和人物一致性逐漸成為基礎能力,競爭焦點開始從“生成得像不像”轉向“是否理解真實世界”。有人押注效率,有人依託規模與生態;智象選擇的切口,則是更懂物理規律與事件邏輯。HiDream V1由此成為觀察其“原生全模態世界模型”路線的一扇窗口。
四支力量,三種路線,
同一個梯隊
沿著各自的技術路線向下看,四家公司呈現出不同的資源稟賦與競爭邏輯。
字節Seedance背靠大廠完整的算力、工程和產品體系;MiniMax H3依託大模型基座與使用者積累,向多模態持續延伸;阿里Wan 3.0則嵌入通義、阿里雲等構成的技術生態。智象走的是另一條路:作為AI創業公司,它沒有大廠的資源和入口優勢,選擇押注“原生全模態世界模型架構”,推動圖像、視訊、3D互動與具身智能在統一底座上演進。HiDream V1補上的,正是其中關於“時間與變化”的關鍵一環。
不同背景、不同路線的團隊同時進入國際主流榜單頭部,意味著中國視訊模型正在從單點突圍轉向叢集競爭。其優勢不只是玩家更多,更在於大廠、AI獨角獸等玩家從不同方向探索技術邊界,降低了產業對單一路線的依賴。
這也引出一個問題:當市場已有多款高畫質、長時長且成本不斷下降的視訊模型,為什麼還需要HiDream V1?
答案不在於“多一個模型”,而在於“多一條路”。當前視訊生成仍面臨一個核心難題:模型可以把每一幀畫得足夠逼真,卻未必理解事件應該如何發生。例如物體運動是否符合物理規律、動作與聲音能否精準同步、前後事件是否具有因果關係。這些問題無法僅靠提升解析度和延長時長解決。
HiDream V1試圖把競爭向前推進一步:在生成之前強化對動作持續時間、物體關係、事件邏輯和音畫對應的理解,讓視訊模型從“會生成”走向“懂世界”。這並非對其他技術路線的替代,而是一種補充:當畫質、時長和效率逐漸成為基礎能力,對真實世界的理解將成為新的分水嶺。中國視訊模型的叢集優勢,恰恰在於多條路線能夠同時向前探索。
雙榜前列,HiDream V1
進入全球頭部陣營
HiDream V1 的首次亮相,先被放進了全球視訊模型競爭的公開坐標系。
發佈同期,在 Artificial Analysis Image to Video Leaderboard(With Audio)榜單中,HiDream V1 位列全球第4;Arena.ai Image-to-Video 榜單暫列第8。
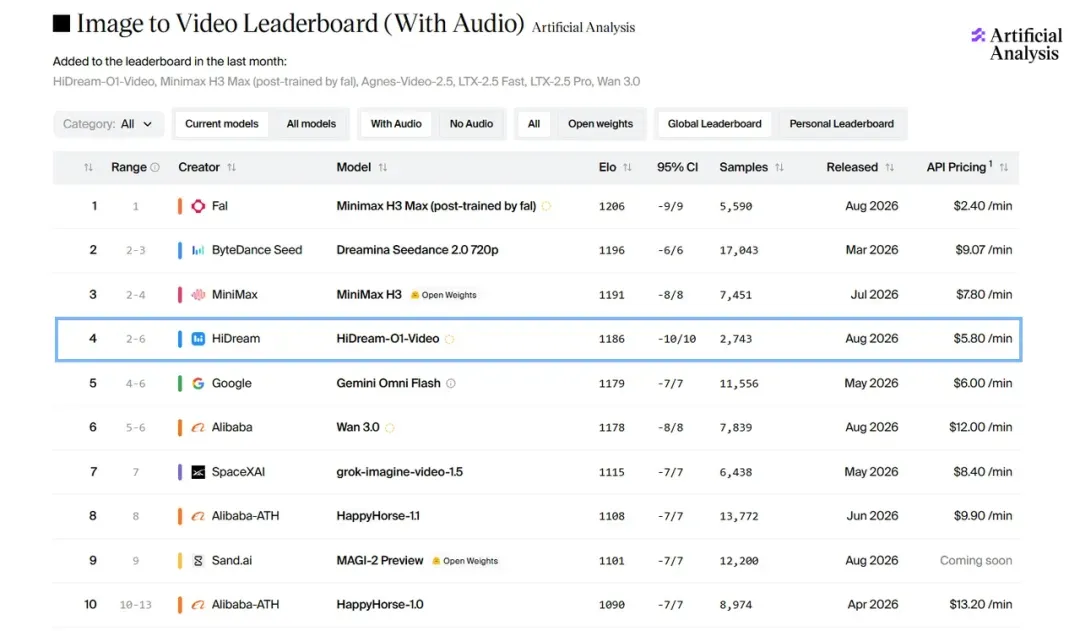
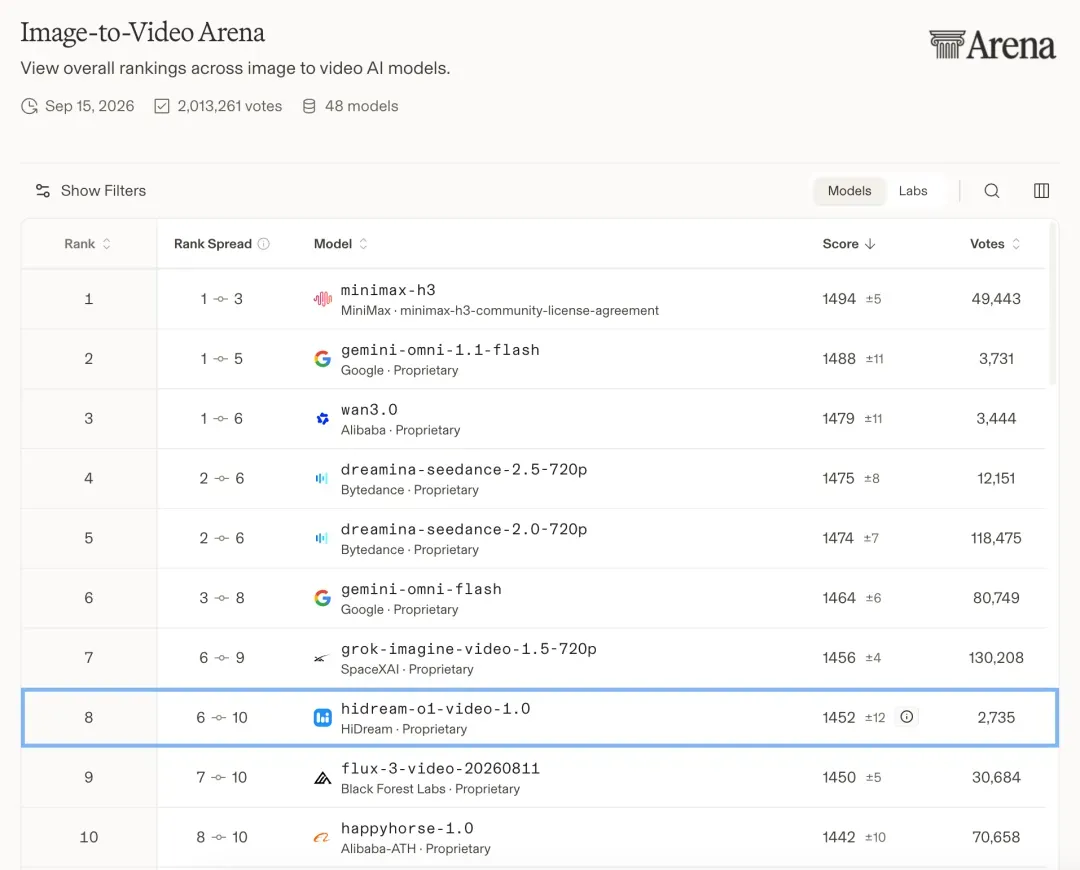
值得注意的不只是智像一家。同一張榜單上,MiniMax H3、字節 Seedance 也都在頭部區間——中國名字密集出現在國際視訊模型排行裡,這本身就是一種產業訊號。
榜單不是全部,但它提供了一個外部參照:HiDream V1 已經進入全球頭部視訊模型的同場比較,而中國視訊模型作為一個整體,正在這張榜單上形成存在感。
回到產品本身。HiDream V1 支援文字、圖片、視訊等多種模態輸入,可生成5至20秒1080p高保真視訊,在意圖理解、物理規律、動態時長、敘事連貫性、人物一致性和音畫同步上完成系統最佳化。它是智象首個原生全模態視訊生成模型。
更值得看的,是 HiDream V1 的競爭力並非來自某一個單點能力。畫面高保真只是基礎,真正拉開差距的,是它試圖把意圖理解、物理規律、時長規劃和音畫同步放進同一條生成鏈路里。換句話說,HiDream V1 要讓視訊裡的事件更合理。
智象未來技術合夥人、演算法科學家潘瀅煒博士告訴網易科技,智象希望做的是"帶腦子的、更智能的模型",不是簡單把提示詞和圖片丟進去,讓畫面動一動。這解釋了為什麼智象會把視訊模型能力的競爭,放到"智能水平"的維度上,而非單純追逐生成效果。
真正拉開差距的,
是demo裡的細節
物理規律,是整個視訊模型行業最難啃的骨頭,不只是智象的挑戰。
當前不少視訊模型已經能生成相當精緻的畫面,也能按照指令做簡單動作。但一旦進入更複雜的物理場景,違和感就會出現:柔性物體不按受力方向運動,物體憑空出現或消失,碰撞反饋不自然,動作完成後鏡頭仍被強行拉長。這些問題在四家頭部模型身上都不同程度存在,區別只在於誰犯得更少。
接下來,從幾個看似日常、卻很能暴露模型短板的任務,看 HiDream V1 的完成效果。
首先是推倒多米諾骨牌。
這個畫面考驗的不是“骨牌倒下”這一個動作,而是一整條因果鏈能不能成立。每一塊骨牌都必須先接觸下一塊,下一塊才能倒下,同時還要配合清晰的點選聲。
實測下,部分模型會在中途斷掉,或出現骨牌還沒發生接觸就自行倒下的情況。HiDream V1 的處理更接近真實連鎖反應:第一塊被推倒後,碰撞一塊塊傳遞,骨牌數量、倒下順序和拐角處的運動關係都保持得更穩定。
同時,對“時長”的理解在這裡也很關鍵。多米諾的時間不是被硬塞進一個固定窗口,而是由事件自己決定:第一塊何時倒下,第二塊何時被碰到,聲音何時出現,都要跟碰撞節奏一致。HiDream V1 在這裡做的,是讓鏡頭時長服從內容本身。
再看,高速賽車。
這個任務同時考驗畫面高保真、指令遵循、運動方向和音畫同步。賽車高速掠過鏡頭時,模型要維持車身結構穩定,不能在運動中變形;聲音也不能只是一段泛泛的引擎噪音,而要隨著車輛接近、掠過和遠離發生變化。
實測下,部分模型會出現車身形態漂移,甚至尾部突然變成車頭的情況。HiDream V1 的賽車主體保持得更穩定,運動方向清晰,引擎聲也隨車輛位置變化產生了更自然的音調落差。
效果的實現主要源於背後的架構。HiDream V1 採用文字、視訊和音訊訊號聯合建模,而不是先生成畫面、再後期配音。潘瀅煒說,音畫同步和原生全模態“天然耦合”,相比割裂生成,聯合建模的對齊程度會更高,感知上也更自然。
也就是說,HiDream V1生成的不是一段帶聲音的視訊,而是一段聲音和畫面共同成立的運動事件。
這個任務考驗的是模型能不能真正聽懂複雜指令。它不只是生成一張漂亮插畫,而是要理解順序、邊界和接觸關係:先後順序不能亂,顏色不能提前出現,畫筆沒碰到的地方不能自己變色,原有線稿結構也要保持穩定。
實測下,部分模型會出現上色突變、顏色溢出,或者沒有嚴格按照指令推進。HiDream V1 的畫面更穩定:顏色跟隨畫筆移動,線稿邊界保持清晰,最終形成的是同一張圖從黑白線稿到彩色插畫的連續變化。
這也是“懂意圖”的另一種體現。難點不在畫得像,而在聽得懂。模型需要把一句複雜提示詞拆成可執行的動作序列,再在連續生成中保持一致。
此外,網易科技還測試了幾組更貼近日常物理世界的場景,包括冰塊掉入水中、倒水、紙張摺疊等。實測結果顯示,HiDream V1 在這些場景裡也能較好維持物體狀態和動作連續性。
把這些實測放在一起看,HiDream V1 把一條能力鏈清晰地展示了出來:從物理因果,到動作時長,到音畫因果,再到複雜指令理解和過程控制,模型正在把視訊生成從畫面能力推向狀態推演能力。
為什麼它能做到:
理解、生成、對齊
這背後,不是給視訊模型多喂一些物理資料這麼簡單,也不是在生成後再做規則修補。
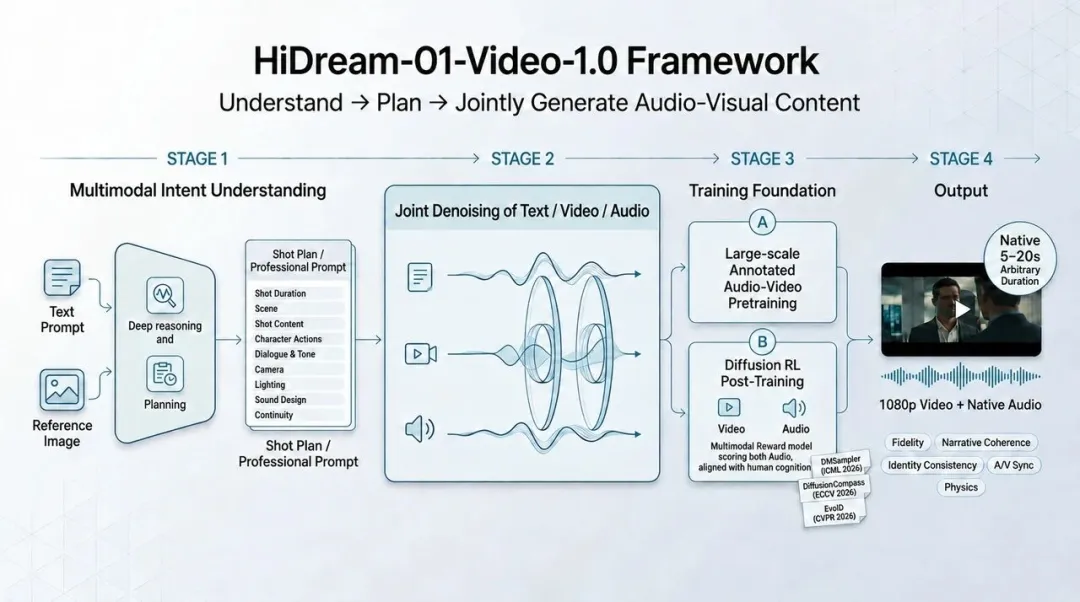
智象技術合夥人潘瀅煒博士告訴網易科技,HiDream V1 的技術路徑可以拆成三步:先理解,再生成,再對齊。
第一步,是在生成前先做理解。
過去很多視訊模型更像是"把圖動起來":使用者給一張圖、一句話,模型直接進入生成。但 HiDream V1 會先通過多模態理解模組,對輸入圖片和文字進行結構化拆解,判斷畫面中的場景、主體、動作、物理關係、鏡頭時長、運鏡方式以及聲音設計。
這一步的意義在於,模型會先把使用者意圖翻譯成更適合視訊生成的內部規劃。比如蘋果拋接,它要先理解這是一個短促動作;乒乓球彈跳,它要先理解彈跳高度、頻率和撞擊聲之間存在物理關聯;穿針引線,它要先判斷紅線、手指、針眼之間的受力關係。
第二步,是把這些理解結果灌進原生全模態生成過程。
潘瀅煒提到,物理規律不能只停留在"知道"層面,還要變成跟視覺內容匹配的訊號。"你重力落下來,幾秒鐘之後會在什麼地方,這些精準的、跟視覺內容匹配的訊號,是要給到模型裡的。"
HiDream V1 的關鍵,正是在生成過程中納入物理規律、動作節奏和音畫關係,讓畫面、動作、聲音和時間彼此約束。
第三步,是用後訓練進一步對齊合理性。
在預訓練之後,智象還會用 Reward 機制強化物理規律、音畫同步和整體觀感。潘瀅煒將其類比為一種 human preference:那些結果更符合重力、碰撞、光影、空間連續,那些結果看起來違和,模型會從這種強弱對比中繼續學習。
這也是 HiDream V1 的能力可以跨越多個場景的原因。穿針測試裡,它要處理柔性物體的受力形變;蘋果測試裡,它要判斷事件應該持續多久;乒乓球測試裡,它要同時對齊畫面運動和聲音反饋。這幾件事表面上不同,底層都指向同一個能力:模型開始推演一個事件如何發生。
更進一步,這套機制之所以能成立,也和智象的原生全模態底座有關。
一個UiT底座,
四大模型同源演進
HiDream V1 並不是一個孤立的視訊模型。它和 HiDream-O1-Image、HiDream-O1-World、HiDream-O1-Embodied 同源,都是從 O1 原生全模態架構上長出來的不同任務形態。視訊模型多了音訊和時序訊號,因此更重、更難,但也正因為它接入同一個底座,文字、圖像、視訊、音訊之間才能在同一生成過程中互相約束,而不是各做各的。
所以,HiDream V1 能做出這些效果,不只是因為視訊能力增強了,而是因為智象試圖把"理解世界、表達世界、反饋世界"放進同一套模型邏輯裡。
智像在視訊生成領域有著深厚技術積累。2024年1月率先實現超15秒視訊生成技術突破,同年7月推出全球首個商用DiT大模型HiDream 2.0,12月發佈採用擴散自回歸架構的HiDream 3.0,持續推動視訊模型從生成能力向深層理解演進。今天發佈的HiDream-01-Video-1.0,則實現了在面向世界模型方向的新一代UiT 架構上的再次升級。
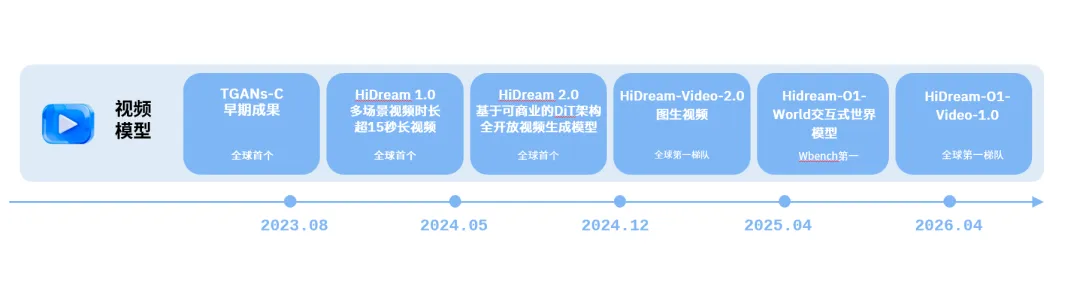
潘瀅煒用了一個更形象的比喻:O1-Image、O1-World、O1-Embodied 和 O1-Video,是"一個架構上面長出來的幾朵不同的花"。它們的基礎架構通用,只是不同任務灌入的資料、後訓練方式、條件設計不同。視訊任務因為多了音訊和時序資訊,也更重、更消耗算力。
這與行業裡其他幾條路線形成了有趣對照。
字節 Seedance 和 MiniMax H3 走的是"先把視訊生成做強"的路線,在單點任務上建立優勢,再向多模態外擴。阿里 Wan 3.0 依託通義體系,把視訊模型嵌入大模型+雲服務的整體方案。這些路徑都很重要,本質上是從一個任務向外延展。
智象的選擇不同:先押注原生全模態 UiT 底座,再讓圖像、視訊、世界模型和具身模型在同一架構下同源演進。
潘瀅煒說,這不是"做完A再做B,做完B再做C"的序列關係。原生全模態架構出來後,多個任務是平行推進的,只是視訊模型更重,所以發佈節奏更慢。
這條路線的代價是,單看一個任務,投入更大、周期可能更長;但好處也很清楚:一旦底座打好,不同模型之間可以互相促進,後續能力迭代會更快。
"對一個人來說,認識世界就是聽覺、視覺,包括觸覺等等一體的。"潘瀅煒說。越接近 AGI 時代的世界模型,模態越齊、對齊程度越高,天花板也會越高。
視訊之後,
世界模型閉環初現
從這個角度看,HiDream V1的節點意義非常清晰。
單看模型本身,HiDream V1是智象未來多年視訊模型積累在新一代 UiT 底座上的升級;放在HiDream O1系列中,它連接的則是靜態圖像、動態視訊、空間互動與現實行動,使智象“一個原生全模態底座、四大模型同源演進”的技術版圖初步閉環。
按照智象的規劃,圖像模型負責靜態表達,視訊模型處理時間與運動,互動式世界模型理解空間及互動,具身世界模型進一步將行動與真實反饋納入體系。四類模型並非彼此割裂,而是在統一底層架構上共享和遷移能力。相比單點推進視訊生成,這一路線的核心價值不在於模型數量,而在於不同模態能否相互增強:圖像沉澱視覺表徵,視訊引入時間與物理變化,世界模型和具身智能再將這些能力推向空間理解與現實行動。
但閉環初現,不等於世界模型已經成熟。正如潘博士所言,目前沒有任何模型能夠完全解決物理規律問題,複雜因果推理、長時一致性、可控互動與算力成本,仍是全行業共同面對的難題。HiDream V1的真正意義,是把競爭向前推進了一步:視訊模型比拚的不再只是畫質、時長和價格,還包括對運動、因果與真實世界規則的理解。
這也是中國視訊模型叢集競爭的下一站。字節、MiniMax、阿里和智象依託不同資源、選擇不同路徑,卻都在從“生成畫面”走向“理解世界”。其中,智象提供了一種底層模型架構創新先行的路線樣本:視訊模型不是孤立的一環,而是通向世界模型的關鍵介面。
過去,視訊生成模型證明了AI可以生成足夠逼真的畫面;接下來,它們需要證明自己理解畫面為何如此發生。HiDream V1補上的不僅是智象原生全模態世界模型版圖中的視訊一環,更是從“生成世界”邁向“建構世界”的關鍵一步。
目前,HiDream-O1-Video-1.0 已開放內測申請。感興趣的讀者可以掃描下方二維碼,申請測試模型能力。(網易科技)