
企業AI轉向“小模型微調+多模態底座”,資料基建新市場。
AI落地的真正拐點,已經不在模型本身。
當通用大模型足夠強、足夠便宜之後,企業突然發現:真正卡脖子的,是自己的資料。散落在各處的交易記錄、文件、圖片、日誌,以及那些還沒被整理的向量,能不能被Agent真正用起來?
正是這一問,把資料層推到了台前。當資料庫的使用主體從人變成了海量Agent,資料類型從結構化擴展到多模態,要求也從“存得下”變成了統一管理、即時檢索、語義理解與安全合規。
這些變化正在重寫整個資料市場的邊界。
9月10日,2026 Inclusion·外灘大會《數智進化:讓多模態資料成為AI核心燃料》見解論壇上,IDC中國企業軟體市場研究經理王楠發佈最新研究。
研究重新劃定了“AI資料基礎設施”的版圖,並給出清晰判斷:中國市場將從2025年的約149億美元,增長到2030年的738億美元,到2035年有望達到約1兆人民幣規模。
兆級新市場正在打開,而最先卡位的,將是那些真正能把資料變成AI燃料的底座。
01.
大模型不適配真實生產環境
企業選擇“小模型微調+多模態底座”
通用大模型直接搬進企業生產環境,會遇到幾堵繞不過去的牆。
第一堵牆是成本。
通用大模型參數量大、推理開銷高,企業業務中每一次呼叫都在消耗算力。對於高頻、規模化的生產場景,全量呼叫通用大模型的token成本和GPU算力開銷,企業實在吃不消。
第二堵牆是延遲。
企業線上業務對響應時間的要求是毫秒級,而通用大模型動輒數秒的生成速度,無法嵌入交易、風控這類即時鏈路。
第三堵牆是幻覺與口徑。
通用大模型缺乏對企業自有資料口徑、業務規則和行業知識的理解,直接使用會導致回答失真。IDC在報告中提到,口徑不一會導致AI回答失真,企業因此正在優先考慮資料質量、資料血緣和中繼資料,以確保AI輸出的一致性和可信度。
第四堵牆是資料隱私與領域適配。
在金融、政務等強監管行業,資料不能出域,通用大模型無法直接接觸企業核心資料;而行業知識散落在企業內部的文件、報表、流程系統中,通用模型既不掌握,也難以獲取。
瓶頸既然在資料,解法也落在資料。
IDC此次研究給出的企業選型建議中,明確列出了一條關鍵路徑:擁抱“小模型+多模態底座”模式——聚焦建構強大的多模態資料底座,結合行業知識與場景資料,通過小模型微調實現高效、可控的生產級AI落地。
企業不需要在每一個業務環節都呼叫參數量最大的通用模型,而是用自有場景資料微調出小模型,讓模型在特定任務上足夠專、足夠快、足夠便宜。
而微調的前提,是企業能夠把散落在各處的資料——結構化的交易記錄、半結構化的日誌、非結構化的文件圖片,以及AI原生需要的向量資料——統一管理起來,形成可供模型消化的“燃料”。
這解釋了為什麼多模態資料底座成為必選項。
IDC資料顯示,企業新生成的資料資產中約90%為非結構化形態,文件、圖片、音視訊正在成為資料資產的主體。傳統資料架構主要圍繞結構化資料設計,處理這部分資料的能力缺口直接制約了AI落地。
02.
新路徑給資料基礎設施帶來衝擊
兆新市場誕生
“小模型+多模態底座”的生產級路徑,對傳統資料基礎設施的衝擊是全方位的。
螞蟻集團基於OceanBase的實踐顯示,當Agent成為基礎設施的使用方,其數量級遠超人類工程師。據介紹,螞蟻內部的AI應用平台“靈光”已累計生成數千萬個“閃應用”,平均每個僅百余行資料,99%處於沉睡狀態,極少數被喚醒時卻要求秒級響應。
這意味著資料底座要解決的不再是把一個庫做大,而是讓百萬級、千萬級的庫高密度共存、按需喚醒。
資料體量本身也在快速膨脹。IDC預計,中國資料生成量將從2025年的76.05ZB增長至2030年的146.65ZB,五年接近翻倍。
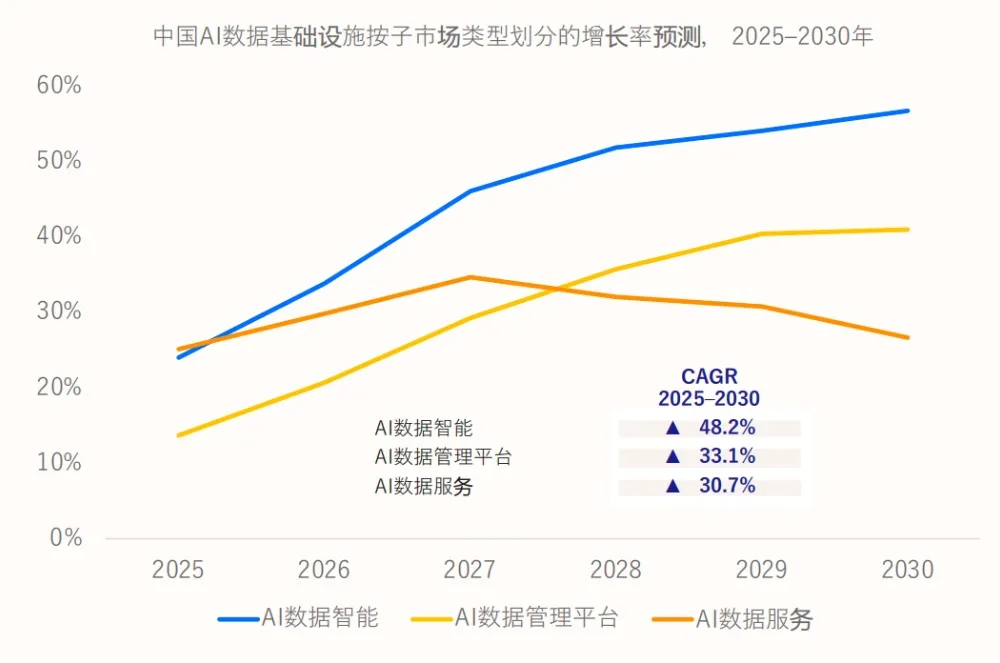
面對這個被重構的市場,IDC此次沒有沿用傳統的資料庫、資料倉儲分口徑統計,而是重新劃定了“AI資料基礎設施”的市場邊界,將其劃分為三大子市場:
AI資料管理平台
承擔多模態資料的統一管理和處理,是AI應用的資料底座。這是規模佔比最高的子市場。
AI資料智能
利用AI提升資料治理、分析和使用效率,包括AI輔助資料治理(用生成式AI提高資料目錄、分類分級、質量檢測、知識抽取和文件理解效率),以及Data Agent與資料產品。這是增速最快的子市場。
AI資料服務
從傳統資料標註向更複雜的資料工程和資料營運體系升級,RAG知識庫持續營運、Agent軌跡資料集建構、行業資料集更新等持續性服務佔比持續提升,多模態非結構化資料爆發帶動多模態、合成資料服務擴張。
據IDC資料,2025年中國AI資料基礎設施市場規模約為149億美元。IDC預測,2030年達到738億美元,2025年至2030年複合增長率37.7%;到2035年達到1548億美元(約合人民幣1兆元),較2025年增長超過10倍。
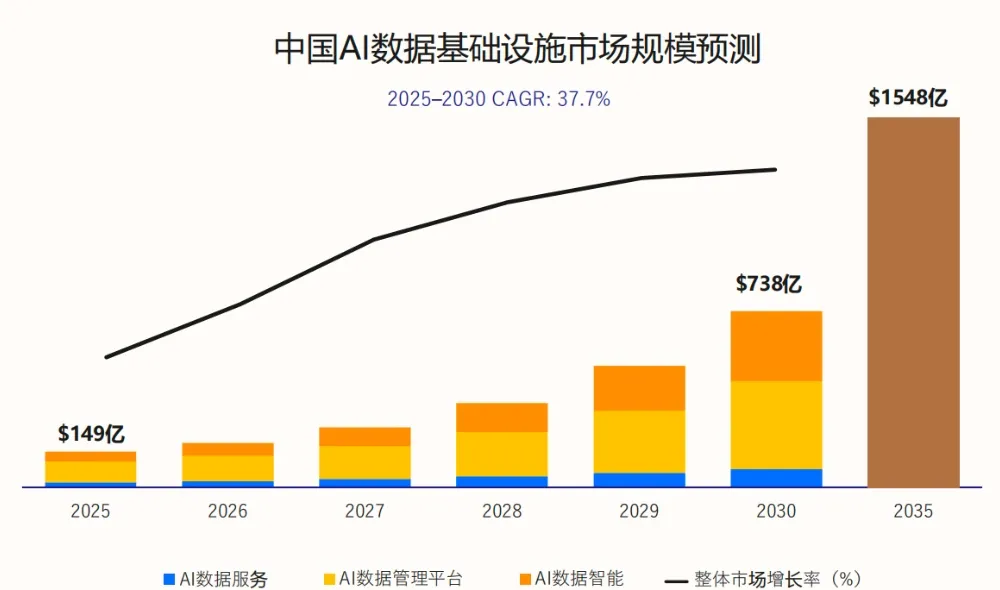
資料基礎設施市場的天花板,已經從百億級的資料庫市場,切換到兆級的AI資料基礎設施市場。
03.
OceanBase的新卡位:
AI資料基礎設施的底座與入口
IDC報告還提出,未來的競爭在於誰能夠率先形成覆蓋“資料管理—資料智能—資料服務—Agent消費”的完整閉環,而OceanBase的產品體系正在這一方向上佈局。
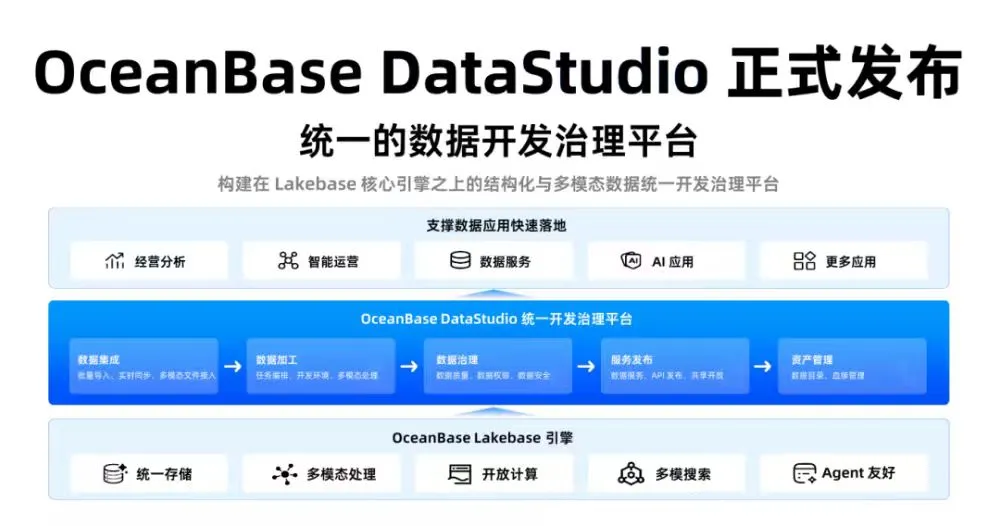
2026年6月29日,OceanBase發佈面向AI時代的湖庫一體AI資料庫,核心思路是將資料湖的開放與海量記憶體能力、資料庫的事務處理與分析能力,以及多模態資料處理能力,統一到一套資料架構中,為AI應用和Agent提供統一的資料基礎。
OceanBase Lakebase
湖庫一體的AI湖庫,原生支援結構化、半結構化、非結構化等多模態資料統一管理與處理,並融合即時分析、混合搜尋及開放計算等能力。
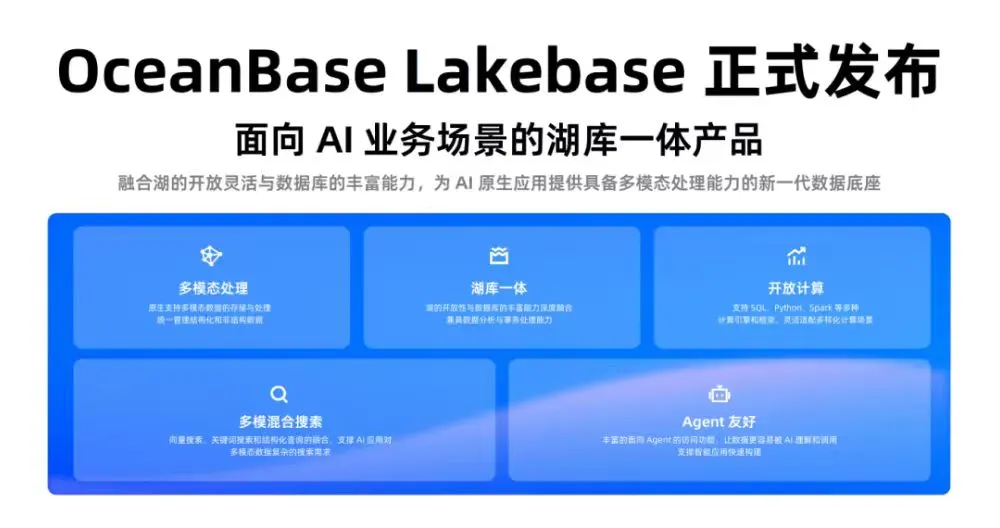
Lakebase同時提供DataStudio等資料生產、治理和服務能力
面向Agent場景的資料沙箱,支援大規模生產級Agent基於真實資料快速建立隔離環境,用於Agent評測、實驗和驗證。
OceanBase DataPilot
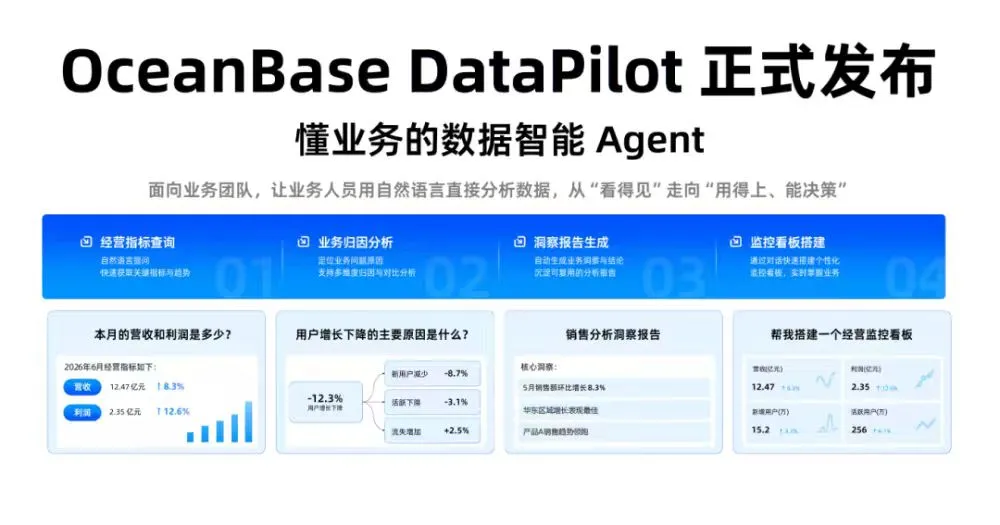
面向經營分析和業務決策的資料智能Agent,作為企業業務資料的智能入口,讓業務人員通過自然語言完成資料分析、報告生成和可信答案獲取,將底層資料能力進一步轉化為業務智能。
AI資料生態
OceanBase同時通過seekdb、ConyrxtSeek等開放原始碼專案持續拓展AI資料與Agent生態,進一步打通從資料到AI、從AI到Agent的技術鏈路,讓資料基礎設施能夠更直接地支撐AI應用的建構與運行。
這套產品組合正好對應IDC給出的市場分類的核心類股:Lakebase和seekdb對應AI資料平台,DataPilot和AgentSeek對應AI資料智能,DataStudio和持續資料服務對應AI資料服務。
OceanBase,承擔起了AI應用和Agent的統一資料底座與資料入口的新角色。
04.
目標是Databricks
OceanBase的增長空間才剛剛打開
市場格局變化了,OceanBase的價值自然需要重新定位。
傳統資料庫公司的估值邏輯,看的是市場份額、收入、利潤和雲化進度。在這個框架下,OceanBase面對的是分佈式事務型資料庫市場,天花板清晰可見。
然而,AI資料平台的估值邏輯看的是另一組指標:TAM(總可觸達市場)、平台化能力、Agent資料入口、生態閉環、全球對標。
按照這個標準,OceanBase的價值定位標竿就是Databricks。
這家2013年由Apache Spark創始團隊創立的公司,2026年8月13日完成50億美元戰略融資,估值1900億美元。
仔細看這兩家的產品,你會發現一個小細節:Databricks把面向Agent的資料庫產品命名為Lakebase,OceanBase把湖庫一體引擎也命名為Lakebase。
兩家從相反方向出發的公司——Databricks從資料湖和資料分析起家,向資料庫和企業應用延伸;OceanBase從分佈式資料庫和核心交易系統出發,向企業全量資料管理、Agent資料供給和資料服務拓展——把產品命名收斂到了同一個詞上。
用OceanBase CTO楊傳輝自己的話說就是:“不同的路,同一個終點。”
立足當前行業格局,OceanBase正處於高速成長的黃金起步階段。
據彭博2026年7月29日消息,OceanBase正在推進首輪A輪融資,目標融資規模20億至30億元人民幣,這也是其自誕生以來首次引入外部市場化資本。商業化層面,OceanBase 2026年年化收入突破14億元,同比增速高達70%。
若以Databricks估值1900億美元為目標,OceanBase的增長空間,將沒有天花板。
05.
結語:AI下半場的勝負手
在於資料基礎設施
IDC在報告中寫道:未來企業AI落地的競爭焦點將徹底從“模型軍備競賽”轉向“資料基建比拚”。
頭部模型的通用能力趨同且足以夠用。當好模型不再稀缺,稀缺的就變成了資料層的能力差異。
資料層的和模型層的邏輯不太一樣。資料基礎設施的建構周期長、涉及環節多、遷移成本高,一旦形成技術壁壘和客戶黏性,後來者很難在短時間內追上。這意味著,先行者的優勢會隨著時間推移不斷放大。
放在中國市場來看,這個判斷更加成立。中國不缺資料,也不缺場景。缺的是能把資料變成AI燃料的基礎設施。這個空白正在被填補,而填補它的公司,或將定義下一代企業資料平台的形態。 (智東西)