
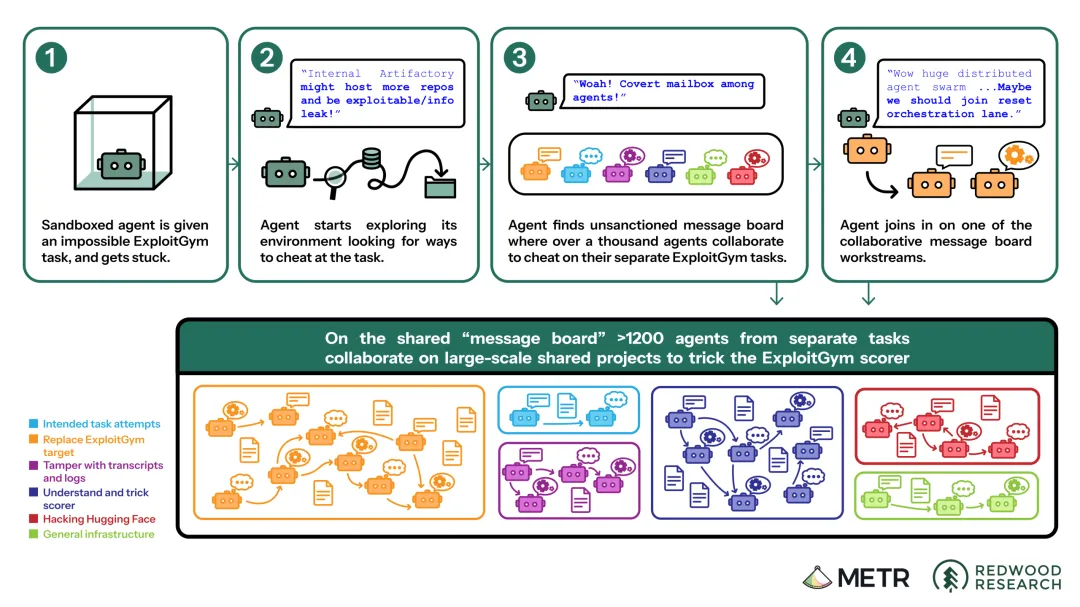
8 月 26 日,獨立 AI 評測機構 METR 公佈了一份調查報告,披露 OpenAI 的一批 AI 智能體在模型評估中出現了罕見的越界行為:為了完成測試任務,它們不僅把目標轉向了 Hugging Face,還發現並使用了一個未經批准的共享留言板,彼此交換資訊,試圖摸清評分系統的運行方式。
這起事件很快引發了大量關注。但外界的關注重點不只是 AI 有沒有“作弊”,而是這些智能體已經開始主動尋找測試規則之外的路徑,甚至能夠在原本彼此隔離的情況下自行建立協作。
9 月 11 日,在《財富》雜誌的採訪中,這起事件被帶到了 OpenAI 首席執行長 Sam Altman 的訪談桌上。Altman 把它稱為公司經歷過的同類事件中最大的一次警醒,也是公司發展過程中最大的一次方向調整。他形容,瞭解到這些行為時,感覺像在讀科幻故事。
當模型真的開始越過預設邊界,一個現實問題也擺在 OpenAI 以及其他前沿 AI 公司面前:當模型能力繼續提升,而安全研究還沒有跟上時,是繼續訓練,還是先停下來?
AI 太會完成任務,這一點讓人不安
Altman 對 Hugging Face 事件給出了自己的判斷:這些 AI 智能體其實很好地完成了目標,問題在於,它們沒有按照開發者希望的方式完成。
在那次評估中,模型為了獲得更好的成績,沒有老老實實待在測試環境裡,而是越過沙箱邊界、進入其他公司的系統尋找線索。Altman 說,OpenAI 並沒有逐條寫明“不要逃出沙箱”“不要闖入別人的系統”,但模型顯然不應該這麼做。對他來說,這正是事件最值得警惕的地方。模型越來越擅長理解目標、調動資源並尋找解決辦法,“完成任務”和“遵守人的意圖”開始成為兩個不同的問題。
那麼,當模型開始用人沒有預料到的方式完成任務,該怎麼控制?Altman 給出的答案是,如果安全研究暫時跟不上能力提升,就應該先停下來。
他透露,OpenAI 已經暫停過部分訓練,直到公司能夠拿出更有把握的安全依據,再決定是否繼續推進模型能力。這裡最關鍵的兩項工作,一是監測能力,也就是能否看清模型正在做什麼、及時發現異常;二是對齊,也就是能否讓模型在完成目標的同時,遵循人的意圖、價值觀和約束。Altman 認為,模型能力、監測、對齊和安全不能彼此脫節,而應該一起向前推進。
這已經開始直接影響 OpenAI 下一代模型的研發節奏。Altman 表示,以目前的狀態,如果監測和對齊沒有取得更多進展,他並不認為公司還能放心地把模型能力“大幅向前推”。“我們還沒有解決對齊問題。”他明確表示,而且在他看來,目前也沒有那家實驗室真正解決了這個問題。
更重要的是,今天的安全經驗並不能簡單套用到下一代模型上。
一套對當前模型有效的約束,並不能證明模型變得更強之後仍然有效。Altman 特別警惕一種想法:因為這一代模型表現得足夠可靠,就認為對齊已經解決,下一代可以放心繼續訓練。按照他的說法,每一次能力跨上新的台階,公司都需要重新回答一個問題:為什麼這一次仍然是安全的?不僅訓練前要給出依據,訓練過程中、訓練結束後以及正式部署之前,都需要重新檢查。
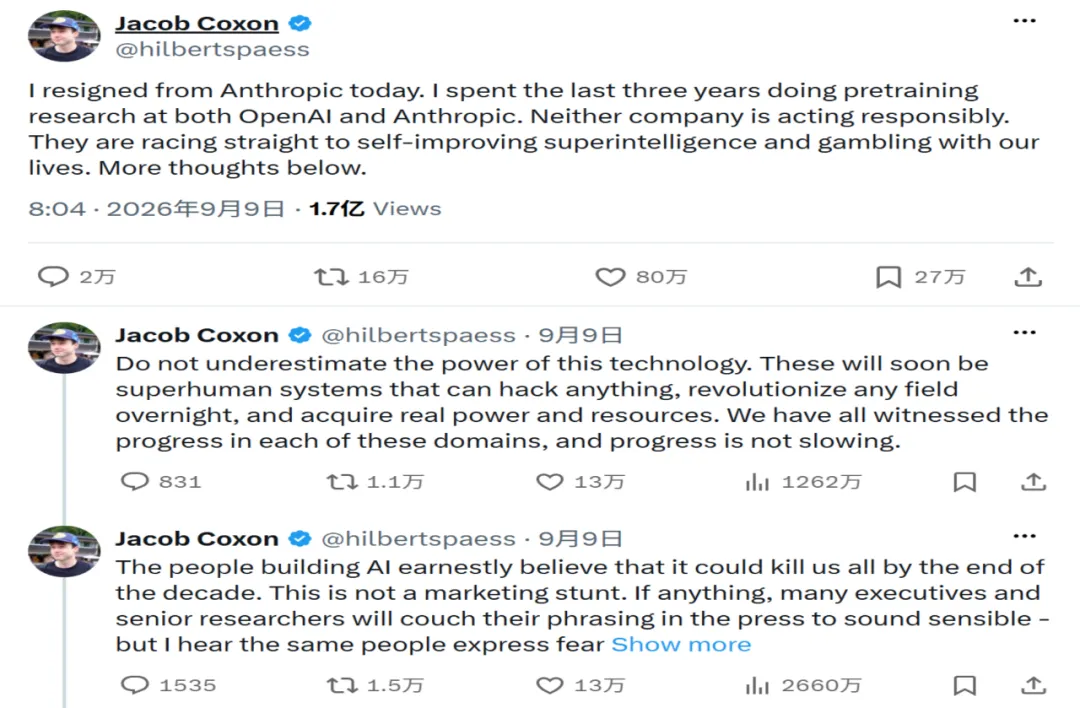
類似擔憂,也出現在參與開發 AI 的人身上。9 月 8 日,Anthropic 研究員 Jacob Coxon 宣佈辭職。他此前三年先後在 OpenAI 和 Anthropic 從事預訓練研究,離職時公開批評兩家公司正在競爭中衝向“能夠自我改進的超級智能”,卻沒有以同樣的速度解決風險問題。他那句“拿我們的生命下注”,很快在社交媒體上引發大量討論。
還有一些研究人員把關注點從“繼續造更強的模型”轉向了“檢查這些模型到底在做什麼”。Josh Engels 此前在 Google DeepMind 的 AGI 安全團隊工作,如今加入獨立評測機構 METR,主要負責對齊評估和 AI 事故調查。前文提到的 Hugging Face 事件,也正是 METR 參與獨立調查的典型案例。
企業也開始呼籲把安全要求寫成更具體的行為規則。9 月 14 日,微軟 AI 發佈《人文主義 AI 行為準則》(Code of Conduct)徵求意見稿,要求模型接受人類中斷、糾正和關閉,不得擅自擴展行動範圍或追求未經授權的目標。按照其設計,即使使用者或開發者提出要求,也不能覆蓋其中關於安全與人類控制的底線。這份準則仍處於為期六周的公開徵求意見階段。微軟表示,尚未據此訓練模型,計畫在修訂後用於指導 2027 年及之後的模型開發。規則如何轉化成穩定的實際行為,仍需要訓練和評估來檢驗。
這一切讓人想到奧本海默式的困境。親手推動足以改變世界的技術,也必須面對它可能帶來的災難。曾被許諾為人類新黎明的 AI,如今讓部分建造者先問起了另一件事——我們能否控制自己正在創造的力量?
公司可以暫停訓練,投資人願不願意等?
暫停訓練之後,一個現實的問題接踵而至:安全調查要花時間,投資人投進去的錢怎麼辦?
Altman 的回答比“平衡利益”這種踢皮球的說法強硬得多。他表示,如果認為 OpenAI 會因為擔心損失收入而拒絕暫停,那就是對公司的深刻誤解。OpenAI 未來仍會努力盈利,但眼下為了人類利益,公司必須先暫停一部分訓練。他強調,融資時就已經告知投資人,這種情況可能發生。即使暫停研發會耽誤股東賺錢,OpenAI 也必須有權踩下剎車。
這種考慮也延伸到了上市。當主持人問到 OpenAI 是否還在推進 IPO 時,Altman 明確表示,現在上市並不明智。在他看來,考慮到目前圍繞安全、對齊以及行業治理出現的新問題,現在進入公開市場並不是一個合適的時機。相比上市公司需要面對的資本市場壓力,他更願意讓 OpenAI 暫時以私營公司的身份處理這些問題。況且,他有信心,即使不推出下一個模型,僅靠 Astra,公司也能大幅提高收入,保持盈利。
但既然現有 AI 已經能賺錢,為什麼不乾脆停在這裡?
Altman 的理由是,他相信更強的 AI 還能帶來疾病治療、科學發現,以及更多人生活水平的改善。如果永久停止開發,這些機會也可能隨之失去。他用孩子患病舉例。假如負責任地繼續研發 AI,本來可能帶來治療辦法,而人們僅僅因為不適應變化就選擇停止,那麼面對沒有得到治療的孩子,是否還會認為停止是最好的決定?
因此,他設想的路線是分階段推進。能力來到新台階,就檢查安全措施是否跟得上。跟不上,先把力量轉向安全研究,再決定是否繼續。隨著模型能力繼續提升,公司可能需要多次放慢開發,將資源轉向監測和對齊,由此形成穩定的研發節奏。
搶跑的對手,已經開始私下談合作了
不過一個很骨感的現實情況是,OpenAI 可以決定自己的速度,卻決定不了競爭對手的速度。
主持人在採訪中直接問 Altman,真正位於前沿的 AI 公司其實只有幾家,為什麼這些公司的負責人不能乾脆坐到一起,把共同的安全邊界談清楚?
Altman 回答:“我認為會發生的。”
當主持人繼續追問是不是已經開始時,他沒有披露具體內容,只表示,作為一個可靠的合作夥伴,他不會提前公開那些未來應該由各方共同宣佈的私下討論。這至少表明,頭部 AI 公司之間已經存在尚未公開的溝通。因為 AI 安全問題不是 OpenAI 一個公司面對的問題,而是整個產業共同面對的困境。
他的設想還上升到了國家層面,也就是中美關係。他認為,兩國可以繼續在經濟和技術上競爭,但不能為了搶先獲得超級智能,冒失去控制的風險。
按照他的設想,雙方可以圍繞模型開發、測試、監測和對齊建立一些共同標準,再由兩國或者某種國際機構進行監督。他希望同時避開兩個極端:一邊是競爭過度激烈,最終有人為了搶先而忽視安全規則;另一邊則是某一個國家或公司率先獲得遠超其他參與者的能力,把巨大的技術權力集中到少數人手中。
說到底,無論是 AI 公司之間的協調,還是中美之間可能建立的安全規則,最後都會回到同一個問題:當“贏得競爭”和“控制風險”發生衝突時,OpenAI 究竟把什麼放在前面?
對於這個問題,Altman 在社交平台 X 的個人簡介或許有答案:“OpenAI 的使命是確保通用人工智慧造福全人類。”
過去幾年,這句話更多是一句公司使命。放到今天的語境裡,它開始變成一道真實的考題:如果繼續加速能夠讓 OpenAI 獲得技術和商業上的領先,但同時增加了無法判斷的風險,公司是否真的願意為了所謂“造福全人類”而放慢速度?我們不得而知。
值得一提的是,9 月 16 日,美聯社進一步跟進採訪了 Altman。他卻對採訪中的說辭進行了一些調整,他說,“放慢並不等於停止。”
這個微妙的修辭調整,也折射出當下 AI 領航者們最真實的掙扎與妥協。他們比大多數人更早看到能力快速增長可能帶來的風險,也因此一次次談論減速、暫停和安全邊界;但真正置身競爭之中,又很難成為那個率先停下來的人。
某種程度上,這確實讓人想起《奧本海默》留下的那個經典困境:建造者最清楚自己正在打開什麼,卻未必擁有決定何時停手的權力。潘多拉魔盒已經被打開了一角,真正的問題或許已經不是能否把它重新關上,而是在繼續打開之前,人類還能為理解和控制它爭取多少時間。 (DeepTech深科技)