
Google DeepMind 放出了一篇RSI最新研究成果。
論文標題是 Dream-RSI: Recursive Self-Improvement through Evolving Worlds,由 Google DeepMind、弗吉尼亞大學和馬里蘭大學聯合發表。程式碼開源在 github.com/zhengkid/Dream-RSI。
過去做遞迴自我改進(RSI),大家默認卡點在底座模型的解題能力。但 DeepMind 把重點轉向了長程任務裡的探索策略,並把它做成了一段可以自我改進的程序對象。
實測顯示,在演算法工程、數學最佳化和 GPU 算子工程中,這套方法把搜尋算力開銷降了一到兩個數量級。
01
現有RSI方法的缺陷
在講自己的方案之前,論文先梳理了現有探索方法各自的缺陷。
1. 靜態探索策略,面對大搜尋空間必然空轉
以 AlphaEvolve、CodeEvolve、SimpleTES 為代表的第一代方案,探索策略全程人工預設。
論文在對照實驗中給出了具體的策略基線。系統會固定啟動 10 個獨立工作區平行探索,每個工作區固定走 11 步連續精煉,分支之間互不相通。每輪迭代不管前期跑出了什麼結果,都機械重複這套固定的配額。
在淺層任務上,這種預設能跑通。但在數千次提議和評估的長程任務裡,策略不具備自適應性。
當某條分支的改進在第 3 步就已經走平,系統依然會把預設的 11 步全部跑滿。同時,由於無法吸收全域經驗,後一輪的新分支往往會把上一輪已經證明無效的方向從頭再踩一遍,導致算力空轉。
2. 線上元策略最佳化:邊探索邊調規則,長程試錯成本過高
第二類思路不僅讓模型找解,還試圖讓模型在任務執行過程中,線上學習並動態調整搜尋規則(如 EvoX)。例如由系統即時決定何時發散探索、何時收斂深挖、各個分支分配多少算力。
這套機制在實際落地中會面臨雙重成本限制。
一是反饋極度延遲且昂貴。評估一段生成的程式碼只需跑一次測試,幾秒就能拿到反饋。評估一套搜尋規則是否有效,必須讓模型在真實環境中跑完整條長任務呼叫鏈,直到整棵探索樹展開才能看到最終收益。
二是真實環境試錯代價大。線上最佳化意味著每次調整規則都在消耗真實的線上算力與呼叫配額。一旦新策略嘗試失敗,整場任務的投入直接沉沒。
02
Dream-RSI 核心邏輯,把歷史資料做成物理模擬器
排除了上面兩條失效路徑後,DeepMind 給出了破局點。歷史探索資料不該當參考文字看,它本身就是一座可以零成本重放的物理模擬器。
1. 三階段遞迴自改進閉環
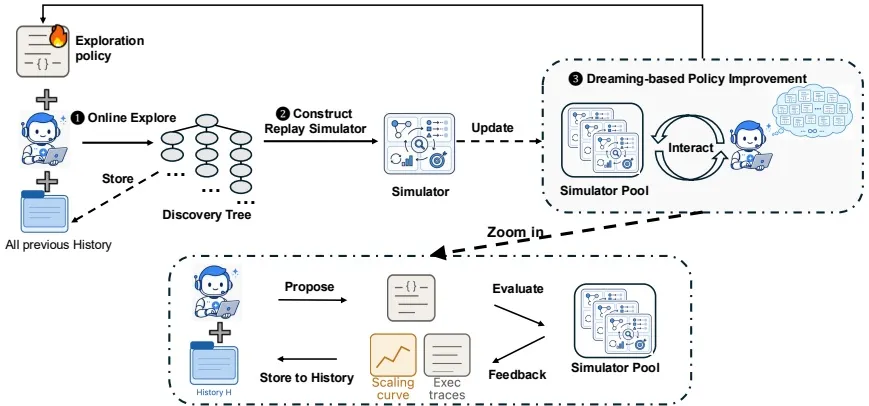
Dream-RSI 的整體系統由三個緊密咬合的階段循環驅動。
第一階段是線上探索。系統部署當前版本的探索策略,指揮底層的 Coding Agent 與評測沙箱真實互動,把所有的探索嘗試沉澱為一棵結構化的“發現樹”。
第二階段是世界演化。系統把最新探索出的節點、程式碼快照、報錯資訊、執行階段長和客觀得分,無損併入歷史模擬器資產池,環境世界隨之演化擴張。
第三階段是離線做夢。在完全脫離真實 API 和沙箱環境的前提下,系統讓成千上萬個候選探索策略在歷史模擬器裡高速重跑,綜合評估策略的解質量與計算效率,篩選出最優策略程式碼,部署到下一輪真實探索中。
在整個閉環中有一條硬約束。底層大模型、評價函數、測試環境完全鎖死不變,只更新探索策略程式碼本身。這是確保性能提升可歸因的技術底線。
2. 核心機制,發現樹直接充當回放模擬器
過去跑過的每一次嘗試,程式碼快照、報錯日誌、執行階段長和客觀得分都記錄在硬碟上。
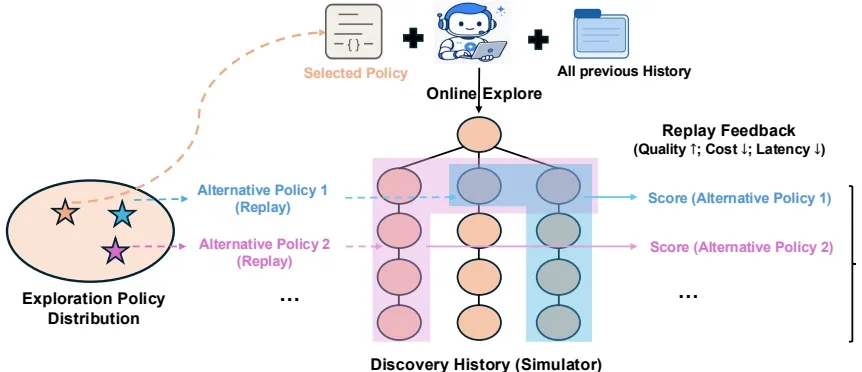
當我們需要評估成千上萬種不同的探索策略時,不需要向大模型發起新的推理請求,也不需要重新跑評測沙箱。候選策略只需要在這棵已有的歷史樹上遍歷一遍,策略想看哪個分支,系統就調出當年記錄的真實結果。
一次真實的探索,換來了上萬次零 Token 消耗的離線模擬。
3. 探索策略程式碼的四個決策維度
在理解了上面的閉環和模擬器之後,這個被反覆最佳化的“探索策略程式碼”,在技術層面到底在控制什麼?
為了讓探索策略變成一段可以被量化最佳化的程序,系統將搜尋過程統一形式化為一棵樹上的遍歷調度。探索策略在每個決策輪次只做四件事。
第一,選節點。決定從當前發現樹的哪些節點作為父節點,派生新的嘗試。
第二,定並行。根據系統設定的最大 Worker 限制,決定當前時刻平行調度幾個生成任務。
第三,設深度。在同一條分支上允許連續深入嘗試幾步,決定深挖還是廣搜。
第四,下止損。什麼時候選擇空批次主動結題,避免無休止的邊際消耗。
探索過程不再是未形式化的經驗邏輯,而是一段輸入輸出明確的 Python 控製器程式碼。
03
Agent自我改進中避坑指南
論文附錄給出的 Prompt 約束,是作者團隊在實際工程裡踩坑後的沉澱。如果不加控制,模型在自主探索時會出現幾類典型的判斷變形。
1. 別把實現級報錯誤判為演算法方向失敗
常見的一個坑是,Agent 在某條分支上遇到了一個 Bug,比如維度不匹配、視訊記憶體超限或者編譯參數遺漏,模型就會得出這條思路不行的結論,立刻把整條方向放棄。
論文的應對規則明確。必須對報錯做嚴格分類。不可恢復的演算法錯誤才能放棄分支,而維度錯、參數錯、視訊記憶體溢出都屬於可修復失誤,單次出現不允許關停分支。
2. 引入分支的赦免與重開機制
早期的幾次失敗會讓模型產生偏見,導致後面有潛力的分支被雪藏。
論文給出的規則是,分支判定不能只看最新一次輸出,必須看整條分支的歷史軌跡。只要後續嘗試出現了進展,系統必須具備撤銷關閉的能力,抹掉早期的失敗標記,重新啟動分支。
3. 避免在收益走平的局部反覆打轉
Agent 容易在局部的細枝末節上反覆修補,提升曲線已經走平,還是死守在原有思路上。
論文的解決辦法是在調度批次裡加入結構性異構候選,把探索多樣性作為和單步收益同等重要的指標,打斷死循環。
4. 探索強度需要動態調整
探索不能按固定步長勻速推進。實測資料顯示,最優策略在初期取得突破時,會自動把單輪嘗試從 110 次壓低到 50 次,主動節省算力;等到進入平台期時,再重新調動高密度探索算力去沖瓶頸。
5. 警惕把歷史塞進 Prompt,先驗引導反而壓制多樣性
很多開發者的直覺習慣是:把上一輪嘗試的經驗、教訓或方向性建議總結出來,直接寫進下一次呼叫的 Prompt 裡做語義引導。
論文在 5.1 節專門對這種做法做了一組對照消融實驗。
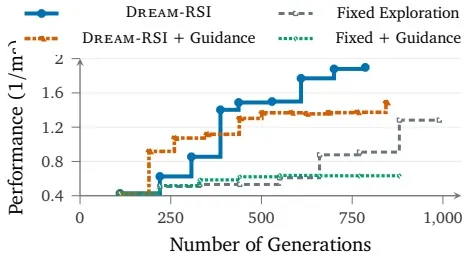
實驗結果顯示,在完全同等的發現算力預算下,無論是在固定探索基線上、還是在 Dream-RSI 上,加入了 Prompt 顯式方向引導的 Agent,最終性能表現都落後於沒有任何引導的對照組。
原因在於長程自主探索依賴多線程並行的多樣性。在 Prompt 裡強加高維的方向性先驗,過早框死了模型的解空間,反倒切斷了潛在的最優探索分支。經驗應當沉澱為環境歷史供策略回放,而不是變成提示詞裡的思維定勢。
04
三大任務開銷對比:演算法工程、數學最佳化與算子生成
消除了盲目試錯之後,Dream-RSI 帶來的收益直接體現在算力開銷上。
1. 演算法工程,Lasso 正則化路徑求解
以 SimpleTES 為對照基線,原方案消耗了 51200 次生成。
同樣使用 Gemini-3.1 Pro,固定探索策略耗費 550 次 Agent 呼叫,下游運行耗時 3587.1 毫秒。Dream-RSI 僅用了 317 次呼叫,下游耗時壓低到了 2931.0 毫秒,算力開銷比 SimpleTES 低了約兩個數量級。
產出的求解器自發結合了 Cauchy-Schwarz KKT 剪枝、強規則篩選與惰性 Gram 矩陣構造,性能超過了標準的 sklearn 和 glmnet。
2. 數學最佳化,千代以內追平或超越前人
在三個數學任務上,Dream-RSI 使用 Gemini-3.1 Pro 運行 10 輪。
在 Sum-Difference 任務上取得 1.145427 評分,刷新了包括 SimpleTES 在內的紀錄;Circle Packing 追平了學界公認的最強解 2.635983;Autocorrelation 在不到 1000 代之內追平了此前消耗 51200 代的 SOTA 模型,預算開銷壓縮了 50 倍以上。
3. GPU 算子工程,更少代數達到工業級性能
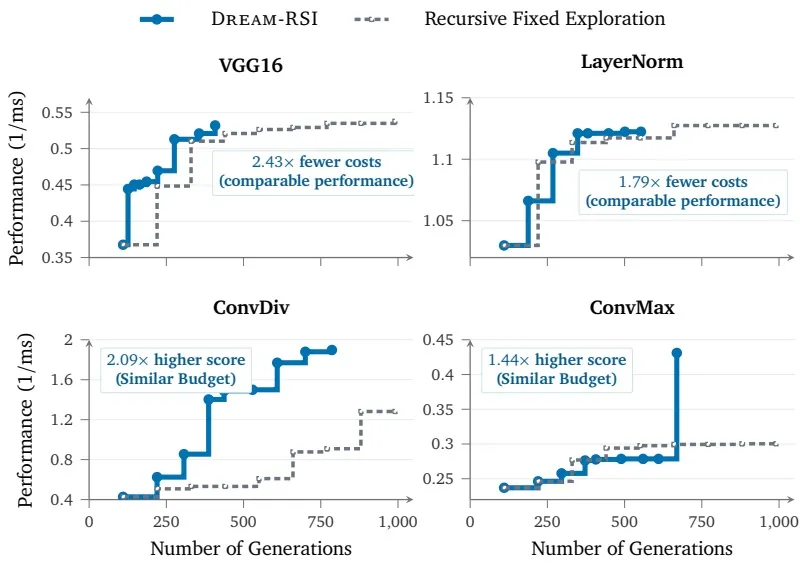
在 KernelBench 測試中,達到同等性能目標,VGG16 上減少了 2.43 倍的代數開銷,LayerNorm 上減少了 1.79 倍。在恆定算力上限下,ConvDiv 和 ConvMax 的算子性能分別提升了 2.09 倍與 1.44 倍。
05
Google Dream-RSI的適用邊界
任何技術都有適用條件,這套方案目前有三個明確的前提邊界。
第一,必須依賴客觀、可自動評分的評測沙箱。系統之所以能閉環,前提是程式碼能不能跑、耗時多少、數學目標是否達成,全都有確定性的評測器兜底。遷移到開放域創意生成或模糊業務分析等缺乏客觀真值評分的場景,整套回放評估將無法成立。
第二,回放模擬器無法憑空產生未探索的真值。離線做夢只能對已經記錄下來的歷史分支做重排、重訪與剪枝,無法預測從未嘗試過的未知路徑。新知識的拓展依然依賴週期性的線上探索。
第三,策略程式碼本身存在複雜度上限。當前演化的探索策略受限於模型編寫控制流程式碼的能力,當探索圖譜變得龐大時,策略程式碼本身的維護將構成新的工程挑戰。
06
寫在最後:從調優模型走向治理探索
面對 Agent 任務失敗時,很多人的第一反應是底座大模型能力不夠,於是陷入微調 Prompt 或者等下一代模型的等待中。
Google DeepMind 這篇工作展現了一種工程思路:底座模型完全可以不動,通過把模糊的探索行為規範成確定性的程式碼介面,把跑過的試錯歷史盤活成離線模擬器,再用清晰的工程規則卡住 Agent 的假性失敗,同樣能在真實任務裡拿到一個數量級以上的效率躍遷。
對於正在搭程式碼生成、科學計算或者長流程 Agent 的開發者來說,怎麼管好探索本身,往往比換一個模型更管用。 (Datawhale)