
2026年被定義為AI虛擬細胞商業化元年。技術突破、政策加持、資本湧入與需求釋放在同一時間窗口交匯,行業正式邁入產業化落地周期。在熱度背後,產業各方對AI虛擬細胞的概念邊界、技術路線、競爭格局和真實瓶頸仍缺乏統一認知。
本份白皮書希望回答三個問題:全球參與者形成了怎樣的競爭格局,那些路徑更具長期生命力?從資料到模型再到應用落地,真正的瓶頸在那裡?產業界已經出現了那些值得關注的創新解法?
為此,動脈智庫梳理了全球AI虛擬細胞的技術演進與產業脈絡,訪談了多家企業,盤點了資料供給、模型開發、商業落地各環節的參與者佈局。我們發現,儘管行業熱度高漲,但資料層的高價值資料缺失、模型層的預測能力未達產業預期、應用層的驗證標準與閉環機制缺位,構成了關鍵制約。與此同時,一批企業正在資料生產、跨模態對齊、乾濕閉環和真實場景交付上展開探索,為行業走向規模化落地提供了現實可行的突破口。
核心內容與觀點:
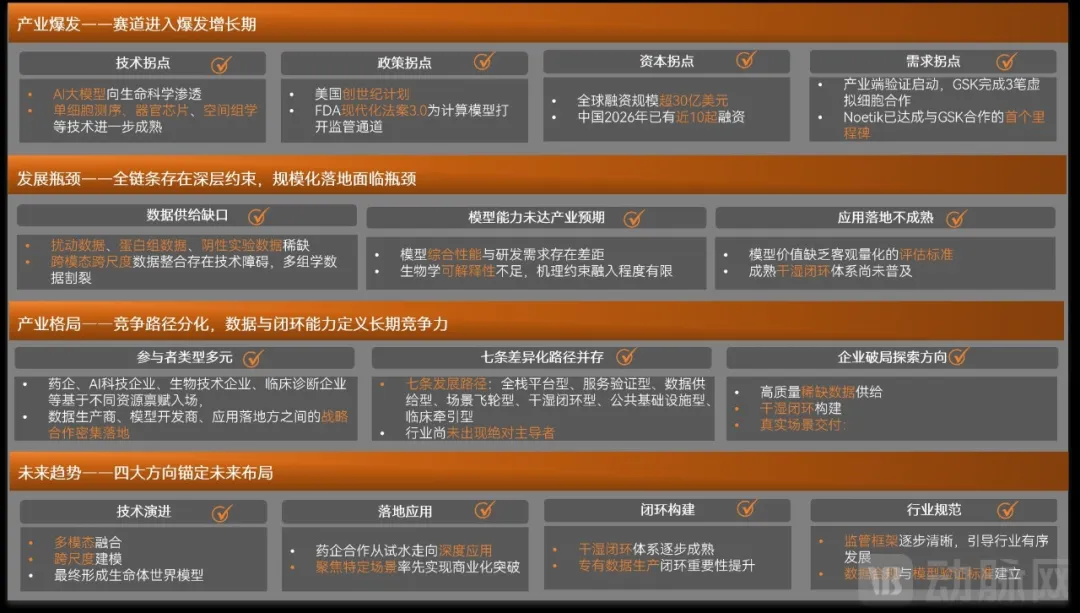
以下為白皮書內容節選:
01
爆發增長,
AI虛擬細胞開啟生命科學新範式
1、定義與三層技術架構
虛擬細胞(Virtual Cell)是指利用數學方程、物理模擬和AI技術,在計算空間中建構細胞行為的數位化模型,使研究者在不依靠實體濕實驗的條件下預測細胞對外部擾動(藥物、基因編輯、環境變化等)的響應。
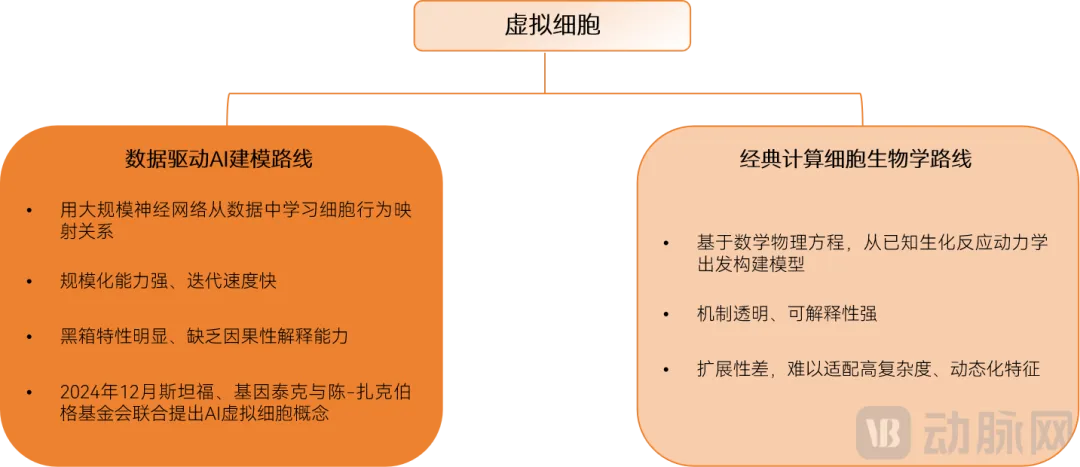
需要指出的是,虛擬細胞並非一個單一產品,而是一類技術體系的總稱。根據建模方法的不同,目前主要存在兩條技術路線。
資料驅動的AI建模路線,用大規模神經網路從資料中學習細胞行為的對應關係。規模化能力強、迭代速度快,但黑箱特性明顯,缺乏因果性解釋能力。2024年12月,史丹佛大學、基因泰克與陳-祖克柏基金會在《Cell》上聯合提出的AI虛擬細胞概念,是這一路線的代表性框架。
經典計算細胞生物學路線,基於數學物理方程,從已知的生化反應動力學出發建構模型。機制透明、可解釋性強,但擴展性差,難以適配真實生物系統的高複雜度、動態化特徵。
當前行業的前沿探索方向,是在資料驅動框架中融入生物機理約束,試圖兼顧規模化能力與可解釋性。
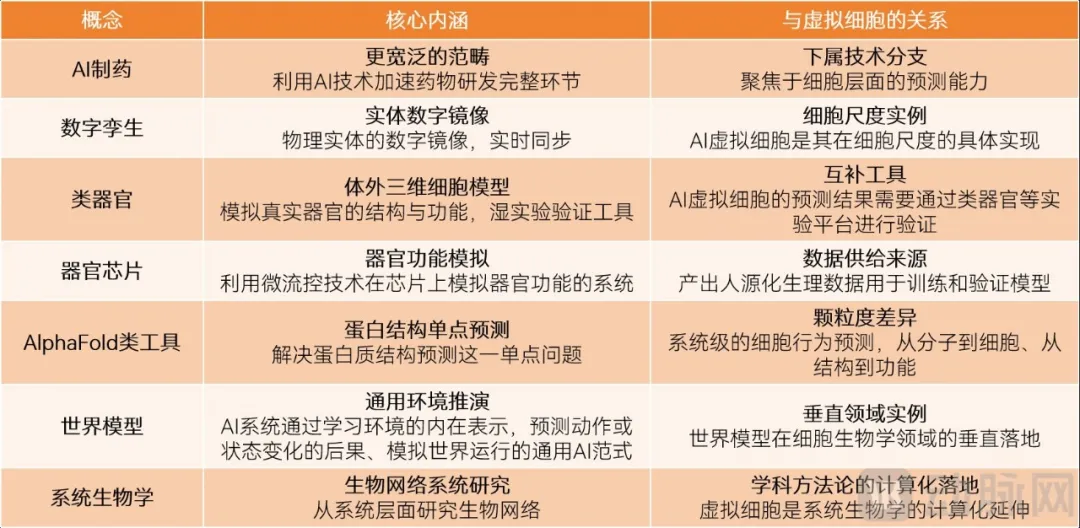
在討論AI虛擬細胞時,有幾個相近的概念有必要釐清邊界。
動脈智庫從技術建構到產業落地的實際流程,將AI虛擬細胞技術劃分為資料層、模型層、應用層三層架構,同時由閉環主動學習驅動持續進化。
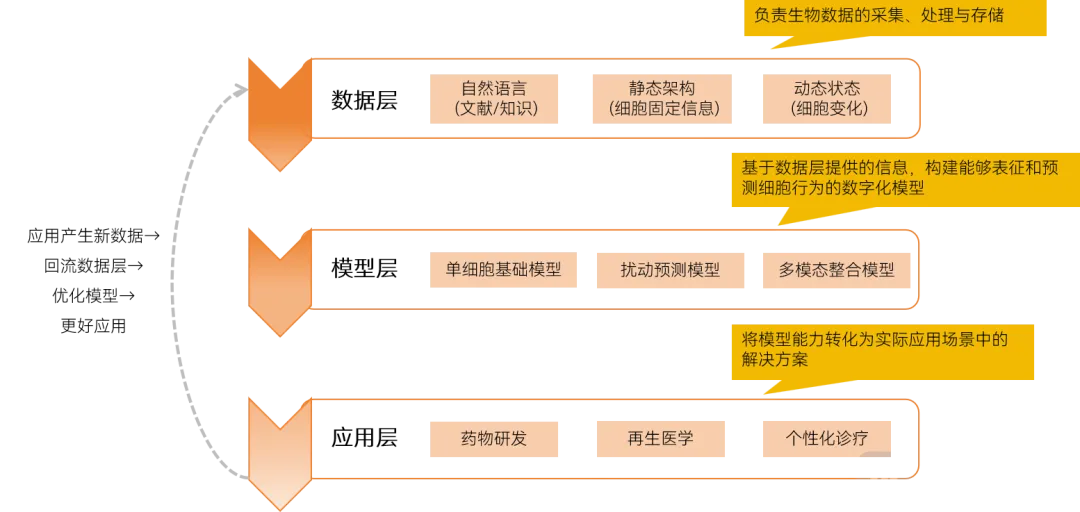
(1)資料層:先驗知識、靜態架構、動態狀態組成
先驗知識整合已發表的生物醫學文獻、已知的分子表達規律和多尺度成像資料,明確細胞生命活動的基礎規則。靜態架構收錄細胞形態結構、分子空間分佈等固定資訊,還原細胞固有物理特徵。動態狀態是建構具備真實推演能力模型的關鍵,聚焦細胞自然發育、衰老、藥物干預、基因編輯等外部擾動下的狀態變化,是支撐AI虛擬細胞實現動態模擬的核心資料底座。
(2)模型層:多類模型構成的能力矩陣
模型層基於資料層提供的資訊,建構能夠表徵和預測細胞行為的數位化模型,產品形態大致分為以下幾類。
細胞表徵模型是當前數量最多的類型。擾動預測模型是目前核心競爭方向,在單細胞基礎模型底座之上,針對性最佳化外部擾動響應建模能力,預判藥物、基因編輯等干預行為對細胞狀態的影響。多模態整合、跨尺度建模模型是長期演進方向,是貼合真實細胞生命活動規律、突破現有模擬精度瓶頸的必然發展趨勢。
(3)應用層:面向生命科學全鏈條的價值落地
應用層將模型能力轉化為實際應用場景中的解決方案,包括藥物研發領域,可覆蓋靶點發現與驗證、候選藥物虛擬篩選、藥效評估、毒性預測、適應症拓展等,以及再生醫學、合成生物學等領域。
(4)閉環主動學習:AI虛擬細胞的進化引擎
在資料層、模型層和應用層之間,存在一個關鍵的動態機制——閉環主動學習。
AI虛擬細胞在應用過程中自主識別模型認知缺口與預測不確定性區域,針對性設計基因編輯、小分子藥物處理等新型濕實驗方案,產出新資料,再將新增資料回流至資料層,驅動模型迭代最佳化。使AI虛擬細胞從靜態的預測工具,變為一個能夠持續逼近真實細胞行為的學習系統。
2、行業爆發窗口:技術、政策、資本、市場四維共振
技術拐點:AI建模與資料獲取技術的雙重突破。AI建模層面,AI大模型技術向生命科學領域滲透,行業擺脫人工預設生物規則的傳統模式,形成資料驅動、自主學習、動態推演的全新建模邏輯。資料獲取層面,單細胞測序、蛋白質組學、器官晶片等技術的逐步成熟,提供了不可或缺的燃料基礎。
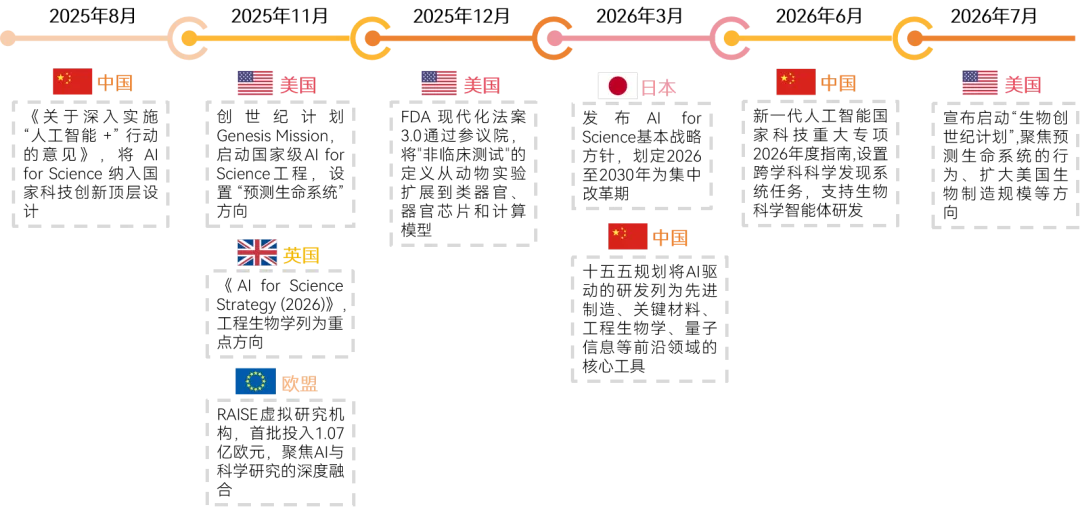
政策拐點:主要經濟體同步加碼AI for Science。2025年以來,美國、英國、歐盟、日本、中國等主要經濟體密集出台AI for Science政策,普遍將其上升為國家級戰略工程。
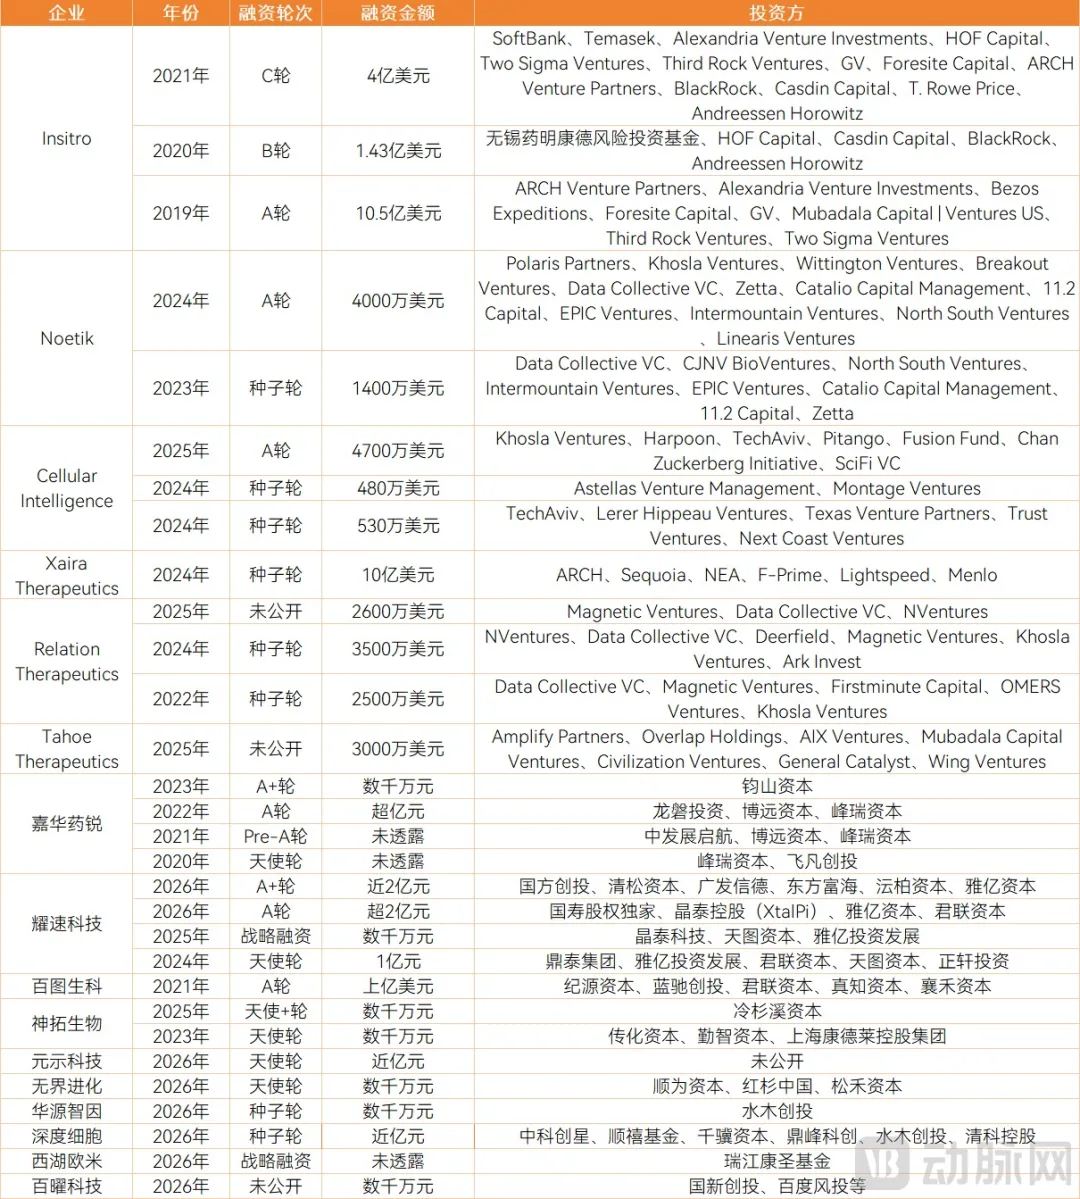
資本拐點:全球資本加速入局,產業資金條件逐步成熟。截至2026年8月底,全球AI虛擬細胞領域融資總規模突破30億美元,成為生命科學智能方向的重點投資賽道。國內市場後發加速,融資熱潮集中於2026年,呈現出早期化特徵。
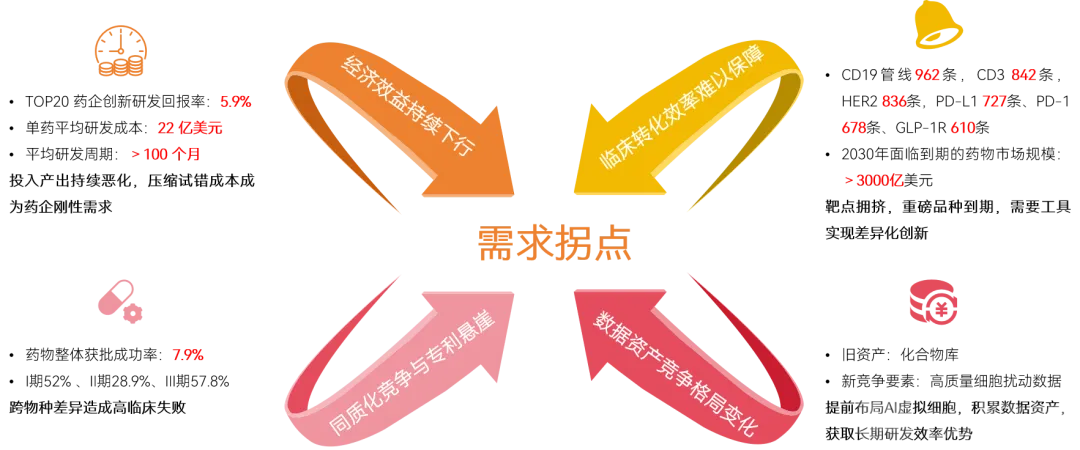
需求拐點:傳統研發體系承壓,行業迎來剛性需求。AI虛擬細胞的爆發,離不開傳統新藥研發體系長期積累的弊端。下游需求已經從前沿技術探索轉向實質性採購,這一變化由多重行業壓力驅動。
02
資料、模型、驗證矛盾待解,
規模化落地面臨瓶頸
在產業熱度之下,從資料生產、模型建構到場景驗證的全鏈條中,仍存在多項深層次矛盾。動脈智庫沿著資料、模型、應用三層產業鏈路,逐層拆解制約行業擴張的核心痛點,梳理現存約束。
1、資料層約束:高價值資料生產與標準化推高產業落地門檻
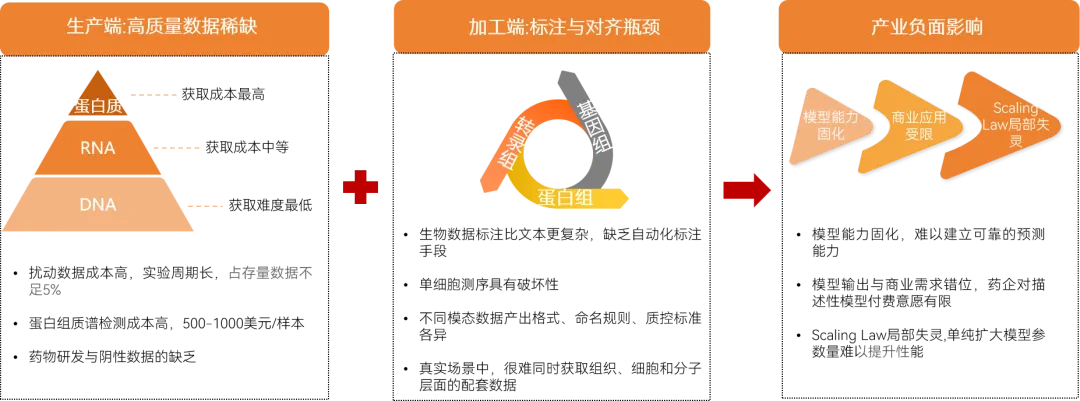
(1)生產端:擾動、蛋白與陰性資料供給不足
擾動資料成本高,實驗周期長,供給存在明顯缺口。擾動資料需要通過定向干預實驗產出,獲取成本高、實驗周期長,整體積累速度遠慢於靜態觀測資料,難以支撐模型持續迭代。
蛋白質資料獲取面臨成本與技術瓶頸,供給嚴重不足。在細胞資訊構成中,DNA僅承載約10%的靜態資訊,RNA反映約20%-30%的預備狀態,蛋白質的功能修飾承載超過60%的資訊權重。但質譜檢測成本尚未出現指數級下降趨勢,且蛋白覆蓋率有限,使得蛋白組學資料獲取的難度和成本都相對較高。
藥物研發與陰性資料的缺乏,對AI虛擬細胞模型性能也有重要影響。藥企內部的研發資料是模型學習真實藥物作用機制的核心素材。特別是陰性資料,覆蓋無效分子、毒性反應、失敗擾動等邊界場景,能夠提升真實研發場景中的預測穩定性與可靠性。但藥企內部研發資料通常不會對外共享,且行業慣例只留存陽性結果,大量失敗實驗資料被丟棄,公開資料清洗時也僅保留陽性結果,導致模型無法學習失敗邊界。
(2)加工端:標註與對齊兩大梗阻制約資料可用性
即便資料被生產出來,進入模型前的加工環節仍面臨雙重梗阻。生物資料標註遠比文字複雜,單個細胞狀態需同時標註基因表達譜、蛋白丰度、表觀遺傳狀態等多個維度,幾乎缺乏自動化標註手段,高度依賴專家。
跨模態、跨尺度資料對齊同樣困難。單細胞測序具有破壞性,測完一個組學後其他組學無法再測,天然難以實現模態對齊。跨資料來源對齊整合需要大量批次效應校正和歸一化處理,目前缺乏行業公認的統一流程。
資料層面的缺陷,會沿著模型能力、商業落地、規模效應形成負向傳導。首先,模型能力固化,難以建立可靠的預測能力,其次,模型輸出與商業需求錯位,藥企對描述性模型付費意願有限,再次,Scaling Law局部失靈,單純擴大模型參數量難以提升性能。
2、模型層瓶頸:通用架構與生物系統運行規律的結構性錯配
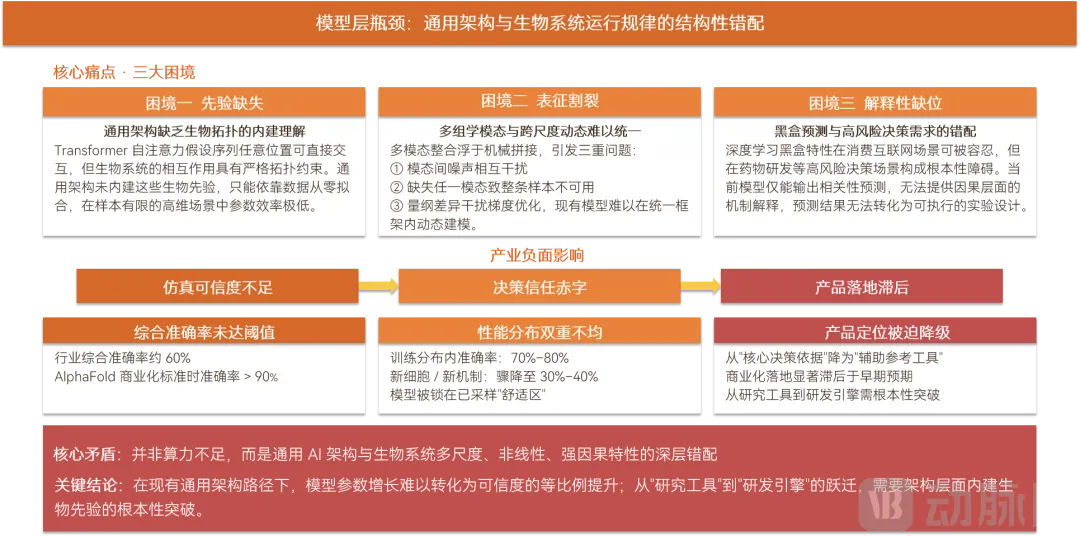
■ 困境一:先驗缺失,通用架構缺乏生物拓撲的內建理解
結構性先驗錯配誘發通用AI架構核心功能失效。Transformer的自注意力機制假設序列中任意位置均可直接互動,但生物系統的相互作用具有嚴格的拓撲約束。通用架構未內建這些生物先驗,只能依靠資料從零擬合。在樣本有限的高維生物場景中,參數效率極低。
■ 困境二:表徵割裂,組學模態與跨尺度動態難以統一
多組學資料格式不統一,跨模態整合停留在特徵拼接層面。 這引發了三重問題:其一,不同模態的噪聲相互干擾,高噪聲模態會稀釋低噪聲模態的有效訊號;其二,模型對模態完整性要求過高,缺失任一模態就會導致整條樣本不可用,資料利用率明顯下降;其三,不同模態的量綱與分佈差異干擾梯度最佳化,導致訓練不穩定。
時空尺度跨越多個數量級,現有模型難以同時實現分子到組織過程動態建模。
■ 困境三:解釋性缺位,黑盒預測與高風險決策需求的錯配
深度學習模型的黑盒特性在消費網際網路場景中通常不構成主要問題,但在藥物研發等高風險決策場景中會直接影響其可信度和實際採納。當前模型僅能輸出相關性層面的預測結果,無法提供因果層面的機制解釋,導致預測結果無法轉化為可執行的實驗設計。
模型層架構與生物規律的錯配,導致模型從核心決策依據退為輔助參考工具,商業化落地進度顯著滯後於早期市場預期,尚未跨過大規模商業化應用的門檻。
3、應用層挑戰:從技術驗證到產業落地之間的斷層
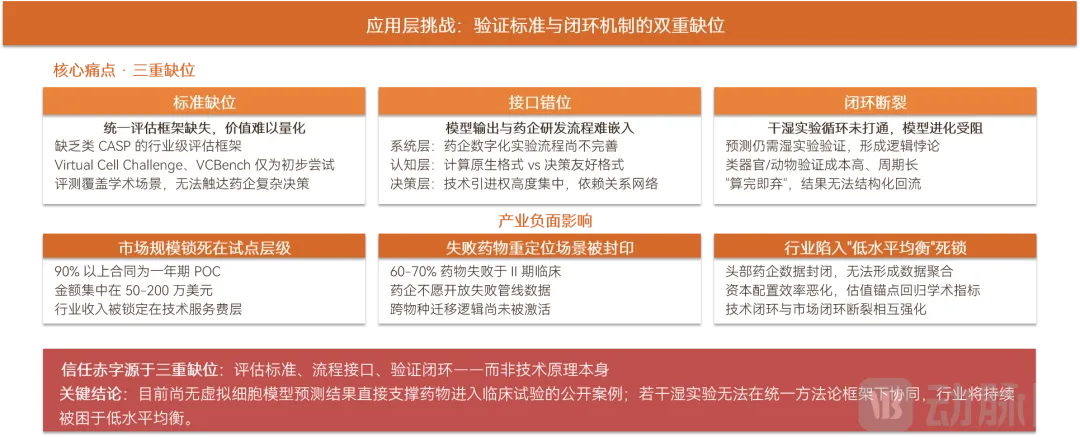
標準缺位,模型價值難以被客觀量化。AI虛擬細胞領域至今缺乏類似CASP的行業級統一評估框架。現有評測任務多為預定義、有限範圍的學術場景,無法覆蓋藥企實際面對的複雜決策情境。評估標準碎片化,導致不同模型之間難以橫向比較,藥企在技術選型時缺乏可靠參照。
介面錯位,模型輸出與藥企研發流程難以嵌入對接。系統層面,多數藥企數位化實驗流程尚不完善。認知層面,模型輸出多為計算原生格式,而研發團隊習慣消費決策友好格式,跨界人才稀缺導致對接高度定製化。決策層面,大型藥企技術引進決策權高度集中,早期合作往往依賴既有關係網路。三重錯位疊加,使商業化落地難以脫離項目制模式。
閉環斷裂,乾濕循環未打通,制約模型進化。AI虛擬細胞的核心價值是以計算預測替代濕實驗試錯,但當前模型預測結果的可靠性本身仍需濕實驗驗證。類器官、器官晶片或動物實驗等驗證路徑成本高、周期長,許多企業只能做到算完即棄,無法將驗證結果結構化回流至模型進行迭代最佳化。乾濕閉環的斷裂,使模型喪失了通過預測、驗證、反饋循環持續提升能力的關鍵機制。
03
競爭路徑分化,
資料與閉環能力決定長期競爭力
過去兩年間,一批企業和機構在資料基建、模型搭建和商業應用上展開了探索,針對行業痛點形成了多元化的技術突破路徑與落地解決方案。
本章基於行業發展現狀,系統盤點市場參與主體類型、產品形態與整體發展進度,建構企業能力全景圖譜,從資料、模型、應用三個層面梳理行業參與者的綜合實力與發展差異。
1、參與類型多元,形成七大差異化發展路徑
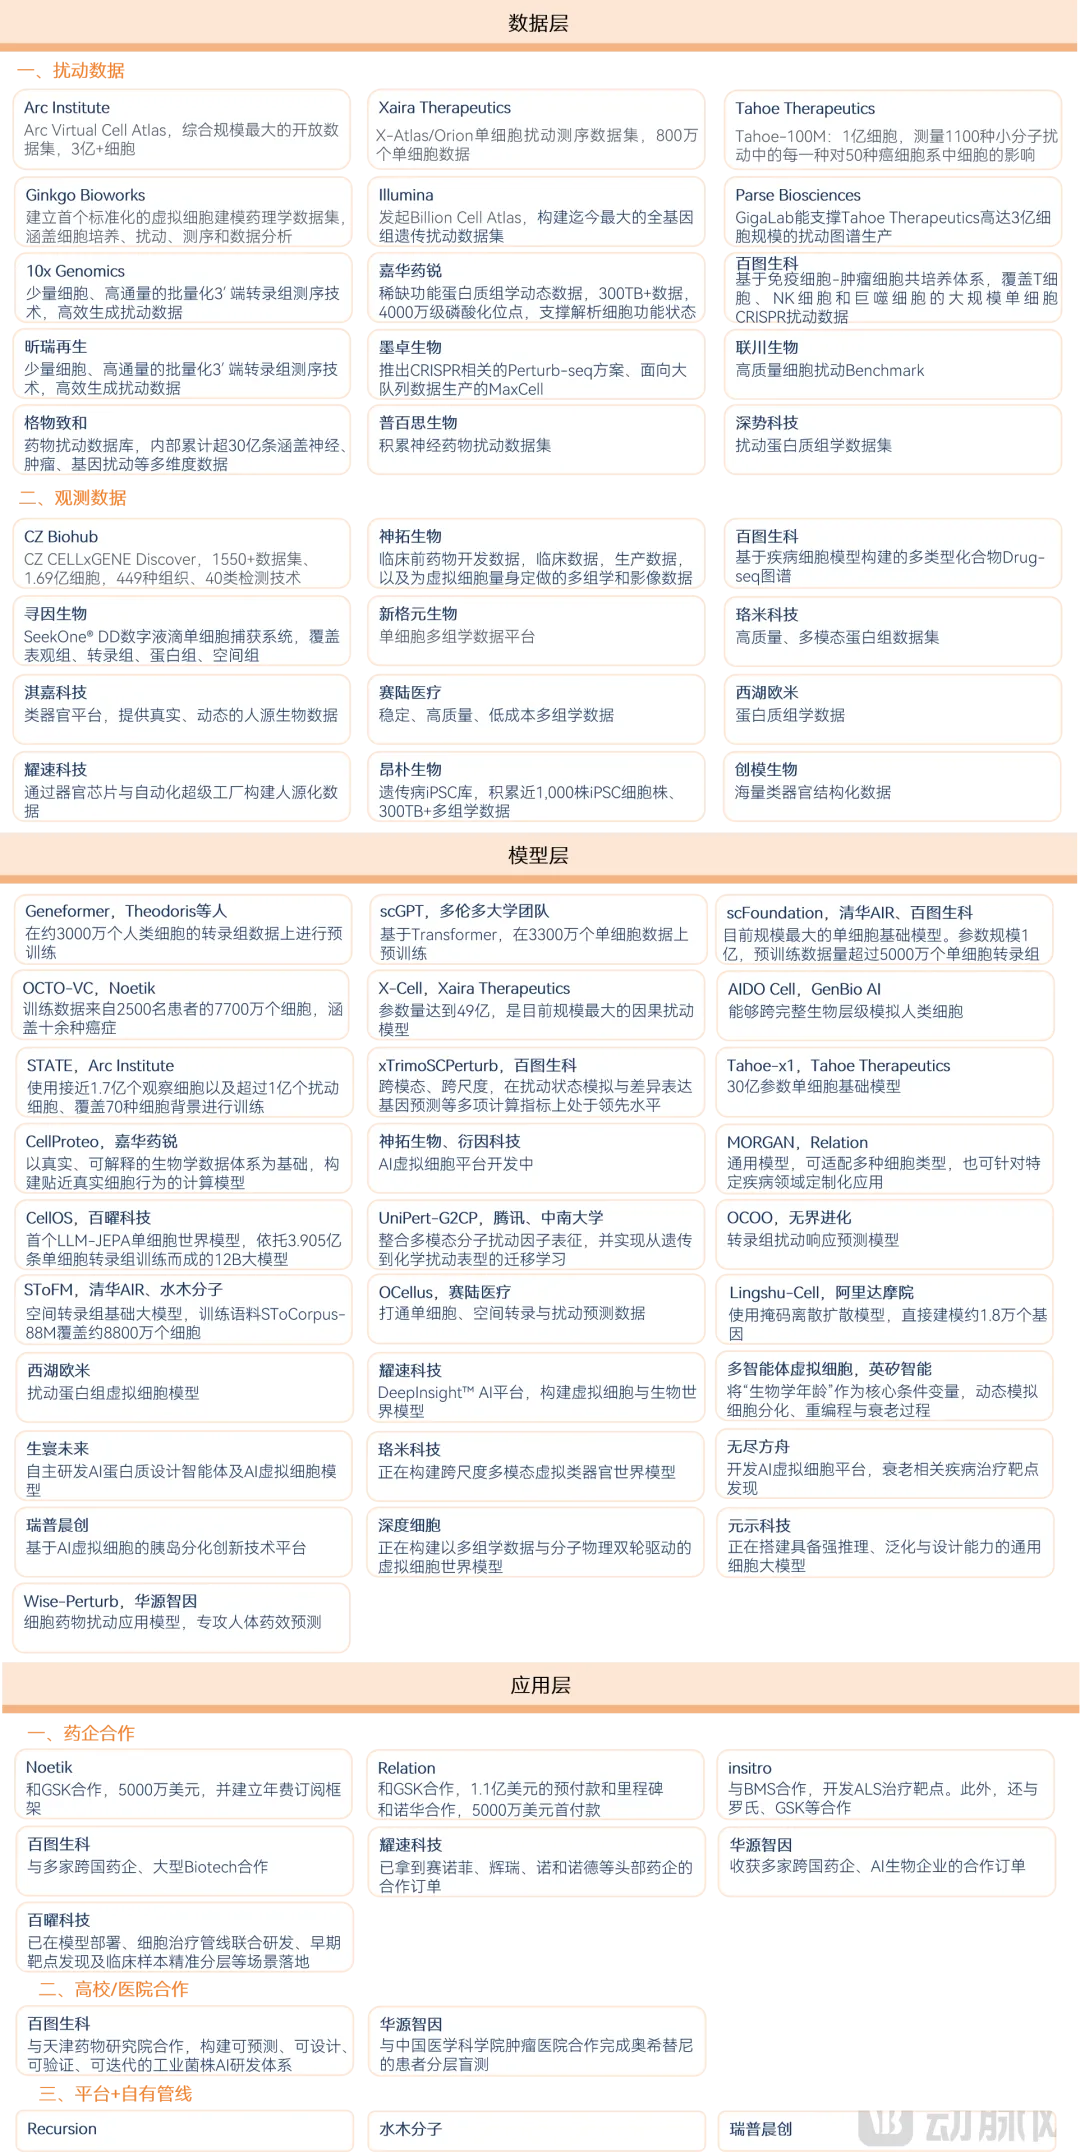
目前行業參與者類型多元、覆蓋維度廣泛,不同背景的企業與科研機構依據自身資源稟賦,分別在產業資料層、模型層、應用層形成差異化佈局,呈現出多點開花、協同發展的繁榮格局,尚未形成高度集中的競爭態勢,各類主體仍處於能力搭建與賽道卡位階段。
可以發現,業內企業雖處同一個賽道,選擇的發展路徑卻差異顯著,從上游資料供給到下游臨床應用,從技術驅動到需求拉動,從商業公司到非營利機構,不同參與者基於初始資源稟賦、資料獲取方式、技術切入邏輯與壁壘建設思路,形成了七條發展路徑,不少企業隨業務推進,會疊加多條發展路徑。
■ 路徑一、全端平台型:資本驅動的全鏈條佈局
該路徑先投入重金建設資料基礎設施和計算模型平台,形成從資料生成、模型訓練到管線推進的全鏈條能力,再通過自研管線或對外合作實現長期價值回報,入場門檻極高,需要大規模的前期資本投入,且回報周期較長。
■ 路徑二、服務驗證型:以藥企合作錨定技術價值
該路徑用跨國藥企的合作合同為自身技術定價,是當前行業認可度最高的技術驗證路徑之一。
■ 路徑三、資料供給型:將資料資產作為核心產品
該路徑打破資料作為實驗副產品的傳統定位,將生物資料打造為獨立商業化產品,通過自主搭建實驗體系規模化生產AI適配資料,供給模型研發企業。
■ 路徑四、場景飛輪型:用臨床場景驅動資料積累
該路徑將真實臨床場景作為資料入口,通過業務持續落地沉澱結構化資料,以資料迭代最佳化模型能力,再依託升級後的模型深化場景滲透,形成自我強化的正向循環,具備場景真實性強、資料維度貼合臨床需求的特點。
■ 路徑五、乾濕閉環型:物理實驗與計算模型互補
該路徑通過器官晶片濕實驗體系彌補純演算法建模的短板,建構AI預測、實驗驗證、資料回流、模型最佳化的閉環迭代體系,依託乾濕結合的差異化路徑形成獨特競爭優勢。
■ 路徑六、公共基礎設施型:搭建公共科研生態
該路徑以非營利科研機構為主,通過搭建公共資料平台、建立行業評測標準、組織產業學術賽事等方式建構行業基礎設施。
■ 路徑七、臨床牽引型:從臨床痛點反向定義能力
該路徑以臨床痛點為導向,先明確臨床診療、藥物研發中的實際問題,再針對性定義AI虛擬細胞模型的能力需求,通過適配的資料採集、演算法最佳化補齊技術短板,實現技術與場景的精準匹配。
2、資料層:從公開資料集到私有資產壁壘的建構
僅依靠公開資料集,不足以支撐具備產業實用價值的模型,必須依託定向產出的私有實驗資料完成訓練與校準,這推動一批專業化資料生產商快速切入AI虛擬細胞賽道。
發展現狀:專業化資料生產商快速崛起
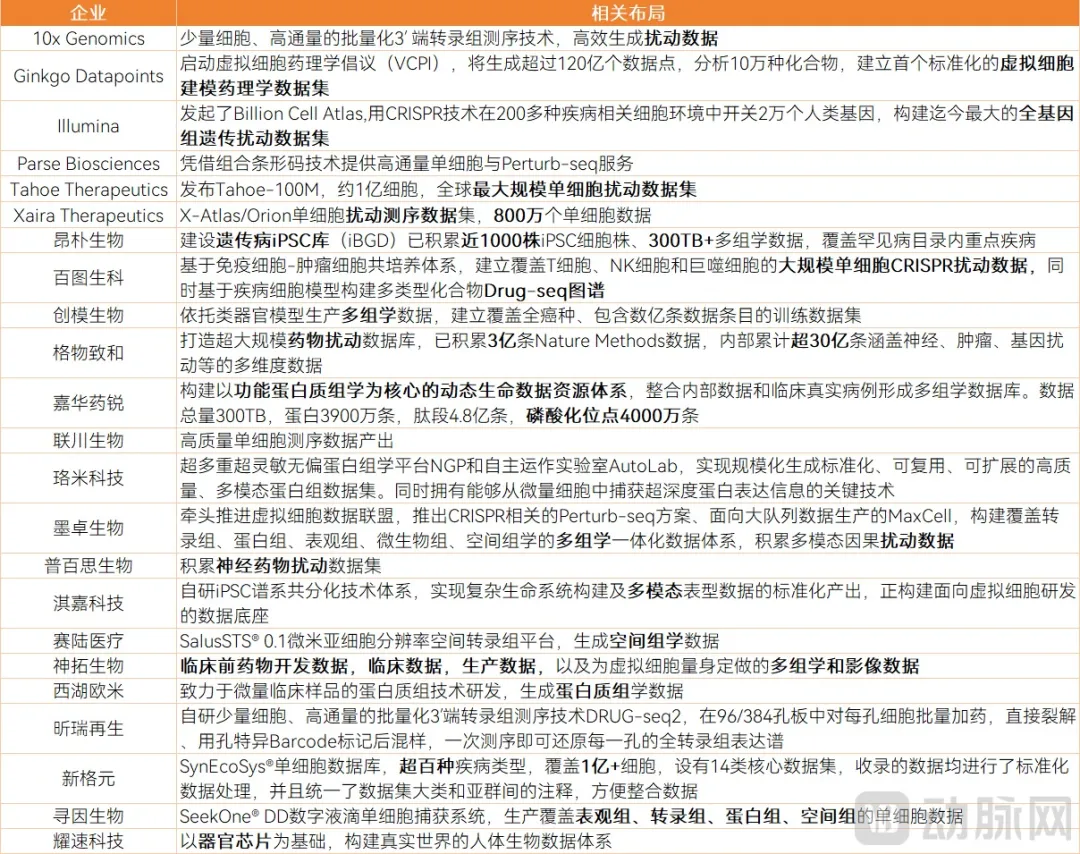
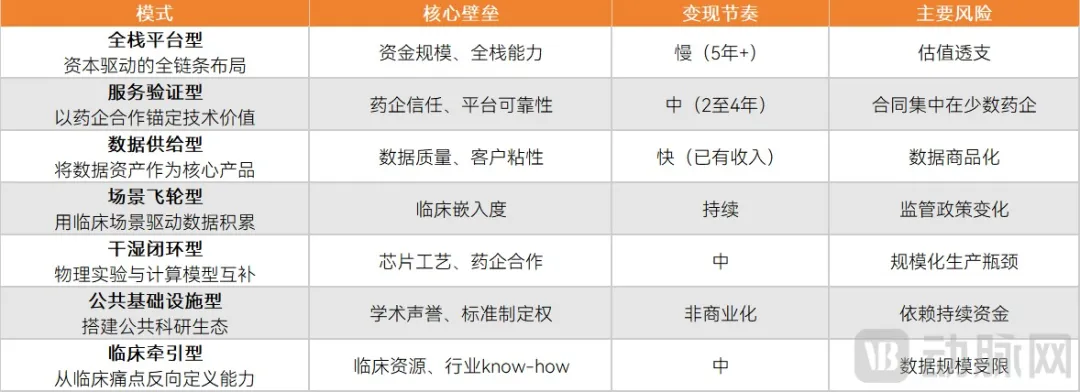
目前,資料供給端已經形成多元參與者矩陣。單細胞測序企業是重要資料來源,包括10x Genomics、尋因生物、墨卓生物、新格元等。類器官與器官晶片企業可產出貼近生理環境的細胞實驗資料,代表有耀速科技、淇嘉科技等;蛋白質組學企業依託自研質譜平台,產出轉錄組難以覆蓋的功能蛋白、翻譯後修飾資料,包括嘉華藥銳、西湖歐米等;部分生物醫藥企業也開始對外輸出資料資產,例如神拓生物這類體內治療技術企業,沉澱大量真實研發過程資料與失敗邊界資訊。
資料層的核心競爭要點集中在資料集積累速度與客戶遷移成本。一旦主體完成規模化、體系化的資料資產沉澱,後來參與者很難在短周期復刻同等體量與質量的資料資源。
單一模態資料很難完整還原細胞複雜運行邏輯,多組學融合的資料集合可以有效降低模型的認知偏差。業內資料生產商正積極通過跨主體合作補齊自身資料維度短板,淇嘉科技與賽陸醫療共建AI虛擬細胞資料訓練平台,耀速科技聯合珞米科技探索器官晶片疊加蛋白組學的資料體系,都是這一趨勢下的實踐案例。
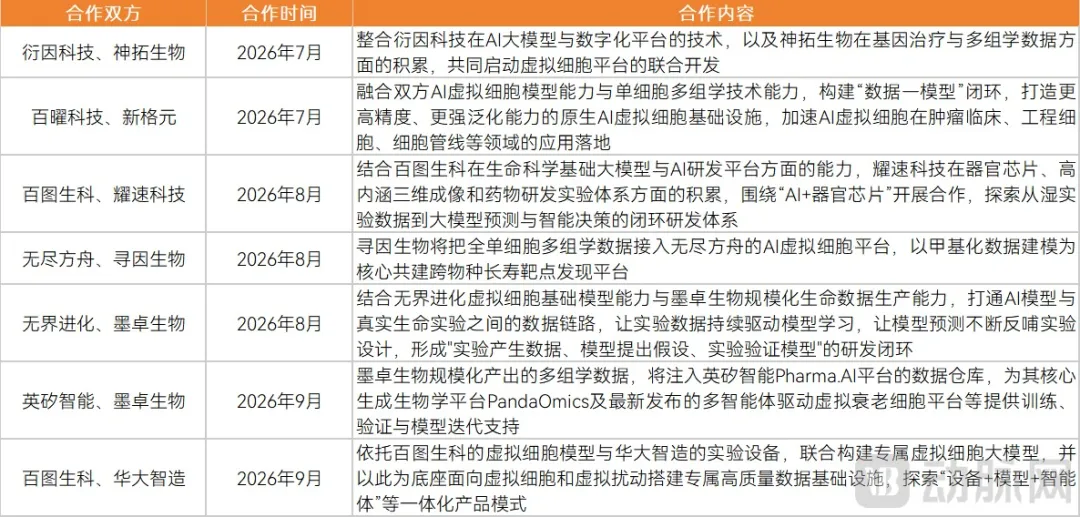
與此同時,模型開發企業也意識到了資料底座的價值,資料生產商已經成為模型開發與迭代不可或缺的外部合作夥伴。2026年賽道誕生多起產業合作,例如衍因科技與神拓生物,百圖生科與耀速科技,無界進化與墨卓生物,百曜科技與新格元,無盡方舟與尋因生物,英矽智能與墨卓生物,百圖生科與華大智造,資料層與模型層的繫結日益緊密。
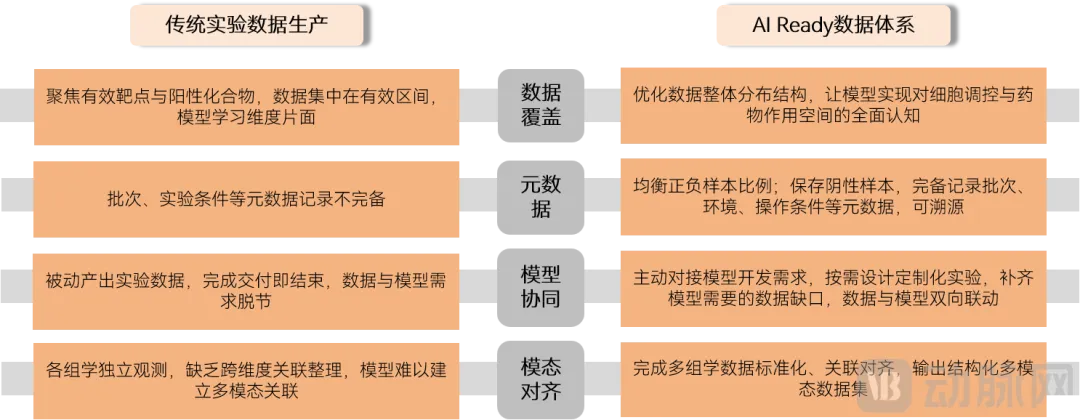
資料供給主體數量持續增長的背景之下,不可忽視的是,行業尚未建立統一的資料質量評判標尺,不同機構產出資料集的一致性、可復用性參差不齊。想要成為合格的AI虛擬細胞資料供給方,需要打造標準化的AI Ready資料體系,圍繞模型訓練訴求重構資料生產、整理與輸出邏輯。
首先,企業需要最佳化資料整體分佈結構。常規藥物設計實驗聚焦優質有效靶點與陽性化合物,資料樣本高度集中於有效區間,會導致模型學習維度片面,難以掌握完整的細胞作用規律。合格的資料生產需要主動拓寬樣本覆蓋範圍,均衡佈局全維度實驗空間,補齊無效、臨界狀態等薄弱資料區間,讓模型實現對細胞調控與藥物作用空間的全面認知。
其次,需要重構樣本建構規則,重視全量實驗資料與配套資訊的留存。傳統研發場景僅關注陽性有效樣本,大量具備研究價值的陰性樣本被捨棄,資料生產商需要合理最佳化正負樣本比例與分佈結構,留存實驗批次、環境參數、操作條件等中繼資料,完善資料溯源體系,這是傳統實驗場景無需關注、卻是AI模型訓練不可或缺的內容。
同時,資料生產商需要建立資料與模型的協同思維,擺脫被動生產實驗資料的模式。企業需要精準匹配模型迭代需求,瞭解模型訓練的資料短板與最佳化方向,以低成本、高品質的定製化實驗方案,補齊模型所需的關鍵資料,實現資料生產與模型開發的聯動。
最後,需要具備多組學多模態資料的對齊與整合能力。AI虛擬細胞模型的高精度訓練,依託於多維度生物資料的關聯匹配。資料生產商需要針對性設計多類型擾動實驗,統一多組學資料觀測標準,梳理不同維度資料的內在關聯,完成多模態資料的標準化對齊與結構化整理。
但AI Ready資料體系的落地將顯著推高實驗與人力成本,對企業資源能力要求較高,多數中小企業難以承擔,未來資料供給端大機率迎來一輪淘汰整合。
資料層創新方案:面向模型訓練需求,補齊關鍵資料短板
面對AI虛擬細胞對特殊類型資料的迫切需求,產業端已經湧現多項創新解決方案,針對性緩解跨模態跨尺度資料難以對齊、擾動資料稀缺、大規模功能蛋白組獲取困難、藥物研發陰性資料不足等行業痛點。
(1)跨模態跨尺度資料對齊
多組學、多尺度資料的對齊融合是一大現實難題。百圖生科是行業內少數已經落地跨尺度、跨模態資料對齊能力的企業,xTrimo生命科學基礎大模型已覆蓋DNA、RNA、蛋白質、小分子、細胞、多細胞及複雜生物系統等,公司通過三個層面建構多模態、多尺度資料的統一建模能力。
第一,通過中間模態建立跨模態關聯。 在當前實驗約束條件下,採用中間模態作為橋樑完成模態關聯,借助同一套細胞樣本下的視覺中間模態,分別建立視覺‑轉錄組、視覺‑蛋白組兩組配對關係,間接實現轉錄組與蛋白組之間的資料對齊。
第二,將各類異構生物資料投射至統一的生物狀態空間,不同來源、不同尺度的資料在同一個模型空間完成表徵學習。即便部分樣本缺少直接配對的實驗測量,依然可以依靠共享的生物狀態表徵,在模型內部彌補物理實驗層面的資料對齊短板。
第三,進一步引入生物機制知識輔助模態關聯推理。通過建構基因調控網路,解析基因與蛋白之間的調控邏輯;依託蛋白質相互作用網路,還原分子層面的訊號傳遞關係,以已知生物學機理約束不同模態之間的對應關係。
(2)擾動組學資料生產:高通量技術推動因果資料規模化
擾動資料是訓練具備因果推斷能力模型的關鍵素材,當前整體供給稀缺。Perturb-seq、CROP-seq等高通量技術的發展,能夠同時對數千個基因進行功能性擾動,並在單細胞解析度上讀取轉錄組響應,為訓練具有因果推斷能力的模型提供資料基礎。
海內外多家企業正在佈局擾動資料集生產。10x Genomics憑藉少量細胞、高通量3′端轉錄組測序技術,實現擾動資料的高效生成;Illumina推出Billion Cell Atlas項目,依託CRISPR技術在200余種疾病相關細胞環境中開關兩萬個人類基因,建構規模領先的全基因組遺傳擾動資料集。
但多數企業並未對外披露擾動資料集實際規模,高通量擾動實驗成本高、流程複雜,大規模、低成本、標準化的擾動資料生產體系尚未成熟,擾動資料的規模化產出會是後續行業重點觀察方向。
(3)蛋白質組學:高靈敏度技術突破功能蛋白檢測瓶頸
針對傳統蛋白質組檢測存在樣本門檻高、檢測通量有限、成本高昂,難以大規模產出訓練資料的痛點,嘉華藥銳微量蛋白平台,單一細胞可鑑定到超過3800種蛋白,並且依託自研SH2超級結合蛋白可捕獲低丰度酪氨酸磷酸化訊號,該能力在全球範圍內尚無其他平台可實現。
酪氨酸磷酸化資料作為細胞訊號通路的直接讀出,能夠在資料量有限的情況下高效反映細胞的功能狀態變化,為AI虛擬細胞提供反映細胞動態功能狀態的重要資料維度。
目前,嘉華藥銳搭建起以功能蛋白組學為特色的多組學資料庫,累計資料總量300TB,包含蛋白3900萬條,肽段4.8億條,磷酸化位點4000萬條,為AI虛擬細胞提供高品質的訓練素材。
(4)細胞與基因治療:補齊藥物研發資料的關鍵缺口
面對真實藥物研發過程資料,以及研發失敗案例這類陰性資料缺乏的問題,細胞與基因治療企業深耕細胞生物學機理,擁有體內實驗完整鏈路,具備天然的資料供給優勢,其積累的體內藥效資料、動物模型資料和陰性資料,可以完善資料層的研發場景拼圖。
以神拓生物為代表,企業佈局體內CAR‑T管線,積累了大量臨床前研發、生產以及部分臨床相關資料,同時產出專門適配AI虛擬細胞訓練的多組學與影像資料,把藥物研發實踐中沉澱的認知轉化為可復用的資料資產。
3、模型層:從狀態表徵走向擾動預測,多技術路線平行
當前AI虛擬細胞行業的模型開發主體呈現多元格局,包含AI科技企業、生物技術企業、高校與科研機構,同時部分創新藥企也在開展模型自研,尚未出現絕對主導者,跨界合作與競爭並存是這一階段的基本特徵。
發展現狀:規模擴張,進入擾動預測模型競速階段
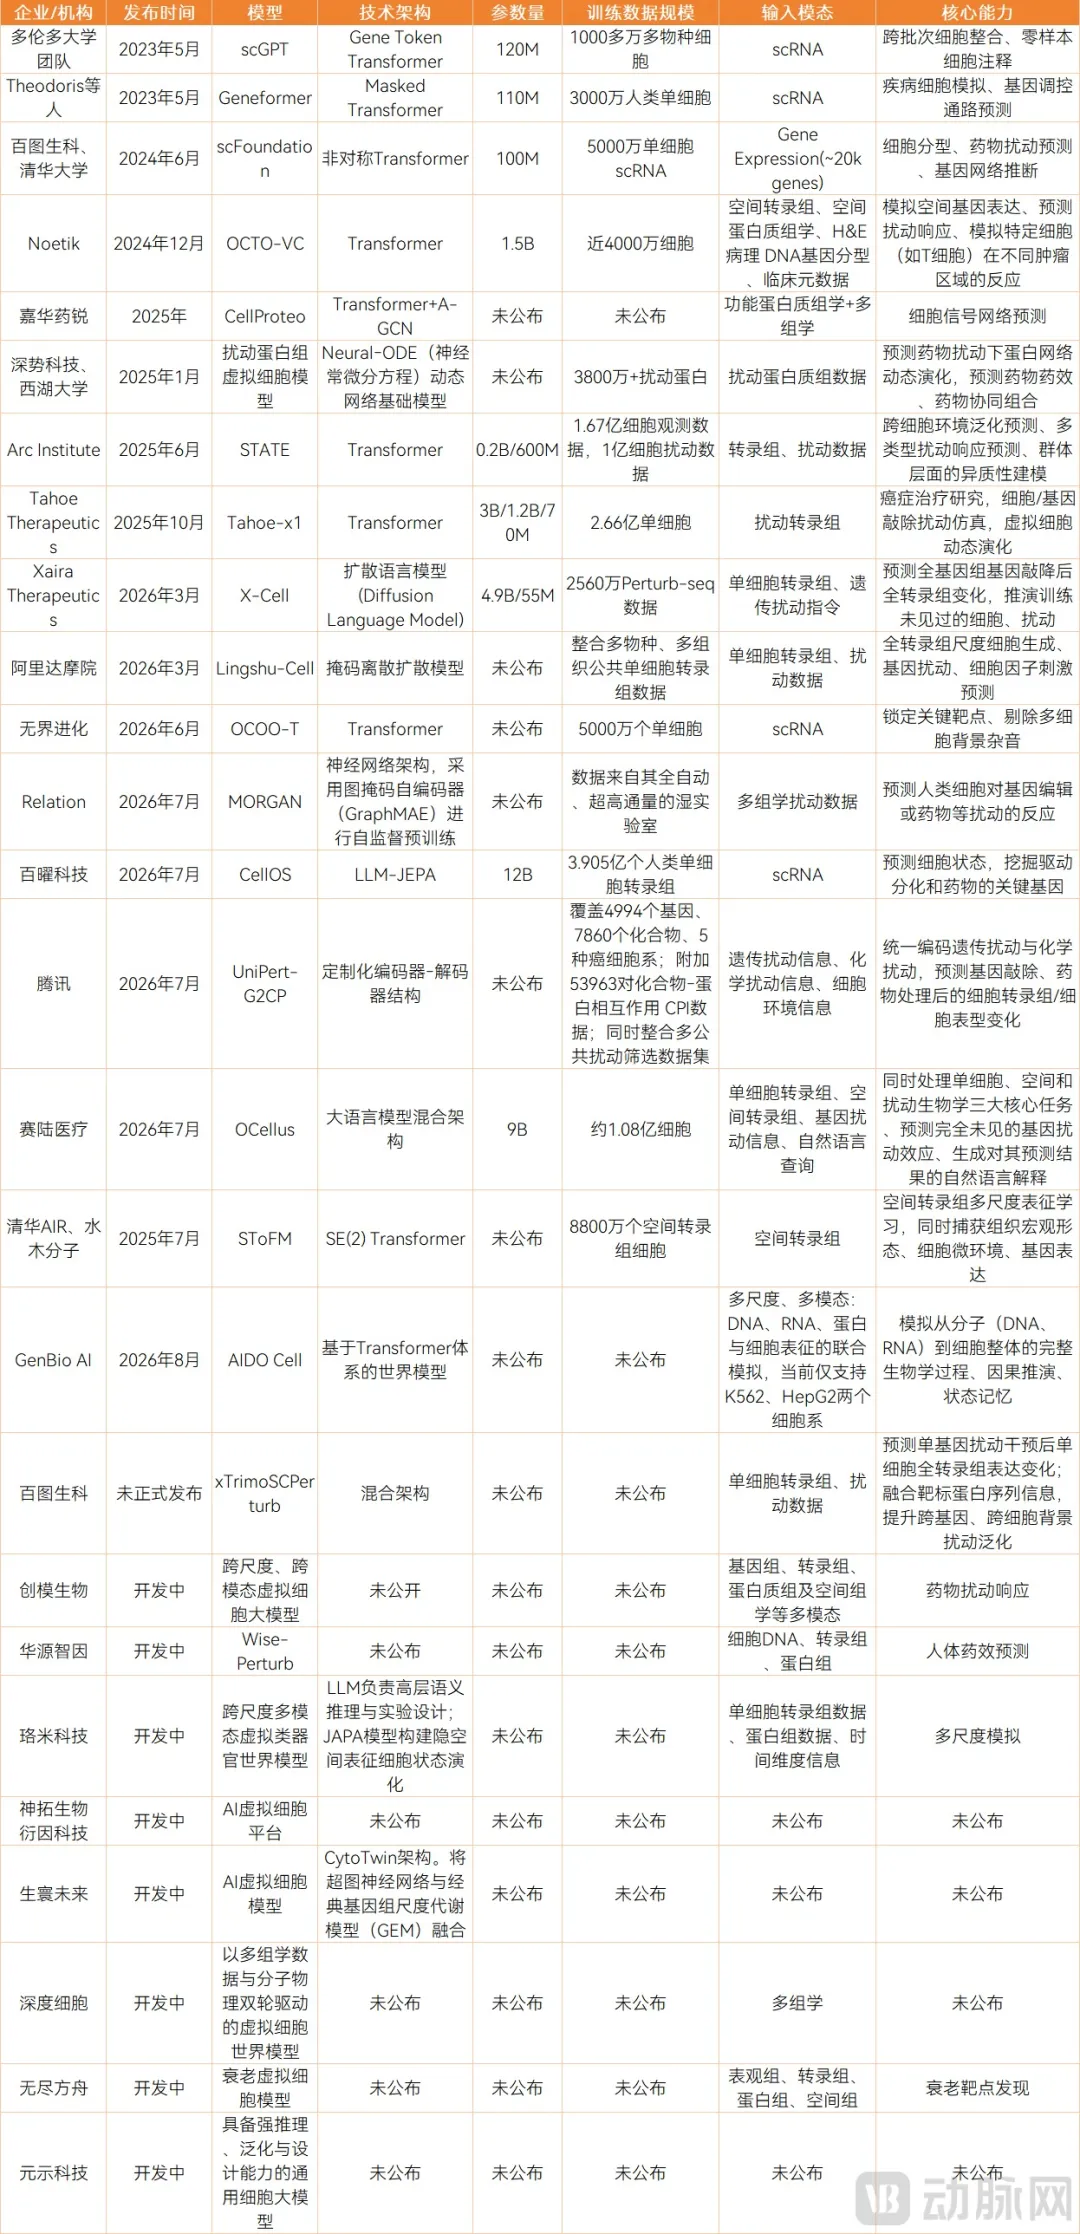
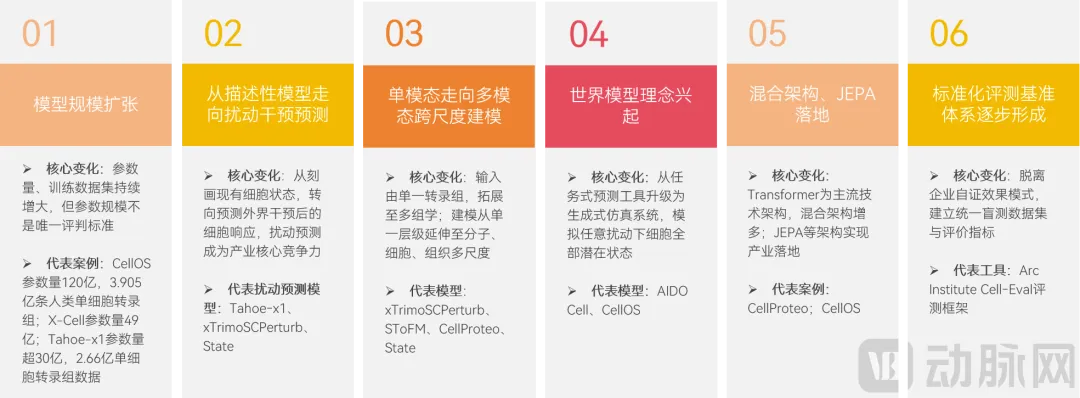
模型規模的快速擴張是近年來最直觀的變化。AI虛擬細胞模型呈現參數量擴大、訓練資料集規模持續提升的趨勢。CellOS參數量達120億,依託3.905億條人類單細胞轉錄組訓練;X-Cell參數量達49億;Tahoe-x1參數量超過30億,整合2.66億單細胞轉錄組資料訓練。但參數量和訓練規模並非衡量模型實用價值的決定性指標,面向擾動任務的資料質量、評測設計與生物學機理約束,往往比單純參數規模更能決定模型落地效果,行業也逐步擺脫一味追求大參數的思維,更加看重模型在真實研發任務上的實際表現。
研究重心正從描述性模型轉向預測性、干預性模型。早期研究的核心任務是描述細胞狀態,Geneformer、scGPT、scFoundation等基礎模型均屬於這一類型。2024年以後,研究重心轉向預測,預測藥物或基因擾動後細胞會發生怎樣的變化,代表模型包括Tahoe-x1、xTrimoSCPerturb、State等。藥企在實際藥物研發過程中,不再僅需要知道細胞本身是什麼狀態,更希望獲取藥物、基因編輯等外界干預之後細胞會如何變化,可以說擾動預測能力決定AI虛擬細胞的產業價值,因此成為當前模型層競爭的關鍵類股。
從單模態向多模態、跨尺度模型演進是另一條重要主線。早期模型多以單細胞轉錄組單一模態為輸入,隨著多組學技術的成熟,越來越多的模型開始整合轉錄組、蛋白質組、空間組學、表觀基因組等多維度資料。xTrimoSCPerturb融入蛋白質模型嵌入作為擾動條件,SToFM整合空間資訊,CellProteo則以功能蛋白組學資料為核心輸入。多尺度建模也成為重要方向:從分子層面到細胞層面再到組織層面,建構多層次的細胞行為模擬能力,State的基因-細胞-群體三層架構就是典型代表。
另外值得關注的是世界模型架構的興起。2026年以來,將世界模型理念引入AI虛擬細胞建模成為重要趨勢。當世界模型應用於細胞建模時,AI虛擬細胞不再僅僅是一個預測工具,而是一個能夠模擬細胞在任意擾動下所有可能狀態的生成式系統。AIDO Cell和CellOS都是基於世界模型架構。
模型層創新方案:面向擾動預測、多模態融合的最佳化
動脈智庫注意到,模型層已經湧現出多個創新解決方案,從不同角度回應了行業在預測精度、多模態融合和跨尺度建模方面的痛點。
■ State:多尺度架構實現擾動預測的跨越式提升
State由Arc Institute團隊開發,最核心的創新在於多尺度三層架構設計:基因水平為每個基因學習嵌入向量,捕捉基因功能關係;細胞水平採用State Embedding(SE)模型,基於雙向Transformer在1.67億細胞上預訓練,用於壓縮細胞轉錄組狀態並過濾技術噪聲;群體水平的State Transition(ST)模型是最具突破性的部分,在超過1億個細胞的擾動資料上訓練,不單獨觀察一個細胞,而是同時分析一組相同條件下的細胞,通過捕捉細胞間的差異和共性,精確分離真正的擾動效應和背景噪聲。
State在性能表現上實現了顯著提升。在化學藥物擾動資料集(Tahoe-100M)上,State 區分不同擾動效應的能力提升了66%,預測基因表達變化的皮爾遜相關係數提升了91%。在細胞因子訊號擾動資料集(Parse-PBMC)上,State區分能力提升了29%,相關性提升了48%。在基因編輯擾動資料集(Replogle-Nadig)上,State區分能力提升了10%,相關性提升了10%。
■ xTrimoSCPerturb:首屆虛擬細胞挑戰賽冠軍
xTrimoSCPerturb由百圖生科研發,是基於單細胞預訓練建構的擾動預測模型。在Arc Institute發起的全球首屆虛擬細胞挑戰賽中,xTrimoSCPerturb從114個國家、1200余支隊伍中脫穎而出,奪得冠軍。
xTrimoSCPerturb的技術特點體現在工程最佳化的深度上。模型依託xTrimo單細胞基礎大模型底座,將xTrimo蛋白質模型的嵌入資訊作為擾動條件引入建模流程,同時採用多重混合損失策略,提升擾動狀態模擬與差異表達基因的預測精度。特別的是,團隊對模型架構與訓練策略進行了雙重升級,通過演算法最佳化解決了傳統模型因測序深度不足導致的低表達基因預測難題,並提升了基因調控關係的AI化解析能力。
■ CellProteo:功能蛋白組學增強的差異化路線
CellProteo由嘉華藥銳研發,定位為功能蛋白質組學增強型虛擬細胞平台。其差異化優勢在於以功能蛋白質組學資料為基石,整合多組學資訊,從資料維度上建構了獨特的競爭壁壘。
模型直接在多細胞尺度進行資料收集和建模,避免了單細胞模型資料採集不足,可解釋性差的缺陷,另外,採用分層設計的混合架構,一方面利用Transformer框架處理分子序列資訊,另一方面借助圖神經網路(GCN)對細胞內部訊號網路進行建模,動態模擬採用Neural ODE,兼顧預測效果與通路層面的可解釋性,還原更加貼近真實生理環境的細胞響應,面向創新藥研發、精準醫學提供計算決策支撐。
4、應用與驗證層:商業化處於早期,乾濕閉環構築長期進化壁壘
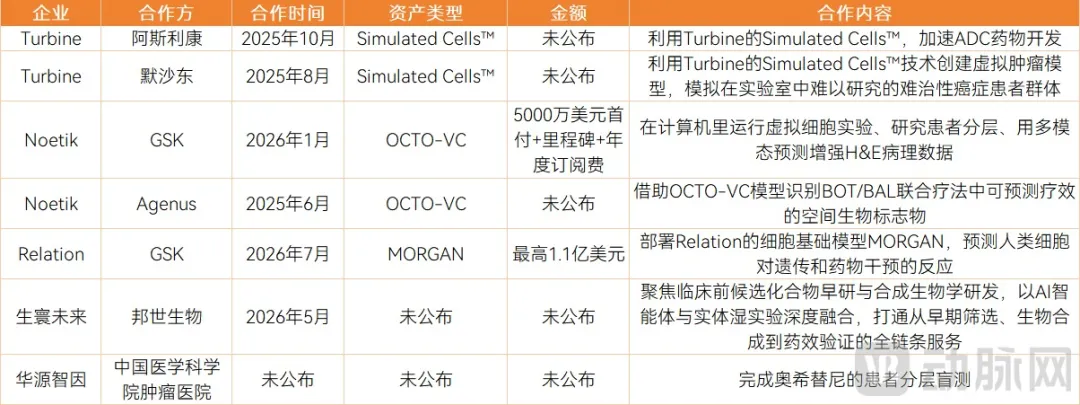
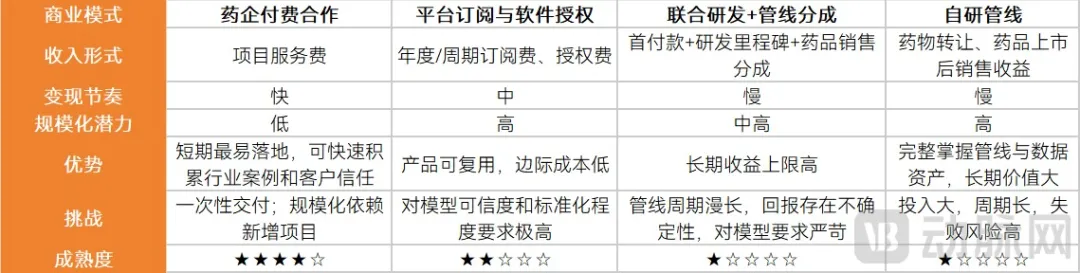
AI虛擬細胞行業商業化落地路徑可分為四類。藥企付費合作是目前行業收入的主要來源,能夠快速實現技術商業價值兌現;平台訂閱與軟體授權可復用性強、邊際成本低,是中長期被普遍看好的方向,但對模型可信度和標準化程度要求極高。
從應用場景來看,當前落地場景高度集中於藥物研發領域,其中靶點發現、藥物擾動效果預測是落地最紮實、產業認可度最高的兩大細分方向,兩者都有明確的付費方和可量化的交付標準。
一個值得關注的新興方向是細胞與基因治療場景。AI虛擬細胞在細胞與基因治療領域的落地相對空白。與小分子藥物不同,細胞與基因治療的干預對象就是細胞本身,基因編輯、載體遞送、細胞重程式設計等操作的效果依賴對細胞狀態的精確理解,這與AI虛擬細胞模型能力高度匹配。細胞與基因治療有望成為繼靶點發現和擾動預測之後,下一個具備規模化落地條件的場景。
商業模式的可持續運轉,依賴於一個底層能力:乾濕閉環。乾濕閉環的意義不止是驗證模型精度,更是驅動模型持續進化的核心引擎。
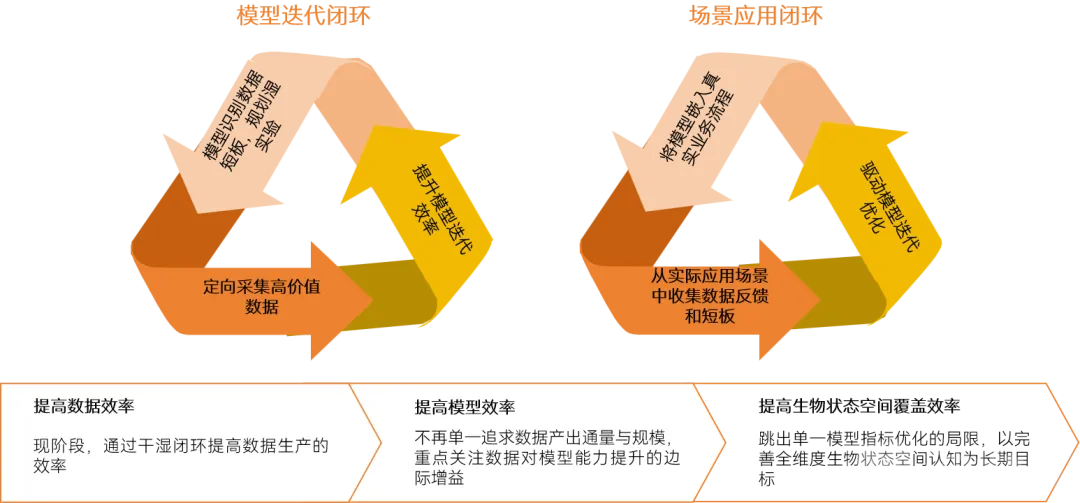
隨著行業的發展,乾濕閉環的內涵也在深化,從簡單的“AI預測-濕實驗驗證-資料回流-模型最佳化”,演進為更精細的多層閉環體系,包括模型迭代閉環與場景應用閉環。
模型迭代閉環,核心特徵是模型主動指導資料生產方向。模型可自主識別自身預測短板與資料缺口,主動規劃濕實驗的擾動條件、觀測維度與實驗範圍,定向採集對模型性能提升增益最大的高價值資料,精準提升模型迭代效率。
場景應用閉環則聚焦產業落地全鏈路,將模型嵌入藥物研發、工業生物製造等真實業務流程,從實際應用場景中收集反饋資料、挖掘技術短板,反向驅動模型迭代最佳化。
乾濕閉環體系的目標是實現三重效率的提升。目前處於提高資料效率階段,通過乾濕閉環提高資料生產的效率。接下來,從資料效率切換到模型效率。行業不再單一追求實驗資料產出通量與資料規模,重點關注資料對模型能力提升的邊際增益。之後,從模型效率切換到生物狀態空間覆蓋效率。跳出單一模型指標最佳化的侷限,以完善全維度生物狀態空間認知為長期目標,全面提升模型各類下游任務的泛化能力。
當前行業能夠搭建有效乾濕閉環的企業仍屬少數,純演算法企業只有干端推演能力,傳統生物企業只有濕端實驗能力。目前乾濕閉環佈局者分為兩類,一類是濕實驗企業向上延伸,以器官晶片、高通量實驗能力為基礎,疊加AI建模能力建構閉環。另一類是AI模型企業從計算端出發向下延伸建構閉環。
應用與驗證層創新方案:交付部署與乾濕閉環的產業實踐
動脈智庫注意到,已有企業在應用落地和乾濕閉環建構上形成了值得關注的創新實踐。
(1)Noetik:與GSK達成首個合作里程碑
2026年8月,Noetik宣佈達成與GSK合作的第一個里程碑——完成OCTO-VC模型推理與微調能力在GSK側的交付部署並通過測試標準,證明了AI虛擬細胞模型具備跨平台部署的能力,僅需少量GSK自有專屬資料進行微調,就能生成高精準度、高特異性的預測結果。對於整個行業而言,Noetik的里程碑完成意味著AI虛擬細胞模型不再只是一個科研工具,而是能夠通過藥企嚴格測試標準的商業化產品,將直接影響其他藥企對類似合作的評估標準。
(2)百圖生科:小閉環起步,建構跨模態跨尺度的乾濕閉環體系
百圖生科在乾濕閉環上的實踐具有代表性。其策略是把模型能力和實驗驗證相結合,借助乾濕閉環進行持續迭代和升級。具體路徑是用大模型做擾動預測,然後通過自有細胞實驗室進行高通量實驗驗證,把結果反饋回模型進行迭代最佳化。公司已形成了單細胞領域的乾濕閉環能力,正在逐步擴展到跨尺度、跨模態的乾濕結合閉環。
在產業落地層面,百圖生科依託生命科學基礎大模型、虛擬細胞建模與乾濕閉環驗證體系,與天津藥物研究院合作,啟動面向工業菌株研發場景的虛擬細胞乾濕閉環合作項目,圍繞工業菌株建模、靶點篩選、代謝網路預測與實驗驗證等關鍵環節,建構可預測、可設計、可驗證、可迭代的工業菌株AI研發體系。 (動脈網)