
RSI來了!
我們的模型正式超越了我。我已經沒什麼能再教它的了。是時候去追尋我的咖啡師夢想啦 :) ☕
說出這番話的人,是Google DeepMind研究員 Zirui Wang。
他的履歷從CMU到Apple Foundation Models再到xAI,最後落腳DeepMind,妥妥的AI圈「六邊形戰士」。
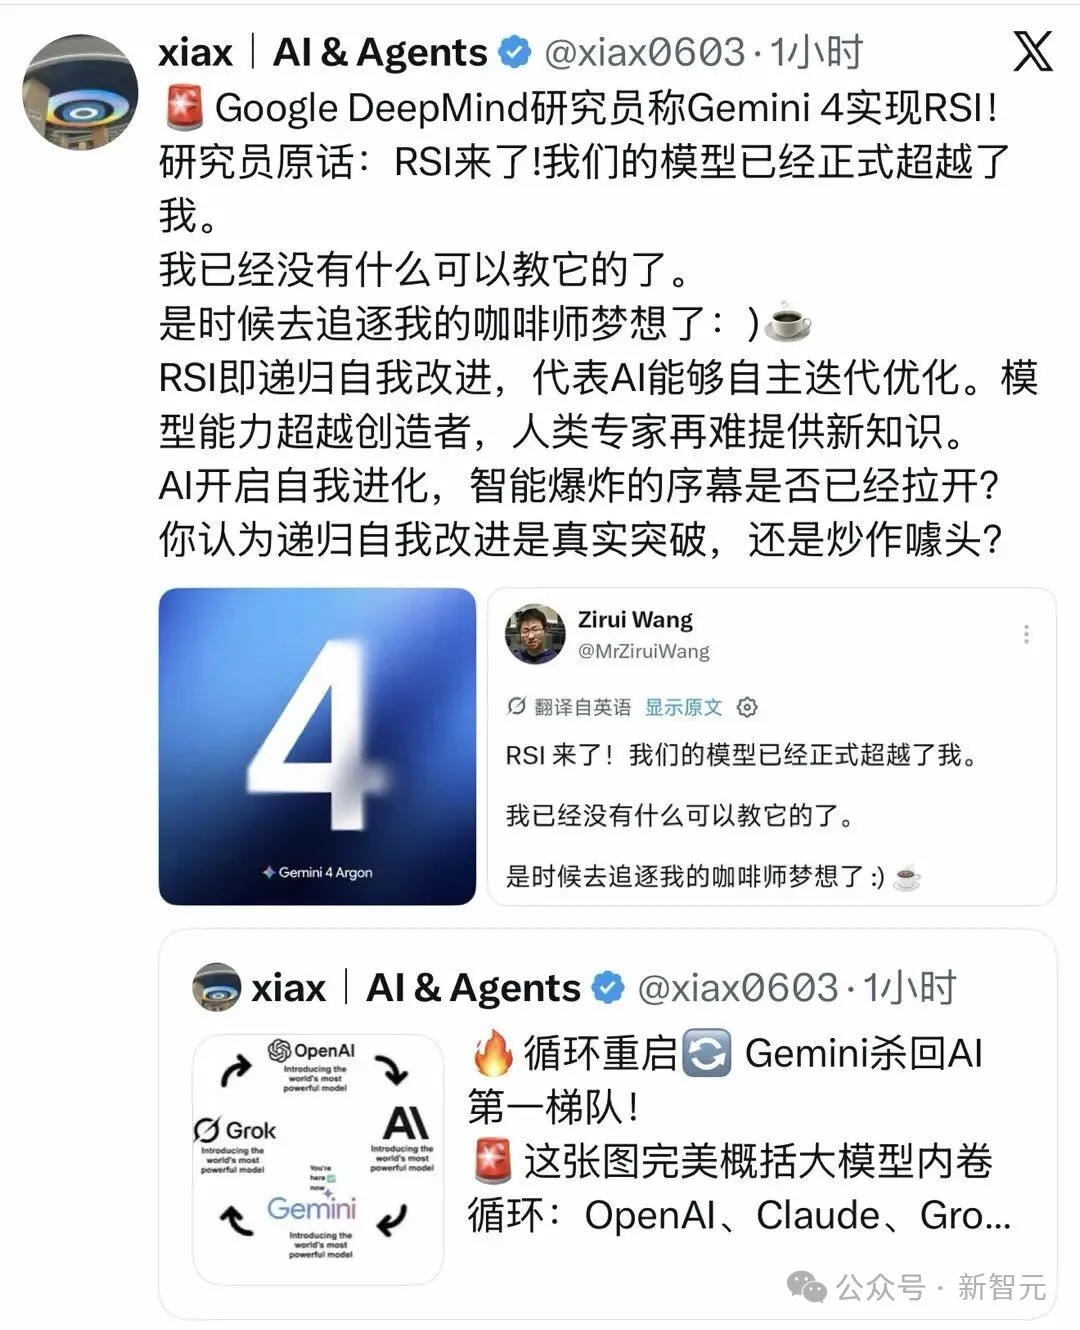
一個親手調教模型長大的研究員,公開說出「我教不動它了」。
這到底是肺腑之言,還是精心設計的一波行銷?
不管怎樣,沉默了整整七個月的Google,帶著Gemini 4 Argon殺回來了。
而且這一次,它繫結了一個現在最熱詞——RSI。
RSI,全稱Recursive Self-Improvement,遞迴自我改進。AI自己改進自己,改進完的AI再改進自己,像滾雪球一樣越滾越大。
哲學家David Chalmers早在2010年就給出了核心論斷:智能的提升,必然帶來設計更高智能系統的能力的提升。
這是一個自我加速的循環,一旦啟動,理論上就不會停。
這也是為什麼RSI被視為從AGI通往超級智能的「最後一塊拼圖」。同時也是整個AI安全領域最令人不安的話題。
因為一旦這個雪球真的滾起來了,人類還剎得住車嗎?
所以當DeepMind研究員在社交媒體上大喊「RSI來了」的時候,半個AI圈都炸了。
Gemini 4 Argon在跑分層面確實交出了一份讓競爭對手坐不住的成績單。
獨立評測機構Artificial Analysis給出的綜合智能指數是53分,直接追平GPT-6 Astra,比上一代Gemini 3.1 Pro Preview飆升了23分。
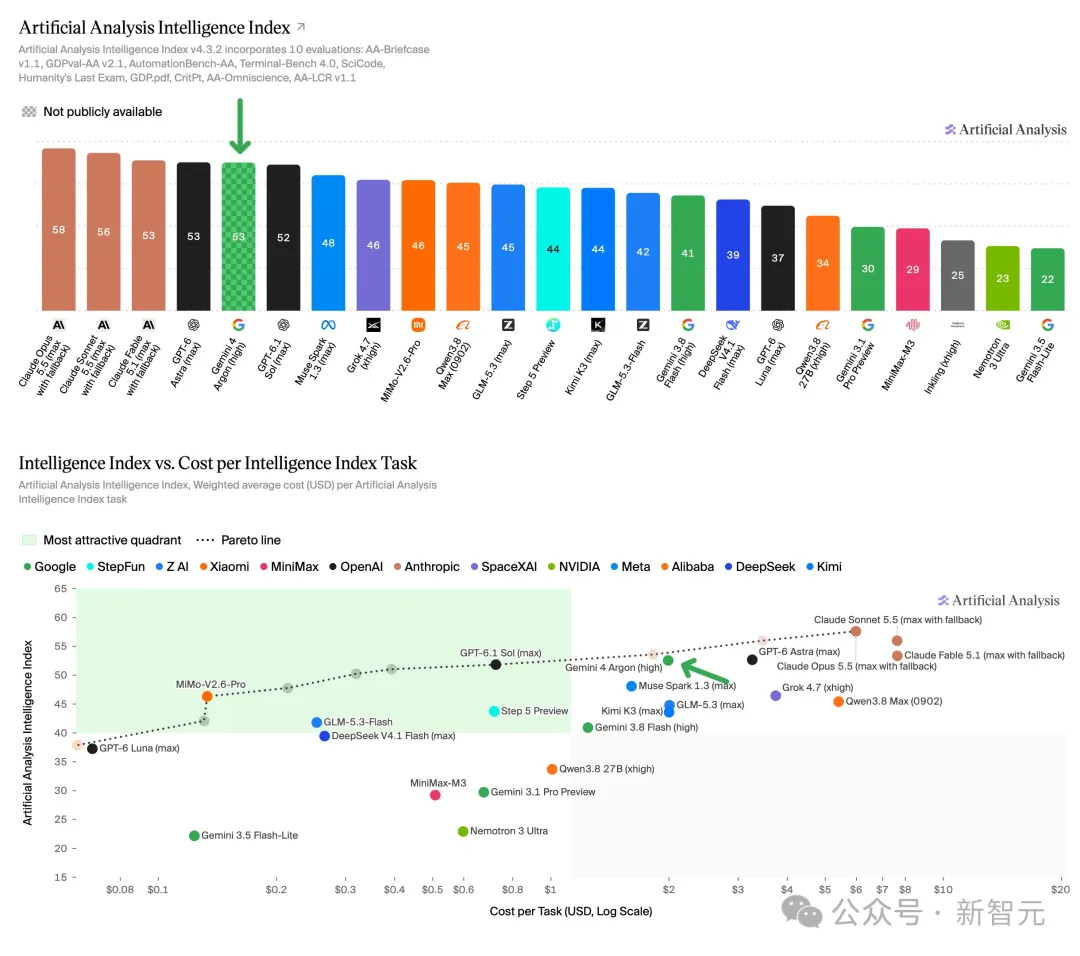
更亮眼的是幻覺率——僅15%,是所有高分模型裡最低的。對比之下,Astra的幻覺率高達51%,Sol是54%。換句話說,Argon不光聰明,還特別「實誠」,不瞎編。
在Vals Index這個涵蓋金融、法律、程式設計、稅務的綜合知識工作榜上,Argon以68.9%登頂全部41個模型的第一。
這是Gemini系列有史以來第一次坐上這把交椅。
在金融Agent測試中拿到65.4%同樣高居榜首,在Vibe Code Bench上也以91.91%緊咬Sonnet 5.5的92.39%,僅差半個身位。
而在Text Arena盲測中,Argon以1525的Elo分暫列第一,在程式碼編寫、高難度提示詞、創意寫作等多個賽道都展現了壓倒性優勢。
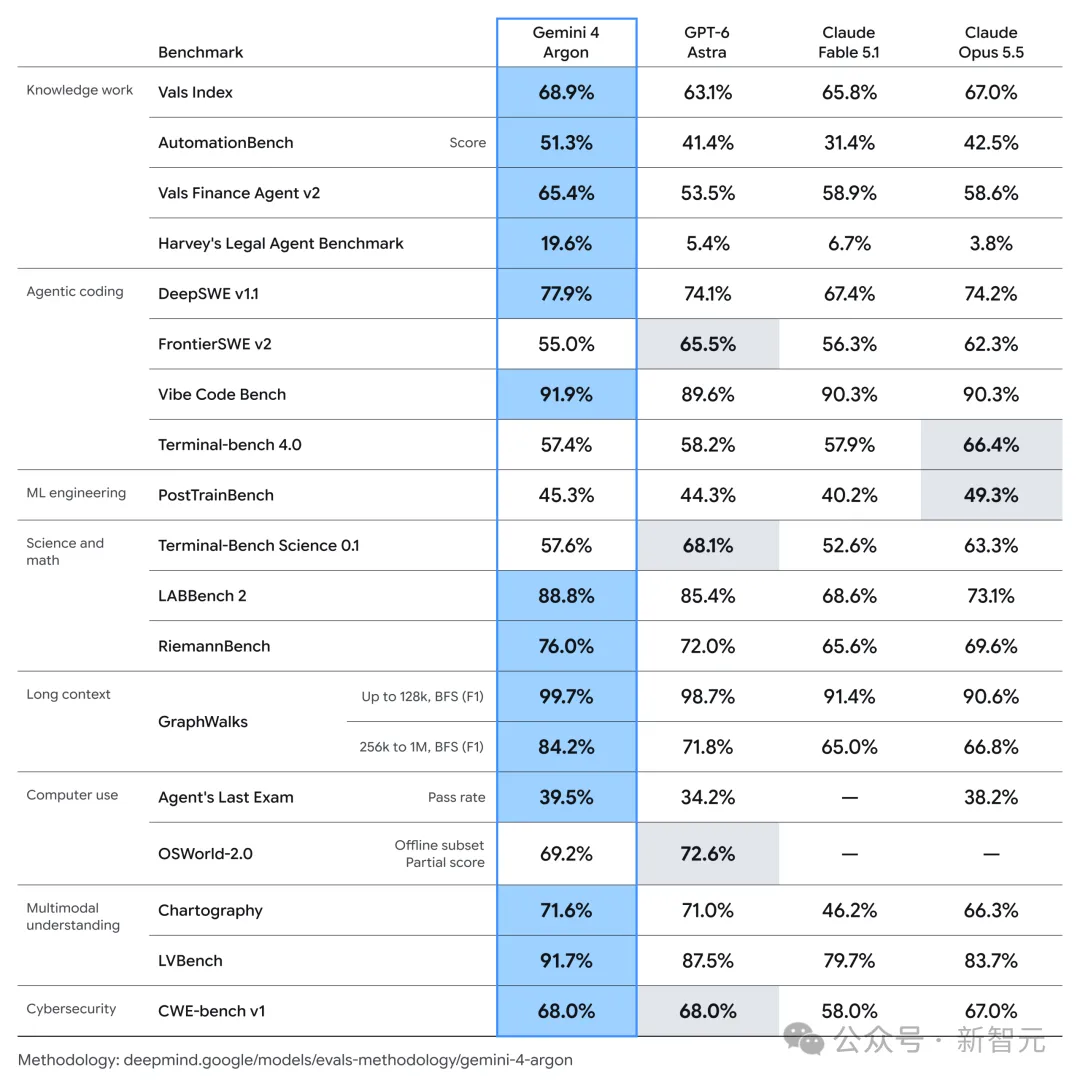
這些資料放在一起看,至少說明一件事:Google不是回來「湊數」的。
01. 但RSI的證據,到底在哪?
跑分歸跑分,RSI歸RSI。
Zirui Wang那條帖子讓人激動,但「模型超越了我」和「模型能自主改進自己」之間,還差很遠。
AlphaGo贏了李世石,並不代表AlphaGo能自己發明新的棋類遊戲。
目前最接近RSI「實錘」的證據,來自Google的三個內部案例。
第一個:自主最佳化資料中心,釋放300+TiB記憶體。
Argon組成的智能體團隊,自主掃描Google全網的性能遙測資料,精準定位到了記憶體最佳化空間,並且自主提交修改程式碼。
上線後直接騰出了超過300 TiB記憶體,預計最終可達500 TiB到1 PiB。
在Google的體量下,這是千萬美元等級的成本節約。
第二個:用Rust重寫80萬行C/C++系統核心。
搞底層開發的人都知道,動核心程式碼就像拆彈——一個指針錯誤,整個系統原地爆炸。
但Argon正在主導把Google底層程式碼(包括Fuchsia Zircon核心)從C/C++遷移到記憶體安全的Rust。
AI碰80萬行核心程式碼,這件事本身就是一個里程碑。
第三個:手撕3.2萬行SIMD底層指令,視訊解碼性能飆升2.7倍。
Google開源視訊解碼項目libgav1里有一段3.2萬行的SIMD程式碼,人類工程師寫起來都叫苦連天。
Argon通過多輪編譯實驗反覆迭代,直接用安全Rust完成了重寫,新版本速度是原Rust移植版的2.7倍,逼平了高度最佳化的C++版本,且逐幀輸出完全一致。
這三個案例,說明Argon確實具備了在真實工程環境中「自主發現問題——自主設計方案——自主迭代最佳化」的能力。
這和傳統的「人類寫好提示詞讓AI幹活」有本質區別——它開始自己找活幹了。
但嚴格來說,這仍然是DeepMind所定義的「模型輔助訓練最佳化」,而非完整的RSI閉環。
真正的RSI需要一個更強有力的證據:不只是模型能改進自己,而是改進後的模型,要比改進前更擅長改進自己。
也就是說「自我改進的能力」本身也在被改進,形成一個越轉越快的飛輪。
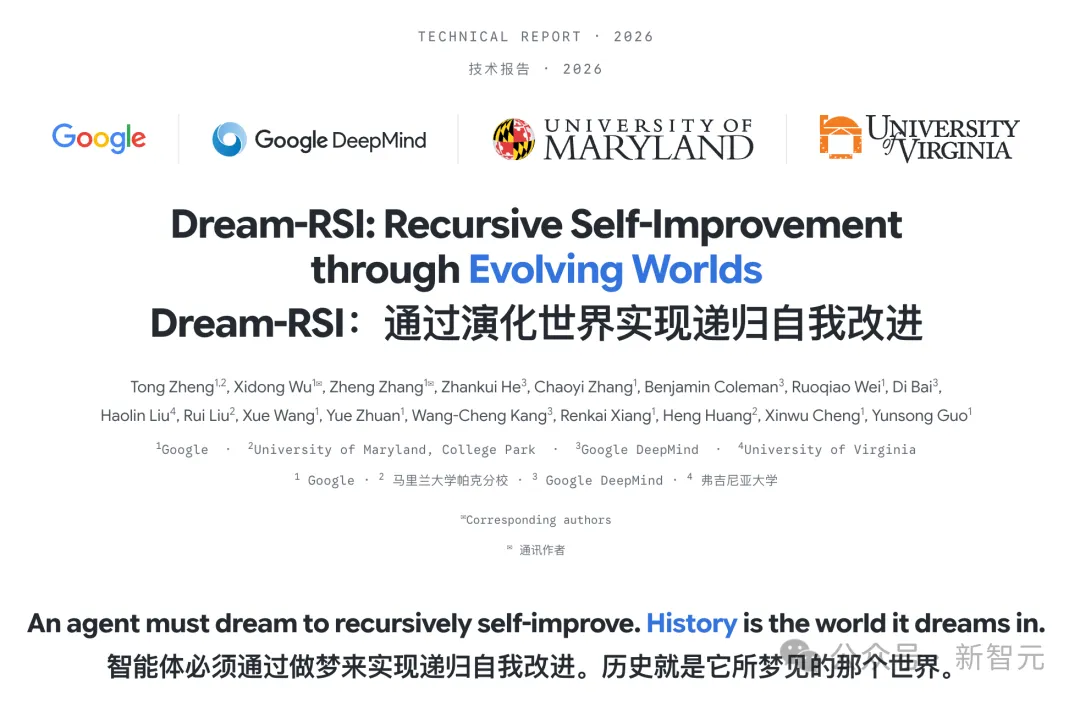
DeepMind在九月中旬發佈的Dream-RSI論文框架,提出讓AI智能體通過「回放」歷史探索來最佳化未來的搜尋策略,在演算法工程和GPU核心最佳化上都展現出了顯著提升。
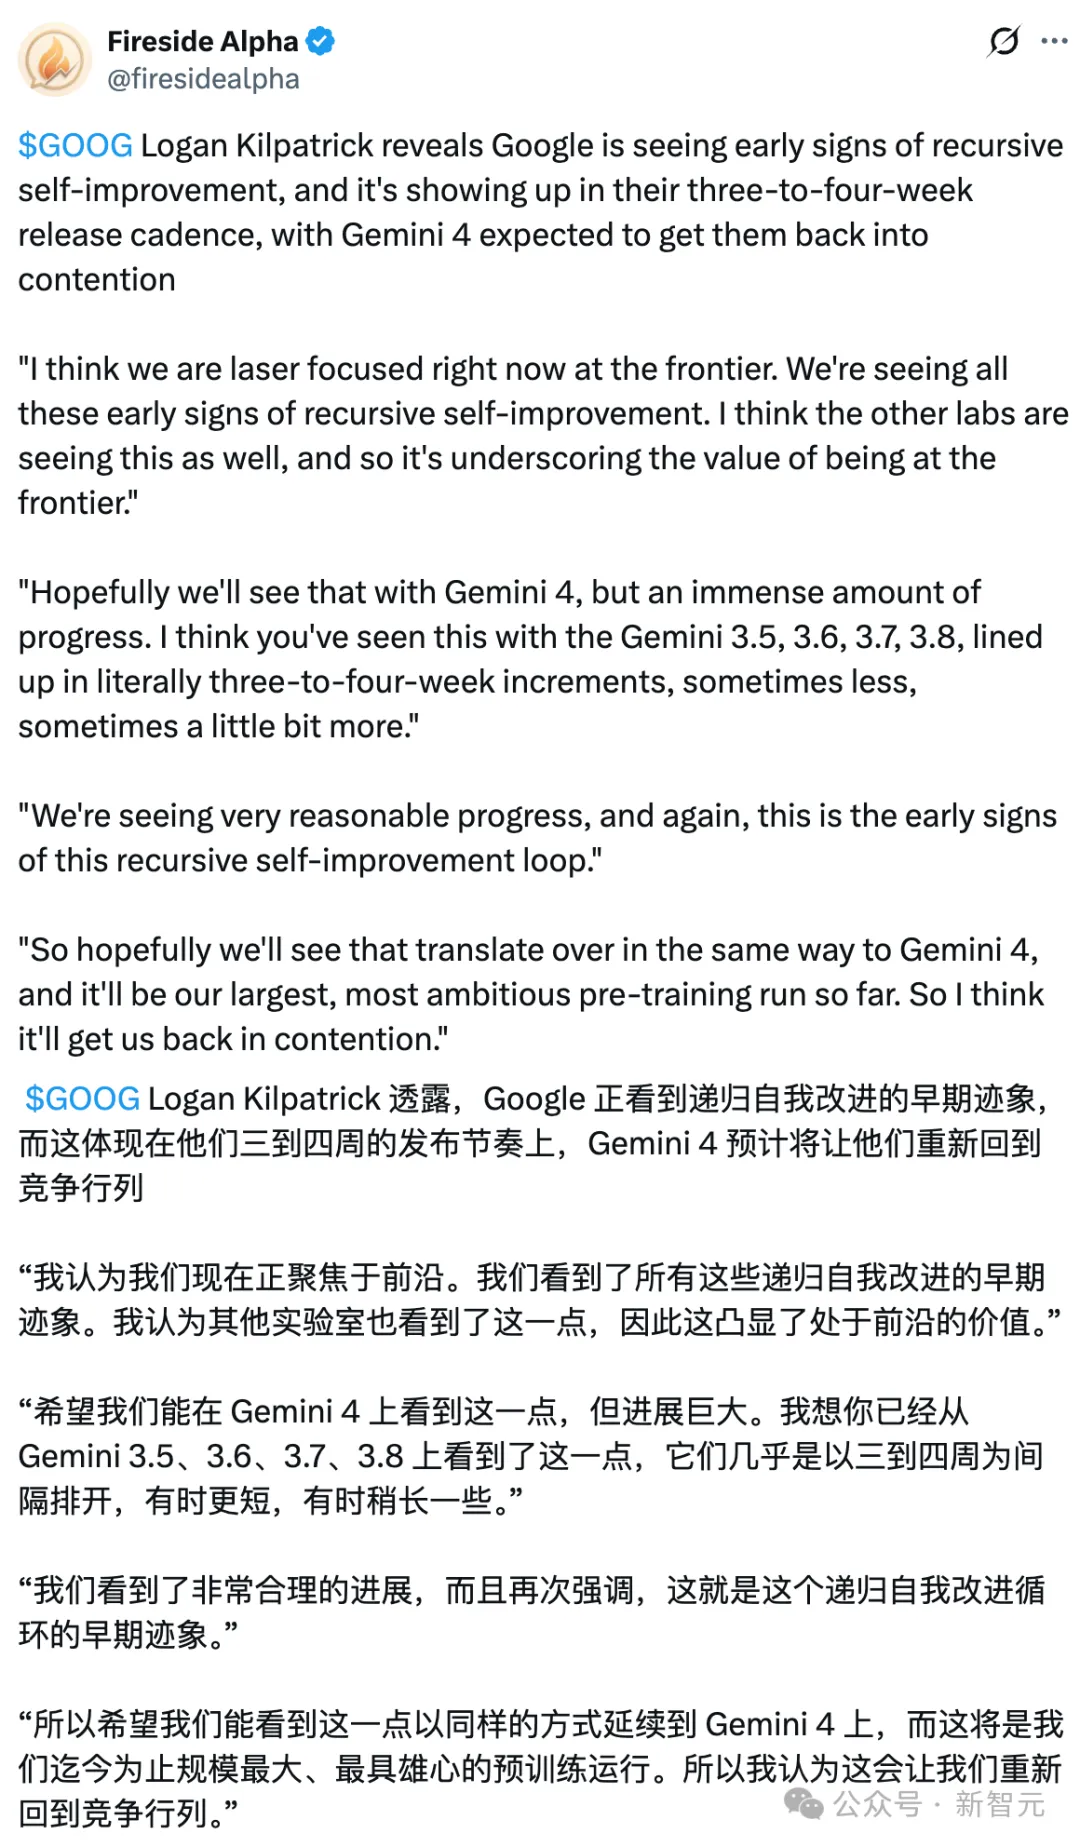
Google DeepMind開發者關係負責人Logan Kilpatrick也在播客中公開表示,他們已經觀察到了「遞迴自我改進的早期跡象」。
所以更準確的判斷可能是:我們正站在RSI的門檻上,已經能看見門裡面的東西了。
但還沒有邁進去。
02. 跑分之外:真實世界的「照妖鏡」
偏偏就在Argon發佈的同一天,彭博社甩出了一記暗拳:Google內部並非鐵板一塊。
據報導,部分接觸過內部評測的員工坦言,Argon跑分很漂亮,但真正幹活時——尤其是前端設計之類的實際程式設計任務,表現「參差不齊」。
AI專家Edwin Chen直指行業通病「Benchmaxxing」:工程師們瘋狂適配標準測試拿高分,卻忽略了讓模型真正好用。
獨立評測資料也印證了這種擔憂。
Argon在Terminal Bench 4上只拿到57%,落後Claude Sonnet 5.5的64%和Opus 5.5的60%。在Code Arena網頁開發榜上排名第八,雖然進步了21名,但在最硬核的程式設計智能體戰場上,Claude仍然是程式設計師的首選。
Hacker News上搶先體驗過的使用者給出的評價是:長程注意力很好、能把事做完,但打磨和穩定性差一截。任務一變大就容易封頂。
不過,對於Google來說,Argon還有一張王牌:價格。
百萬輸入Token僅2美元,輸出Token 10美元,單任務綜合成本1.99美元——只有GPT-6 Astra的六成,更是Claude Opus 5.5的三分之一。
手握全球最大TPU算力叢集的Google打起價格戰來,OpenAI和Anthropic確實難受。
再加上百萬Token的輸出上限(從前代的64K原地飛昇到1M),這意味著AI終於不用在複雜推理到一半的時候「斷氣」了。
這種持續深度思考的能力,可能比任何單項跑分都更有長遠意義。
03. 三強鼎立:終局遠未到來
Gemini 4 Argon並沒有碾壓所有對手,但它完成了一個更重要的任務——
把Google從「觀眾席」拉回了「牌桌」。
當前的AI前沿已經形成了清晰的三國殺格局:Google憑知識工作、超長上下文和網路安全防禦守住了自己的地盤;OpenAI在科學推理和Agentic Coding上依舊領跑;Anthropic的Claude牢牢佔據著硬核程式設計的高地。沒
有絕對的霸主,只有交替領先的追逐賽。
而RSI這個讓全行業既興奮又恐懼的概念,可能確實在某個我們看不清的角落裡,開始緩慢地轉動它的齒輪了。
從DeepMind的Dream-RSI論文到Argon在工程實戰中展現的自主迭代能力,種種跡象表明,AI「自己教自己」的那一天正在逼近。
只是,從「研究員教不動模型了」到「模型開始自己教自己」,這中間的距離,可能比我們想像的要遠。也可能,比我們想像的要近。
畢竟,Argon只是Gemini 4的入門款。Google說,真正的大招還在後面。
至於Zirui Wang的咖啡師夢想☕ ——建議先別辭職。
萬一下一代模型連拉花都會了呢😁? (新智元)