
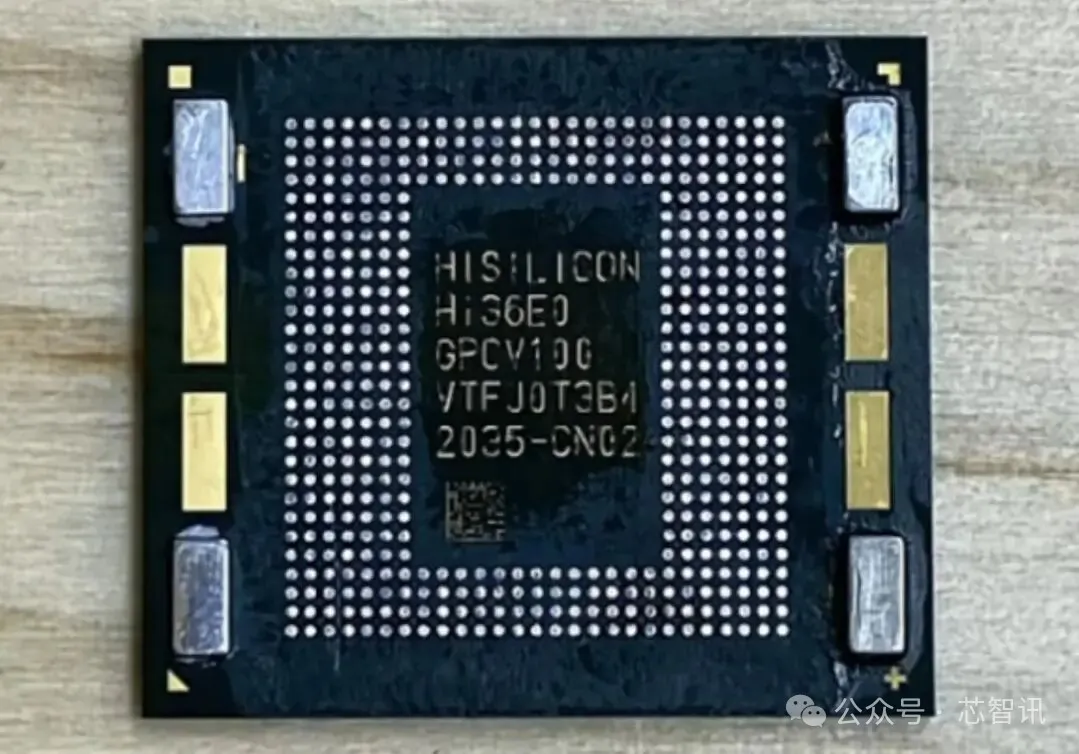
近日,半導體分析機構 Kurnal Insights 發佈了華為麒麟9050 Pro(Hisilicon Hi36E0)晶片裸片照片(Die Shot),展示了這款基於華為“韜定律”邏輯摺疊(LogicFolding)技術的全新SoC的內部結構。
邏輯Die+SARM Die摺疊設計
Kurnal Insights公佈的華為麒麟9050 Pro晶片的裸片照片顯示,其並未採用傳統的將計算單元與SRAM在同一個2D Die結構上的設計,而且分成了兩個Die,即一顆計算Die(CPU/GPU/NPU/ISP/DSP等計算單元都在這個裸片上)與一顆SRAM Die(SRAM/Cache都在這個裸片上)通過“邏輯摺疊”技術鍵合而成,這種方法縮短了訊號鏈路,並利低至微米級間距的垂直互連,使兩個Die在功能上作為一個單片單元運行。
據華為半導體業務負責人何庭波此前披露的論文闡述,所謂“邏輯摺疊”,並非傳統意義上的晶片堆疊:傳統堆疊是將現成模組在封裝層面連接,而邏輯摺疊是將原本在平面上展開的完整邏輯系統,放到三維空間中重新設計、重新布線、重新定義時序,其不僅提升了晶片密度和性能,還最佳化了晶片的訊號鏈路和電氣鏈路,降低了功耗和時延。
從Kurnal公佈的兩個裸片的標註圖來看,這兩顆裸片尺寸均為11.13mm × 10.84mm,面積均為120.65mm²,雖然單個裸片的面積甚至略小於前代麒麟9030S的122mm²,但由於是兩個裸片“邏輯摺疊”而成,因此其整體的電晶體密度得到了大幅提升。
據爆料人@Taog_1575透露,麒麟9050 Pro的計算Die採用N+3工藝,SRAM Die則採用N+2工藝,這樣的工藝組合,在麒麟晶片當中尚屬首次。
根據華為半導體業務部總裁何庭波此前公佈的論文資料顯示,麒麟9050 Pro的電晶體密度達到每平方毫米2.38億顆,較麒麟9030 Pro的每平方毫米約1.55億顆電晶體提升了55%。不過,華為最新發佈會披露的資料顯示,如果只看計算Die的邏輯單元電晶體密度,則提升了約28%。
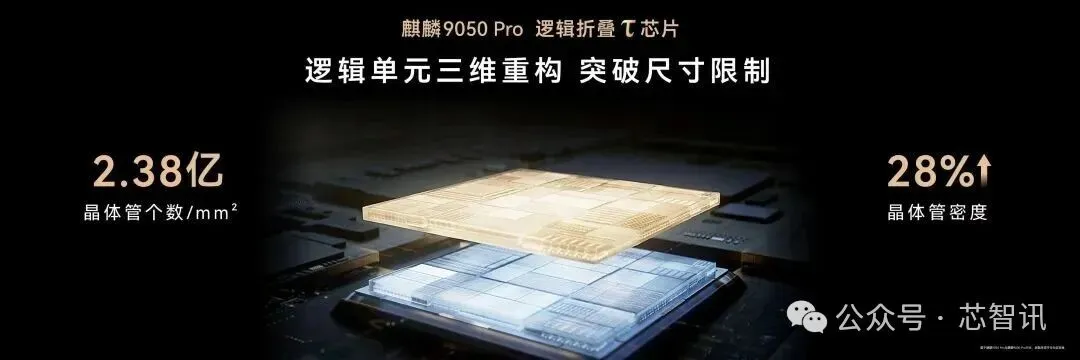
此外,麒麟9050 Pro通過創新的邏輯摺疊架構,壓縮關鍵路徑時延,能將新晶片時鐘緩衝器的數量降低55%,關鍵路徑時延也減少30%。與此同時,麒麟9050 Pro還實現了500萬個訊號傳輸鍵合,跨Die傳輸頻寬高達125TB/秒,這也助力了訊號傳輸時延的降低。
根據華為官方的資料,麒麟9050 Pro相比上代麒麟9030 Pro的CPU多核性能提升了23%;該晶片還整合了一顆超低功耗微核,息屏顯示、消息推送等低負載場景由微核運行,有效降低待機功耗;GPU圖形渲染性能提升了40%;NPU性能提升了140%,可以在端側運行30B MOE 大模型;整合的第十代ISP,可以將長焦清晰度提升34%;通訊方面,整合了全新的巴龍基帶,支援超5.5G通訊。
計算Die:9核CPU+6核GPU+4核NPU
Kurnal公佈的計算Die的標註圖來看,麒麟9050 Pro的邏輯計算單元全部集中在這一層。
其中,左上方的區域是Maleoon 955 GPU,擁有6個GPU核心,主頻為1056MHz,佔據了相當大的裸片面積。
Maleoon 955 GPU的下方和右側則是LinXi CPU區域。在具體CPU架構方面,麒麟9050 Pro搭載自研靈犀9核16線程CPU,採用1+6+2架構,包含一個主頻3.1GHz的LinXi-Big大核和6個主頻2.2GHz的LinXi-Mid中核和2個1.75GHz LinXi-Small小核。
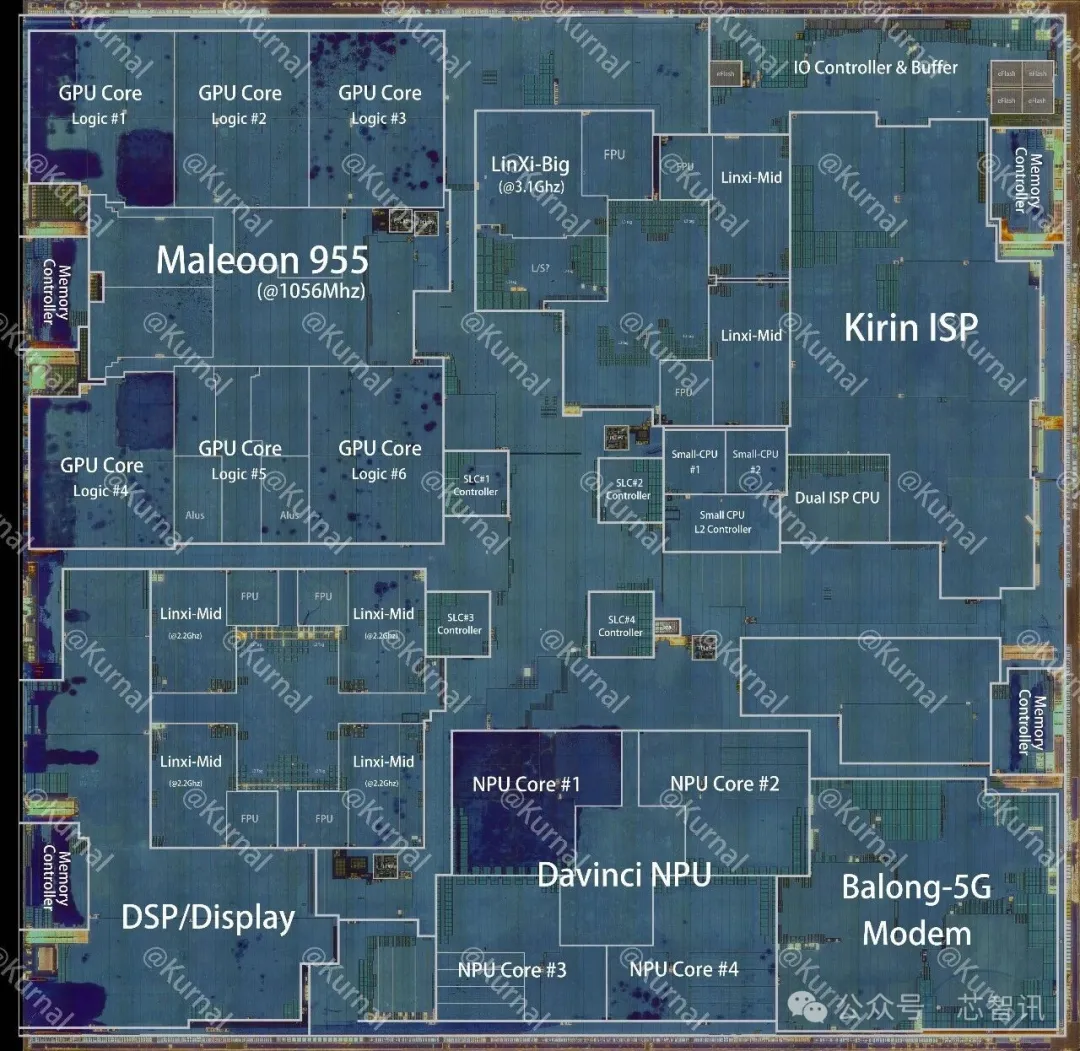
需要指出的是,從裸片照片來看,麒麟9050 Pro的CPU分拆成了不同位置的兩個獨立的叢集:一個叢集位於Maleoon 955 GPU右側,擁有1個LinXi-Big大核+2個LinXi-Mid大核+2個LinXi-Small小核;另一個叢集位於Maleoon 955 GPU下方,擁有4個LinXi-Mid中核。
計算Die右側是面積相當大的Kirin ISP,並且該ISP還配備了專用的雙核CPU核心;計算Die的下方中央是四核心的達文西(Da Vinci)NPU,左下方是DSP/Dispaly單元,右下方是巴龍(Balong)5G基帶。
此外,計算Die內部還分佈著多個Cach Controller,邊緣還分佈著多個Memory Controller和I/O Controller & Buffer等模組。
SRAM Die:與計算Die垂直耦合的有源多級快取層
Kurnal公佈的SRAM Die標註圖顯示,這一層並不是一片簡單的“快取倉庫”,而是與計算Die高度對應的有源記憶體層。
其中,麒麟9050 Pro的六個Maleoon 955 GPU,不僅每個核心都配備了獨立的一級快取,同時還有4MB的共享二級快取。
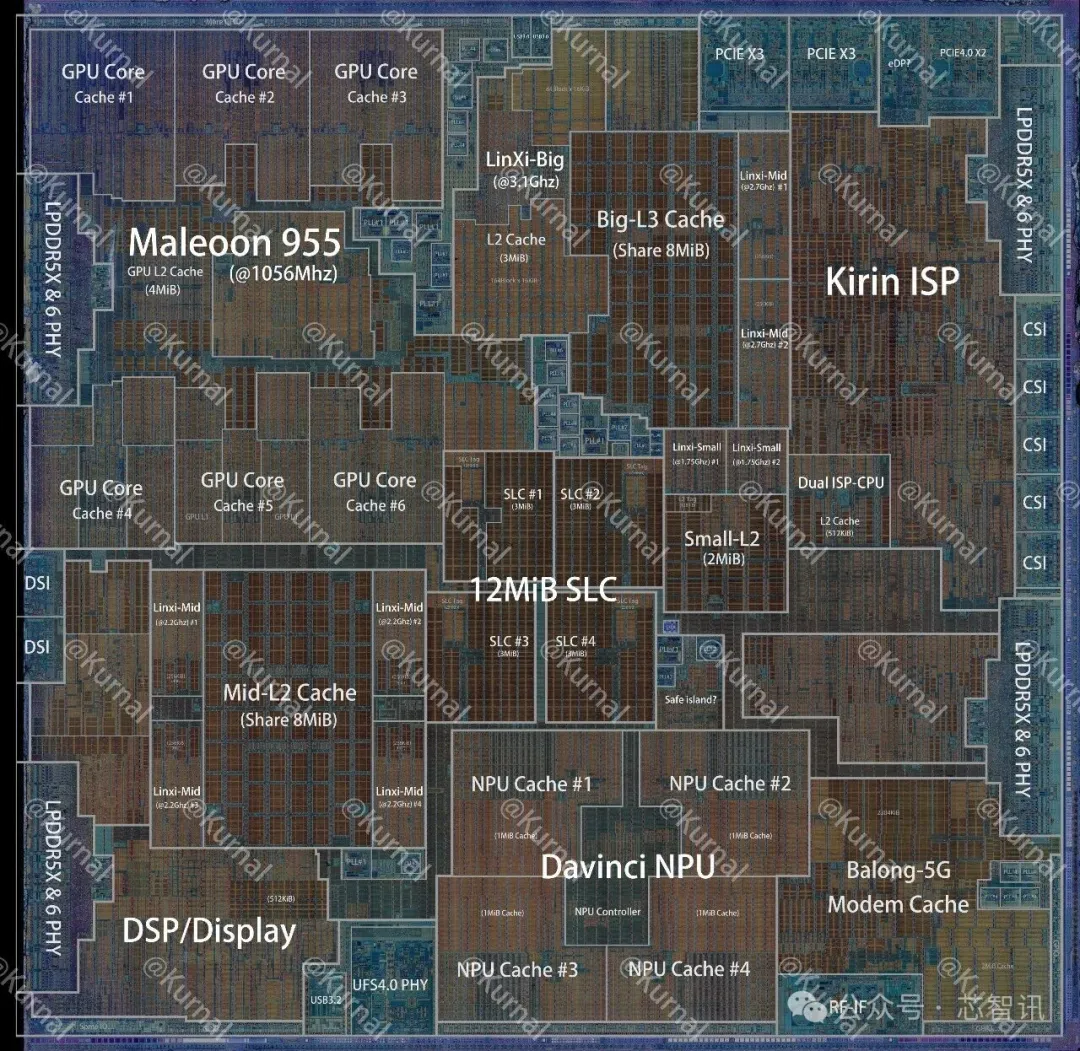
在CPU快取方面,位於Maleoon 955 GPU右側的5核CPU叢集中,LinXi-Big大核配備了獨立的3MB二級快取,2個LinXi-Small中核分別配備了256KB的快取,2個LinXi-Small小核則配備了2MB的共享二級快取,這5個CPU核心還擁有共享的8MB三級快取。
位於Maleoon 955 GPU下方的擁有4個LinXi-Mid中核的CPU叢集,則配備了共享的8MB二級快取。
在NPU方面,4個芬奇架構的NPU核心,每個核心均擁有獨立的1MB快取。
Kirin ISP專用的雙核CPU,也配備了512KB的二級快取;DSP/Display計算單元,配備了512KB快取;巴龍5G基帶也配備了2304KB快取。
此外,麒麟9050 Pro還配備了12MB的SLC系統快取,整個SoC的計算單元都能夠進行呼叫。
其中,各個計算單元內部的Cache是解決局部、高頻、低延遲資料訪問;12MB SLC則承擔更高一級的系統級資料共享;外部的LPDDR負責更大規模的資料存取。
需要指出的是,在SoC當中,計算單元和記憶體單元之間存在大量、高頻、低延遲的資料交換,如果能夠縮短互連距離,那麼將能夠大幅降低RC延遲、動態功耗和布線資源佔用,因此將計算單元和記憶體單元進行垂直整合價值更高。
但是,麒麟9050 Pro的SRAM Die並不是一個簡單的大容量共享Cache層,而是為CPU、GPU、NPU等計算單元配備了緊密耦合的獨立多級Cache,並與SLC一起納入了這個垂直快取體系當中。邏輯Die上的各個計算單元和SRAM Die上的快取之間,實際上構成了一組跨矽層的邏輯-記憶體垂直耦合關係,這比單純的計算Die與DRAM進行3D堆疊更加複雜。
此外,SRAM Die上還有安全核心和NPU Controller,周圍還分佈著多個PCIe、LPDDR PHY、CSI、DSI、USB PHY、RF等相關單元。
小結:
雖然麒麟9050 Pro通過“邏輯摺疊”設計將邏輯Die和SRAM Die垂直整合,確實在頻寬、時延、功耗和電晶體密度等方面帶來了顯著收益,但是這並非沒有代價。
一方面,兩顆Die若要穩定協同工作,必須依賴高精度晶圓減薄、混合鍵合(Hybrid Bonding)以及極高精度的對準與互連工藝。另一方面,傳統單Die設計中,若Die出現損壞,通常隻影響一顆Die;而在Logic Die + SRAM Die + Bonding的架構下,任一環節出現問題,都可能拖累最終封裝良率,甚至導致兩顆Die同時報廢。
因此,麒麟9050 Pro的“邏輯摺疊”方案在換取性能與能效提升的同時,也對製造工藝、鍵合精度和良率控制提出了更高要求。 (芯智訊)