
現在的模型越來越多了。不管是 OpenAI 還是 Anthropic,同一個系列裡往往有好幾款模型,而且每款模型還有不同的推理等級。
這對很多人來說,怎麼選就變得非常困難。
所以大部分人用的時候,可能根本不去選,從頭到尾都用同一個模型。這樣不僅沒有發揮出模型的最佳性能,往往還消耗了更多的 token。
OpenAI 官方也意識到了這個問題,所以前兩天專門發了一份 GPT-6 使用指南,教大家怎麼選模型。
01 三款模型,怎麼分工
先看官方給的定位和標價。
(美元) | (美元) | (美元) | ||
|---|---|---|---|---|
這張表列的是 OpenAI 目前 GPT-6 系列三款主要模型的價格,以及官方對它們的定位。
官方說得很明確。目標明確的日常重複性工作,比如提取發票欄位、對請求分類、生成結構化摘要,用最便宜的 Luna 就行。
我的理解是,那些不需要思考、只需要執行的事,有 Luna 就夠了。
更複雜的程式設計、研究和電腦使用任務,除了執行,還要一定的思考能力,用 Sol 比較合適。
目前 GPT-6.1 Sol 應該算是性價比最好的一款,官方說它的智能水平接近 Astra,價格只有 Astra 的五分之一。
最厲害的當然是 Astra,但大家都知道,它的 token 消耗量也非常大。所以最難、最需要推理的事,才用 Astra。
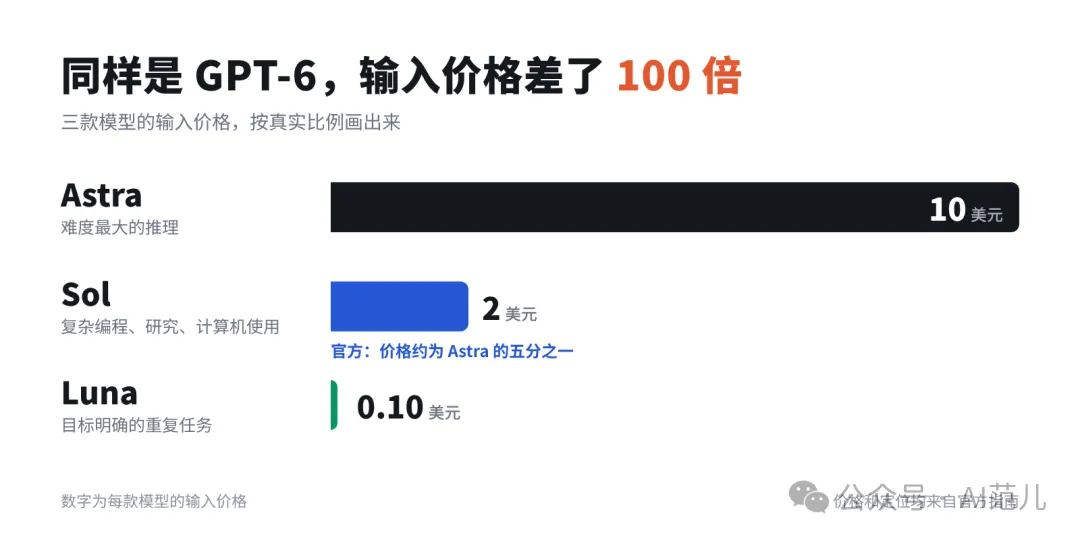
之前 AI 給過我一個建議:在我的日常工作裡,最多隻有 5% 的任務需要用到 Astra。絕大部分用 Luna 就能完成,剩下的交給 Sol。
02 推理強度,別一上來就開滿
選完模型,還要選推理等級,也就是讓模型花多少力氣去想。官方給了四檔:
- 低:提取事實、小改動這類活。
- 中:需要判斷的活,比如規劃功能、比較幾個方案。
- 高:高難度偵錯、深入分析、細緻審查。
- 極高或 Max:“高”還不夠的時候再試。只有效果提升抵得過多花的時間和錢,才繼續用。
最後一檔官方說得很克制,意思就是別默認開。
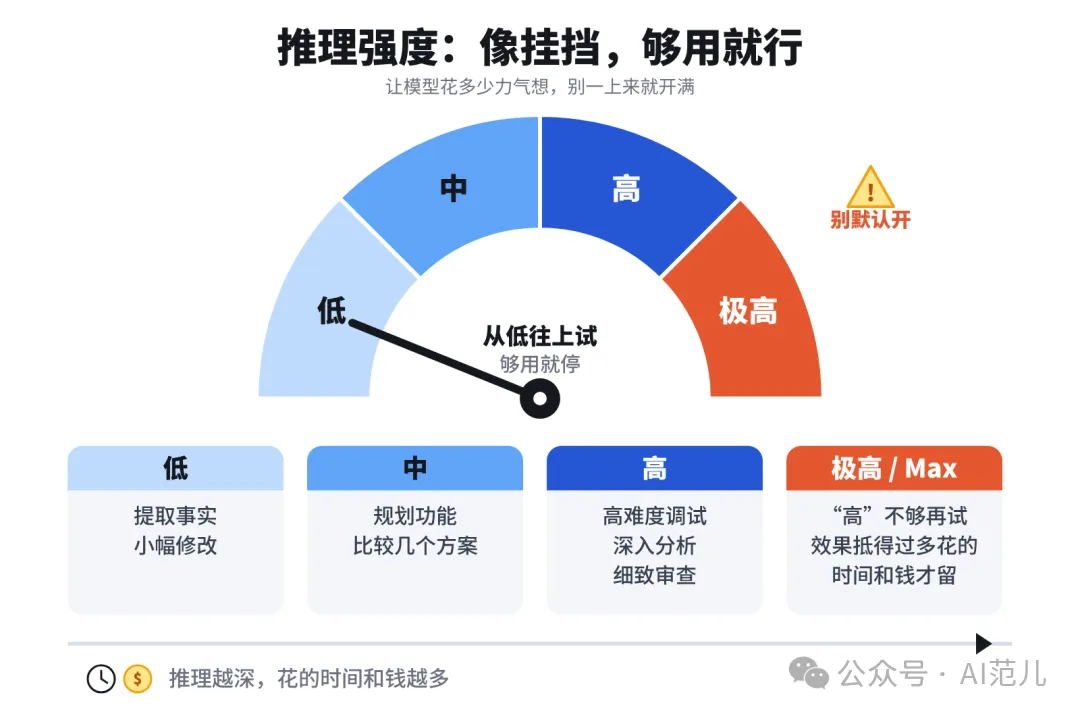
在 API 裡,對話中途可以調整推理強度,快取不會失效。在 Codex 裡,先用模型的默認等級,簡單任務往下調,要深入分析再往上調。
速度也是要花錢的。
API 裡有個快速模式,響應更快更穩,但每個 token 更貴。官方建議用在聊天應用、程式設計工具這類對響應時間要求高的場景。
還有個超高速模式,Codex 和 API 都能用,生成速度更快,推理強度不變。官方說它適用於 Astra,適合需要快速迭代程式碼、更快的響應值得多花錢的時候。
03 提示詞:寫少一點
這一點很多人會覺得反直覺,其實很好理解。
我們原來學的提示詞寫法,總是教我們寫得越詳細、越具體越好。但這種教法是建立在以前的模型還不夠智能的前提上。
現在的模型能力遠遠超過了之前,我們不能再拿教小學生的那一套去教一個博士生。
OpenAI 開發者體驗團隊的 Eric Provencher 說,模型理解細微差別和模糊含義的能力已經大幅提升,過去有幫助的詳盡指導,如今反而可能妨礙模型發揮。
對新模型來說,最重要的是先把任務說清楚:你想要什麼結果,面向誰,有那些相關的上下文和限制,怎樣才算完成。老的寫法,也要跟著模型的能力一起更新。
就像我之前介紹 Anthropic 時說的那樣,我們也可以從下面四個方面去更新。這四點,官方摘自另一篇《重新思考 GPT-6 Astra 的技能與提示詞》:
- 技能:用一句短描述寫清什麼時候用。補充細節等需要時再載入,不要寫死操作步驟。
- AGENTS.md:寫清那些文件和測試適用於那些情況。安全的常規流程直接授權,比如用一次性資料跑本地測試,不碰生產環境。
- 決策邊界:說清那些事它可以自己定,那些要你批准。別一刀切寫成“始終先詢問”。
- 做到底:定義什麼叫完成,包括改完、跑通、檢查結果、修掉問題。再說明那些決策要你來審。
輸出這邊,官方的例子是:模型可以自己決定摘要怎麼組織,但改項目範圍之前要先問你。回覆用通俗語言,技術細節貼合讀者,最後帶一段簡短的交接說明:改了什麼,查了什麼,還剩什麼。
04 長任務:中途能改,也能幹別的
官方說,GPT-6 系列可以處理持續數小時甚至數天的任務。
對這種長任務,如果還像普通對話那樣一輪一輪來,等它做完再進行下一輪,就會浪費大量 token。因為在它做的過程中,你可能會冒出新想法,或者想糾正點什麼。這時候你不用等它結束,中途就可以讓它調整。
OpenAI 明確了一些可以用的能力。API 這邊有三個:
- 輪次中途引導:模型幹活的時候,你可以通過 Responses WebSocket API 發糾正資訊。更新會進佇列,不會取消正在跑的工具,也不會撤銷已經做完的操作。
- 非同步工具呼叫:應用在跑測試這種慢任務時,模型可以先去做別的獨立工作。依賴測試結果的部分,等結果回來再開始。
- 多智能體:GPT-6.1 Sol 能通過 Responses API,把獨立的活分給子智能體,比如各查程式碼庫的一塊,最後彙總。這個功能還在測試階段。
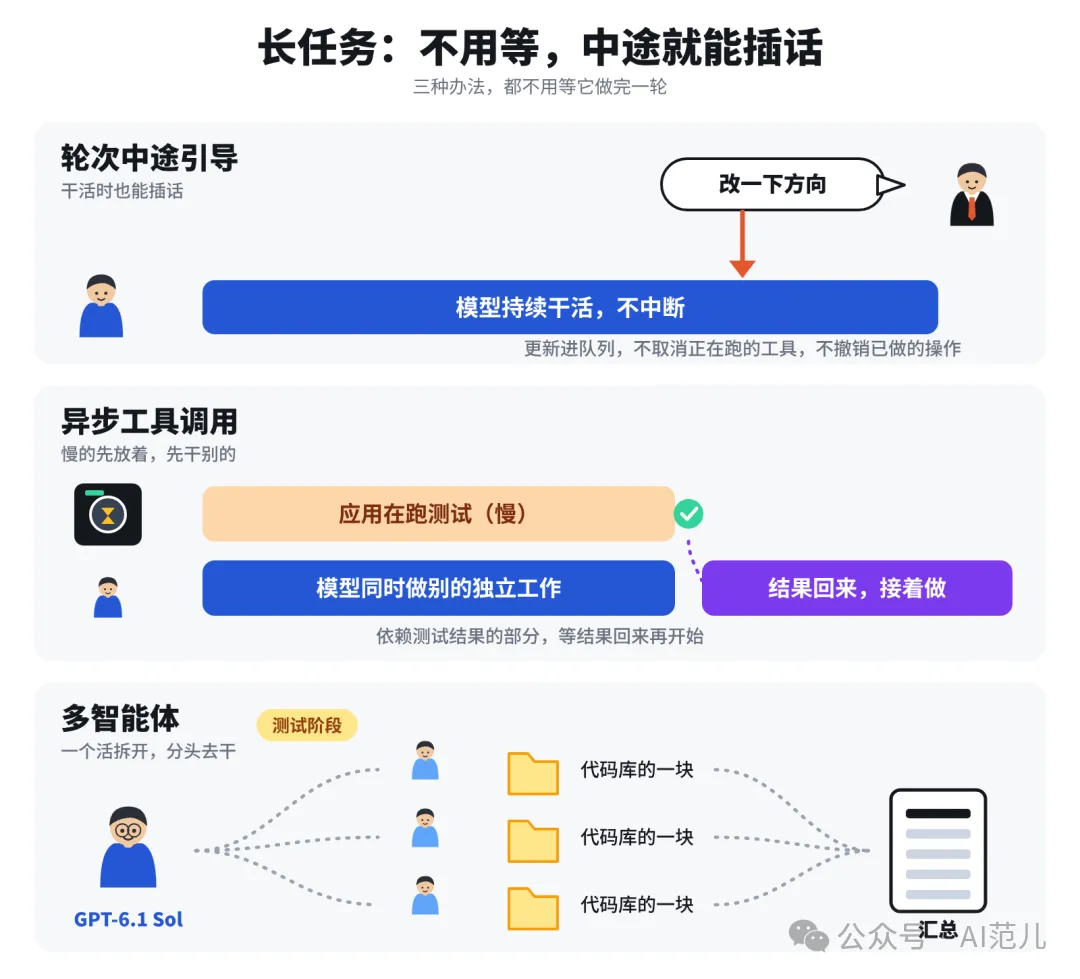
長時間運行的任務,中途可能遇到需要你決策的事,而這種事很難在最開始的提示詞裡就想到、寫明白。所以過程中也可以做澄清和引導。Codex 這邊有兩個:
- 邊做邊問:GPT-6 Astra 在 Codex 裡可以中途請求澄清。你要離開的話,先說清那些任務可以繼續,什麼時候該停下來等你。
- 改方向:需求變了,就用新資訊引導當前任務,說明什麼要改,什麼不動。省得它在一個已經不對的方案上繼續耗。
05 電腦使用:能走 API 就別點螢幕
自從 Astra 出來之後,電腦使用就變得非常流行。我也經常用,很多默認的任務,最後也會借助它來完成。但用過的人都知道,這種操作非常費 token。
三款模型都支援電腦使用,可以直接操作網站和桌面應用,沒有 API 也行。官方舉的例子是:讓模型調查一個缺陷,改完程式碼,再打開你的產品,在瀏覽器裡確認修好了沒有。
那到底那些任務該用?我自己一直也有點好奇。官方的原則是選最簡單可靠的路:
API 或者已連接的工具能直接辦,就用它們。
- 要讀螢幕、點按鈕、填表單的時候,才用電腦使用。
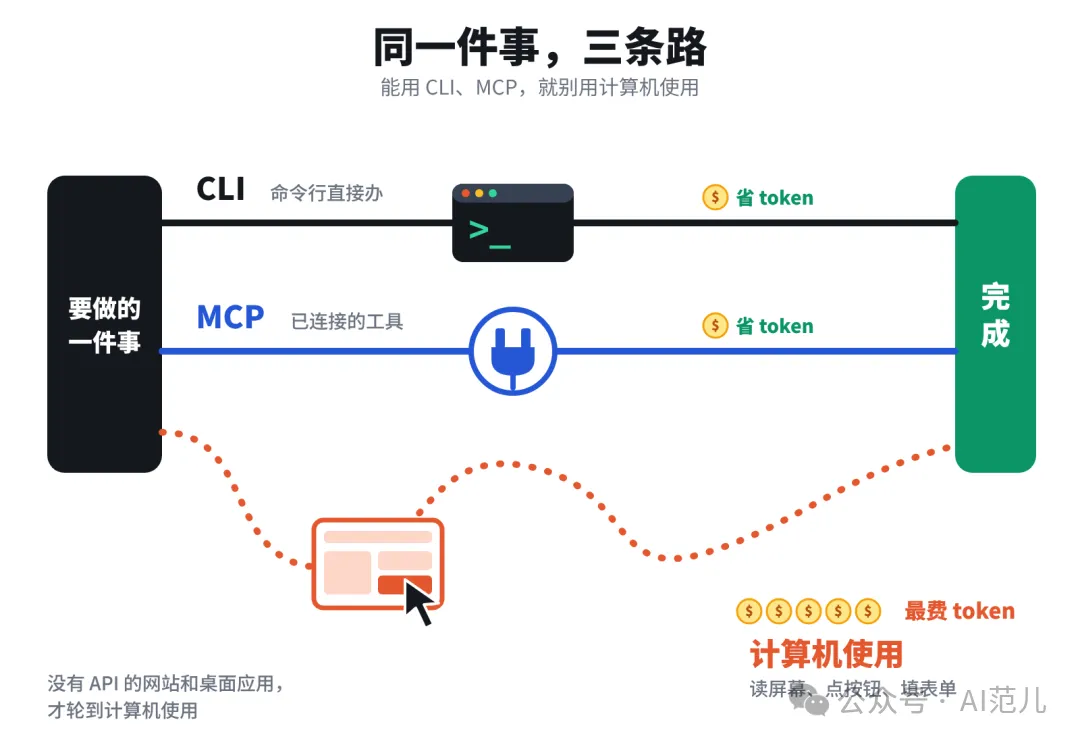
這其實已經說得很直白了:能不用就儘量不用。我自己也一樣,現在能通過 CLI、MCP 解決的,絕對不會用電腦使用。
如果你要自己做整合,就給模型一個能跑程式碼的工具來控制瀏覽器或桌面。官方點名了兩個:瀏覽器用 Playwright,桌面應用用 PyAutoGUI。
06 上線前:快取和測試
省錢方面,官方最看重提示詞快取。快取輸入的費用,比未快取的輸入最多低 95%,具體看模型。回頭看上面的表,三款模型的快取價,都是各自輸入價的十分之一。
想用好快取,有兩個條件:
- 固定的指令和參考資料,放在會變的任務細節前面。
- 工具定義保持一致。
這裡我舉個例子,不然不太好理解。
假設你做了一個合同稽核助手。每次來一份新合同,你都要先給模型一大段稽核規則,再把這份合同交給它。
稽核規則每次都一樣,合同每次都不一樣。
規則放前面、合同放後面,從第二份合同開始,前面那一大段一模一樣的規則,就可以直接按快取價算,只有新合同按原價。官方標價裡,快取價是原價的十分之一。
反過來,合同放在最前面,開頭每次都不一樣,後面的規則就復用不上了。這就是官方要求“固定的放前面”的原因。
07 像分配員工一樣分配模型
我經常聽到讀者朋友說,套餐額度消耗太快了。我曾經也這麼覺得。我的習慣是不管什麼任務,都用最好的那個模型。但摸索了一段時間之後,我發現自己的用法大錯特錯。
可能很多朋友跟我一樣,都用最好的模型,從來不選推理等級,都用默認的,更搞不清楚什麼叫快速模式。
其實理解起來很簡單。你是一個 Manager,手下有三個能力各不相同的員工。任務來了,你肯定會按難易程度分給他們,對吧?如果把所有任務都丟給你認為最強的那一個,肯定不合適。
希望這篇文章對你有所幫助。(AI范兒)