
成立兩年後,想做“美國版DeepSeek”的Reflection AI終於交捲了。
美國時間10月5日,Reflection AI公佈了首個開放權重模型 Beam,主攻程式設計、推理和智能體任務。(虎嗅註:開放權重模型指公開訓練好的模型參數,使用者可以下載、自己部署,能否修改和商用取決於許可證)
許多美國媒體和科技業人士,將Beam視為美國對中國開放AI的回應。
他們公司自己也是這麼對標的。
按照公司官網的說法,Beam 在程式設計和智能體任務上的表現可與智譜 GLM 5.2 競爭,接近阿里的 Qwen 3.8-Max,但在絕對能力上仍落後於 Kimi K3 等領先模型。
但它的意義不只在Benchmark。
Reflection有一套非常明確的定位:服務那些不願或無法使用中國模型,同時又希望擁有、控制自己AI能力的企業和政府客戶。
在美國本土,這樣的公司並不多見。Reflection同時擁有數十億美元融資、頂級GPU資源、Nvidia支援,以及美國政府和主權AI項目資源。
這也是為什麼,一款還沒有站到開放模型最前沿的產品,仍然會受到如此高的關注。
Reflection到底是一家什麼公司?Beam又到底做到了什麼?
01
Beam的成績單
Reflection創始人在播客采訪中披露,Beam採用MoE架構,總參數約5000億,但推理時只啟動約230億參數。
作為對比,DeepSeek-V3總參數為6710億、啟動370億;月之暗面Kimi K2達到1兆總參數、啟動320億;智譜GLM-4.5則為3550億總參數、啟動320億。
同時,Reflection還強調,Beam從預訓練階段開始完全自主完成(沒有蒸餾),並針對Coding、推理和Agent任務重點訓練。
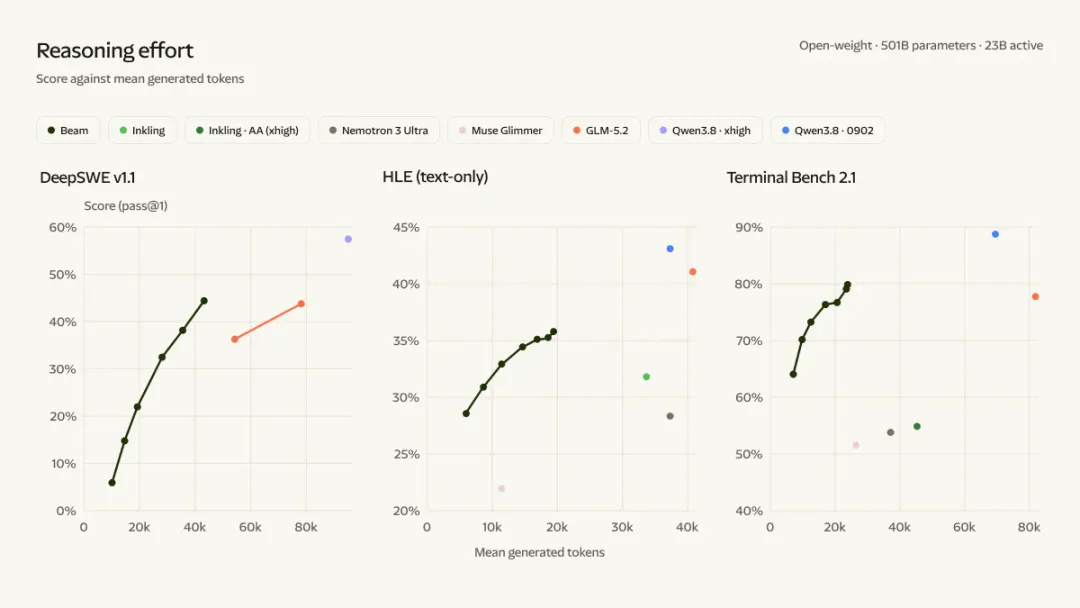
Reflection還尤其強調Beam的推理效率。
公司表示,依靠大規模強化學習,Beam完成相似難度推理任務時需要消耗的Token和推理計算量,可以達到GLM 5.3、GPT-6 Luna等模型的約1/3到1/4。
官方披露,Beam的預訓練資料達到23.8兆Token。作為對比,DeepSeek-V3使用了14.8兆Token預訓練;Kimi K2約15.5兆Token。Beam隨後進行了一輪高強度RL訓練,他們用10500張Nvidia GB300 GPU連續運行4周,總共生成超過1億次Rollout。
Reflection的判斷是,前沿模型的Scaling正在發生變化。
過去幾年,行業最熟悉的是擴大參數量和訓練資料,提升預訓練算力。但隨著預訓練逐漸成為一門更成熟的工程,下一階段模型能力提升的重要變數,會越來越多來自把強化學習本身繼續Scale。
所以,Beam像是Reflection的一次技術驗證。
一家新公司能不能靠大規模RL,把一個只有較少啟動參數的模型,推到接近中國頭部開放模型的水平。
它已經證明自己上了牌桌。
02
美國“DeepSeek”,為什麼是Reflection?
Reflection並不是一家突然冒出來的模型公司。
它成立於2024年,由兩名前Google DeepMind研究人員Misha Laskin和Ioannis Antonoglou創辦。Laskin和Antonoglou在DeepMind期間,曾參與Gemini 1和Gemini 1.5相關工作。Antonoglou在DeepMind早期就加入公司,是AlphaGo核心團隊成員之一。
但有意思的是,Reflection創業之初,其實沒有準備自己從頭訓練基礎模型。
Laskin最近在播客中回憶,兩人創辦Reflection時,主要押注了兩個判斷:第一個判斷是,強化學習會讓大模型從會聊天,進一步走向Coding和Agent;第二個判斷則是,西方仍會不斷出現足夠強的開放模型,Reflection沒有必要重複訓練基礎模型,只要站在這些模型上繼續做強化學習和Agent研究。
從今天回看,第一個判斷已然成為主流方向,但第二個卻落空了。
DeepSeek V3出現後,西方開放模型與中國開放模型之間的差距開始迅速拉大。Reflection又等了幾個月,希望美國出現一個足夠強的開放模型,但一直沒有等到。於是,它決定自己下場。
Beam就是這次戰略轉向後的第一份答卷。
過去一年,全球最強的閉源模型仍主要掌握在美國公司手中,但開放模型的重心,卻越來越向中國傾斜。
DeepSeek、Qwen、智譜、Kimi等中國模型不斷進入全球開發者的模型列表。OpenRouter排名顯示,在開放模型中,排名靠前的產品大量來自DeepSeek、智譜、小米、騰訊等中國公司。
Reflection和美國政府都想要的,是重新搶回這塊市場。
Reflection目前估值約250億美元,累計融資超過40億美元,其中Nvidia投資約8億美元。
今年7月,路透社報導,Reflection 與雲端運算公司 Nebius 簽署超過10億美元的協議,獲取包括輝達最新晶片在內的計算資源。
此前,Reflection 已與 SpaceX 簽下算力協議。按照 Axios 報導,經過初始爬坡階段,公司從今年7月起每月支付1.5億美元,協議持續到2029年。
Reflection 官網還稱,公司將參與美國能源部 Genesis Mission 科研計畫,為美國國家實驗室提供開放模型。
一家成立兩年多、第一款基礎模型才剛剛發佈的公司,已經獲得這個等級的資源,本身就說明投資者押注的並不只是Beam。
他們押的是美國重新擁有一個開放模型體系。
按照Reflection官網的介紹,公司不僅計畫開放模型權重,還在開發配套的開放原始碼軟體,並支援通過API呼叫,或在企業私有雲、本地伺服器、與外部網路物理隔離的環境中部署。
開放權重只是第一層。Reflection真正準備賣的是,模型+推理+軟體棧+基礎設施+企業部署。
它的主要客戶也不是普通消費者。在創始人的描述中,大型企業、政府機構、公共部門和“主權AI”客戶,才是未來開放模型最大的買家。
一個現實案例已經在韓國出現。
今年3月,Reflection與韓國新世界集團宣佈簽署合作備忘錄,計畫建設一座250MW的AI資料中心,為韓國企業和政府機構提供主權AI服務。項目將使用Reflection的開放權重模型和輝達GPU,美國商務部長也出席了簽約活動並表示支援。
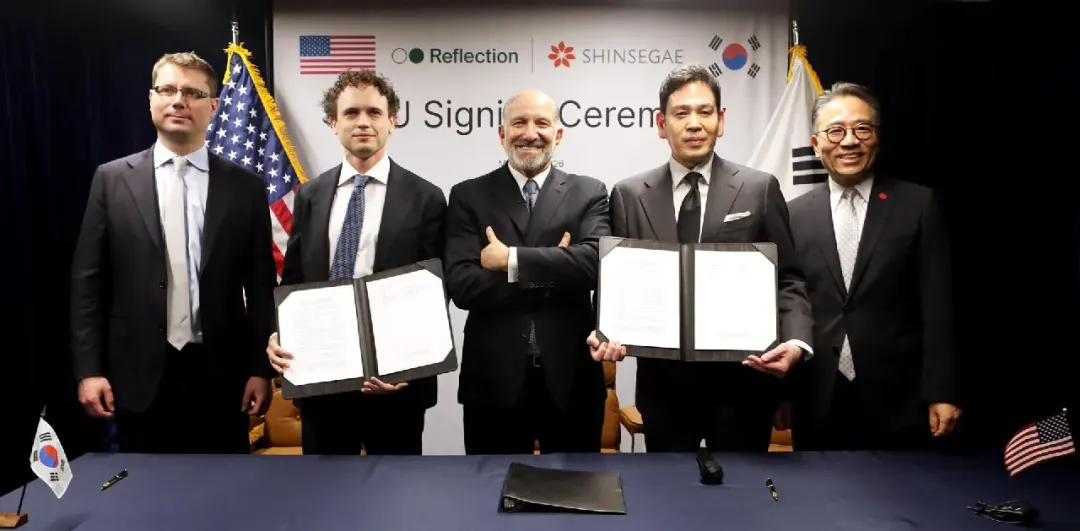
Reflection 已經拿到了訓練大模型的資源,也找到了願意討論合作的企業和政府客戶。接下來,Beam 要過的還是生態應用關和能力提升關。(AGI介面)