
Claude新模型來了,呼叫價格直接打一折!
美國時間10月7日,Anthropic發佈Claude Haiku 5.5。在不超過10萬token的請求中,新模型的輸入、輸出單價均比上一代降低90%。它能整理文件、查詢資料庫、操作瀏覽器,也能給更強的Opus和Sonnet當助手。
在Anthropic公佈的客戶案例中,金融AI公司Rogo已經用上了這種分工:大模型負責製作簡報,Haiku則去翻公司的年度報告,找出需要的收入數字。
一份工作拆開來做,不必從頭到尾都呼叫昂貴的大模型。
單價降了
實際能省多少
Haiku 5.5按輸入提示詞的長度分兩檔計費。提示詞不超過10萬token時,每百萬輸入token收費0.10美元,輸出0.50美元;超過這一長度,輸入、輸出單價分別為0.50美元和2.50美元。
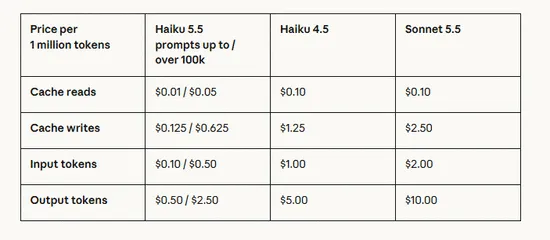
上一代Haiku 4.5的輸入、輸出單價分別是1美元和5美元。因此,短提示詞請求的單價降了90%,長提示詞請求也降了50%。Anthropic所說的“我們發佈過的最便宜的小模型”,比較的是自家歷代產品。
至於使用者平均能省多少,Anthropic給出的估算是運行成本降低約75%。
公司稱,上一代Haiku約90%的請求不超過10萬token;計算平均降幅時,已經考慮了不同長度請求的價格,以及新分詞器帶來的token用量變化。
分詞器決定一段文字會被拆成多少個token。開發者西蒙·威利森(Simon Willison)用同一段長提示詞測試,發現Haiku 5.5的計數比4.5多了約25%。
接近10萬token分界的請求,遷移後尤其需要重新計數:原本按低價計費的輸入,可能進入另一檔。
降價後,Haiku 5.5在10萬token以內的輸入、輸出單價,已經與GPT-6 Luna持平。按威利森列出的價格,Luna要到27.2萬token以上才進入長上下文收費檔,屆時輸入、輸出分別為0.20美元和0.75美元,仍低於Haiku 5.5長提示詞檔的單價。
不過,價目表上的差距,未必會原樣出現在帳單上。同一項任務,兩款模型生成多少內容、需要呼叫幾輪,也會影響最後的花費。
給大模型當助手
連快取費也降了
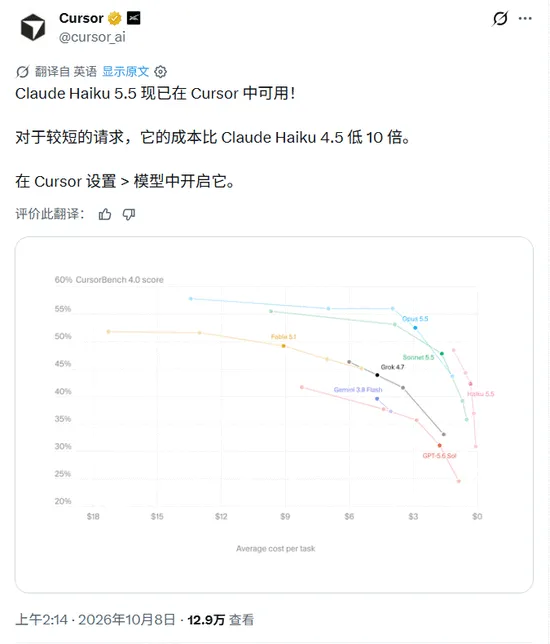
除了尋找指定資料,Haiku還可以把長對話整理成摘要,供後續任務繼續使用,也能承擔文字分類、資料庫查詢。在程式設計流程中,Anthropic將它定位為Opus和Sonnet的子智能體,處理已經拆分好的任務。
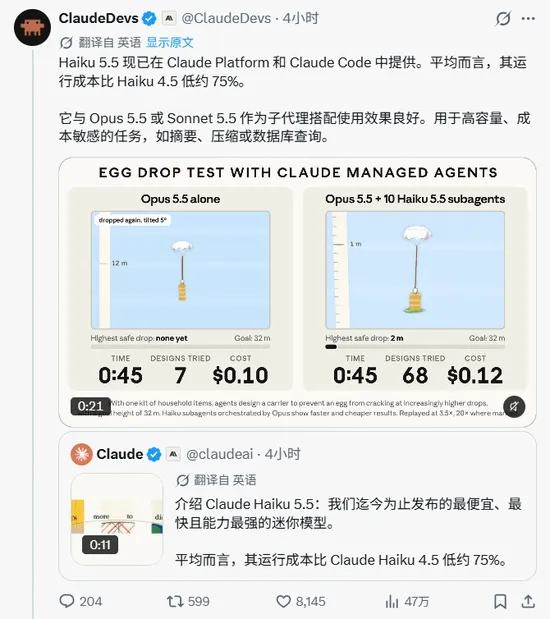
智能體連續工作時,會反覆讀取相同的指令、文件和對話背景。快取可以讓這些已處理過的內容復用,不必每次都重新計算。
與Haiku發佈同時,Anthropic把Sonnet 5.5每百萬token的快取讀取價格從0.20美元降至0.10美元。按公司的估算,這會讓大多數智能體任務的運行成本再降低約20%。
想自己搭應用或智能體的訂閱使用者,還能領取每月API額度:Max 5x為100美元,Max 20x為200美元;Team按席位彙總,整個團隊每月最多共享500美元。
這些額度用於Claude平台上的API呼叫,可以選擇不同的Claude模型;它們不會提高Claude或Claude Code的訂閱使用上限,未用完的部分也不結轉到下個月。
七秒畫一隻鵜鶘
複雜程式設計還有差距
Haiku 5.5接下這些工作,靠的也不只是低價。
在Anthropic公佈的OSWorld 2.1離線子集評測中,它的得分從上一代的15.7%提高至72.4%,高於同表中GPT-6 Luna的48.9%。這項測試考察模型操作電腦的能力,允許對部分完成的任務計分。
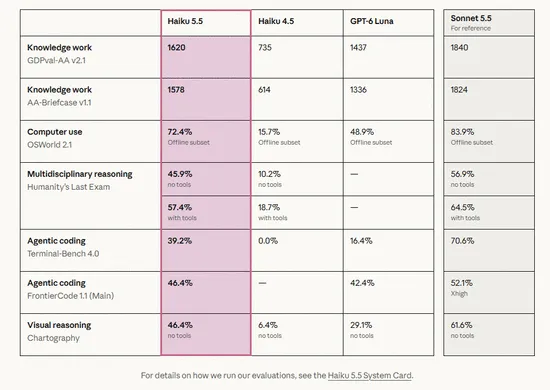
其他測試也有進步:知識工作評測GDPval-AA的Elo評分從735升至1620;“人類最後的考試”在不使用工具時,得分從10.2%升至45.9%。這些成績來自Anthropic的發佈材料。
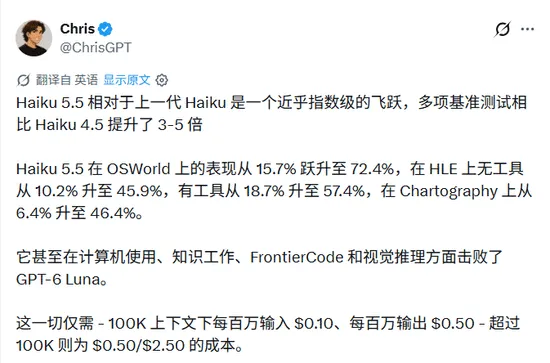
這代Haiku還首次支援調整推理強度,從low到max共五檔。
同一個模型可以少想一會兒、盡快回答,也可以投入更多計算。Anthropic稱,按各款模型的標準速度模式比較,Haiku 5.5是公司目前最快的模型,適用於線上客服等需要快速響應的場景。
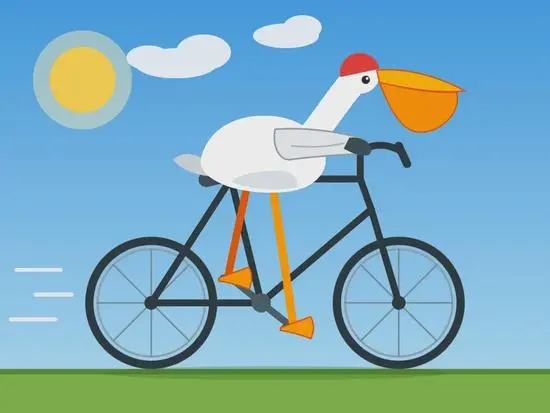
威利森用他慣常的“鵜鶘騎自行車”題目試了五個檔位。這次要求生成的是SVG繪圖程式碼:由程式碼描述鳥、自行車和各個圖形的位置,再顯示成圖像。
低檔只用了7秒,費用為0.0936美分;中檔及以上就能畫出像樣的自行車架。最高檔則花了5分9秒,費用升至3.3826美分。
同一道題,調高推理強度,等待時間和花費都明顯增加。
威利森還注意到,新模型默認使用中檔,推理環節不能完全關閉。
一年前,他讓Haiku 4.5畫同樣的東西,得到的是一隻圓乎乎、粉嘴橙腿的鳥。他當時的評價是:“它畫鵜鶘畫得很糟。”
畫出一幅SVG,與在終端裡連續完成複雜工作,對模型的要求不同。在Terminal-Bench 4.0中,Haiku 5.5得分39.2%,Sonnet 5.5為70.6%。
對於複雜智能體程式設計,Anthropic仍建議優先選擇Sonnet或Opus。
開發者也開始把它放進已有流程。Kacper Kapuściak把一套智能體端到端測試從GPT-6 Luna換到Haiku 5.5,觀察到的結果是:運行更快,但用了更多token,錯誤也更多。
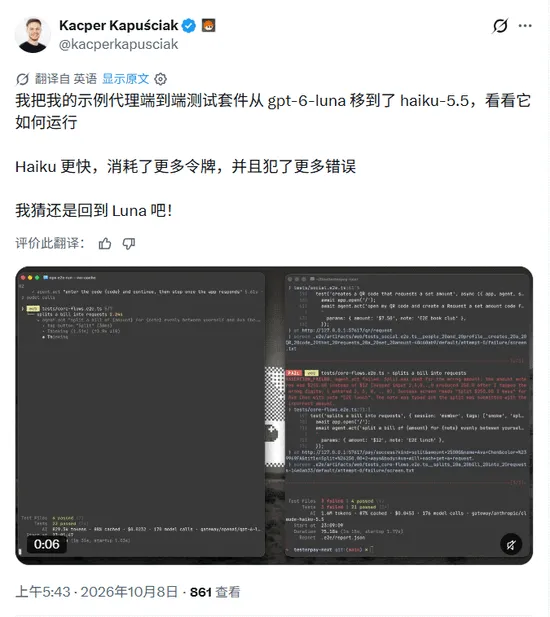
另一位開發者James在自己的內部測試中累計跑了五輪,認為Haiku 5.5的表現仍不及Luna。
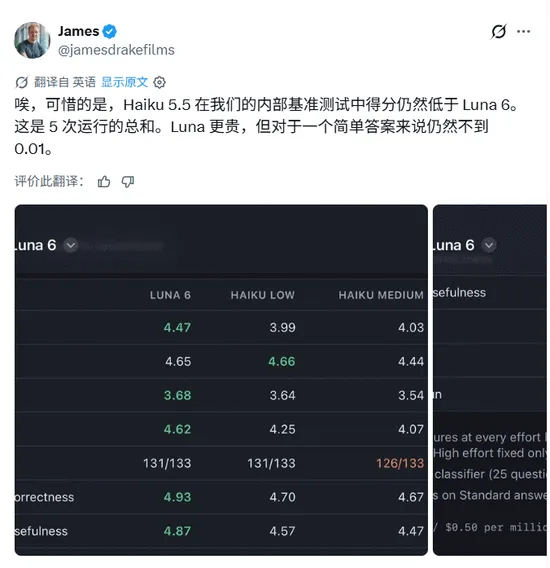
對Kapuściak來說,速度的提升沒有讓這次換模型留下來。他最後又把那套測試切回了Luna。 (網易科技)