
與閒置率較高的聊天機器人不同,Meta Muse等智能體的「始終在線」特性使其對算力的消耗呈數量級增長。花旗預計,這一趨勢將使CPU-GPU配比從訓練期的1:8向1:1演進,推動2030年CPU市場規模達3000億美元。同時,僅1億Muse日活用戶就可能為輝達帶來最高190億美元的GPU收入。
隨著Meta Muse等個人AI智能體的發佈,AI正從被動響應的聊天機器人向全天候自主運行的智能體演進,這或將推高對CPU、GPU、內存及網絡基礎設施的消耗。
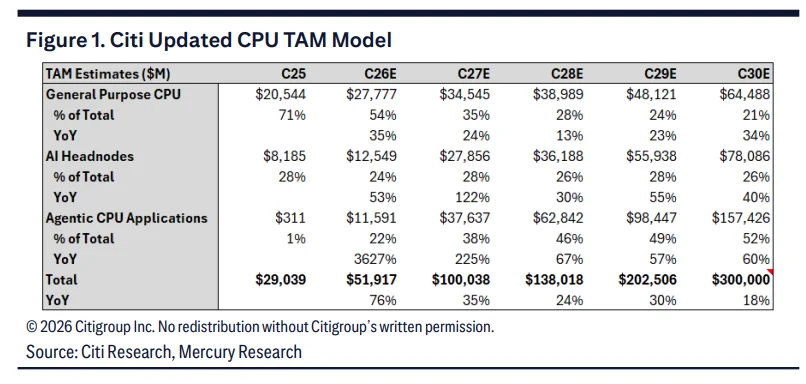
據花旗10月6日最新發布的研究報告,以Meta Muse為代表的智能體應用,正將計算硬體的市場預期推向新高度。該行預計,到2030年,全球CPU總潛在市場規模(TAM)將從2025年的290億美元擴張至3000億美元,年複合增長率高達60%。
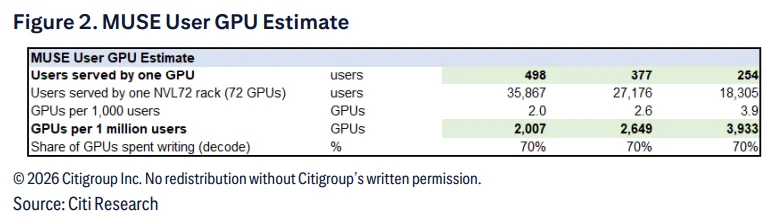
在GPU端,智能體同樣帶來了結構性的增量需求。該行測算,若Meta Muse達到1億日活躍用戶,將需要約20萬至39萬塊Blackwell級別的GPU,這可能為輝達帶來70億至190億美元的一次性收入。
這一趨勢直接利多核心算力供應商。該行指出,由於Meta是AMD服務器業務的最大客戶之一,AMD將成為CPU復興的主要受益者,其目標價被上調至800美元;同時,輝達也將因GPU需求激增而持續獲益。
智能體崛起,CPU成為新瓶頸
在智能體AI爆發之前,CPU主要侷限於傳統工作負載和作為AI應用的頭節點(Head Node)。在頭節點中,CPU僅負責「管理」,將用戶請求發送給GPU並返回結果,繁重的矩陣乘法和推理工作由GPU承擔。
然而,智能體改變了這一分工。花旗在報告中指出:「相比傳統的聊天機器人,我們認為智能體AI是計算需求潛在的呈數量級增長的驅動力。」智能體需要處理編排、推理循環、數據處理和安全組件,這使得CPU成為了新的瓶頸。
隨著AI從模型訓練轉向推理,再轉向智能體自主工作流,CPU與GPU的配比正在發生顯著變化。在模型訓練階段,這一比例為1:8;在推理階段為1:4;而在智能體AI中,這一比例正向1:1甚至更高水平演進。該行預計,到2030年,專用於智能體的CPU將以247%的年複合增長率增長,佔據整個CPU市場52%的份額。
Meta Muse的GPU算力帳本
Meta Muse是首個在真正社交網絡規模上發佈的消費者AI智能體,其計算足跡是目前AI基礎設施中最重要的變量之一。與標準聊天機器人不同,Muse作為自主智能體持續運行,其底層邏輯決定了它對GPU的消耗更為龐大。
花旗構建了自下而上的GPU需求模型。在基準情形下,假設典型用戶每天進行4次簡單請求和12次智能體任務(如尋找餐廳、覈對日曆並起草邀請函),每個智能體任務包含約8次模型調用。由於模型在調用之間沒有記憶,它必須每次重新讀取不斷增長的對話上下文。
基於此,該行測算每位Muse用戶大約需要0.0020塊GB200級別的GPU。簡而言之,一塊GPU大約只能服務500名用戶。該行強調:「智能體在結構上是比聊天機器人更繁重的推理工作負載。」在相同的框架下,聊天式用戶所需的GPU容量僅為智能體用戶的12.5%至25%。
內存與網絡的連鎖反應
智能體工作流不僅對邏輯晶片提出更高要求,其連鎖反應也蔓延至內存和網絡領域。在內存方面,CPU對LP、DDR和SSD有很高的附加率。美光近期指出,以Meta Muse為代表的智能體工作流正在讓消費者獲取更多價值,而CPU正對DRAM造成更多限制。
在網絡端,智能體AI實質性地增加了網絡流量。輝達管理層在與花旗的溝通中表示:「智能體可以持續運行數小時或不間斷運行……從而在消費者和企業工作負載中驅動多得多的Token生成。」
這種持續運行意味著,越來越多訪問基礎設施的是智能體而非人類。這推動了數據中心內部「南北向」流量(如記憶體訪問、安全、配置等服務)的增長,從而為使用DPU(如BlueField 4)和Spectrum-X以太網創造了新的加速機會。 (華爾街見聞)