
AI Agent的非確定性行為,正在從根本上瓦解傳統可觀測性的底層假設
這是一篇關於範式更替的文章。核心判斷只有一句話:AI Agent的非確定性行為,正在從根本上瓦解傳統可觀測性的底層假設;監控正在從"狀態可視"走向"決策可解釋",這是一場範式級重構,而非功能疊加。
本文將用一個真實故障模式的復合案例開場,拆解傳統APM三個根本假設的崩塌過程,給出Agent可觀測性的四維問題框架與三層落地架構,引入2026年最前沿的因果推斷審計方法,並提供三個開源工具的完整部署方案。
引子:凌晨3:47,儀表盤全綠,帳單在燃燒
凌晨3:47,某電商平台的智能客服Agent開始了一次" routine "的售後工單處理。使用者的問題是:"我的訂單為什麼還沒發貨?"Agent呼叫物流查詢介面,介面返回超時。按照設計,它應該重試一次然後轉人工。但它沒有。
它進入了一個精心構造的推理迴環:查詢超時→換一種參數格式重試→把超時原因推斷為"地址缺失"→呼叫地址補全工具→地址補全工具要求先驗證訂單→呼叫訂單查詢→訂單查詢依賴物流狀態→再次呼叫物流查詢……
10分鐘後,值班工程師的手機依然安靜:API成功率99.98%,P99延遲正常,CPU水位20%,所有儀表盤一片綠色。而在帳單側,這個Agent在10分鐘內發起了214次LLM呼叫,累計吞下約9.8億token——按混合模型單價折算,一次迴環,燒掉約2.7萬元。沒有異常,沒有報錯,沒有stack trace。它只是"自信地、全速地做著錯誤的事情,然後接著再做一遍"。
這個案例是基於CNCF官方部落格描述的故障模式整理的復合場景,但故障機制本身毫無虛構:CNCF在2026年8月4日刊發的《You can't debug what you can't see — Observability for AI Agents》一文中,StackGen首席工程師Sabith K. Soopy寫下了這段已經被無數團隊復現的判詞——"Agent不會帶著堆疊軌跡崩潰。
它們迴環、幻覺、燒token,並產出貌似合理卻 subtly wrong 的輸出。你的儀表盤會顯示平台一切健康,而Agent正在燒穿預算反覆呼叫同一個工具——因為從基礎設施的視角看,什麼都沒有壞。"
這就是問題的全貌:故障不在呼叫層,而在決策層——那裡恰恰是傳統遙測的盲區。當故障發生在你的觀測體系物理上無法表達的維度上,再貴的APM也只是昂貴的失明。
這也是我們把Agent可觀測性稱作"CT"的原因:傳統監控是聽診器,聽得見心跳,看不見病灶;而Agent需要的是CT——對決策過程逐層掃描、斷層成像、定位病灶。當軟體開始自己做決定,"CT"就從奢侈品變成了剛需。
一、三個根本假設的瓦解:Agent如何拆掉APM的地基
傳統APM並非做得不好,而是它站立的地基——三個長期被視為公理的假設——正在被Agent逐一拆除。
1.1 假設一:確定性因果鏈
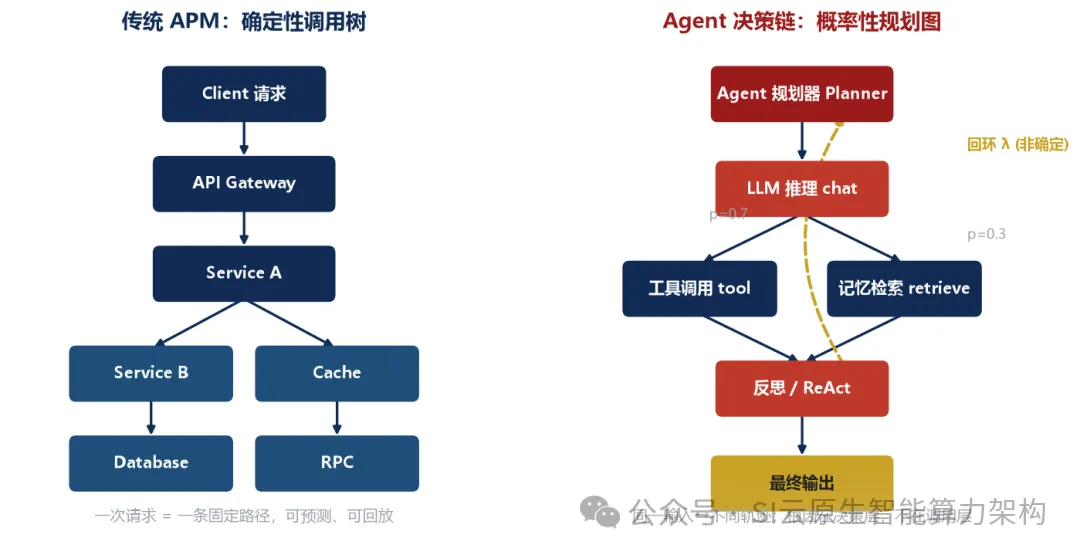
APM的世界觀建立在"請求-響應"模型上:一次使用者請求,沿確定的服務拓撲傳播,每個span的父子關係就是因果關係的投影。呼叫樹即因果圖——這是分佈式追蹤四年來最深刻的隱含承諾。所以"trace"這個詞才可以同時表達"呼叫路徑"和"因果路徑"。
Agent把這份承諾撕碎了。同一個輸入,今天Agent呼叫工具A、明天呼叫工具B;同一個工單,這次三步收斂、那次十二步迴環。呼叫樹依然存在,但呼叫樹不再是因果圖:LLM的採樣溫度、上下文窗口的累積內容、工具返回值的微小差異,都會讓"為什麼"藏在一條這次根本沒被執行的路徑上。你無法通過看樹來回答"為什麼呼叫get_weather三次",因為答案在規劃器的狀態裡,而規劃器的狀態根本沒有被建模為遙測訊號。
1.2 假設二:有限且已知的呼叫層級
微服務時代的呼叫深度是有限的、可列舉的:閘道器→服務→資料庫,最多再套一層RPC。APM的拓撲發現、依賴圖、深度限制,都建立在"層級有限"之上。而多Agent系統引入了遞迴式委託:主Agent把任務拆給子Agent,子Agent再拆給孫Agent,每一層內部還有規劃-執行-反思的循環。
軌跡深度不再是架構圖的函數,而是執行階段決策的函數——理論上無界,實際上不可預估。CNCF AI TCG在2026年3月KubeCon EU發佈的《Cloud Native Agentic Standards》中,明確把"多Agent span巢狀"列為可觀測性支柱的核心難題,並要求用W3C Trace Context把子Agent的span繫結進同一個可觀測工作流——因為"多智能體追蹤巢狀正是大多數供應商當前折戟的地方"。
1.3 假設三:成本是慢變數
傳統系統中,成本(CPU、記憶體、頻寬)是資源佔用的時間積分,變化平緩,可以用小時級粒度的容量規劃管理。而Agent的成本模型是逐token計價、逐呼叫結算:每一次"思考"都在直接產生現金流支出。成本從慢變數變成了快變數——一個迴環可以在10分鐘內製造2萬元等級的損失。
這意味著成本必須從財務月報的角落,提升為一等監控訊號,配基線、配閾值、配熔斷。CNCF那篇部落格的三大實踐教訓之一就是:"成本尖峰是bug最好的金絲雀"——在Agent系統裡,帳單異常往往比任何技術指標都更早暴露問題。
二、四個核心問題:可見性、可解釋性、可行動性,以及錢
假設崩塌之後,Agent可觀測性需要重新定義自己的問題域。我們把它歸納為三個經典維度加一個Agent特有的成本維度。
2.1 可見性:讓決策過程成為一等遙測訊號
可見性的新邊界是:Agent看到的每一個輸入(含檢索上下文與工具返回)、做出的每一個決策、呼叫的每一個工具(名稱、參數、結果、延遲、錯誤態)、最終產出及關聯的業務結果,全部結構化、可回放。
行業裡有個尖銳的甄別標準:只記錄prompt/response對的"AI可觀測性"產品,本質是日誌搜尋;只有當軌跡、多Agent巢狀、生產失敗回放三者齊備,才配叫Agent可觀測性。
2026年,這個邊界被OpenTelemetry GenAI語義約定正式標準化——這是本文第四節之前必須先記住的名詞。
市場側的分化同樣清晰。2026年,三個平台從混戰中拉開身位:LangSmith(LangChain官方,深度繫結LangGraph生態)、Arize Phoenix(OTel中立路線,適合有平台工程能力的團隊)、Braintrust(評測優先,以評促部署)。
與此同時,Datadog在v1.37中原生支援OTel GenAI語義約定,把LLM負載無聲納入既有APM版圖;AWS Bedrock AgentCore Observability則以OTel相容格式輸出遙測,可對接CloudWatch、Datadog、LangSmith與Langfuse。
但整個品類仍處在動盪期——按span計價的商業模式至今沒有定論,這意味著洗牌還將持續。給採購者的建議只有一條:任何框架私有屬性都應疊加在標準schema之上、而非取而代之——今天鎖定私有SDK,就是在給明天的框架遷移埋雷。
2.2 可解釋性:從"那裡慢"到"為什麼這麼做"
傳統根因分析回答"那個服務慢了",Agent可觀測性必須回答"為什麼做出這個決定"。這有一個令人不安的技術前提:Chain-of-Thought並不天然等於真實決策過程。2026年1月的arXiv論文《Project Ariadne》用結構因果模型對此做了嚴格審計,發現所謂"推理軌跡"在很多場景下只是"推理劇場"(Reasoning Theater)——我們第四節會展開。可解釋性因此成為一個數學問題,而不僅僅是UI問題。
還要意識到:解釋是有聽眾的。同一個決策鏈,工程師要的是"那一步開始跑偏、參數為何如此";安全團隊要的是"是否有注入、是否越權、資料去了那裡";合規與監管要的是"這個自動化決定是否符合既定策略、依據那條規則、誰來擔責"。
一份合格的Agent軌跡必須能同時服務三類受眾——這正是"決策可解釋"比"狀態可視"難一個量級的原因:狀態可視只需要一張圖,決策可解釋需要一套按角色切片的語義投影。可觀測性系統若只面向工程師設計,審計與合規就會退回到"翻日誌"的原始時代。
2.3 可行動性:告警要能熔斷,而不只是彈窗
人類響應速度是分鐘級的,而Agent迴環的燒錢速度是秒級的——依賴人看告警再手動止血的體系,在Agent時代結構性失效。可行動性要求告警系統直接掛接執行面:硬性迭代上限、單工具預算上限、連續重複呼叫檢測,在超支之前就攔下Agent的行為。CNCF部落格稱之為"preflight circuit breaker(起飛前熔斷器)":治理邏輯必須前置於損失發生,而不是事後追認。
2.4 成本維度:Token是新的電費
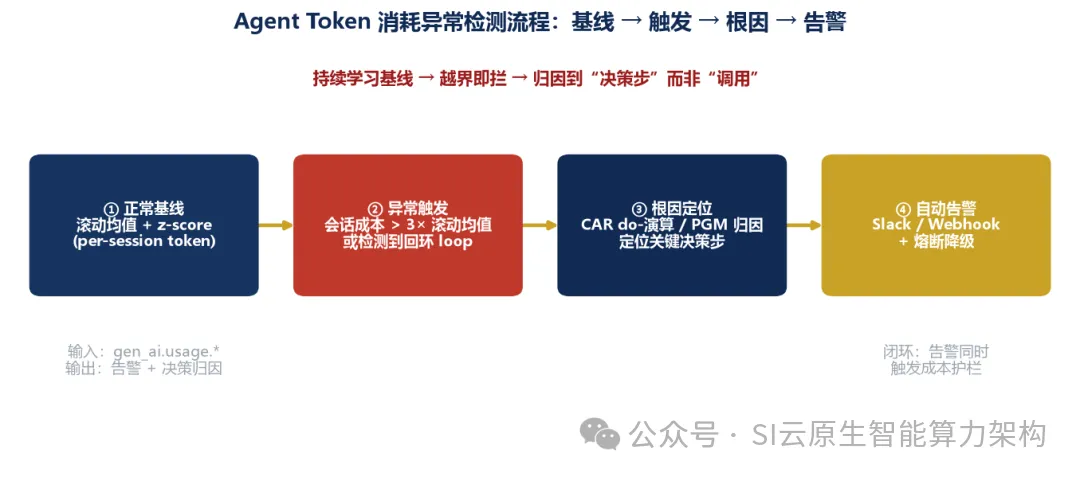
成本監控的正確姿勢是四層漏斗:會話級總成本→單Agent時間序列→按工具/模型拆解→單步token歸因。配套的異常檢測流程如圖3所示:從滾動基線出發,以統計方法識別異常會話,再下沉到決策步定位根因,最後聯動熔斷與告警。值得強調CNCF給出的一個工程紅線:永遠不要把session_id放進Prometheus的label——高基數標籤會直接打爆指標伺服器。指標負責即時告警,軌跡負責事後偵錯,二者不可互相替代。
三、範式對比:從"服務是否存活"到"決策是否合理"
把傳統APM與Agent可觀測性並排放置,差異不是功能多少,而是追問的問題本身變了。APM問:"服務是否存活?延遲多少?錯誤率幾何?"Agent可觀測性問:"這個決策合理嗎?這次委託該不該發生?這12.3k token花得值不值?"
表1從四個工程維度給出對比:
| 資料採集 | gen_ai.* 語義span | |
| 根因分析 | ||
| 成本歸因 | ||
| 合規審計 | append-only決策審計 |
表1 · 傳統APM工具與Agent可觀測性工具能力對比
CNCF部落格把生產級Agent可觀測性總結為三大支柱——軌跡(Traces)、成本(Costs)、審計(Audit),並給出兩條極易被忽視的工程細節:
其一,軌跡投遞必須非阻塞——工具執行永遠不該等待一次同步的POST,span應經batch exporter緩衝、周期性flush,後端當機時"丟遙測,不丟可用性";
其二,審計日誌必須在落地前完成PII消毒,因為這份記錄終將在事故復盤時被翻出來。
這三個支柱合起來指向同一句話:把"決策歷程"本身當作一等公民來收集與展示。
成本支柱的正確姿勢是雙層級監控:單session的token總帳與模型分佈、跨session的聚合趨勢,兩者缺一不可。控管邏輯必須前置——硬性迴環次數上限、單工具呼叫預算上限、連續重複呼叫檢測,都是"起飛前熔斷器";再配一條樸素而有效的告警規則:當某個session的成本超過其滾動均值的數倍時立刻介入。
更進一步,CNCF建議用自動化session體檢替代人肉盯屏:系統自動標記迴環、高成本、工具報錯的異常會話送人工覆核,另配一條doctor式一鍵自檢命令,覆蓋模型連通性、向量庫可達性與trace後端狀態——這些都是可以直接抄進runbook的工程細節。
審計支柱的緊迫性還在被安全事件加速放大。2026年7月,Sysdig威脅研究團隊報告了首個完整執行勒索鏈條的"agentic威脅行為者"JADEPUFFER——其載荷程式碼甚至自帶自然語言推理與目標排序註釋;同一時期,Hugging Face披露基礎設施遭agentic攻擊者竊取評測基準答案。
當攻擊者開始用Agent對抗Agent,append-only審計日誌就成了追責與取證的唯一生命線:凌晨三點,某個持有合法token的部署Agent把生產API縮容到零——那個session、想做什麼、誰批准的、燒了多少token?這五個問題如果一分鐘內答不上來,說明你的Agent正在無審計地 operating 你的基礎設施。
架構師視角:傳統APM與Agent可觀測性不是替代關係——容器、佇列、資料庫依然需要經典監控。正確的結論是"GenAI-native觀測層與經典APM平行":底層繼續用Prometheus+OTel看資源面,上層為Agent形態的負載增加決策面觀測。真正的錯誤是只用其中一層去解釋另一層的故障。
四、行為驗證的數學基礎:把Agent決策鏈當成因果系統來審計
如果說前三節回答"要採集什麼",這一節回答一個更根本的問題:採集到的決策鏈,如何被數學地驗證?2026年,這個問題第一次擁有了嚴肅的學術答案——答案的底座,是機率圖模型與因果推斷這對老搭檔。
4.1 機率圖模型:軌跡是隱變數序列,不是呼叫序列
把一次Agent運行形式化為軌跡 τ = (x₁, h₁, a₁, x₂, h₂, a₂, …, a_T):x是觀測(使用者輸入、工具返回),h是隱變數——規劃器的內部狀態,a是動作(工具呼叫/子Agent委託/輸出)。這在結構上是一個隱馬爾可夫式的機率圖模型:h_t = f(h_{t-1}, a_{t-1}, x_t),動作從條件分佈 P(a_t | h_t) 中採樣。
關鍵區別在於:經典HMM的轉移矩陣是有限維的,而這裡的"轉移函數"由LLM參數化、由無限維的上下文內容調製。狀態空間不可列舉,意味著任何"數值指標+閾值"的監控方案在原理上就不夠用——你必須把語義事件("呼叫了什麼工具""推翻了什麼結論")作為觀測原子。這正是語義層觀測的數學必然性:不是為了好看,而是因為狀態空間的結構逼你這麼做。
4.2 結構因果模型與do-演算:Ariadne的φ與ρ
2026年1月上線的arXiv論文《Project Ariadne: A Structural Causal Framework for Auditing Faithfulness in LLM Agents》(arXiv:2601.02314)把這個框架推到了極致:把Agent的推理鏈建模為一組結構因果模型(SCM)的內生變數,然後執行Pearl意義上的硬干預(do-演算)——系統性地翻轉邏輯算子、否定事實前提、反轉因果方向,再觀察最終答案的分佈位移。它定義了兩個量化指標:
因果敏感度 φ:終端答案對中間推理步干預的響應程度。φ≈0意味著"推理步驟被顛倒了,結論卻紋絲不動"——推理鏈只是裝飾。違反密度 ρ:干預實驗中因果性被違反的比例。Ariadne在事實與科學推理域測得的ρ最高達到0.77——四分之三的干預實驗裡,Agent在自相矛盾的內部邏輯下給出了相同結論。作者給這個現象起了個流傳極廣的名字:Causal Decoupling(因果脫鉤)——推理軌跡在演"推理劇場",真正驅動決策的是參數化的潛在先驗。
這給可觀測性敲響了警鐘:記錄CoT文字 ≠ 記錄了決策依據。一個可解釋性合格的可觀測系統,必須能對軌跡做干預式驗證,而不只是把推理文字渲染在UI裡。
4.3 反事實重放與Shapley歸因:CAR把"那一步導致失敗"變成可計算問題
2026年6月的《Causal Agent Replay》(arXiv:2606.08275)把因果工具對準了生產排障的最高頻問題:Agent失敗了,是那一步造成的?直覺啟髮式在這裡系統性失靈——執行有害動作的那一步,通常不是決定執行它的那一步;而LLM-as-judge的步級歸因在Who&When基準上準確率僅約14%,接近拋硬幣。
CAR的做法是把Agent運行建為SCM,對可疑步施加do操作,在同一隨機策略下向前重執行軌跡,度量結果分佈的位移;跨多步互動的功勞拆分則使用預算受限的蒙特卡洛Shapley估計,且每個效應都附帶置信區間。一句話總結:根因定位從"看trace猜",變成了"干預-重放-檢驗"的因果實驗。
用一個具體場景體會這種反直覺性:客服Agent錯誤地給使用者發了退款。人類復盤者的第一直覺是懲罰"呼叫refund工具"的那一步——但反事實重放會告訴你真相:那怕把那一步的參數改成拒絕退款,只要上游"判定使用者符合補償條件"的推理步不變,策略在下一步仍會找到別的路徑完成補償。病灶是"判定",不是"執行"。這正是SCM干預的威力:它區分了"看起來造成問題的步驟"與"真正改變結果分佈的步驟"——兩者的錯位,恰恰是Agent排障區別於微服務排障的本質。
4.4 誠實的邊界:當信用訊號集體失效
2026年8月的另一項預印本研究(arXiv:2608.19760)給這個方向潑了一盆必要的冷水:在ALFWorld環境的反事實重放審計中,三種業界常用的步級信用訊號——LLM-judge評分、以結果為條件的logprob比值、策略自身置信度——沒有一種識別因果關鍵步的能力顯著優於隨機;隱式信用訊號與"語言流暢度"的中位秩相關高達+0.75,也就是說,我們常把"說得漂亮"誤認為"決定了結果"。同時,僅有約30.5%的決策點攜帶可測量的因果效應——因果貢獻本質上是稀疏的。工程啟示很直接:觀測系統應當披露每個反事實檢驗的支援度與可測性,而不是假裝每一步都能被歸因。
一句話公式化:步級因果貢獻 φᵢ = Σ_S [v(S∪{i}) − v(S)] 的Shapley加權(CAR);推理忠實度 φ = 輸出對do(步k := 反事實)的敏感度(Ariadne);異常檢測 z = (c_session − μ₂₄ₕ)/σ₂₄ₕ > 3 觸發。三件武器共同構成Agent行為驗證的數學底座:機率圖模型提供表達,do-演算提供干預,Shapley提供分帳。
五、架建構議:語義級觀測的三層落地
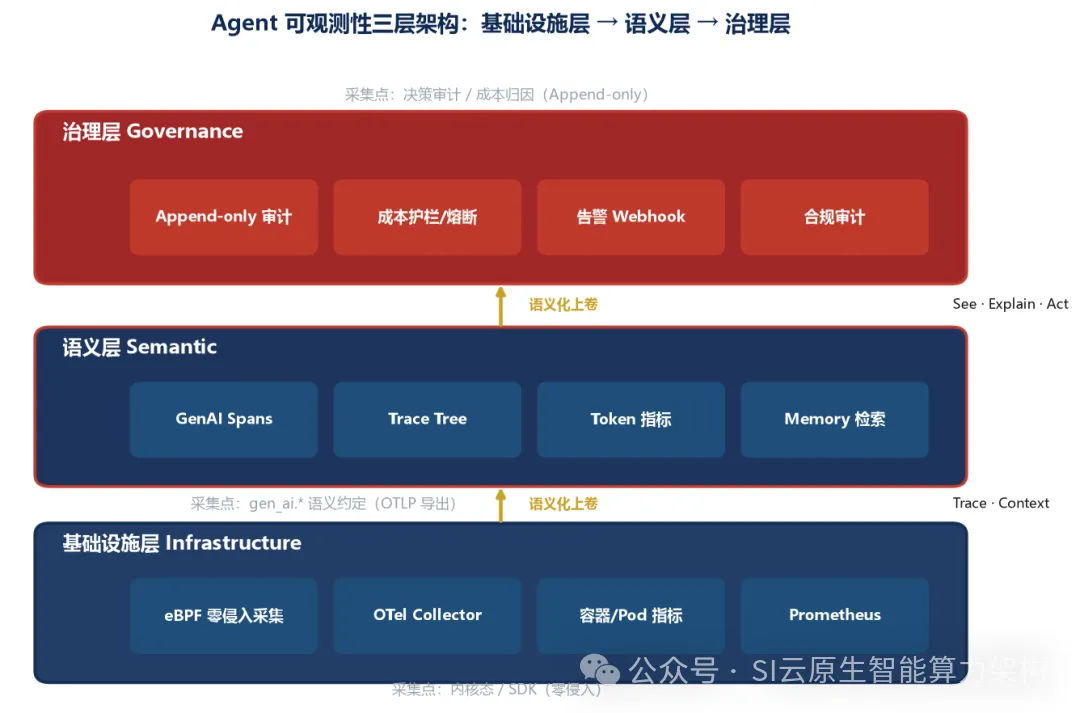
理論講完,落到架構。我們建議按基礎設施層→語義層→治理層三層建設,每層有明確的資料採集點與工具棧。
5.1 語義級觀測:gen_ai.* 全家桶
語義層的地基是OpenTelemetry GenAI語義約定。2026年6月,GenAI語義約定從主倉庫拆分至獨立倉庫open-telemetry/semantic-conventions-genai,當前整體處於Development狀態(核心client側屬性自2025年末起事實穩定)。它標準化了四類span——invoke_agent / chat / execute_tool / retrieval——與一組核心屬性。
兩個必須知道的細節:第一,約定刻意不定義成本欄位——token數是標準,價格表隨時在變,成本應作為派生指標在下游用 token×單價 連接得出,"span模式不該為價格波動買單";第二,務必同時記錄 gen_ai.request.model 與 gen_ai.response.model——伺服器端模型路由與降級會讓"實際服務的模型"偏離"請求的模型",兩者不一致時成本預測與質量歸因都會悄悄失真。Python棧零程式碼接入只需兩行:
pip install opentelemetry-distro opentelemetry-instrumentation-openai-v2 OTEL_INSTRUMENTATION_GENAI_CAPTURE_MESSAGE_CONTENT=true \ opentelemetry-instrument python agent.py
注意環境變數:prompt與響應內容默認不採集,這是正確的隱私預設值——span、模型、token、finish_reason先跑起來,內容捕獲必須帶著脫敏與保留策略 deliberate 地打開。
同時要對約定的成熟度保持誠實:截至2026年中,GenAI語義約定整體仍標註為Development狀態——agent與tool span屬於experimental,獨立倉庫還沒有帶版本號的正式發佈,v1.37.0甚至把gen_ai.system更名成了gen_ai.provider.name,過渡期兩代屬性會並存。工程上務實的做法是:鎖定插樁版本、在處理程序啟動時設定 OTEL_SEMCONV_STABILITY_OPT_IN=gen_ai_latest_experimental、在分析層做屬性代際歸併。標準"Development"的標籤低估了它的實際可用性——核心欄位名自2025年末起就沒再動過——但採用時眼睛要睜開,為欄位演進留好緩衝。
5.2 Agent內部任務規劃追蹤:invoke_agent span樹
自動插樁只能給你一串扁平的chat span,無法知道那次呼叫屬於那個任務。架構上必須手動補兩顆"結構span":用invoke_agent包裹整個運行循環,用execute_tool包裹每次工具呼叫,讓自動插樁的chat span自然掛載其下。
多Agent委託即巢狀:Agent A呼叫Agent B時,B的invoke_agent span作為A某span的child出現,W3C Trace Context保證"誰呼叫了誰"在整棵樹上可追溯。迴環檢測則讀取finish_reasons與工具名序列——同一工具+同一參數連續出現且無進展訊號,即是迴環指紋。這裡有一個架構上的血淚教訓:多Agent巢狀正是當前大多數供應商折戟的地方——不少平台在子Agent委託時丟棄trace上下文,整條委託鏈在UI裡斷成孤島。選型時務必驗證一件事:子Agent的span是否真的掛進了父軌跡。此外,把"doctor式一鍵自檢"(模型連通、向量庫可達、trace後端狀態、預算護欄在位)做成CI裡的常規用例,比任何事後排障都便宜。
5.3 工具呼叫與記憶檢索監控:成功率紅線與檢索質量
工具面監控有兩條鐵律。第一,分工具統計成功率,95%是紅線——任何生產工具成功率跌破95%,按bug處理,不要等它演變成迴環。業內最常見的工單"Agent不調我的工具",九成真相是MCP或下游服務在靜默超時——沒有分工具的span與耗時遙測,這類故障不可見。第二,記憶檢索(retrieval span)必須記錄查詢、召回塊與相關性得分,否則RAG鏈路的"答非所問"永遠無法歸因到檢索層還是生成層。檢索監控的進階玩法是把相關性得分與線上評測聯動:按採樣率對生產流量跑LLM-as-judge(如上下文精度、答案相關性),低於閾值的軌跡自動掛上質量標籤——讓"壞答案"與"產生它的那條路徑"在同一個面板上比肩而立,這是Agent時代根因分析的新形態。
再次強調CNCF用生產事故換來的教訓:label裡放agent名、模型名可以,放session_id會讓指標伺服器死給你看。
六、開源工具與部署實戰:三條路線,各取所需
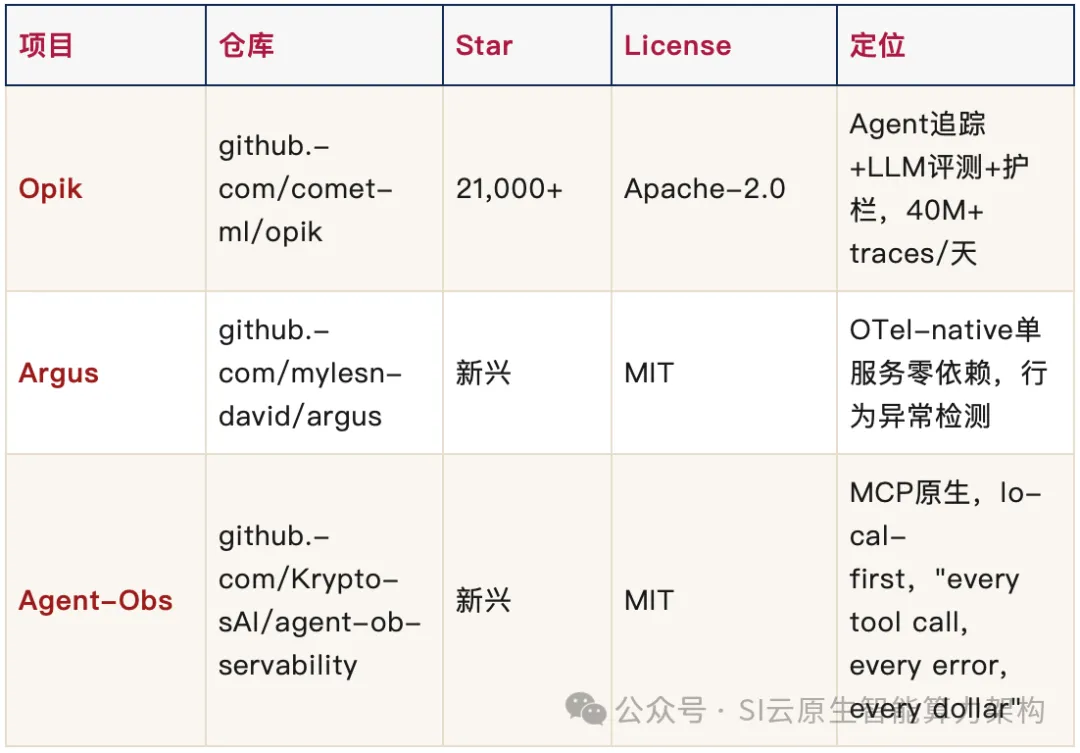
生態層面,2026年的開源格局已經足夠支撐生產落地。三個代表性項目的核心資訊如下:
6.1 Argus:60秒起一套OTel-native觀測台(推薦首選驗證環境)
Argus的賣點是"全見之眼":不只記錄延遲與錯誤,而是盯著Agent的行為——迴環、工具失敗、拒絕回答、失控token——在靜默失敗時主動告警。整個系統是單服務、零第三方依賴(使用Node內建node:sqlite),非常適合作為團隊的第一個Agent觀測試驗田。
環境要求:Node.js 22+(node:sqlite需要)。無資料庫、無建構步驟、無npm install。
git clone https://github.com/mylesndavid/argus.git cd argus node bin/argus.js # 啟動儀表盤 + OTLP採集服務,默認 http://localhost:4317 node seed.js # 可選:灌入一套真實的演示軌跡 # 瀏覽器打開 http://localhost:4317
接入你的Agent:任意語言的OpenTelemetry匯出器,把OTLP/HTTP端點指向 POST http://localhost:4317/v1/traces 即可——Argus原生理解gen_ai.*語義約定,agent/model/tool span與token用量零對應直接入庫。Python側最小接入:
pip install opentelemetry-sdk opentelemetry-exporter-otlp-proto-http from opentelemetry import trace from opentelemetry.sdk.trace import TracerProvider from opentelemetry.sdk.trace.export import BatchSpanProcessor from opentelemetry.exporter.otlp.proto.http.trace_exporter import OTLPSpanExporter provider = TracerProvider() provider.add_span_processor(BatchSpanProcessor( OTLPSpanExporter(endpoint="http://localhost:4317/v1/traces"))) trace.set_tracer_provider(provider)
配置與驗證:三個環境變數搞定生產化——PORT(默認4317)、ARGUS_DB(默認./argus.db)、ARGUS_WEBHOOK(告警目的地,Slack incoming webhook或任意HTTP端點)。驗證方法:先node seed.js灌入演示資料,打開http://localhost:4317應看到p50/p95/p99延遲、分模型成本拆解與Trace Explorer;再把一個會觸發工具迴環的測試Agent指向它,數分鐘內Behavioral Issues面板應自動浮出loop告警——從"看不見"到"自動告警"的完整閉環,15分鐘內可以驗證完畢。
6.2 Opik:從追蹤到評測到護欄的完整閉環(生產級推薦)
如果你要的是"追蹤+評測+護欄"一體的平台級方案,Opik是當前開源陣營裡許可最乾淨(全倉庫Apache-2.0,無企業版程式碼隔離)、規模最硬(設計目標40M+ traces/天)的選擇。它內建30+ LLM-as-judge指標(幻覺檢測、答案相關性、上下文精度)、線上評測規則與即時護欄,整合70+框架(LangChain、LlamaIndex、Autogen、Dify等),還提供獨家的Agent Optimizer自動最佳化SDK。
環境要求:Docker與Docker Compose(自託管全平台);Python 3.9+(SDK)。
# 1) 自託管 server(資料不出內部網路) git clone https://github.com/comet-ml/opik.git cd opik ./opik.sh # Linux/macOS;Windows 用 docker compose up -d # 2) 安裝SDK並指向本地server pip install opik opik configure # 互動選擇本地部署,填 http://localhost:5173
驗證:5行程式碼看到第一棵trace樹:
from opik import track @track # 巢狀函數自動形成span樹 def my_agent(user_question: str) -> str: return "Hello" my_agent("ping") # 打開 http://localhost:5173 —— trace已入庫,含輸入/輸出/耗時/token與OTel的關係值得說明:Opik同時提供OTLP端點消費標準gen_ai.*軌跡——插樁時鎖定開放標準、後端隨時可換,從託管版切自託管、從Opik切Langfuse,改一個環境變數即可,SDK呼叫一行不動。2026年的兩個新動向也值得跟進:其一是Cost Intelligence功能(2026年6月上線),可按團隊追蹤Claude Code、Codex等編碼Agent的開銷——FinOps與Agent觀測正在合流;其二是Opik MCP伺服器,讓Claude Code、Cursor等編碼智能體直接讀取trace、評分輸出、運行評測——觀測資料本身開始被Agent消費,形成"Agent觀測Agent"的閉環。
6.3 Agent-Obs:MCP時代的零摩擦觀測
Agent-Obs代表了另一個方向:觀測能力本身作為MCP伺服器交付——local-first、零憑證、npx一鍵啟動,宣稱覆蓋"每一次工具呼叫、每一個錯誤、每一分錢"。它適合個人開發者與MCP原生的Agent桌面環境,把追蹤資料留在本機。Node 18+環境下一行接入任意MCP客戶端(Claude Desktop / Cursor / VS Code等):
// claude_desktop_config.json / .cursor/mcp.json / .vscode/mcp.json { "mcpServers": { "agent-observability": { "command": "npx", "args": ["-y", "agent-obs"] } } }保存配置重啟客戶端即完成安裝——這正是MCP作為"AI時代USB-C"的紅利:觀測工具的接入成本被壓到了配置檔案的三行JSON。需要提醒的是,該項目尚處早期(Star數還很小),建議作為輕量本地方案與Argus/Opik組合使用,而非企業級唯一依賴。
七、未來展望:2028,可觀測性將消失於Agent執行階段
給出一個可能引發爭議的判斷:到2028年,Agent可觀測性將不再是一個獨立品類,而是嵌入每一個Agent執行階段框架的默認能力。這不是拍腦袋,而是一條已經被驗證過三次的演進路徑:
第一段(2015–2023):eBPF證明"採集可以消失"。Cilium、Pixie、Beyla證明了零侵入採集的可行性——DaemonSet一裝,全叢集的HTTP/gRPC/SQL呼叫盡收眼底,業務程式碼一行不改。觀測的第一性原理被改寫:最好的插樁,是沒有插樁。
第二段(2020–2026):OTel證明"管道可以統一"。2026年,OpenTelemetry正式從CNCF畢業,OTLP成為事實標準;3月26日Profiles訊號進入Public Alpha,四個可觀測性支柱首次被收入同一SDK、同一協議、同一語義約定層。CNCF生態中超80%可觀測性項目原生支援OTLP。管道層的戰爭結束了——勝利者不再是一個產品,而是一個協議。
第三段(2024–2027):GenAI約定證明"語義可以標準化"。gen_ai.*與mcp.*屬性、invoke_agent/chat/execute_tool四類span、六層語義覆蓋(從LLM客戶端呼叫到質量評估)——Agent遙測的詞彙表已經定稿。2026年的現實是:LangChain、CrewAI、AutoGen、AG2已原生或通過官方插樁發射標準span,Datadog、Grafana、Honeycomb、New Relic均原生消費;"選格式"的辯論已經終結,辯論只剩"選後端"。
第四段(2027–2028):語義追蹤沉入執行階段。推理鏈條如下:當span模式成為標準,框架之間的差異化就不再可能建立在"我的trace格式更好"上;當CNCF AI TCG已把"OTel+token指標+agent traces"寫進雲原生Agentic標準的四支柱,合規壓力會讓"默認開啟語義追蹤"成為框架的准入門檻而非增值功能;當成本護欄與迴環熔斷成為生死功能,使用者會像今天選K8s默認看調度器一樣,把"觀測是否內建"列為選Agent框架的第一問。三個壓力同向,終點只有一個——觀測內化。加上第四節的因果審計方法(Ariadne/CAR)正在快速工程化,未來的Agent執行階段大機率原生攜帶三件套:語義軌跡發射器、token熔斷器、反事實重放器。
對產業格局的影響可以推演得更具體。框架側:LangGraph、CrewAI、AutoGen、OpenAI Agents SDK這類執行階段將把"原生發射gen_ai.* span + 內建預算護欄"寫進默認行為,觀測能力從賣點降級為準入項——就像今天的K8s不會把"有日誌"當作特性宣傳。平台側:獨立觀測廠商的護城河將從"採集"(已標準化,無差異)轉向"分析"——因果歸因、行為基線、自動評測、回放調參,誰能把Ariadne式的忠實度審計做成一鍵產品,誰就接過了品類的大旗。基建側:雲廠商會沿襲Bedrock AgentCore的路線,把觀測做成Agent託管服務的原生開關,"開Agent即開觀測"。三個方向殊途同歸:獨立品類溶解,能力擴散到棧的每一層。對企業而言,真正的風險不是"沒趕上某個工具",而是觀測管線仍鎖定在某個私有SDK上——標準收攏的窗口期,正是遷移成本最低的時候。
歷史的註腳早已寫好:今天你不會說"我部署了一個日誌系統",日誌是執行階段的默認產出;2028年你也不會說"我為Agent部署了可觀測性"——它只是執行階段的一部分。品類消失之日,才是範式勝利之時。
結語
回到引子裡那個凌晨3:47的迴環。它的教訓從來不是"要買一個新工具",而是:當故障發生在你的觀測體系物理上無法表達的維度,任何工具都救不了你。傳統監控看的是心跳,Agent可觀測性看的是抉擇——前者告訴你系統是否活著,後者告訴你它是否值得被信任。
軟體工業用二十年學會了給基礎設施做心電圖;接下來兩年,必須學會給AI做CT。因為下一場燒掉數十萬的故障,儀表盤上依然會是一片綠色。看不見決策的系統不是黑箱,是盲盒——而沒有人能把公司的命運,託付給一個盲盒。
金句收尾:監控回答"系統是否活著",可觀測性回答"為什麼出問題",而Agent可觀測性回答的是這個時代最貴的問題——"它做的決定,你敢不敢簽自己的名字。"(SI雲原生智能算力架構)