
好傢伙,世界動作模型(WAM)賽道,中國團隊直接衝到了全球第一?!
而且,GPT-6-Astra、Physical Intelligence的π0.5、輝達GR00T-N1.7等一眾全球頭部具身模型,這次都被甩在了身後。
出手的是一家中國機器人公司——清華唯一持股的嫡系具身公司,星動紀元。
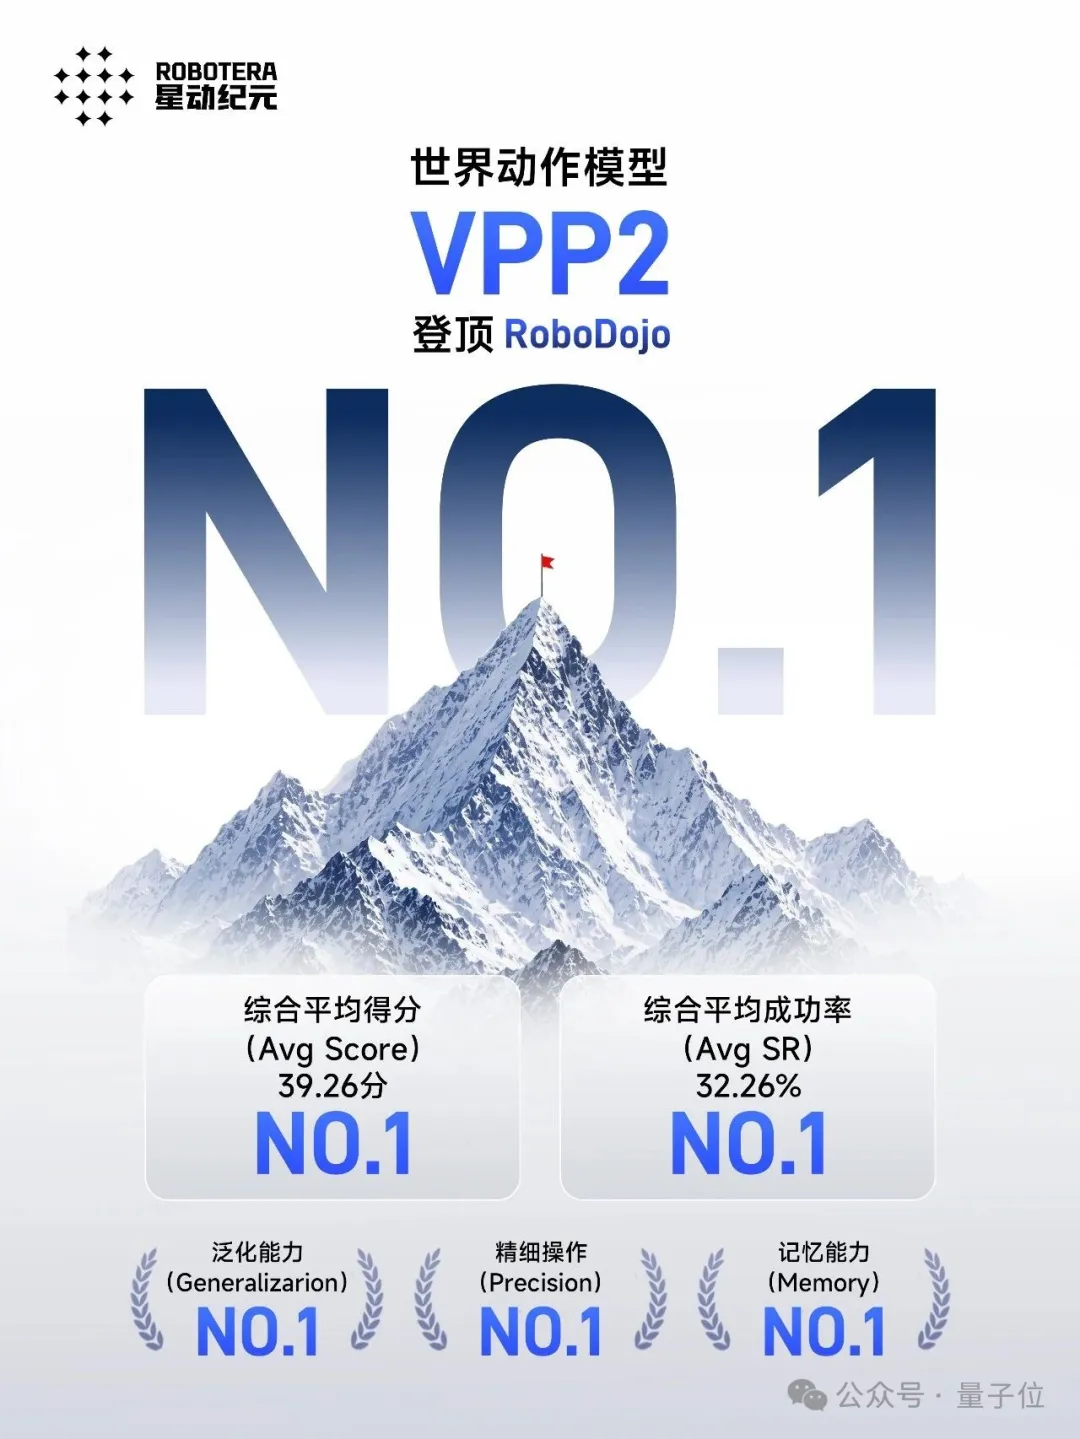
近日,星動紀元自研的世界動作模型VPP2,一舉登頂RoboDojo模擬榜單。
綜合平均成功率32.26%,綜合平均得分39.26分,兩個指標雙雙第一。
關鍵是,這場比賽還真不好打。
RoboDojo號稱具身智能界的「珠穆朗瑪峰」,由香港大學MMLab牽頭,全球近20所頂尖學術機構共同建設。
它專挑機器人不擅長的地方出題:換個環境,還會不會幹活?東西擺歪了,還能不能抓準?任務做到一半,還記不記得前面發生了什麼?
總之,想靠刷熟練度矇混過關,沒那麼容易。
結果呢?
星動紀元VPP2不僅拿下綜闔第一,在泛化能力、精細操作、記憶能力三個維度上,也拔得頭籌。
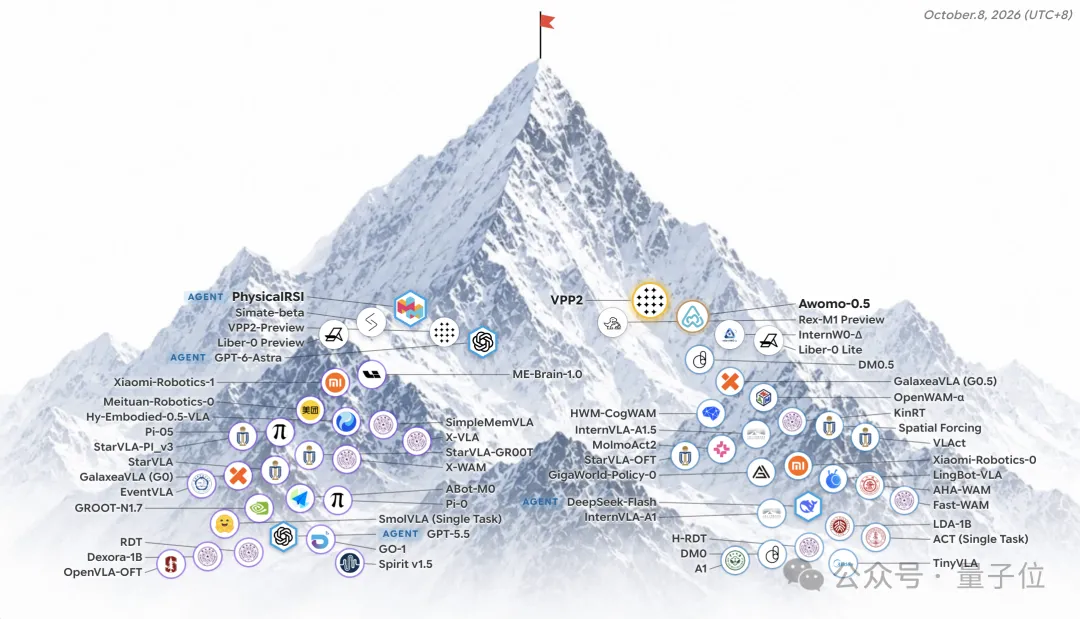
據說,這次VPP2沒有額外加資料,也沒用Agent RSI等增強手段,僅靠「標準資料集」,就把一眾高手給捲了下去。
這代表著VPP2模型本身足夠強,性能提升來自預訓練,基座足夠泛化,因此不靠外掛增強策略,不靠擴充資料「刷分」。
不是,哥們兒,這麼夯的模型到底是怎麼練出來的啊???
我們往技術路線裡扒了扒,你別說,VPP2這次的突破,還真有點東西。
它瞄準了世界動作模型的一道老大難問題:預測錯了,動作就跟著錯。
VPP2給出的解法,是先把視訊預測能力練到足夠強,再讓機器人在陌生環境裡真正動起來。
從預測到行動,兩種泛化能力一起提升。
從目前披露的多項測試結果來看,VPP2已經成為世界動作模型WAM賽道中,最有競爭力的選手之一。
世界動作模型WAM,捲出一個新冠軍
具身智能行業有個挺尷尬的現象。
機器人Demo越做越炫,模型榜單分數也越來越高,但真要問一句,誰的機器人更聰明、更能幹活?
還真不好回答。
比如讓機器人抓杯子。在訓練時見過的桌面上,它可能百發百中。結果換個杯子、挪下位置,立刻開始懷疑人生。
更別提那些需要連續執行多個步驟的任務了。
這也是為什麼,RoboDojo這套評測值得關注。
它的目標是為具身智能建立統一、可復現的評測標準,模擬測試包含42項雙臂操作任務,覆蓋泛化、精準操作、長程任務、記憶、開放詞彙指令理解五個維度。
說白了,就是把機器人拉出舒適區。
傳統機器人模型在熟悉任務上可能接近滿分,一旦環境、物體位置、任務組合發生變化,成功率可能明顯下降。
RoboDojo專門對這類複雜情況進行考察,看機器人面對變化時,有多少泛化能力。
而VPP2這次交出的成績單,相當亮眼。
平均成功率32.26%、平均得分39.26分,兩個指標均位居榜首。
作為對比,在RoboDojo模擬基準的後訓練評測中,GPT-6-Astra的平均成功率為22.48%,平均得分28.97分。
而VPP2分別領先9.78個百分點和10.29分。
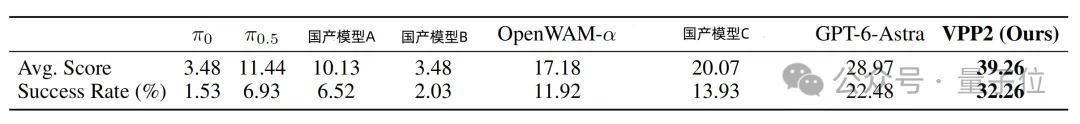
△論文截圖,基線模型資料取自官方排行榜
這裡兩個指標各有側重:成功率看機器人能否完整完成任務;平均得分則衡量任務推進到了那一步,即便沒能全部完成,也能體現其階段性表現。
兩項指標均綜合了五大能力維度的測試結果。
換句話說,VPP2不僅完成任務的比例更高,面對沒能做完的任務,也體現出了更強的階段性完成能力。
而且,這種領先並不侷限於綜合成績。
拆開五項能力維度來看,VPP2在泛化、精準操作、記憶三個維度上,同樣拿下第一。
這三項能力對應著機器人進入真實世界的幾道難關:換個環境還能不能幹活,操作能不能做准,以及連續執行任務時能不能記住前面的步驟。
綜合成績領先,關鍵能力也能打。
不過,RoboDojo再難,考場終究還是「模擬環境」。真到了物理世界,物體的摩擦、形變、位置偏差,又會陡生變數。
VPP2在模擬裡展現出的泛化能力,到了真機上還能成立嗎?
星動紀元也做了實驗。
這次,團隊直接把VPP2部署到真實ALOHA雙臂機器人上,測試了抓取、放置、堆疊、摺疊、傾倒等10類零樣本操作任務。
也就是說,無需針對這些測試任務進行額外微調,機器人就得直接上手。
結果,VPP2再次交出領先成績:平均成功率58.5%,高於π0.5的40%。
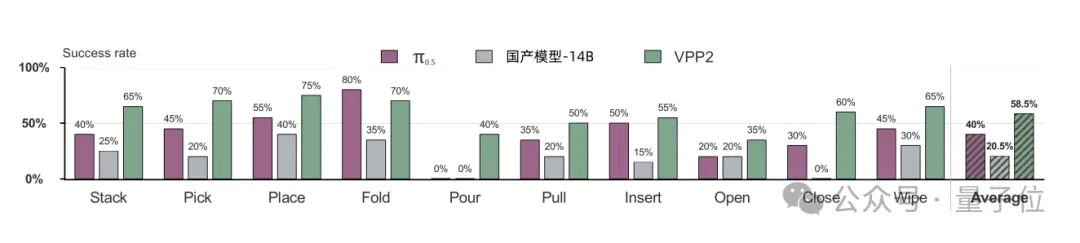
在10類任務裡,VPP2拿下了9類最佳成績。
這下有意思了。
榜單第一,證明的是它在標準評測體系裡的能力;真機零樣本操作,則進一步考察這些能力能否遷移到真實物理環境。
兩份成績單擺在一起,VPP2的技術優勢就更值得深挖了。
要知道,VPP2走的是世界動作模型(WAM)路線。
這類模型的基本思路,是借助視訊預測理解物理世界接下來會如何變化,再把這種預測轉化為機器人動作。
但這條路線長期存在一個問題:視訊預測得漂亮,不代表機器人真的會幹活。
VPP2這次,偏偏就衝著這個問題去了。
從預測泛化到行動泛化,VPP2怎麼做到的?
想理解VPP2的突破,先來看一個簡單任務:讓機器人把桌上的杯子放進盒子裡。
對人類來說,伸手抓住、抬起來、放進去,幾乎不用思考。
但機器人得判斷杯子的位置、機械臂的運動軌跡、夾爪何時閉合,還要預測整個操作過程中,物理世界會發生什麼變化。任何一步出了偏差,都可能翻車。
現有的世界動作模型(WAM),恰恰容易在這裡出問題。
一方面,普通視訊模型擅長生成畫面,但畫面看著合理,和符合真實物理規律是兩回事。
比如要求抓左邊的杯子,模型卻預測抓起右邊那個。視訊照樣能生成,機器人執行時卻會直接跑偏。
另一方面,直接把動作學習加入視訊模型,還可能損傷原本的泛化能力。
結果動作學會了,機器人換個環境卻不會做了。
VPP2提出了一個很直接的判斷:視訊預測的質量,決定了動作的上限。
基於這一思路,星動紀元選擇將視訊預測與動作學習分階段訓練,重點不是「視訊、動作一鍋燉」,而是把兩者「解耦」,重新「排序」。
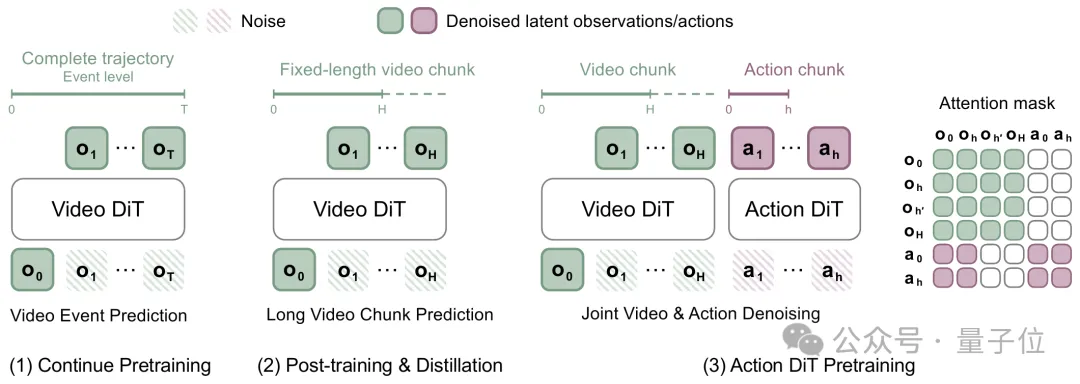
星動紀元為此設計了一套三階段訓練策略:
第一階段,事件級視訊繼續預訓練,讓模型學會預測完整操作過程。
- 第二階段,固定時長視訊後訓練與蒸餾,讓預測能力跟得上機器人即時執行的速度。
- 第三階段,動作專家訓練,將視訊預測轉化為具體動作,同時儘量保住原有的泛化能力。
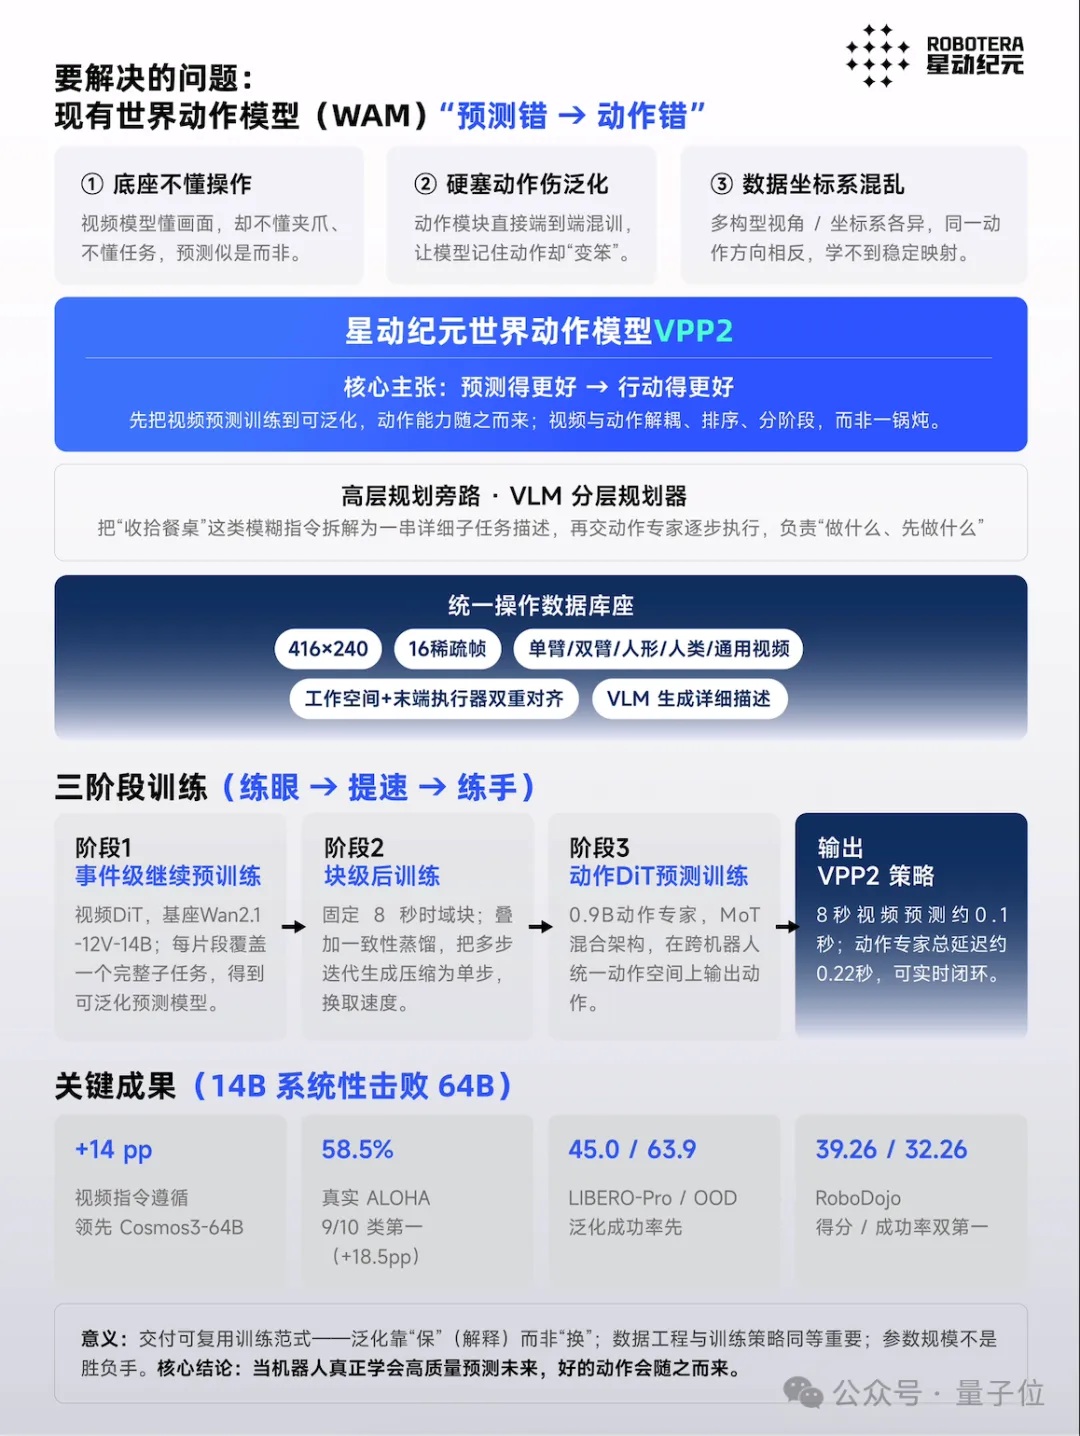
三個階段層層遞進,最終指向兩個核心突破:預測能泛化,行動也能泛化。
第一個突破:讓視訊預測具備泛化能力
VPP2首先要解決的,是機器人能否精準預測陌生任務中的物理變化。
星動紀元以阿里開放原始碼的Wan2.1-I2V-14B為基礎,整合機器人操作、人類活動、通用視訊等多種資料,覆蓋不同機器人本體和操作方式。
不過,真正有意思的是它對資料的處理。
團隊沒有簡單地把視訊一股腦喂給模型,而是先將操作過程切分成語義完整的片段,再配上詳細描述。
比如,不能只告訴模型「把杯子放進盒子」,還要明確是那只機械臂、那個杯子、那個盒子,以及整個操作過程。
因為同一句模糊指令,可能對應無數種動作軌跡。
模型如果連操作對象都沒搞清楚,自然很難精準預測未來。
VPP2索性把任務描述得更細,讓語言指令和物理操作形成更穩定的對應關係。
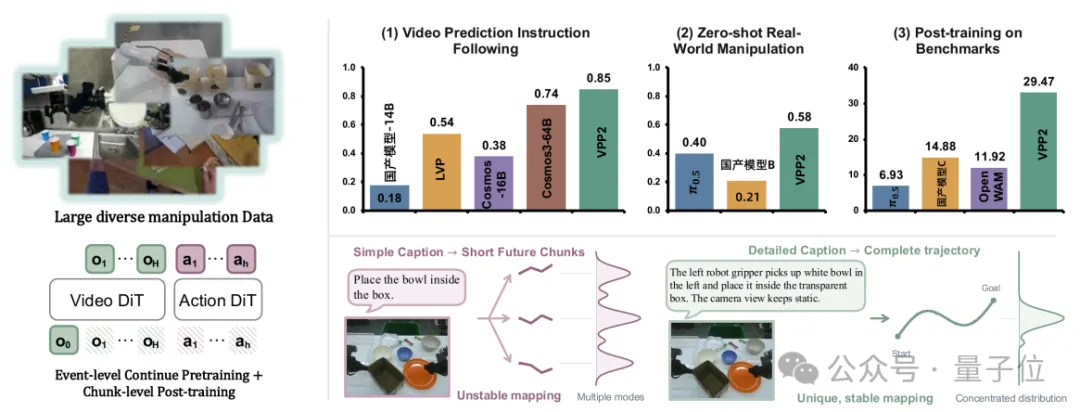
更關鍵的一步,是事件級視訊預測訓練。
傳統短時預測關注接下來幾幀會發生什麼,而VPP2直接讓模型學習一次完整操作從開始到結束的變化。
從機械臂靠近杯子,到抓住杯子,再到放進盒子,模型要理解的是一整件事如何發生。
這樣一來,面對新的物體、位置甚至操作任務,它才更有機會預測合理的物理變化。
在機器人操作視訊的指令遵循測試中,14B參數的VPP2達到90%的成功率,而64B參數的Cosmos3模型為78%。
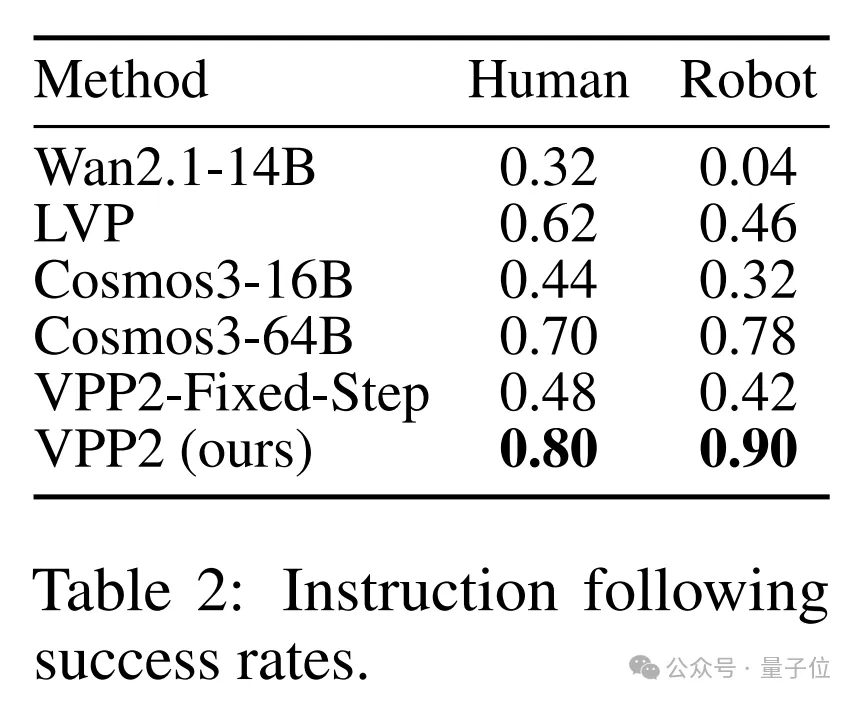
14B打贏64B。
這也說明,在物理操作預測中,參數規模並非唯一的勝負手,能否真正理解操作過程同樣重要。
不過,預測得再准,機器人動不起來,也白搭。
第二個突破:讓預測泛化變成行動泛化
這裡有兩道檻,一是速度,二是如何在學會動作的同時,保住視訊模型原有的泛化能力。
第一道檻很好理解。如果讓機器人幹活,每個動作發生前都要花幾秒生成視訊,那麼再強的預測能力也很難派上用場。
星動紀元選擇先給預測模型提速。
團隊將事件級預測模型進一步調整為固定8秒的視訊片段預測,再通過一致性蒸餾,將多步計算壓縮為單步生成。
最終,預測未來8秒的視覺變化,計算耗時約0.12秒。
第二道檻,稍微棘手一些。
前面好不容易讓視訊模型學會了預測陌生任務,結果加入動作訓練後,模型反而只會執行熟悉的操作。
動作能力長出來了,泛化能力卻丟了?VPP2要做的,就是同時跨過這兩道檻。
VPP2引入一個0.9B參數的擴散Transformer(Action DiT),採用MoT架構,學習如何根據預測的未來狀態生成機器人動作。
但星動紀元沒有直接將視訊預測模型(Video DiT)和動作專家一起從頭訓練。
在動作訓練初期,視訊模型的基礎參數被凍結,僅通過LoRA進行適配,儘量避免動作訓練破壞已有的預測泛化能力。
相當於先讓機器人理解物理世界怎麼變化,再訓練它如何把這種「理解」轉化為「動作」。
兩種能力分階段生長,又相互配合。
最終,視訊預測約耗時0.12秒,動作專家約耗時0.1秒,整體動作片段生成延遲約為0.22秒。
當然,架構再漂亮,也得看最終效果。
前面提到的ALOHA真實機器人零樣本測試,已經展現出VPP2將預測能力轉化為陌生任務操作的潛力。
另外兩套泛化測試,則進一步驗證了這條路線。
LIBERO-Pro考察物體位置、任務要求變化後的操作能力,VPP2取得45.0%的總體成功率,其他基線模型最高為11.0%。
LIBERO-OOD則考察組合泛化,將熟悉的物體、佈局和任務目標重新組合,形成此前沒見過的新任務。
VPP2的總體成功率達到63.9%。
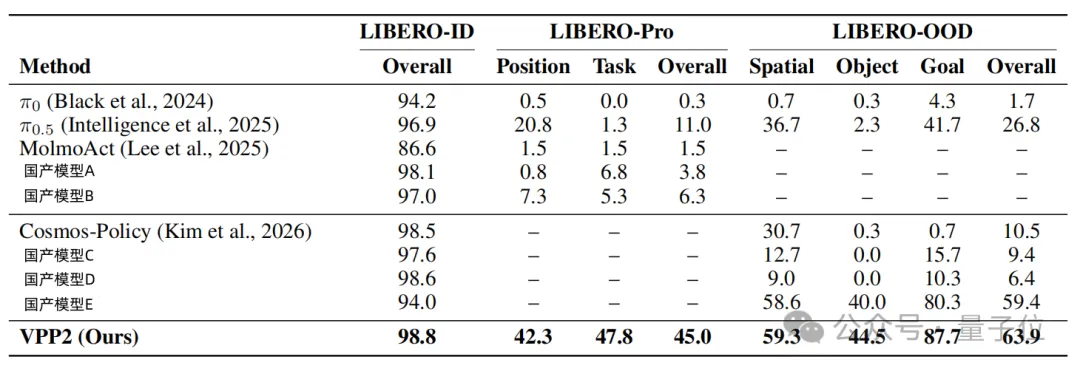
把這些結果放在一起看,VPP2的技術思路就清楚了。
先通過多源資料、詳細任務描述和事件級預測訓練,讓模型更準確地預測物理變化。
再通過蒸餾加速、分階段動作學習,將這種預測能力轉化為實際操作,同時儘量保留原有的泛化能力。
具身智能的性能上限,顯然還沒到只能靠規模硬堆的地步。
VPP2再次說明,最佳化資料管線、調整訓練範式,這些看似樸素的工程方法,仍然有機會帶來可觀的模型性能提升。
從GPT到WAM,物理AI正在形成新範式
預測能泛化,行動也能泛化,是VPP2作為世界動作模型WAM,最值得關注的核心突破。
但真實任務往往更加複雜。機器人不僅要知道怎麼做,還得判斷先做什麼、後做什麼。
這就需要更高層的認知與規劃能力參與進來。
星動紀元這裡貢獻了一個思路:GPT負責想,VPP2負責做。
前者負責理解、推理和規劃,把複雜任務拆解成明確步驟;後者負責預測物理世界如何變化,再將規劃轉化為具體動作。
這一思路,在VPP2論文中已經有了初步的實驗支撐。
團隊實際採用的是VLM高層規劃器,由其負責語義理解、記憶和任務拆解,再將明確的子任務交給VPP2執行。
結果相當直觀。在RoboDojo選定的長程任務測試中,引入VLM子任務規劃後,平均成功率從27.6%提升至57.6%。
這意味著,機器人要完成複雜任務,光有強大的動作能力還不夠。高層規劃與底層執行能否配合,同樣影響任務完成效果。
順著這條思路往後看,GPT+VPP2有望形成一種新的物理AI技術範式:通用認知+通用物理執行。
GPT等通用模型負責理解意圖、推理和規劃,VPP2這樣的WAM負責預測物理變化、生成動作,再通過執行反饋持續調整。
從認知、規劃、預測,到執行、反饋,一套完整的物理AI閉環逐漸清晰。
而這,也讓WAM的價值有了更大的想像空間。
模型能力要通過本體與物理世界互動,真實使用又會暴露失敗、產生反饋,推動模型和硬體繼續改進。
星動紀元同時做大腦、本體和靈巧手,「深全端」的戰略可以在這一邏輯中得到解釋:公司試圖掌握的不僅是訓練環節,也包括能力落地與反饋回流的環節。
u1s1,技術路線再漂亮,最終還是得去真實世界裡幹活。
星動紀元在這方面,已與中國郵政、順豐等企業開展合作,在全國5個省市、10余個物流中心常態化營運。
物流場景中的貨物尺寸、擺放位置、作業流程都可能發生變化。同樣一套操作,換個倉庫,機器人可能就得重新適應。
這也對機器人的泛化能力提出了更高要求。
模型能否把學過的本事遷移到陌生任務中,直接關係到未來跨場景部署的效率和成本。
當然,已有物流業務的商業化進展,並不意味著VPP2已經實現規模化部署。模型能否在更多真實場景中長期穩定運行,還需要進一步驗證。
但VPP2這次的成績,已經釋放出一個值得關注的訊號。
世界動作模型的競爭,正在從預測未來,進一步走向把預測轉化為通用行動。
回頭再看RoboDojo登頂,值得關注的也就不只是一個第一名了。
從模擬到真機,從預測泛化到行動泛化,VPP2的一系列實驗結果表明:視訊預測與動作學習的分階段訓練,確實能夠提升機器人在陌生任務中的操作能力。
而隨著GPT等通用認知模型與WAM進一步結合,物理AI也有望形成更完整的能力體系。
說到底,具身智能下一輪比拚的,就是機器人能否把學到的本事,帶進更多陌生場景。
預測得準,還要做得到。這才是世界動作模型真正走向物理世界的關鍵。 (量子位)