
Andrej Karpathy最新長推,給出新的判斷,這是對4月份他的一條推文的重新補充
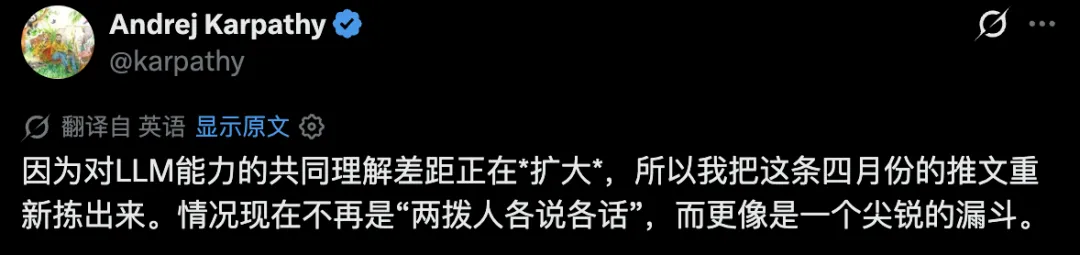
Karpathy警告:全世界絕大多數人以為AI不過是個經常出錯的玩具,但真實情況是,全球只有大約5000人真正見識到了前沿AI徹底失控的恐怖能力。
普通人與頂級專家對AI能力的理解斷層正在急劇拉大。
這種差距已經演變成一個極其殘酷的陡峭漏斗。
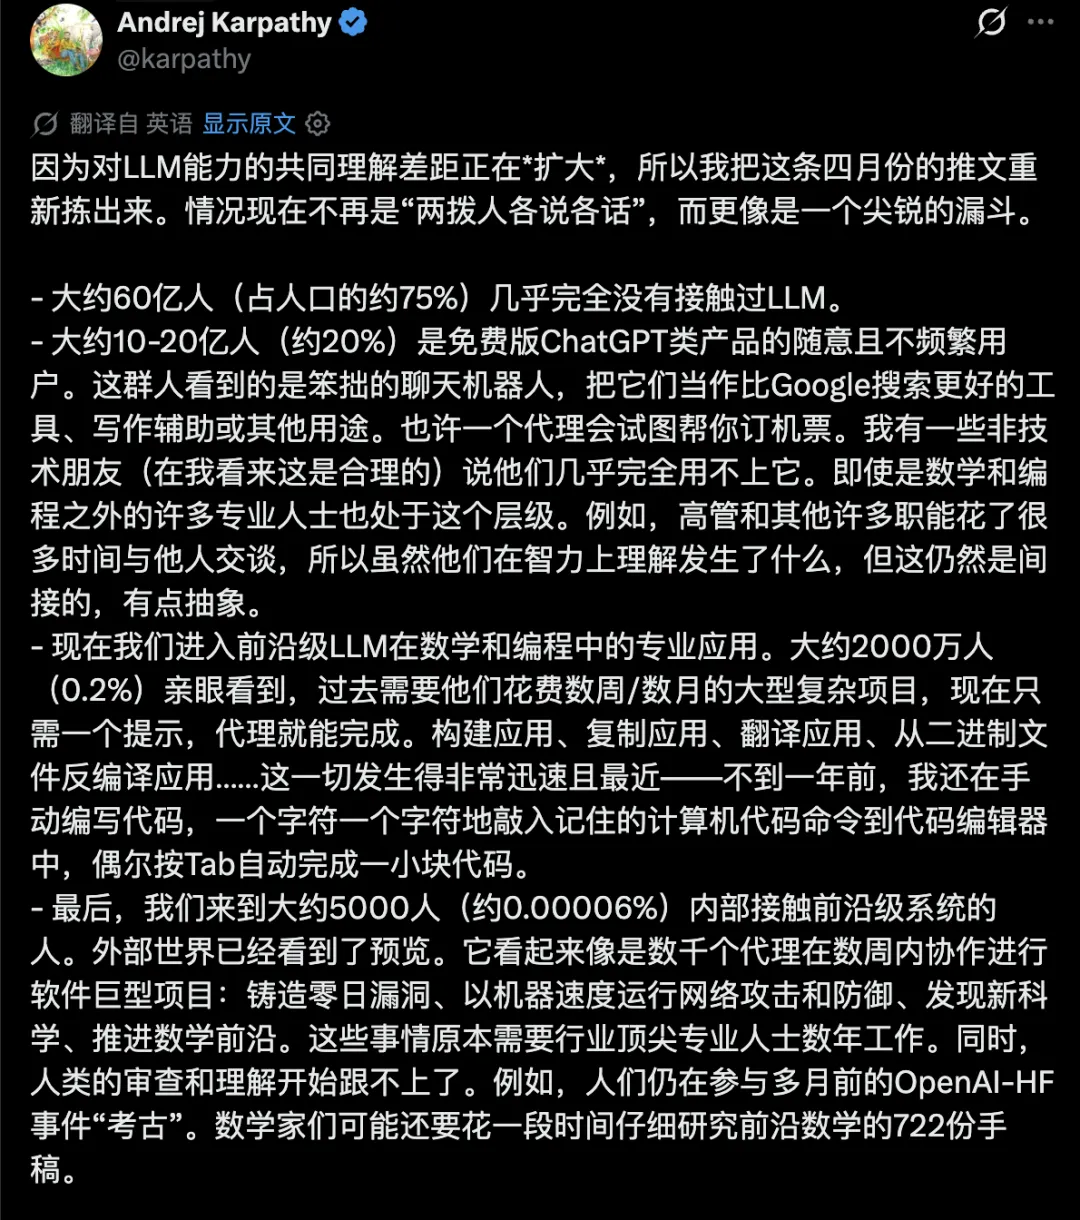
全世界的人口正在被切分成四個完全不同的世界。
第一層,大約60億人,佔全球人口的75%。
他們至今幾乎完全沒有接觸過大語言模型。
第二層,大約10到20億人,佔全球人口的20%。
這批人是免費版ChatGPT這類產品的低頻使用者。
在他們眼裡,AI是個笨拙的聊天機器人,頂多當個好一點的Google搜尋,或者拿來改改文字,偶爾讓智能體訂個機票。
網上傳播的很多視訊裡,官方語音模式連該開車還是走路去洗車這種蠢問題都答不好,經常產生幻覺。
很多非技術領域的職場人、公司高管都停留在這一層。
他們平時的工作主要是與人溝通,對AI的認知全靠道聽途說,概念極其抽象。
他們得出的結論很自然:這東西對我沒多大用。
第三層,大約2000萬人,佔全球人口的0.2%。
這批人正在數學和程式設計等專業領域,高頻使用最頂級的商用模型,比如OpenAI Codex和Claude Code。
他們親眼看著以前需要人類耗費數周甚至數月的大型複雜項目,現在被智能體用一句指令搞定。
做應用、複製應用、翻譯程式碼、從二進制檔案裡反編譯應用,AI全都做到了。
卡帕西說,就在不到一年前,他還在程式碼編輯器裡一個字元一個字元手動敲程式碼,偶爾按一下Tab鍵補全幾行。
現在這一切徹底成了歷史。
這批每個月願意花200美元以上的技術人員,正在經歷強烈的AI眩暈症。
他們把終端交給模型,看著模型瞬間融化掉那些原本要寫幾周的程式碼難題。
第四層,金字塔最頂端的大約5000人,全球佔比只有0.00006%。
他們能直接接觸實驗室內部最前沿的未公開系統。
外界目前看到的只是冰山一角。
這5000人看到的是:
成千上萬個智能體組成的叢集,連續協同工作幾個星期,攻克超大規模的軟體工程。
智能體自己在系統裡挖出0day漏洞。
以機器的速度,自動發起並防禦網路攻擊。
發現全新的科學規律。
推進入類數學的最前沿。
這些工作原本需要行業頂級專家耗費數年時間。
人類的審查和理解速度已經開始全面落後於AI。
大家到現在還在考古分析幾個月前的OpenAI與HF事件。
數學家們光是閱讀和消化模型寫出來的722篇前沿數學論文,就要耗費極長時間。
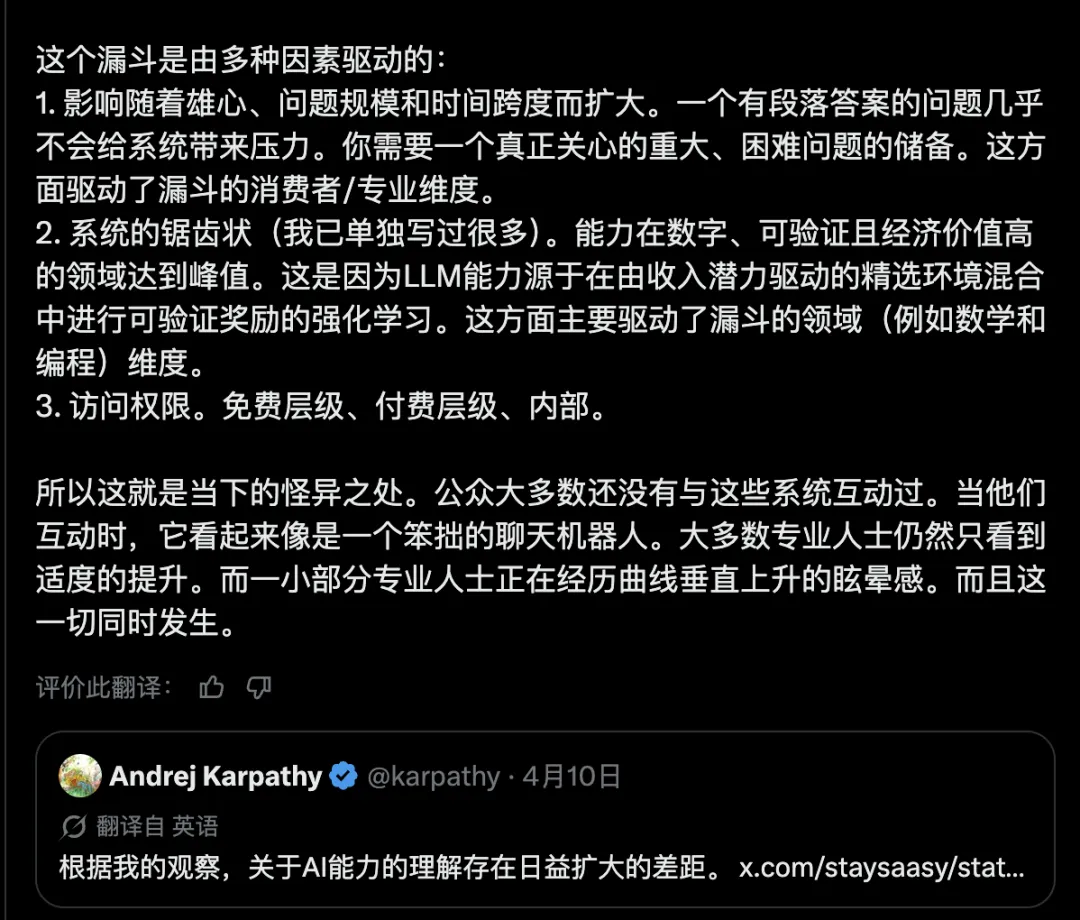
為什麼普通人覺得AI很傻,頂尖圈子卻覺得AI在垂直狂飆?
卡帕西指出了背後的三個核心原因。
第一,使用者的目標規模完全不同。
如果你只給模型丟一個段落就能回答的生活小問題,根本測不出模型的真正實力。
你必須擁有海量、極其困難、你真正關心的超級難題,才能榨出它的極限能力。
第二,模型的能力分佈極度不均勻。
AI在數位化、結果可驗證、商業價值極高的領域表現最強,比如數學和程式設計。
因為大模型的能力來自於強化學習。
程式碼寫得對不對,測試用例通沒通過,數學證明成不成立,都有絕對客觀的標準,可以通過結果給予明確的演算法獎勵。
但聊天、寫作、日常建議根本沒有客觀的對錯標準,很難做強化學習訓練。
同時,企業級軟體和網路安全能賺到巨額利潤,開發團隊會把絕大部分資源集中在這些能賺大錢的方向上。
日常閒聊不賺錢,自然得不到重點攻堅。
第三,存取權完全不平等。
免費層級、付費層級、實驗室內部層級,彼此看到的是完全不同的產物。
大眾看到的是經常翻車的聊天框。
大部分普通專業人員只感受到了微弱的工作提效。
極少數人正在看著陡峭的技術曲線筆直向上狂飆。
這幾種完全撕裂的現實,正在此時此刻同時發生。
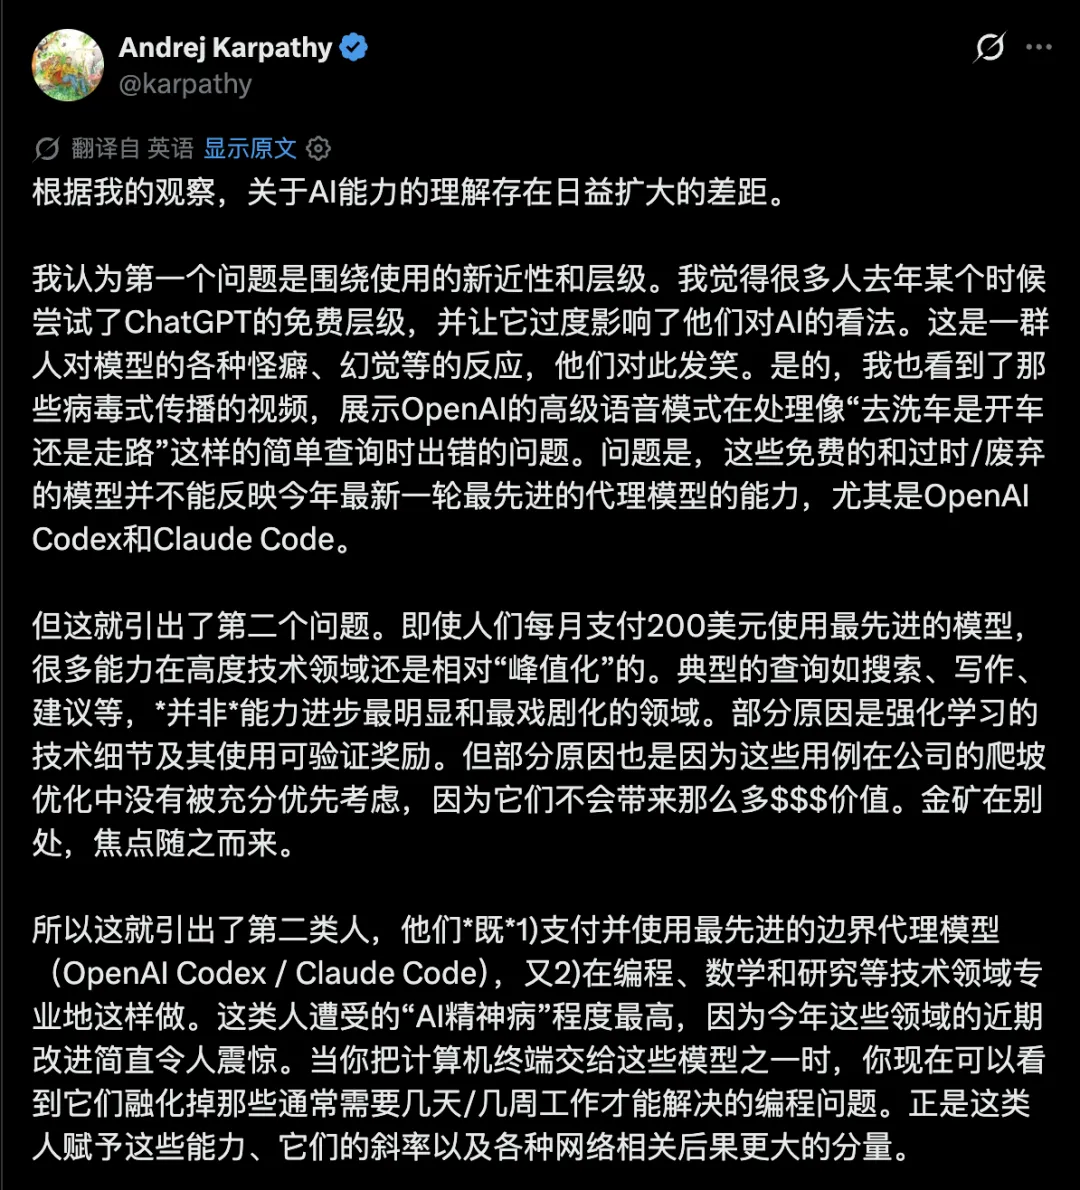
4月那條推文說了什麼
卡帕西在4月10日的原推文裡,講了兩個問題。
第一個問題,出在使用時間和使用檔位。
很多人去年試過一次免費版ChatGPT,就拿這次體驗定下了對AI的看法。
這群人嘲笑模型的各種怪癖和幻覺。
卡帕西也看過OpenAI高級語音模式的病毒視訊,它在回答該開車還是走路去洗車店這類簡單問題時翻了車。
但這些免費的、舊的、已被棄用的模型,代表不了今年最新一輪最先進的智能體模型,尤其是OpenAI Codex和Claude Code。
第二個問題,即便每月付200美元用上最先進的模型,能力也集中在高度技術性的領域。
搜尋、寫作、建議這類常見用法,進步沒有那麼明顯。
部分原因在強化學習和可驗證獎勵的技術細節。
另一部分原因是,這些場景帶來的收入不多,公司沒有優先去提升它們。
賺錢的方向在別處,精力也就跟著投到別處。
於是出現了另一群人。
他們既付費使用最先進的智能體模型,也就是OpenAI Codex和Claude Code,又在程式設計、數學、研究這些技術領域專業使用。
這群人的AI精神病程度最高,因為今年這些領域的進步堪稱驚人。
給這些模型一個終端,你能看著它們解決原本預計要花幾天甚至幾周的程式設計問題。
這群人更看重這些能力本身、能力提升的斜率,以及各種網路安全層面的後果。
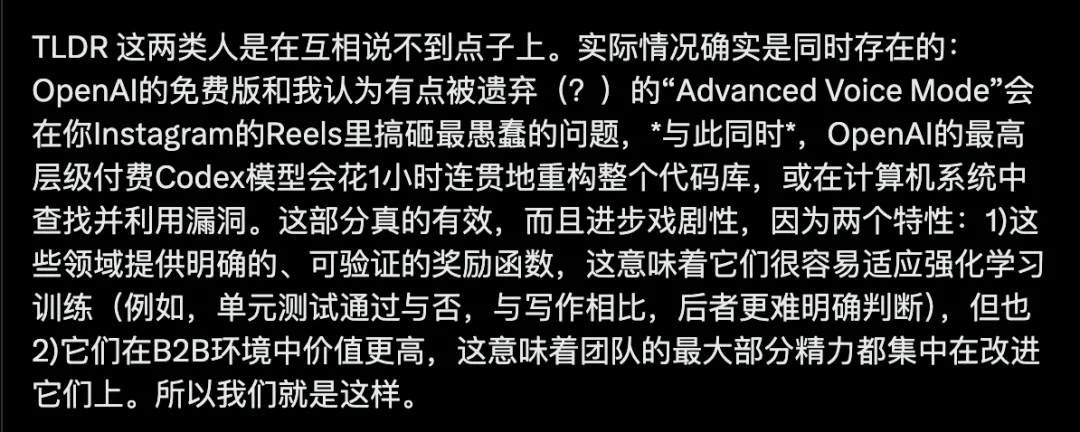
卡帕西的總結是,這兩群人在各說各話。
兩件事同時成立。
OpenAI免費的、似乎已經被冷落的高級語音模式,會答錯Instagram短影片裡最蠢的問題。
而OpenAI最高檔的付費Codex模型,可以連續工作1小時,條理清晰地重構整個程式碼庫,或者找到並利用電腦系統中的漏洞。
後一種能力真實有效,進步巨大,原因有兩個。
一是這些領域有明確、可驗證的獎勵函數,容易做強化學習訓練。
比如單元測試通過與否,而寫作就難以明確評判。
二是它們在企業服務場景中價值更高,團隊裡最大比例的人力都投在這裡。
事情就是這樣。
(AI寒武紀)