
華為麒麟 9050 Pro 自正式亮相後備受關注,一份新的拆解談到了這款晶片的“3D 堆疊設計”,主要揭示了華為的 LogicFolding(邏輯摺疊)技術如何運作,並帶來怎樣的效果。
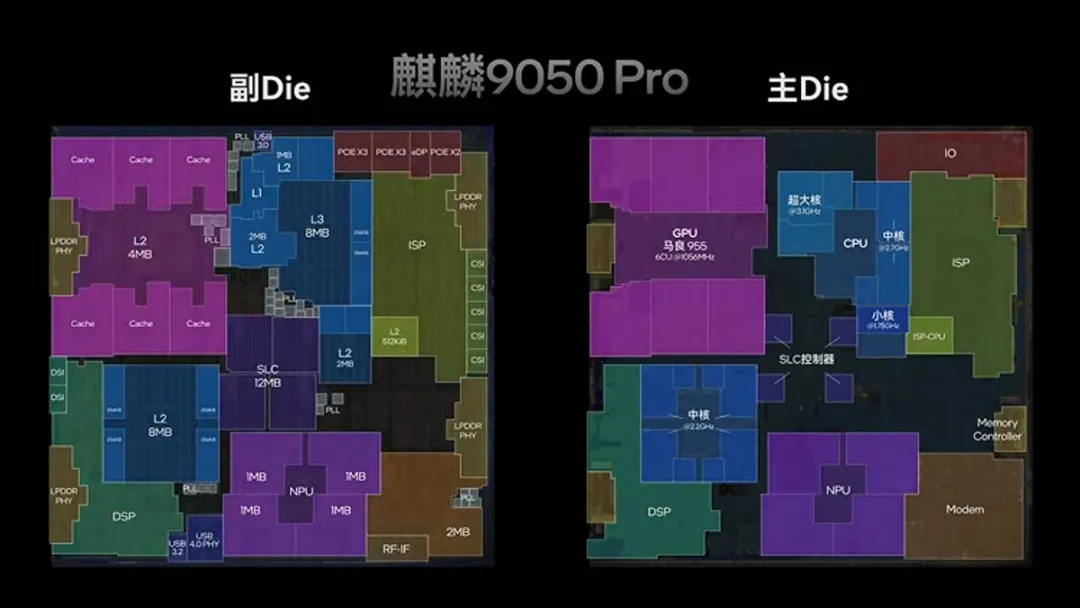
Geekerwan(極客灣)在 YouTube 發佈了華為麒麟 9050 Pro 晶片的拆解視訊。該晶片搭載於 Mate 90 Pro Max,官方稱其相比上一代晶片組整體性能提升 42%。
這次拆解的重點,是對麒麟 9050 Pro 3D 堆疊設計的詳細闡述。其他移動處理器的結構通常是基板、金屬層,再加頂部一層邏輯電路,而麒麟 9050 Pro 用的是兩顆裸片,上下垂直堆疊放置。
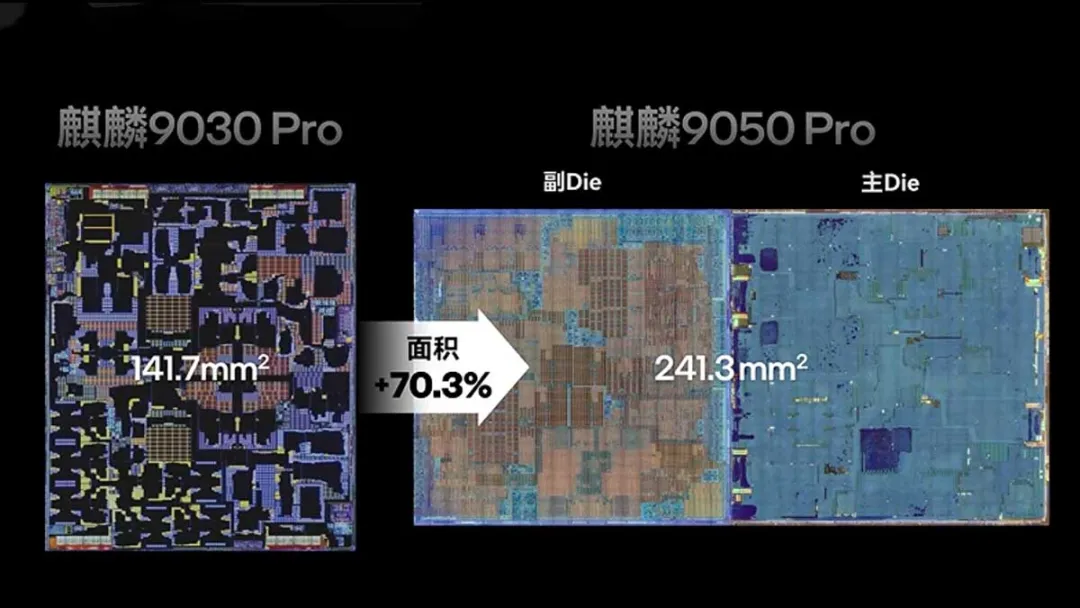
銅對銅混合鍵合連接兩層金屬
兩顆裸片之間通過銅對銅混合鍵合連接彼此的金屬層。第一顆裸片是計算裸片,採用 N+3 節點,性能優於 6nm;第二顆裸片承載快取、I/O 介面和 PLL,也就是鎖相環這類反饋控制系統,採用 N+2 工藝製造。
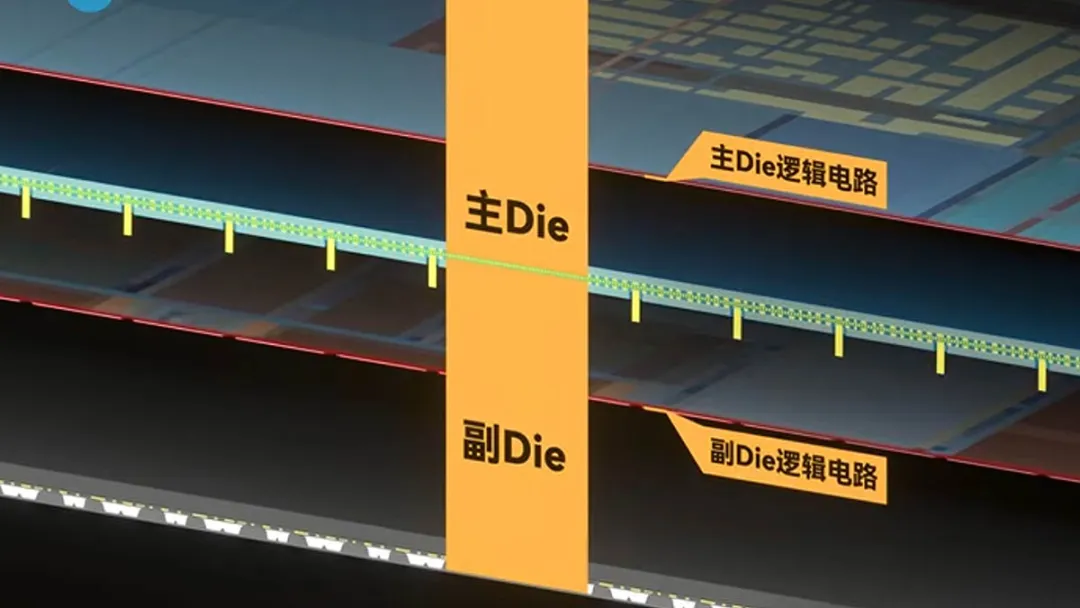
兩顆裸片都通過 80000 個矽通孔(TSV)接收電力與訊號,由此把晶片連接到基板。訊號和電力從下方那顆裸片傳遞到上方那顆。
思路接近 AMD 3D V-Cache,但堆疊順序相反
麒麟 9050 Pro 晶片設計的整體概念,與把快取放在單獨裸片上的 AMD 3D V-Cache 非常相似。區別在於,這裡的混合鍵合互連密度遠高於 AMD 的方案,從而縮短了執行單元與快取之間的路徑,在更大程度上降低了延遲。
進一步細節顯示,大多數執行單元位於頂部裸片,而 L1 和 L2 快取位於底部裸片,原因是快取運行溫度更低,對製程也不那麼敏感。
NPU 是另一處重大升級
拆解中出現的另一個重大升級是 NPU。它在兩顆裸片上的合計面積,比麒麟 9030 Pro 的 NPU 大 150%。
極客灣實測 INT8 吞吐量約 68 TOPS,用 3B 參數模型測試時 prefill 提升約三倍。搭載該晶片的手機支援端側 30B-A2B 混合專家模型(300 億參數,同時啟動 20 億),用於離線照片整理與編輯建議,並驅動華為的 AI 助手,配合一個 6B 多模態模型完成編輯。作為對照,蘋果採用的端側模型為 20B-A4B。所有搭載麒麟 9050 Pro 的機型均配備 16GB 記憶體,以便把更大的模型留在快速記憶體中。Notebookcheck 也指出,這顆 NPU 相比最新競品仍有差距,因此華為實際啟動的參數比例低於蘋果方案。
製程歸屬
國際硬體測評媒體Notebookcheck(NBC) 在報導同一拆解時寫明:計算裸片出自中芯國際 N+3,大致比其他代工廠的 6nm 級節點好一檔;承載快取、I/O 介面和 PLL 的那顆出自中芯國際 N+2,大致相當於台積電 N6。該報導同時強調,華為與中芯國際都沒有正面確認過這兩個節點。因此原文的“優於 6nm”屬於媒體與拆解方的判斷,不宜當作定論引用。
8 萬根 TSV 的代價
極客灣統計,海思在晶片與基板之間打了約 8 萬根矽通孔,這些通孔從襯底穿上來,先穿過下層裸片,再抵達上層裸片。它們留下的禁布區(keep-out zone)吃掉了底部裸片約 8% 的可用面積。相當於拿底部裸片近十分之一的面積,去換兩顆裸片之間的頻寬與更短的走線。
官方規格與實測資料
華為在 10 月 1 日的發佈會上給出了麒麟 9050 Pro 的一組官方資料:每平方毫米電晶體數達 2.38 億,密度較麒麟 9030 Pro 提升 28%;訊號傳輸鍵合數量 500 萬個,跨裸片傳輸頻寬 125TB/s;時鐘緩衝器數量下降 55%,關鍵路徑時延下降 30%。CPU 為自研靈犀架構,9 核 16 線程,多核性能提升 23%;馬良 GPU 圖形渲染性能提升 40%;達文西架構 NPU 性能提升 140%,可在端側運行 30B 參數的 MoE 大模型;第十代 ISP 使長焦清晰度提升 34%;整合巴龍基帶,支援超 5.5G 通訊。
整機層面,華為稱通過軟硬芯雲垂直整合,Mate 90 Pro Max 較 Mate 80 Pro Max 整機性能提升 31%。
遊戲能效表現
極客灣的遊戲測試顯示,Mate 90 Pro Max 在《原神》中的表現優於部分搭載驍龍 8 Elite Gen 5 的機型,僅略微落後於驍龍 8 Elite Extreme Gen 6 與蘋果 A19 Pro 機型。在 890p 解析度下運行《原神》可維持滿幀,整機功耗約 4.2W。在《鳴潮》中,該晶片排在搭載天璣 9500 的機型之前;在《歸龍潮》中幾乎追平天璣 9500 與驍龍 8 Elite 機型,不過Android裝置的運行解析度略高。
需要說明的前提是,這些結果高度依賴為 HarmonyOS 原生移植的遊戲。通過轉譯層運行的作品,例如《明日方舟:終末地》,效率較低、影格率也更低。純合成的 CPU 跑分仍落後於最頂尖的驍龍與蘋果晶片。 (銳芯聞)