
給寫程式碼的過程“開倍速”。
智東西10月12日報導,近日,智譜在其AI程式設計工具ZCode中,悄然開啟了高速旗艦模型GLM-5.3 HighSpeed的測試。
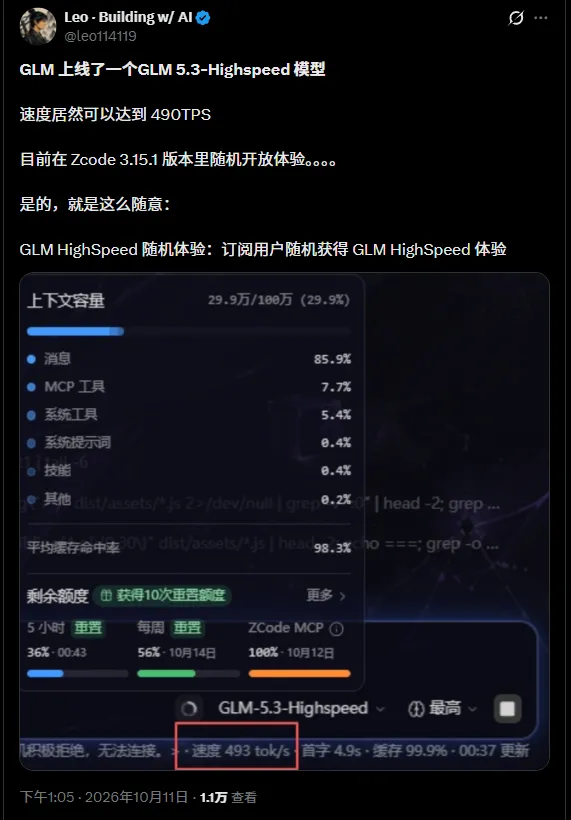
X平台上的AI程式設計博主Leo爆料,他已經灰度到了這款模型,其輸出速度竟然可以超過490 tokens/s。
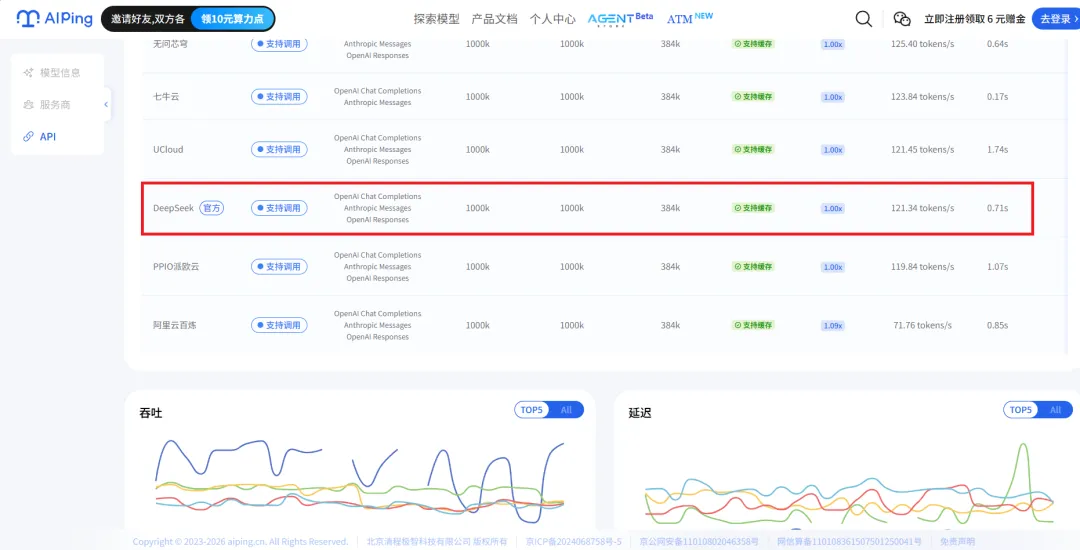
每秒490個token是什麼概念?目前,大模型API評測平台AI Ping的資料顯示,DeepSeek V4.1 Flash官方API的輸出速度為121.34 tokens/s,而智譜官方的GLM-5.3 API速度為70.84 tokens/s。也就是說,GLM-5.3 HighSpeed達到了數倍於當前國內主流模型的速度。
GLM-5.3 HighSpeed目前只對ZCode訂閱使用者隨機開放,也沒有明確的內測申請入口。它在內測展現出的飛快速度應該也只能作為參考,最終還是得看實際上線後,對外規模化提供服務時的速度。
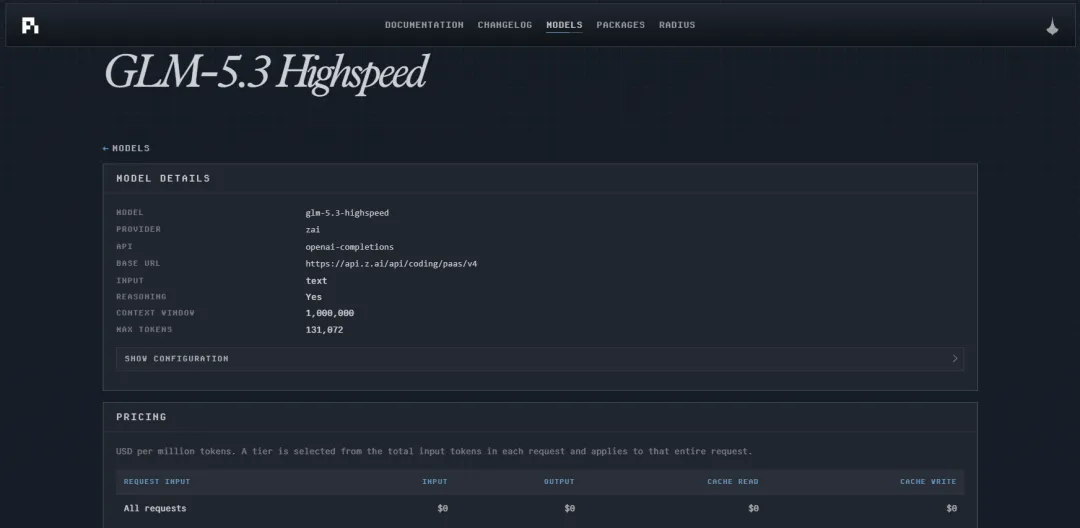
其實,GLM-5.3 HighSpeed在一個月之前就出現在開源程式設計智能體Pi harness的官網上,這個模型的輸入輸出價格尚未披露。
從模型基本資訊來看,GLM-5.3 HighSpeed擁有100萬個token的上下文窗口,最多可以一次性輸出131072個token,這和GLM-5.3的資訊一致。
這不是智譜首次推出高速旗艦模型。今年5月,GLM-5.1就曾推出一個面向部分企業使用者的高速版API“GLM-5.1-highspeed”,模型輸出速度達到400 tokens/s。
當時,智譜展示了高速模型在實際生產場景的價值。一個Coding Agent任務往往需要經曆數十輪模型呼叫,單輪響應只要慢上幾秒,整體耗時就可能拉長十幾分鐘。
更快速的模型能給寫程式碼的過程“開10倍速”,模型能夠一邊理解工程上下文,一邊持續生成程式碼與修改方案,使用者剛輸入需求,函數、介面與呼叫鏈已經同步展開,迭代速度明顯提升。
這種輸出速度主要來自於軟硬體基礎設施的最佳化。此前,GLM 5.1 Highspeed模型API是由智譜GLM團隊與TileRT團隊聯合打造的,這一API在推理引擎、調度系統與底層基礎設施三個層面進行了系統級最佳化:
在推理引擎層,研究團隊針對GLM-5.1的架構特點,重寫了核心推理路徑,有效提升了單卡吞吐能力;
在調度系統層,他們通過動態批處理、請求合併和KV快取調度最佳化,顯著降低高並行場景下的尾延遲;
最後,在基礎設施層,團隊圍繞推理叢集部署、網路鏈路、負載平衡進行協同最佳化,確保高速的輸出成為穩定可用的生產級能力。
TileRT的核心思路是放棄傳統Runtime層的動態算子調度,把整個推理計算圖在編譯期靜態編排成一個常駐GPU的persistent Engine Kernel,從而把調度、訪存和同步開銷壓到最低。
如今,提升模型推理速度已經成為不少廠商關注的重點,除了推出專門的快速模型之外,把旗艦模型的速度再拔高一個量級也正成為新的競爭方向。 (智東西)