
是不是3090二手要漲價?
在本地運行大語言模型時,顯示卡的算力往往不是第一瓶頸,視訊記憶體頻寬才是。NVIDIA RTX 3090雖然擁有24GB視訊記憶體和936.2GB/s的頻寬,但在運行270億參數等級的模型時,傳統的逐Token生成方式依然會受限於反覆讀取模型權重的過程,導致顯示卡的計算單元大量閒置。

近日,Reddit使用者u/iamMess通過一套專門建構的推理引擎,在不更換任何硬體的前提下,將Qwen3.8-27B模型在單張RTX 3090上的Token生成速度從82 tok/s提升到了382 tok/s,增幅達到4.6倍。
這是一個極快的速度,目前主流雲端大模型(如ChatGPT)的生成速度通常在30到60 tok/s左右。382 tok/s意味著它一秒鐘就能“寫”出大概250到300個漢字,一分鐘能生成近兩萬字。
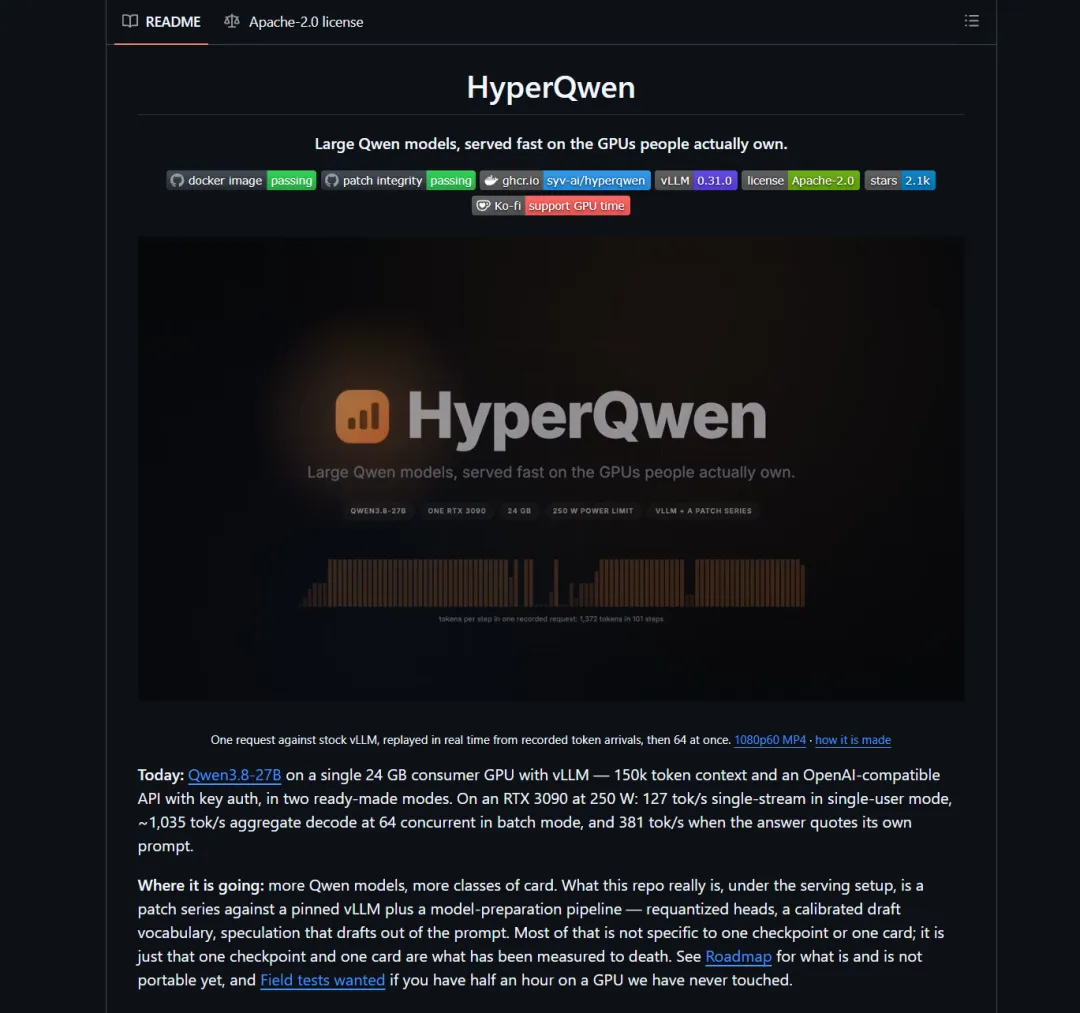
這套方案的核心是投機解碼技術:一個輕量級的“草稿”模型會先行猜測後續的多個Token,主模型再一次性對這些候選進行批次驗證,保留正確的部分。由於主模型始終擁有最終決定權,輸出結果與原始模型完全一致,開發者在數學基準上的精準率也維持在96.5%。
最佳化的推進是分階段完成的,首先,利用Qwen3.8-27B內建的多Token預測功能,將單使用者速度提升至約114 tok/s。隨後加入DFlash2草稿方法,每次提議7個Token,同時引入一個“尋找式”草稿器,從已有對話文字中尋找匹配內容來預測後續詞彙,速度進一步升至138 tok/s。
真正的突破來自驗證環節的調整,開發者發現,驗證步驟不必受限於DFlash2的7個Token猜測,尋找式草稿器可以“免費”填充額外的槽位。引擎由此改為每步驗證16個Token,在引用文件的25000 Token任務中,16個猜測里約有15個被接受,速度從260 tok/s推升至382 tok/s。
那麼代價是什麼呢?加長的驗證步驟會佔用一半的請求槽位和8000 Token的上下文,因此屬於可選功能。緊湊的記憶體格式則會使文件的初始讀取時間翻倍,更適合“一次載入、多次提問”的使用場景。在普通聊天中,最佳化後的速度約為133 tok/s,仍比原始的82 tok/s有明顯提升。

這套方案的意義在於,它展示了軟體層面的推理最佳化能夠釋放老款硬體的潛在余量。對於仍然持有RTX 3090的使用者來說,在24GB視訊記憶體的邊界內,通過針對性的引擎調優,本地大模型的可用性可以得到實質性改善。(AMP實驗室)