
不久前,我們和大家介紹過“AI斬殺線”的概念,簡單說就是中國AI模型每次發佈,就會讓一堆海外模型在性價比上失去競爭力。
DeepSeek V4.1發佈後,事情變得更有意思了。
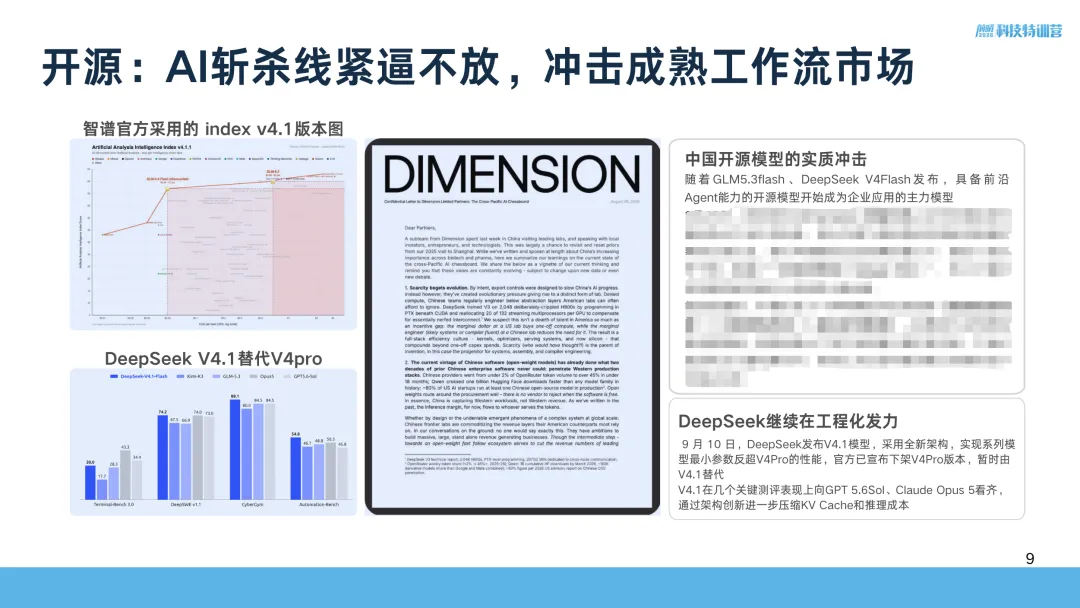
DeepSeek官方宣佈,V4.1 Flash在性能、速度、成本和完成任務總時間上,已經整體優於上一代V4 Pro。
於是,在新的Pro版本推出前,原本呼叫V4 Pro的API請求,直接切換到更便宜的V4.1 Flash。
AI斬殺線瘋起來,連自己的Pro也砍。
為什麼V4.1這麼一個小版本更新,能取得這麼大的改進?隨著中國AI斬殺線越跟越近,對AI產業會有什麼影響?
今天我們就一起解讀下V4.1背後的技術變化,一起看看中國AI斬殺線的未來影響。
Flash為什麼突然能把Pro替掉?
很多討論都認為DeepSeek訓練出了一個“更聰明的小模型”。
實際上,V4.1 Flash本身一點都不小。
按照官方技術資料,它的主幹模型擁有5520億參數,另外還有近2000億Engram參數,只是真正執行階段只需要啟動其中很小一部分。
這背後代表的是大模型競爭正在發生一個很重要的變化:
模型“知道多少”,和每次回答問題“需要算多少”,開始被拆開。
MoE框架本來就在做這件事。一個模型裡可以有很多不同“專家”,但處理一道題時,只叫真正相關的幾個專家上班,而不是讓整個公司所有人都來開會。
V4.1又把這種思路做得更徹底。
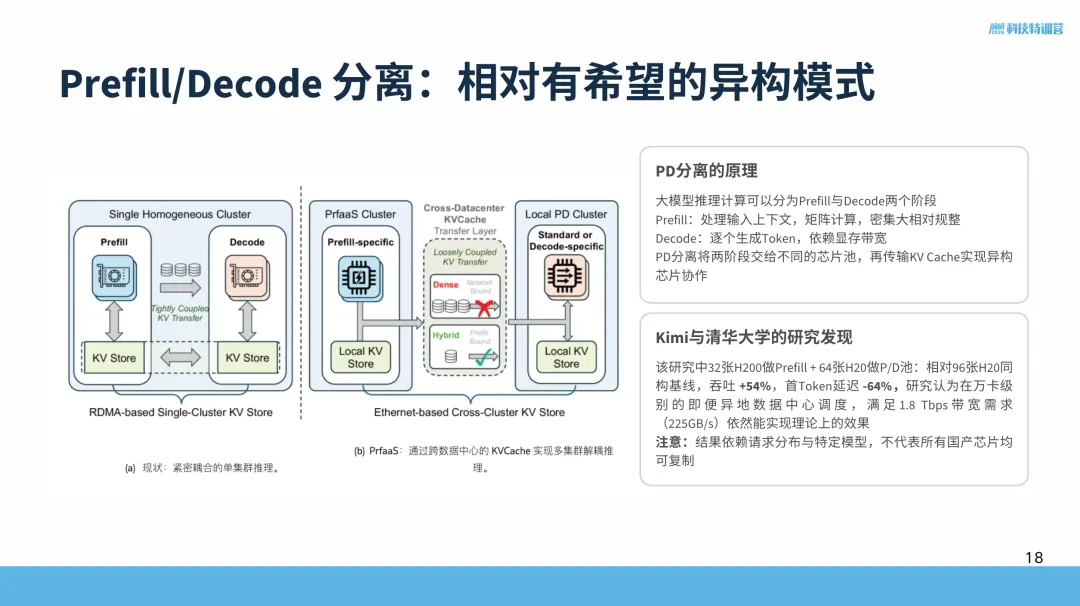
大模型運行其實分成兩個階段,一個是Prefill,另一個是Decode。
簡單說,前者就是先把Prompt、歷史記錄、程式碼、工具返回結果全部“讀進去”,讓AI理解現在要幹嘛;後者也就是Decode階段,AI才真正開始“思考和輸出”。
Agent時代最大的問題是“讀”的東西越來越多。一個Coding Agent可能先吞掉幾十萬Token程式碼和幾十次工具呼叫結果,最後真正需要輸出的程式碼卻只有幾千Token。
所以V4.1開始讓不同階段使用不同規模的計算:讀大量上下文時更省,真正生成和推理時再增加計算。
普通使用者不用理解其中所有工程細節,只需要記住一個變化:
過去提高AI能力主要靠“多算”,現在開始越來越依靠“把計算花在真正有用的地方”。
更有意思的:DeepSeek開始把“記憶”和“思考”分開
V4.1另一個值得關注的技術叫Engram。
傳統大模型有一個很浪費的地方:很多固定短語、語言規律和事實關聯,每次都要通過神經網路重新算一遍。
DeepSeek提出了一個很直接的問題:既然有些東西本質上只是“記住”,為什麼每次還要重新“想”?
於是Engram把一部分適合直接查詢的資訊放進一個巨大的記憶結構裡。需要時直接取出來,把昂貴的神經網路計算留給真正需要推理的地方。
這也是為什麼一個模型完全可以擁有巨大的知識容量,但真正處理每個Token時,只呼叫很少的計算資源。
換句話說:模型有多大、模型有多聰明、模型跑起來有多貴,正在變成三件不同的事情。
這可能才是V4.1最值得行業關注的技術變化。
Agent時代,真正競爭的是“完成一個任務多少錢”
另外兩項變化也值得放在一起看。
第一是長上下文成本持續下降。
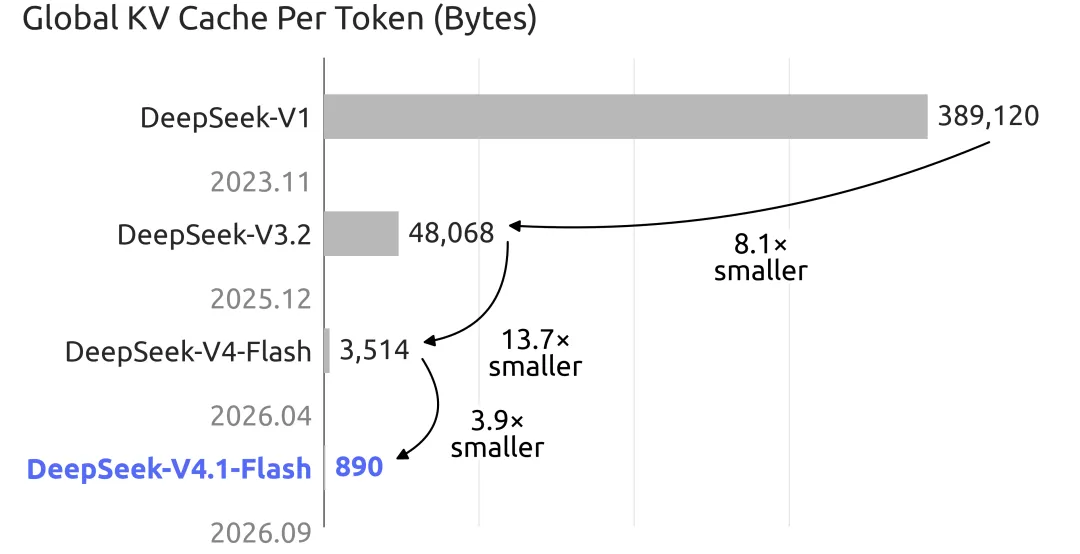
DeepSeek從V4開始就在大幅壓縮KV Cache。KV Cache和記憶體之間的關係我們7月和大家解讀過。
簡單理解,就是Agent連續工作時,為了“記住前面發生過什麼”需要佔用的視訊記憶體會越多,因為Agent越工作越久,需要記的東西越多,KV Cache越大。
在這個HBM價格暴漲的時期,降低1%的視訊記憶體消耗都會釋放巨大的硬體成本壓力。
第二是後訓練。
今年7月,DeepSeek曾在完全不改變Flash模型結構和尺寸的情況下,只重新做後訓練,就讓Terminal Bench等Agent測試成績大幅提升。
這說明今天AI真正的生產力,已經越來越不能只看底層模型。
模型怎麼訓練它使用工具、怎麼規劃任務、失敗後怎麼重試、Harness怎麼搭、允許它思考多久,都會直接改變最終效果。
所以DeepSeek這次特別強調了一個很值得注意的指標:Total Time-to-Completion,完成整個任務到底需要多長時間。
這比“每百萬Token多少錢”更接近企業真正關心的問題。
一個模型即使Token便宜一半,如果經常做錯、需要不斷重試,最後可能反而更貴。
反過來,一個Flash模型只要已經能穩定完成絕大多數任務,它就沒有必要繼續為所有請求支付Pro價格。
這就是V4.1真正幹掉Pro的地方。
AI斬殺線再度加速
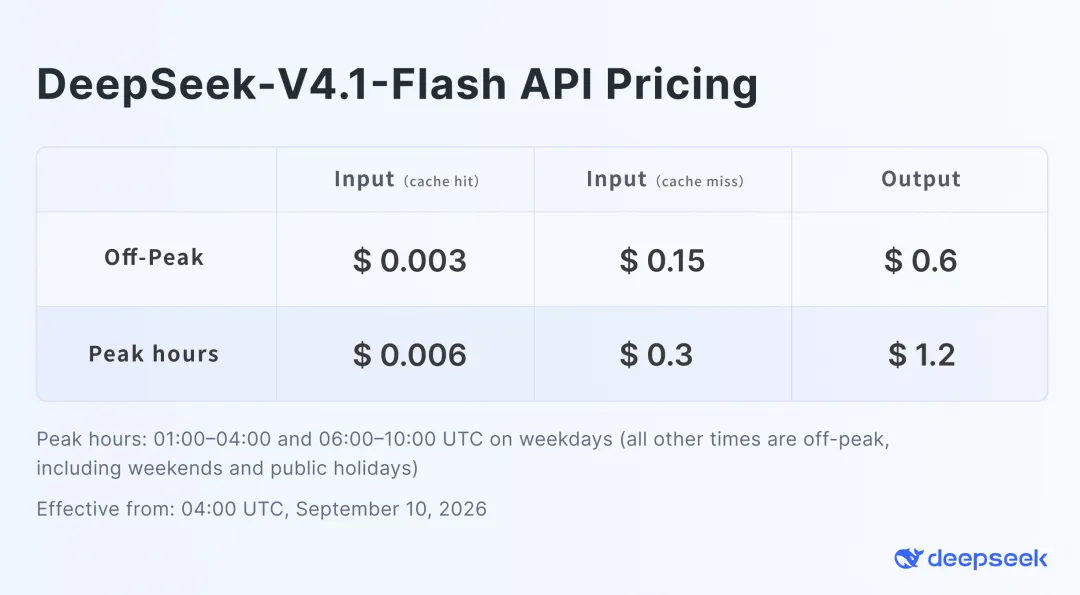
聽到“AI斬殺線”,很多人把它理解成中國AI崛起、不斷用低價模型衝擊海外巨頭。
但再後退一步看,它背後其實是:算力和資源約束,逼出來的極致工程效率,引領模型成本下降,也驅動更便宜的模型被更多人使用,又反過來推動下一輪最佳化。
回顧2024年,王煜全在前哨第一次和大家掃描DeepSeek,一路從稀疏計算、模型蒸餾,到KV Cache壓縮、後訓練…
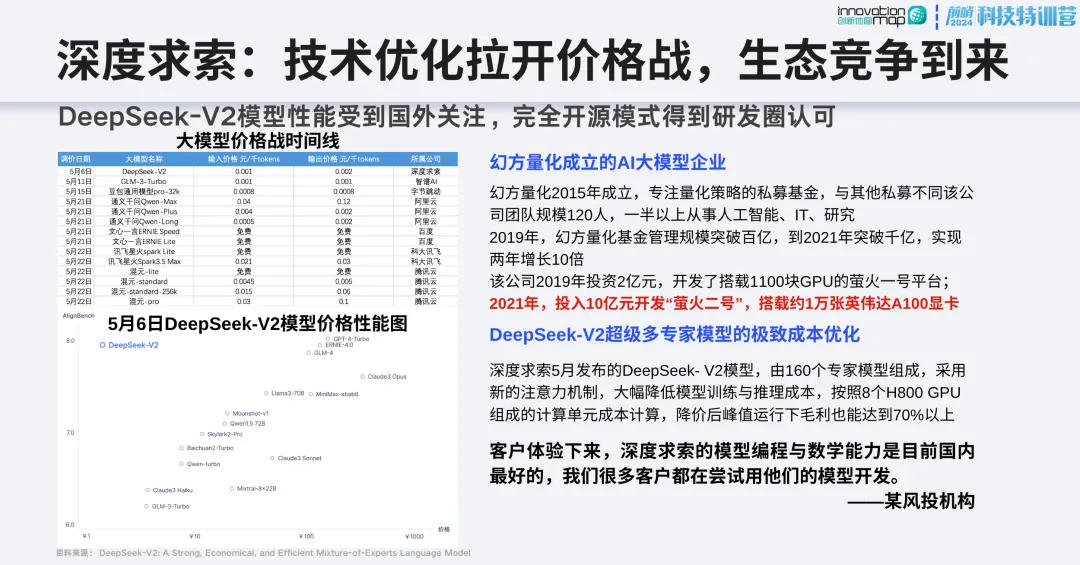
這個曾經被GPU算力決定一切的領域,已經發生了新的變化:前沿AI的能力保質期越來越短,模型企業的關鍵優勢不再是簡單的算力和資料,而是整套模型底層的工程能力。
在這樣的變革中,OpenAI、Anthropic這些領跑者會不會被顛覆?DeepSeek、智譜、Kimi、MiniMax這些中國公司到底能不能賺到錢?
這些問題的答案,王煜全在本周專題直播《AI大模型產業最新趨勢掃描》給出了新判斷。
這次直播沒有把重點放在模型排行榜上,王煜全和大家對比了OpenAI、Anthropic、智譜、MiniMax等模型廠商的業績、營收和技術變化情況,掃描1100+Agent初創公司。
站在產業上游,和大家一分享了新聞、熱點背後真正的未來趨勢,一起看清Agent的下一輪變局、創業新機會。
如果你也想抓住未來機會,不妨好好思考一下這個問題:
當AI能力越來越強、越來越便宜以後,什麼東西會迅速貶值,什麼東西反而會變得更值錢?
跳出一兩個AI模型優劣的對比,你看到的可能是一輪AI產業重新洗牌的機會。 (全球風口)