
HBM的迭代,已經從單純的記憶體密度問題演變為系統性難題。
DRAM正承受巨大壓力,其連鎖反應正在波及整個晶片行業。大型系統廠商要求記憶體的資料讀寫速度進一步提升,三大DRAM廠商 —— 美光、三星、SK海力士,正面臨越來越複雜的權衡取捨。目前最有效的方案,就是在HBM模組(記憶體立方體)內堆疊更多晶片層。但每增加一層,都會帶來全新難題,部分問題至今尚未解決。
受HBM封裝高度上限約束,堆疊更多晶片層,就必須減薄堆疊內的記憶體裸片。但DRAM裸片減薄已經逼近物理極限,有時甚至會直接發生破損。在製造與封裝環節,薄裸片的處理難度大幅上升。堆疊層數越高,功率密度越大,熱量在整個模組內部的傳導路徑也會變長。薄裸片還更容易發生翹曲,造成晶圓處理、凸點對位、裸片鍵合的難度提升。
與此同時,AI資料中心的資料量爆發式增長,行業對頻寬的需求持續高漲,進一步放大上述難題。矽通孔(TSV)是3D‑IC模組的主要資料通路,也是實現HBM超寬平行介面的核心。TSV數量越多,頻寬越高,這是提升HBM模組性能的基礎。但TSV會佔用裸片面積,壓縮每一層可用於記憶體資料的空間。HBM模組沿Z軸垂直方向不斷增高,會加大封裝難度,也不利於堆疊底部邏輯裸片產生的熱量向外散出。
業內人士表示,上述各類問題疊加,會顯著影響良率,進而衝擊DRAM供給。HBM堆疊內的DRAM裸片數量越多,出錯的機率就越高。除TSV數量增加、裸片變薄之外,底部填充膠出現空洞、對位偏移、工藝偏差帶來的各類結構缺陷,任意一項問題,都會讓整疊裸片變成昂貴的報廢品。儘管HBM底層記憶體單元技術和普通DRAM基本一致,但每位元資料對應的矽片與晶圓產能消耗,HBM遠高於傳統DRAM。
Objective Analysis總經理Jim Handy在2026 Hot Chips大會主旨演講中,總結了DRAM供應緊張的三點原因:
- AI需求爆發,資本投入空前,市場對高速DRAM的需求激增;
- HBM的晶圓消耗遠高於其他類型DRAM,造成DRAM晶圓供給收緊;
- 製造產能跟不上持續高漲的市場需求。
“現在AI資本開支規模很大,而想要獲得目標頻寬就離不開HBM。大家都希望處理器晶片上擁有無限大的快取記憶體,但現實做不到。那搭建超大SRAM行不行?成本實在太高。於是行業選擇HBM。HBM擁有極寬匯流排,可以實現很高頻寬;雖然存在一定延遲,但延遲水平和標準DRAM接近。” Handy說道。
不過高頻寬是以犧牲晶片面積為代價。三星記憶體業務設計團隊成員Sangwook Han表示:“成千上萬顆TSV完成裸片互聯。每一代產品的最大容量都實現提升,但迭代的核心驅動力依舊是頻寬,HBM每代頻寬幾乎翻倍。想要實現更高頻寬,我們面臨兩大瓶頸:裸片之間的TSV,以及底部裸片上的物理I/O介面(PHY)。TSV的迭代思路相對清晰,但提升TSV運行速度難度大、風險高,因此行業主要依靠增加TSV數量。該方案的弊端在於TSV陣列會佔用矽片面積,迫使我們不斷縮小TSV間距。而對比TSV,PHY I/O的工藝縮放要複雜得多。”
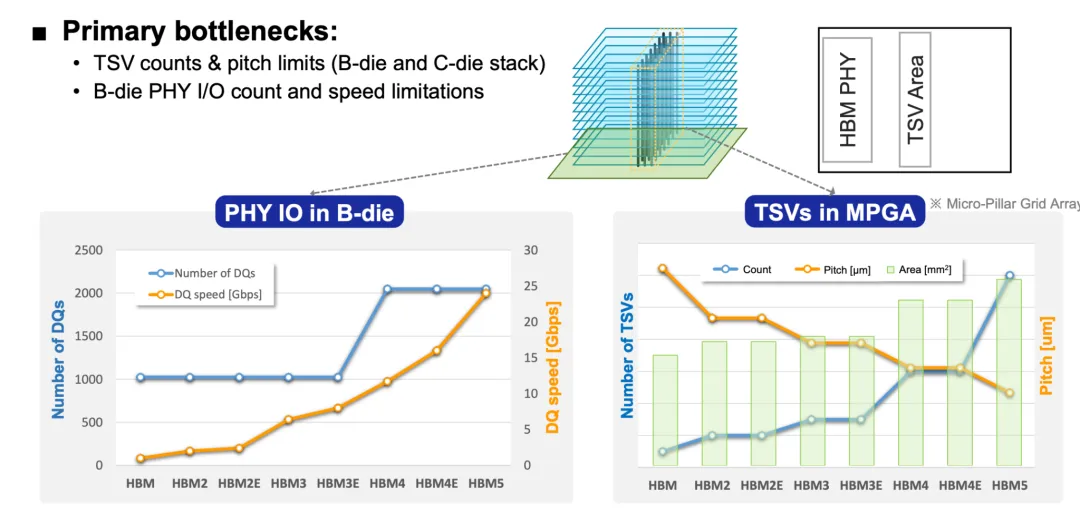
TSV佔用的晶片面積十分可觀。Handy指出:“單塊晶圓產出的記憶體容量,HBM只有標準DDR‑DRAM的三分之一。這意味著HBM會消耗海量晶圓;而HBM與普通DRAM共用同一條產線,最終帶動全品類DRAM出現供應短缺。”
HBM和普通DRAM的不同之處在於,TSV與周邊電路會佔用本可以用作記憶體單元的矽片面積。
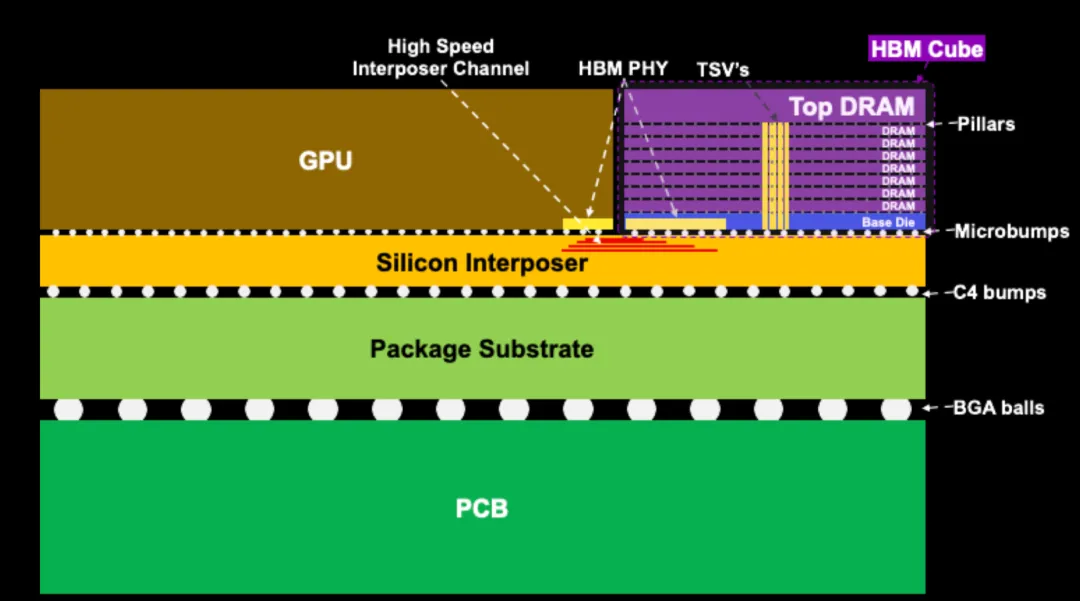
美光HBM設計架構首席工程師Raghu Sreeramaneni表示:“二者的記憶體單元技術本身差異不大,區別是圍繞記憶體單元所設計的技術、封裝與架構,以此實現更高頻寬。HBM的核心是超高平行度,擁有數量更多的可平行工作記憶體體(bank),更多資料通路把資料傳輸到底部裸片。HBM3E每顆DRAM裸片擁有128個記憶體體;HBM4單顆裸片記憶體體提升至256個。全部DRAM裸片連接到底部裸片,由底部裸片實現與GPU/XPU的對接。系統包含兩套PHY:底部裸片通過微凸點與中介層和XPU通訊的PHY;以及連接所有DRAM裸片與底部裸片的TSV‑PHY。”
Handy分析,DRAM廠商此前並未預料到這一局面:過去DRAM市場增速平緩,廠商僅靠提升單塊晶圓的GB產出,就可以匹配市場容量增長。“儘管摩爾定律放緩,但單晶圓容量提升速度足以匹配市場,所以企業十多年沒有新增工廠產能。一夜之間,行業卻不得不新建大量晶圓廠。”
目前沒有快速可行的解決辦法。產能層面,新建一座DRAM工廠至少需要數年時間;受電力、水資源、環保法規、建廠人力等各地條件差異影響,建設周期波動很大。當下新建產能能否滿足需求、讓DRAM價格回歸合理區間,依舊充滿不確定性。多數專家認為,記憶體需求增速已經超過算力需求。
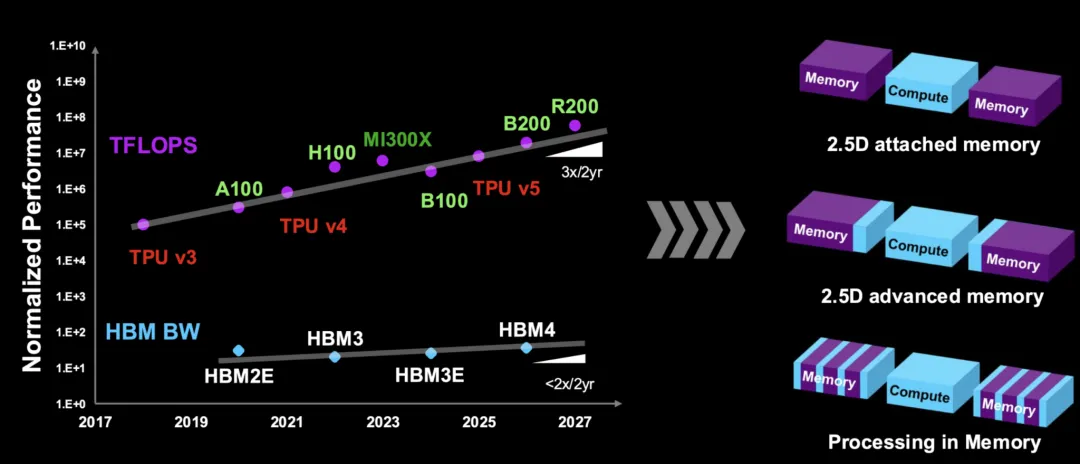
Sreeramaneni稱:“算力性能大約每兩年提升3倍;HBM雖然解決了大量頻寬問題,但性能提升節奏偏慢,約每兩年提升2倍。記憶體牆問題依舊存在,甚至還在持續惡化。”
01. 多重複雜制約因素
單純往堆疊裡增加更多DRAM裸片只會進一步放大各類難題。SK海力士在研發16層堆疊HBM時,暴露出多項關鍵製造挑戰。
SK海力士美國封裝工程副總裁Jaesik Lee在Hot Chips 2026主旨演講中提到:“行業在討論將HBM記憶體立方體總厚度從720微米提升至775微米。厚度增加可以帶來工藝余量,但對比12層堆疊方案,裸片仍需要再減薄10%。我們也可以把裸片間隙縮小50%,同時減小凸點間距,凸點最佳化和厚度調整相互獨立。但這也帶來全新挑戰:裸片側壁間距受裸片變薄影響;功率密度與頻寬同步上升,帶來散熱難題。堆疊層數越多,氧化層數量也隨之增加,封裝端的熱壓力進一步加劇。”
HBM模組內部的熱量傳導同樣越來越棘手。Sreeramaneni表示:“HBM立方體的散熱主要依靠頂部。底部裸片承擔複雜運算,擁有高速互聯線路,是發熱最嚴重的區域。但散熱器佈置在模組最頂端,熱量需要穿過整個堆疊,存在較大熱阻。而DRAM本身不耐高溫。溫度過高會造成DRAM刷新機制異常,影響可靠性。熱方案設計已經變得至關重要,如今我們甚至要圍繞散熱去做整體架構設計,而不是讓散熱去適配現有架構。”
02. 未來發展方向
美光Sreeramaneni說道:“HBM記憶體立方體可以持續迭代,實現更高頻寬,但資料終究要在HBM和處理器之間來回傳輸。從工藝技術、電路創新到中介層技術,各個環節深度耦合。行業需要全新的高速I/O設計思路。我們正在研究面向記憶體最佳化的SerDes PHY,而不是沿用傳統記憶體介面。能否借鑑晶片間D2D SerDes的思路做記憶體最佳化?光互聯未來也會進入該領域。同時中介層技術也在快速演進:支援更大的系統級封裝SiP、整合更多GPU與HBM,新材料迭代,通道頻寬提升來支撐更高速率,高速互聯鏈路領域會有大量創新。”
鍵合技術同樣會迭代升級。“現階段主流HBM方案採用熱壓鍵合或者微凸點技術。未來會逐步轉向熔融鍵合、混合鍵合,可實現微米級以下極小間距,封裝內部的資料吞吐能力更強。同時堆疊裸片之間介質層減少,熱阻也得到改善,對散熱有利。” Sreeramaneni說。
隨著AI持續普及,從AI資料中心到邊緣嵌入式AI裝置,都會受到上述技術變化影響。AI催生海量待處理資料,合成資料規模還會繼續擴大。未來解決方案會偏向分佈式資料處理:在邊緣端實現記憶體內計算、感測器內計算,減少邊緣向AI資料中心傳輸的資料量,支撐生成式AI與智能代理AI運行。
03. 總結
HBM的迭代,已經從單純的記憶體密度問題演變為系統性難題。堆疊裸片數量增加,頻寬需求隨之上漲,帶來裸片厚度、熱管理、封裝複雜度等一系列挑戰,幾乎必然會造成良率下滑。
未來需要新技術、新方案,甚至在資料記憶體、處理、壓縮方式上做出底層調整,尤其是邊緣AI落地、小模型分佈式推理架構普及之後。但仍有大量技術工作有待攻克,DRAM技術也迎來了數十年來前所未有的關注度。 (半導體產業縱橫)