
語言模型聊天能力超越人類好幾年了,可真正的業務自動化到底卡在那裡?
這是前 OpenAI 研究員、ChatGPT 背後核心方法開發者 Diogo Almeida 琢磨了四年的問題。
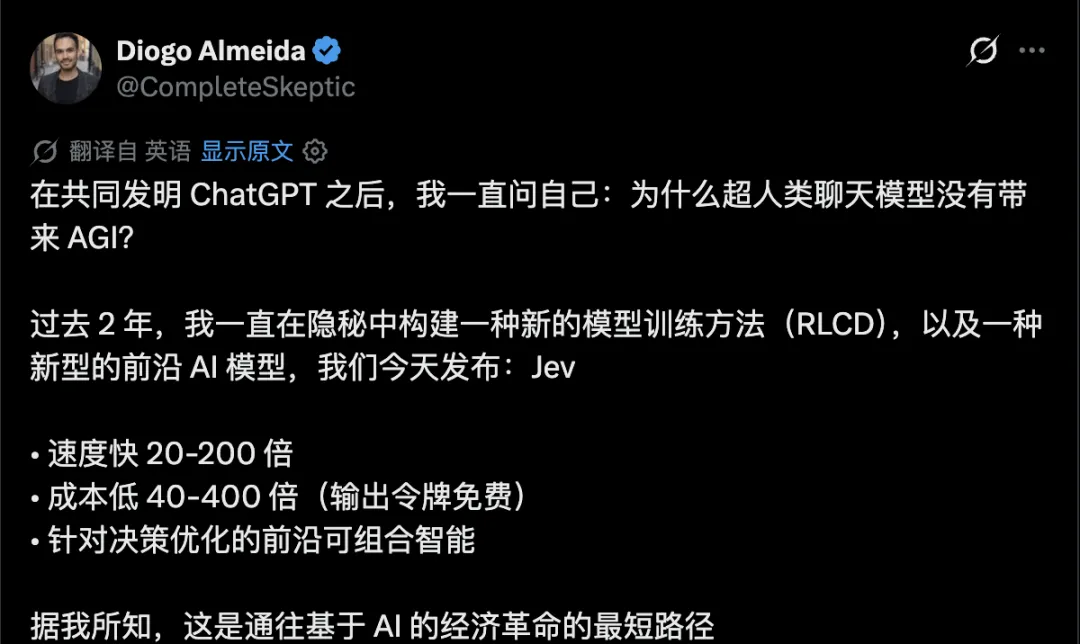
當年他參與打造了讓大語言模型聽懂指令並與人順暢對話的技術。
但在熱潮退去後,他意識到基於聊天的模型少了一塊極其關鍵的拼圖。
隱身研發兩年後,他創立的 TypeSafe AI 正式發佈首個 System One 模型:Jev。
這是一個專為自動化設計的全新前沿模型。
它不做逐字生成,直接輸出軟體能直接消費的結構化決策。
Jev 放棄了長文字生成。
換來的回報非常誇張:
速度提升兩個數量級。
輸出完全免費。
從數學層面根除類型錯誤與幻覺。
一句話概括:給它一段無結構的狀態輸入,它直接返回帶機率置信度的强型別決策。
兩代前沿模型對比
傳統大模型與 Jev 的底層設計完全不同:
最佳化演算法
傳統大模型採用人類反饋強化學習(RLHF)或可驗證獎勵強化學習(RLVR)。
Jev 採用專為校準決策設計的強化學習(RLCD)。
最佳化目標
傳統大模型最佳化人類偏好或可自動驗證的答案。
Jev 最佳化決策校準度,在判斷任務中給出真實可信的機率。
輸入格式
傳統大模型偏重連續對話消息。
Jev 偏重結構化的程序狀態。
輸出格式
傳統大模型輸出自由字串。需要解析驗證,隨時可能格式錯亂或胡說八道。
Jev 輸出强型別結構化數值。可能的結果提前定義好,永遠不會出現類型錯誤,每個答案自帶置信度。
採樣方式
傳統大模型自回歸單字生成,一個 Token 接著一個 Token 往外蹦。
Jev 平行採樣,單次查詢直接返回所有輸出,極度契合硬體加速。
呼叫成本
傳統大模型輸入每百萬 Token 價格在 0.2 美元到 10 美元之間,輸出通常貴 5 倍。
Jev 輸入每百萬 Token 僅需 0.042 美元(折合 10 億 Token 只要 42 美元),輸出完全免費。
響應速度
傳統大模型端到端需要 3 秒到 329 秒。
Jev 端到端僅需 70 毫秒到 500 毫秒,快了 40 倍到 200 倍。
置信度表現
傳統大模型容易過度自信且飄忽不定。
Jev 嚴格校準,置信度越高代表精準率越高,相似輸入結果高度一致。
適用場景
傳統大模型擅長聊天、輔助程式設計、原型演示等有人類把關的任務。
Jev 適合嵌入常規軟體當做智能判斷分支,搞定分類、路由、評分、大批次資料 Map-Reduce 分析、即時系統以及給大模型做安全護欄。
實測資料與細節公開
團隊公佈了多項對比驗證,並公開了所有測試細節。
1. 即時並排對比
Jev 接收輸入後瞬間平行返回所有機率,而對比的 GPT-5.6 Terra 還在逐字推理輸出。
針對這次測試,團隊公開了以下細節:
測試輸入是一段簡短密集的段落,這種短輸入更有利於展示 Jev 的平行採樣優勢。
測試選用默認推理模式的 GPT-5.6 Terra,因為它的平均智能水平與 Jev 最接近。
在實際運行中,Jev 和 GPT-5.6 Terra 唯一的判斷分歧在使用者流失機率等級上,這段文字本身確實存在歧義。
2. 真實工作流評估
為了測試模型在真實程式碼邏輯裡的表現,團隊設計了一套全新的測試方法。
不測公認的標準答案,給所有模型套入相同的生產級業務工作流程式碼,拿 GPT-6 Astra 和 Fable 5.1 兩個大模型的平均判斷做基準。
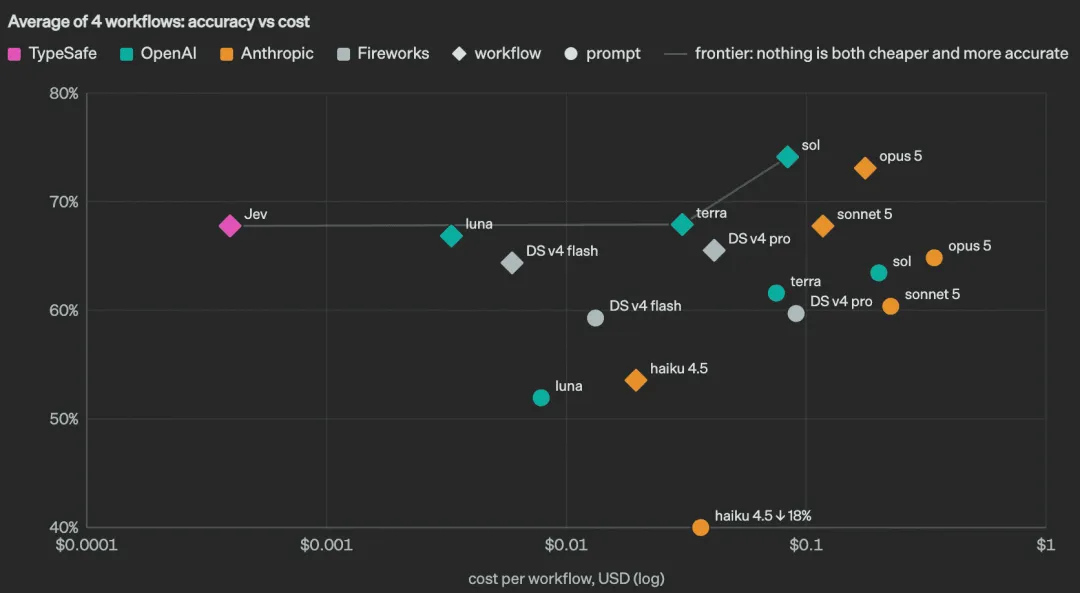
在 4 個實際業務工作流測試中,Jev 佔據了帕累托最優前沿,精準率達到約 68%,成本比 OpenAI、Anthropic、Google 等主流模型便宜了 100 倍到 1000 倍。
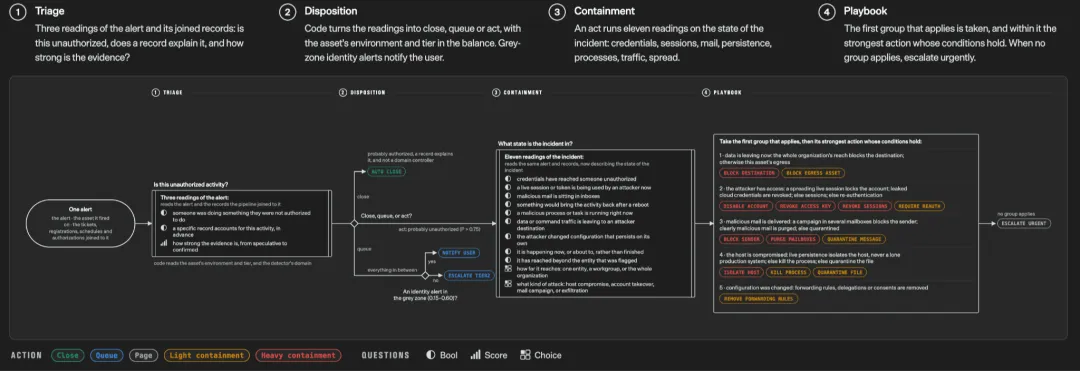
這是 4 個工作流中最簡單的一個:分流、處置、遏制、劇本。
包含大量獨立解耦的問題與細粒度機率分支。
針對測試,團隊補充說明:
首頁宣傳的提速 193.6 倍、降本 444.6 倍來自該測試,屬於現實收益的上限水平。
工作流由內部能力團隊編寫,不排除存在潛在偏好。
參考標準採用了 OpenAI 和 Anthropic 的模型均值,可能低估了 DeepSeek 等模型以及 Jev 的相對表現。
對比的大模型均使用了團隊開放原始碼的 System One LLM 適配層,雖然限制了大模型輸出規範,但這也讓大模型的呼叫成本進一步上升。
3. 徹底杜絕幻覺與類型錯誤
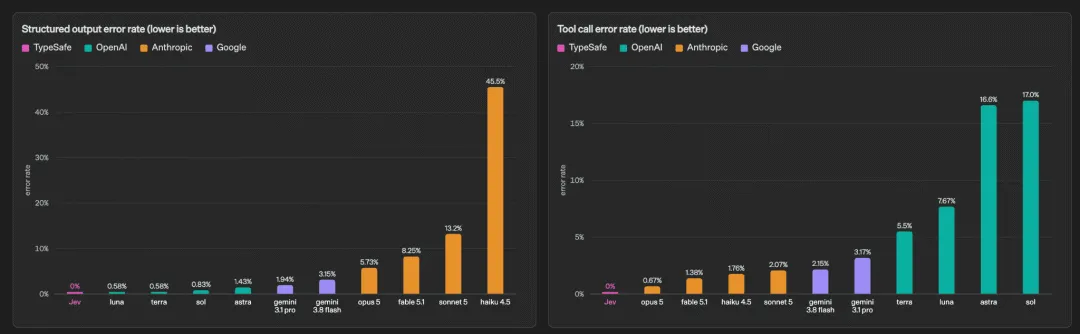
現存大模型在 OpenRouter 上的統計資料顯示:
結構化輸出錯誤率在 0.58% 到 45.5% 之間。
工具呼叫錯誤率在 0.7% 到 17.2% 之間。
Jev 在這兩項指標上的錯誤率全為 0%。
因為 Jev 從底層直接鎖死 Schema 模式匹配,從數學機制上杜絕了類型錯誤與幻覺。
試玩演示
毀滅戰士 Doom
團隊給 Doom 遊戲接入了 Jev,每秒呼叫 10 次判斷,每小時呼叫成本約 7 美元。
需要說明的是,當前測試輸入給模型的是遊戲的結構化文字狀態資料,並非直接輸入圖像。
雖然專用非 AI 指令碼可能打得更好,但該演示展示了模型極快的指令跟隨與響應速度。
維基百科競速 Wikiracing
規則是從一個維基百科詞條出發,只靠點選頁面內的連結跳到目標詞條。
Jev 支援最高 255 個高基數選項。
面對極多連結時,系統採用兩階段處理:先獨立打分再做明確選擇。
在對比中,Jev 的跳躍步數明顯更少。
名字以及研發背後
名字裡的 System One 和 Jev 是什麼意思?
名字來自丹尼爾·卡尼曼的《思考,快與慢》,指代人類快速直覺反應的系統 1。
Jev 名字取自經濟學家威廉·斯坦利·傑文斯(傑文斯悖論)。蒸汽機效率提升沒有減少煤炭消耗,反而引爆了總需求。算力成本每降一個數量級,就會啟動成倍的自動化需求。
為什麼要開發全新的訓練演算法?
以往的 RLHF 最佳化目標是讓人類給文字點贊,這適合聊天,不適合嚴密的自動化。
RLVR 只能解決容易用程式碼判分的問題,真實世界的大量判斷不具備這種特性。
訓練目標決定模型形態,因此團隊研發了 RLCD 演算法。
Jev 算是一個更小的大語言模型嗎?
Jev 既不是小模型,也不屬於大語言模型,它是完全不同的結構。
為什麼不刷公開跑分榜?
團隊堅決不公佈公開基準測試成績。
公認跑分容易導致針對榜單刷分,甚至讓模型能力失真。
團隊建議開發者在自己的真實場景下建立評估集,即便在跑分上領先,也不去過度推崇榜單。
訓練資料來自那裡?
TypeSafe 本質上是一家資料研究實驗室,所有訓練資料全部由團隊自研建構,絕對不會拿使用者的資料用於訓練。
目前 Jev 已經開放早期預覽申請。
source:
https://typesafe.ai/blog/introducing-system-one-models-and-jev
(AI寒武紀)