
AI原生架構,會成為手機晶片在智能體時代的新解嗎?
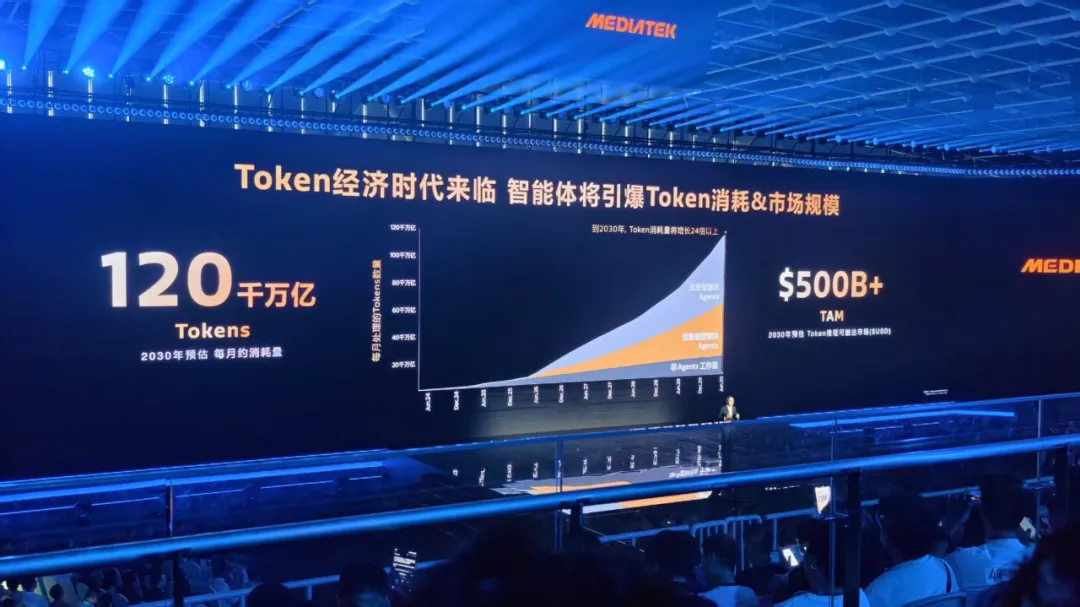
今天,智能體的爆發進一步加速著Token經濟時代到來,到2030年,全球每月Token消耗量預計將達到120千兆,增長24倍。
智能體浪潮之下,新的產品、新的UX體驗、新的生態都在不斷湧現,AI與各類智能終端加速融合,AI從雲端走向邊緣和端側。
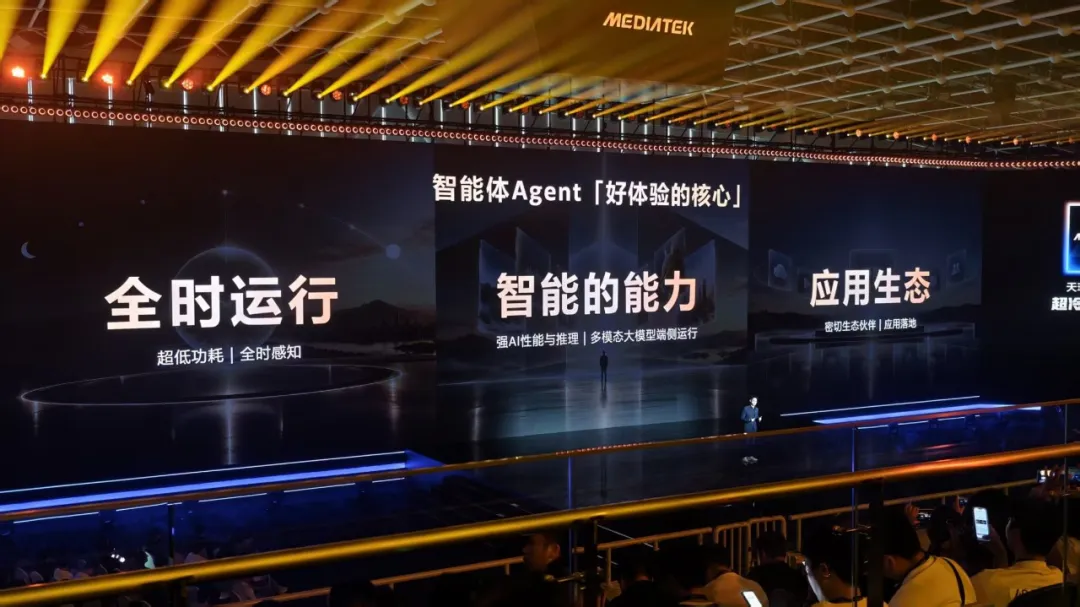
AI開始真正幫人高效做事,實現端到端閉環,強大的端側Agent不止於多模態互動,更在於執行複雜長程任務、即時感知主動服務、知你懂你。AI手機也在快速化為智能體AI手機。
與此同時,端側智能體快速發展也在倒逼晶片架構層創新,晶片競爭焦點從極限算力轉向能效、記憶體、成本,如何讓AI應用跑得“多快好省”,成為關鍵。
如何讓強大的Agent能夠全天候為你服務?如何進一步推升能效極限、打破資料搬運效率瓶頸?
AI計算需求從單點走向全端,這對CPU、GPU、NPU都提出了新的要求,晶片底層架構創新已勢在必行。
在這樣的行業背景下,聯發科技(MediaTek)昨日正式發佈了新一代天璣旗艦天璣9600 Pro,從CPU、NPU、GPU到ISP,在性能、能效基礎能力大幅提升之上,SoC底層硬體全面圍繞AI升級。
我們看到,NPU深度參與各部分計算,AI融入整個SoC,實現系統級資源協同調度。可以說,面向智能體AI,聯發科把SoC徹底重做了一遍,在移動SoC領域定義了真正的AI原生架構,基於軟硬深度協同,將智能體AI手機體驗帶到了一個新高度。
01.深度“拆解”AI原生架構SoC:各模組全面基於AI進化,NPU深度融合
智能體AI手機帶來的海量AI應用需求爆發,給端側晶片帶來了巨大挑戰。
如今AI發展早已走過了早期單純生文生圖階段,長程複雜任務的意圖理解、拆解、規劃、執行,以及持續感知、長期記憶之下的貼心主動服務,都涉及大量不同負載、不同類型、不同需求特點的AI計算需求,從CPU、GPU、NPU到更細的SoC組成部分,都需要針對這一智能體趨勢深度改造。
AI原生架構將成為後續晶片廠商聚焦的關鍵方向,唯有原生——從底層就全面針對AI需求深度改造,才能實現最佳效率。而聯發科,已經率先交捲了:
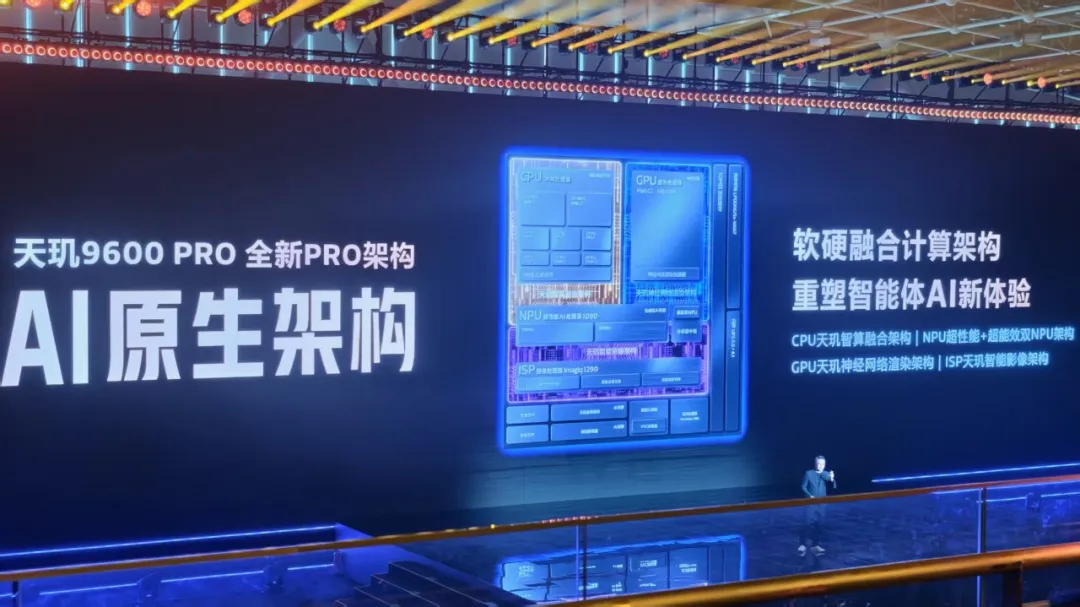
從CPU天璣智算融合架構、NPU性能+能效雙NPU架構、GPU天璣神經網路渲染架構到ISP天璣智能影像架構,AI深入SoC各個模組,CPU、GPU、NPU都針對智能體時代端側AI一系列挑戰做針對性架構最佳化,並實現高效協同。
具體是如何做到的、其中克服了那些關鍵技術挑戰、對我們實際使用AI的體驗又有怎樣的影響?接下來我們將一一深入“拆解”。
1、超性能+超能效雙NPU架構再進化,聯合行業頭部落地海量端側智能體體驗
首先,我們將目光聚焦於NPU。智能體時代,NPU一直是端側AI處理的核心計算單元,其重要性愈發凸顯。
本地模型高效運行、AI全天候持續精準感知,都離不開出色NPU的加持,並且是既需要性能、又需要低功耗,可以說是“既要馬兒跑,又要馬兒不吃草”。
為此,聯發科從去年開始就在行業中首次推出了雙NPU架構,在今年的旗艦9600 Pro上,雙NPU架構再次升級,超能效NPU功耗更低,超性能NPU性能更強,整體雙NPU協同能效表現更好。
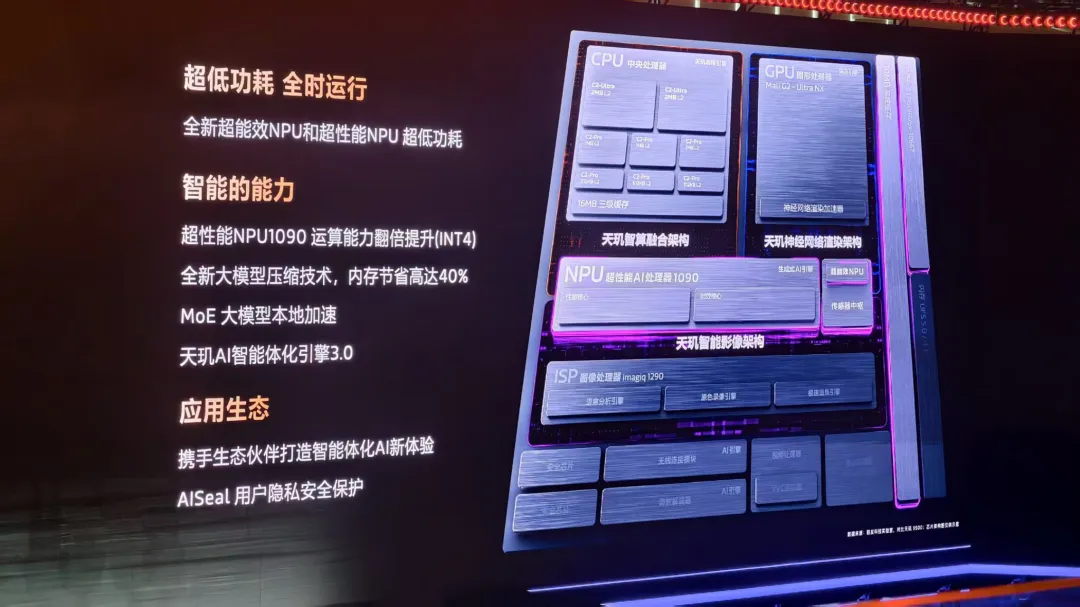
超性能NPU 1090主要負責大模型運行與端側推理、多模態、生成式AI、複雜Agent任務,其大語言模型預填充性能提升51%、每瓦特生成Token數大幅增加了55%,在ETHZ AI Benchmark排行榜中再次登頂,支援30B MoE大模型端側運行。
超能效NPU則負責Always-On即時感知、持續背景執行,功耗較天璣9500降低了40%之多。
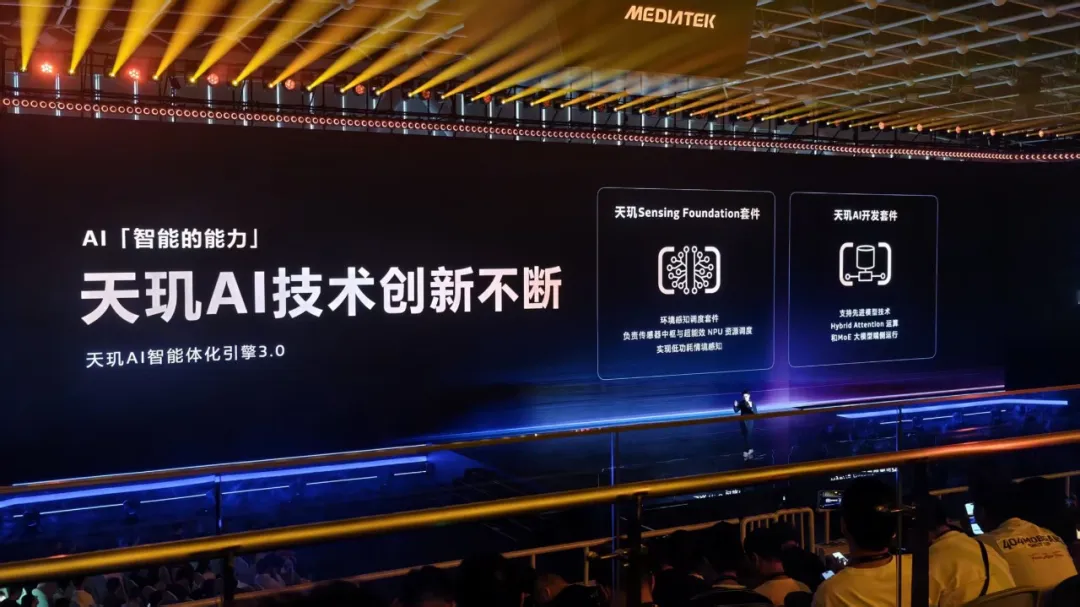
硬體底子打牢之上,聯發科通過天璣智能體化AI引擎 3.0的升級進一步實現軟硬體的深度協同。
目前天璣NPU的AI能力已經形成“硬體+系統+開發工具+生態”完整鏈路。感知能力方面,Sensing Foundation套件可以協助實現低功耗AI即時情景感知;在模型最佳化方面,天璣AI開發套件則可以讓端側複雜模型更高效的運行。
在雙NPU兼顧性能、能效和完善生態之下,我們在發佈現場展區看到了不少出色的端側AI應用體驗:
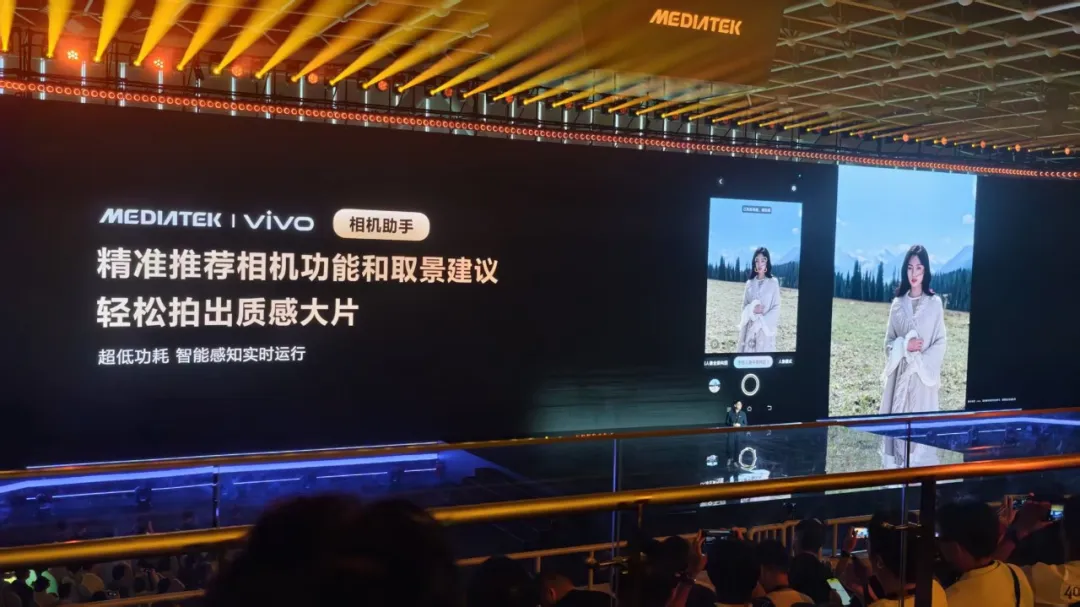
手機廠商方面,聯合vivo,利用超性能NPU端側運行多模態大模型,自動識別視訊高光時刻並一鍵生成專屬回憶,利用超能效NPU讓AI持續感知拍攝場景,並從拍攝模式、構圖到濾鏡風格進行智能適配;聯合OPPO,通過低功耗常駐AI即時識別拍攝場景、自動最佳化構圖,小布助手可以更主動地幫使用者篩選重要資訊並及時提醒。
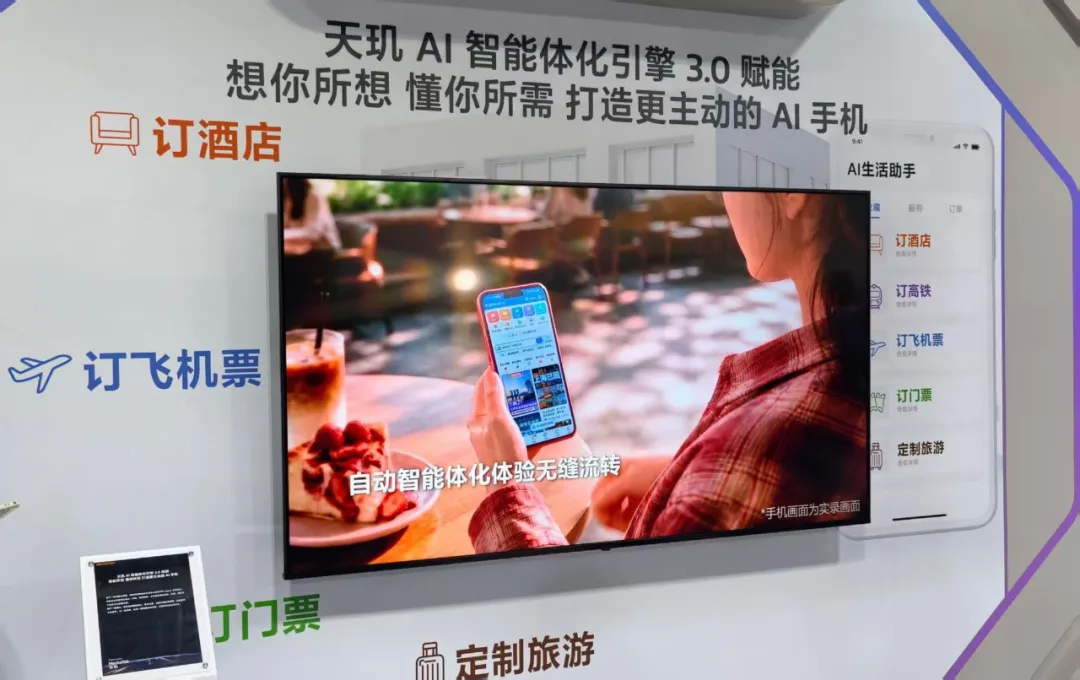
大模型廠商方面,聯發科聯合階躍星辰(StepFun),通過天璣AI智能體化引擎3.0讓手機進一步理解使用者意圖與需求,提供更主動的智能體服務;與千問深度合作,依託雙NPU架構在端側運行30B MoE大模型 ,結合天璣智能體化引擎打造數字分身體驗。
整體來看,雙NPU架構進一步迭代,強化了性能優勢,提升了能效表現,解決了端側模型落地算力瓶頸同時,讓智能體AI真正常伴、即時感知成為可能,可以說給智能體化的AI手機體驗夯實了AI算力根基。
2、CPU是智能體時代的“中樞和肌肉”,CPU、NPU、記憶體統一智能調度實現架構融合
接下來,我們將目光聚焦於SoC的通用計算核心CPU。智能體時代,AI應用最大特點就是計算需求複雜,感知資料的分析、複雜意圖的理解、邏輯推理、複雜任務的拆解規劃執行,都離不開CPU作為“中樞指揮”。
此次天璣9600 Pro的CPU在性能、能效、快取方面的升級對AI應用端側落地都有重要推動作用。
在天璣9600 Pro上,聯發科首創的全大核架構繼續迭代升級,將超大核擴展至2顆,雙C2-Ultra超大核的峰值頻率來到4.55GHz。
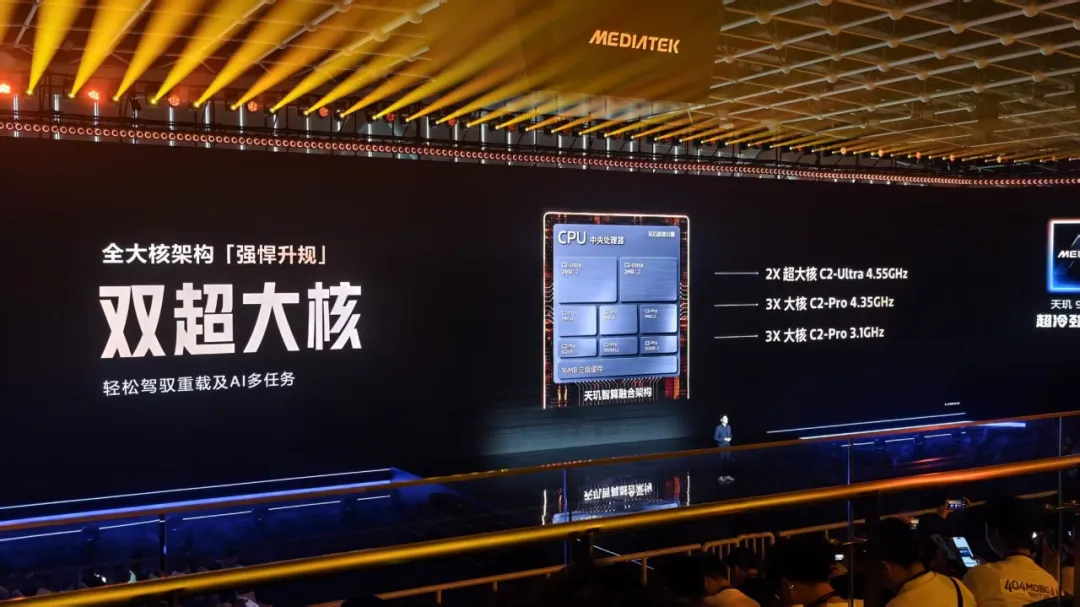
在聯發科與台積電進行深度設計工藝協同最佳化(DTCO)的2nm工藝與核心架構升級之下,CPU能效顯著提升,超大核性能提升17%、多核性能提升15%。
雙超大核設計在Agent時代有助於突破AI多載下的單核瓶頸,雙核協同可以兼顧瞬時高負載和平行流水線,讓AI響應更快;同時,雙核還能實現高頻與能效更好的動態平衡,單位功耗下性能輸出更高,提升晶片持續性能。
快取方面,L2+L3+系統快取升級至34.5MB、二級快取提升21%,這可以減少核心對外部記憶體的頻繁讀取,提高AI的響應速度、減少功耗和發熱。
在CPU、NPU、記憶體的深度軟硬協同方面,聯發科祭出了天璣智算融合架構,把CPU算力、NPU算力、電源和記憶體統一納入智能調度,實現Agent持續執行階段前台流暢。此次全大核的電源調度做到了微秒級動態調度,快開快關速度相比上代提升了10倍。
CPU+NPU實現智能計算,先進記憶體+快閃記憶體實現高速資料交換,進而實現能效和性能的同步提升。
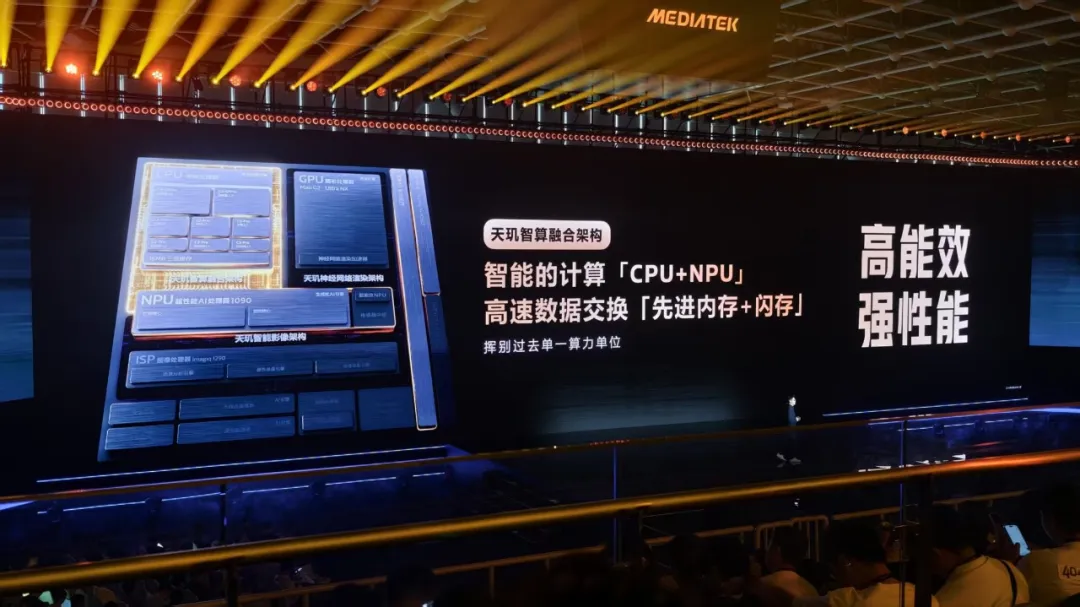
算力調度引擎3.0可以預測端側AI的算力需求,動態協調資源,在性能和功耗之間即時尋找最優點。
基於一系列軟硬協同最佳化,在3B大語言模型測試中,出詞速度提升40%。
在超級記憶體調度技術加持下,AI與App並行記憶體壓縮調度,可以實現25個應用與3B大語言模型全保活。
縱觀CPU升級,我們看到雙超大核架構設計更好應對複雜多樣的AI應用挑戰,實現更好的端側智能體體驗,性能、能效的大幅提升夯實基礎,海量軟體層面的技術最佳化進一步釋放CPU上限,並實現CPU與NPU更高效的協同。
換言之,智能體時代對CPU在即時響應、多工編排和持續能效上的苛刻要求,在這一代架構上得到了系統性的回應。
3、神經網路渲染架構落地,AI與GPU深度融合
在圖形處理的核心模組GPU部分,如今GPU圖形渲染與AI的深度結合已是行業大勢所趨,AI超分、AI插幀技術廣泛應用,降低GPU算力壓力,最佳化系統功耗。
在GPU方面,天璣9600 Pro搭載了最新G2-Ultra NX旗艦GPU新架構,峰值性能功耗下降24%。
值得一提的是天璣神經網路渲染架構的落地,這一架構實現了GPU與NPU協同進行神經網路渲染,AI融入圖形渲染管線。
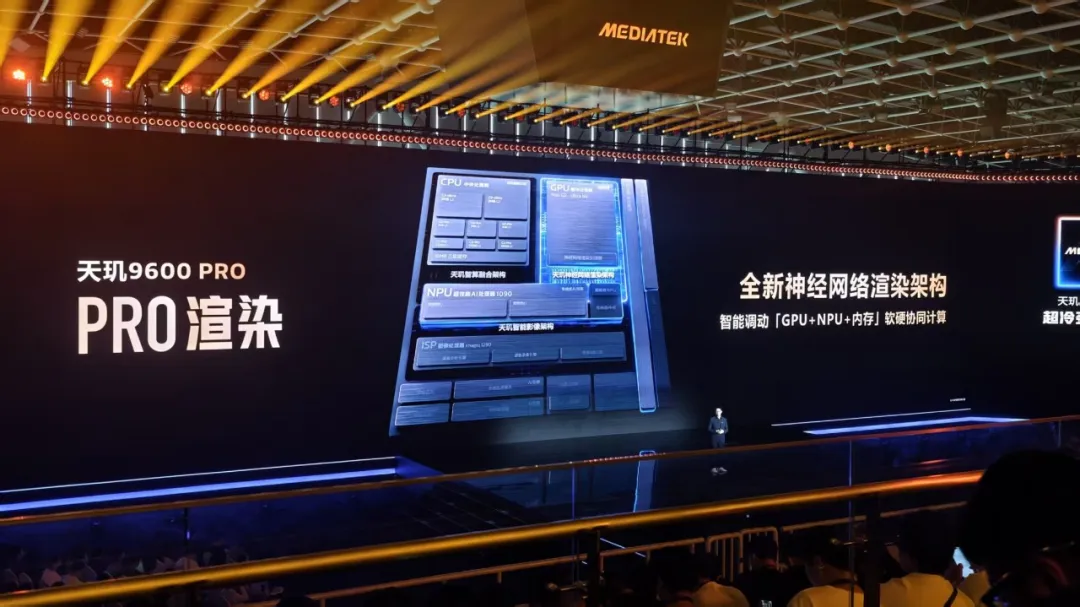
從實際效果來看,在《王者榮耀》CG超分中,原生720P最高可以提升至1080P,並且功耗更低、GPU壓力更小,最終流暢度提升明顯。顯然,聯發科已成為推動PC端AI圖形渲染技術加速落地移動端的核心玩家之一。
4、AI加持影像、通訊,打破體驗天花板
既然是AI與整個SoC的深度融合,自然離不開ISP與NPU的協同。
影像方面,新的高性能ISP與NPU結合,AI深度參與計算攝影,超性能NPU進行多幀計算合成,讓拍照前景後景都能保持清晰,提升影像上限。
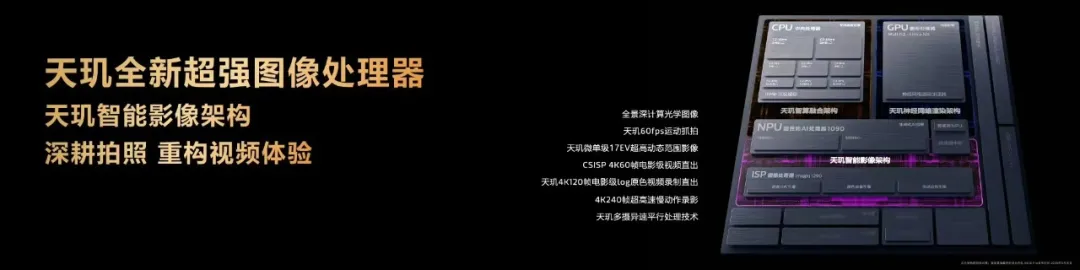
超性能NPU加持下,天璣9600 Pro實現了60fps專業運動級追焦,追焦速度和對焦速度都提升了2倍。
通訊方面,聯發科首次祭出天璣通訊AI開放平台,允許OEM使用自己的AI模型直接參與通訊側決策,相較純CPU運行功耗降低50%。
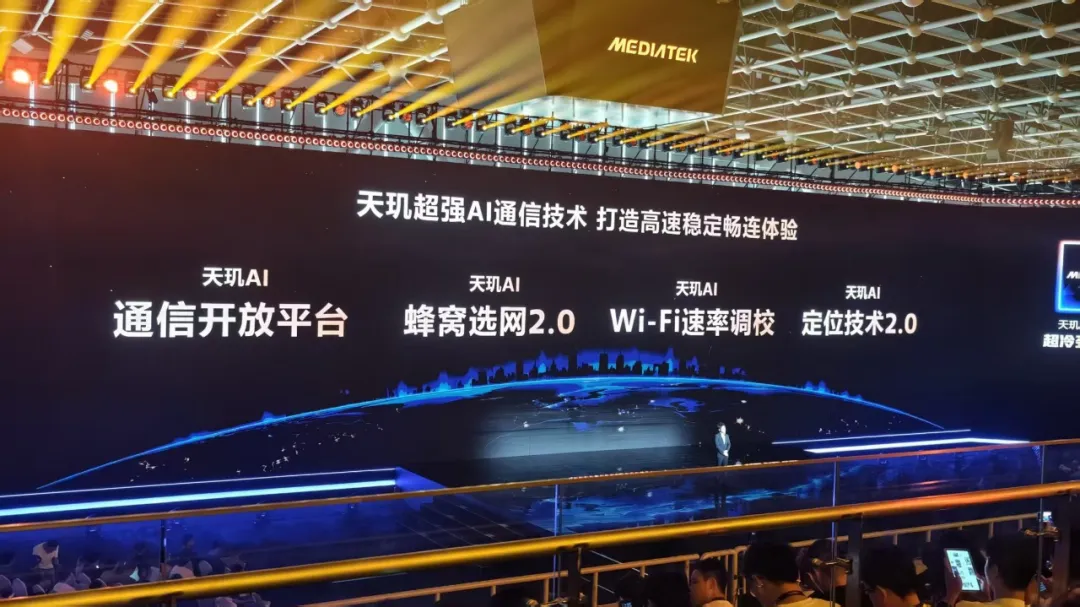
此外,AI蜂窩選網2.0借助AI判斷複雜網路環境並主動選擇/切換基站,卡頓時長較天璣9500下降30%,結合OEM大模型協同最佳化後,卡頓時間再降低10%,達到40%;AI Wi-Fi速率調校通過AI動態推理得出最佳傳輸速率,減少卡頓、保持持續穩定。
縱觀天璣9600 Pro在SoC各部分的升級,我們對AI原生架構有了更清晰的理解:
各模組全面圍繞AI進化,NPU深度融合,晶片不僅是基礎性能、能效的升級,更是針對AI應用特點在架構層面進行改進創新,突破現有技術瓶頸。
這種架構層面的創新有的不僅是縱向的深度,同時也是系統各模組橫向高效協同,NPU與各個模組實現1+1>2。與此同時,軟硬體深度協同也發揮著關鍵作用,各類引擎加持,充分釋放硬體能力,進一步加速端側AI應用落地。
02. 長期深耕AI,緊抓智能體AI浪潮 天璣成端側AI落地核心推手
天璣9600 Pro可以說是一顆全面進化的AI智能體手機晶片,這樣亮眼的表現離不開聯發科在AI賽道的長期深耕,以及對Agent趨勢的精準把握和堅持投入。
與此同時,其在底層架構層的創新突破、整體晶片設計思路,都給手機移動晶片行業在AI智能體時代的發展提供了極具價值的可行路徑參考。
實際上,早在2017年,聯發科就開始做AI相關投入,也是首個將擁有AI能力的硬體處理器搭載於晶片上的廠商。
2023年,天璣9300開始支援全球主流熱門AI大模型,2024年的天璣9400成為行業內第一顆專門為智能體AI打造的旗艦5G晶片,在端側AI層面對NPU軟硬體生態進行了大幅升級,同期聯發科還首發了天璣AI智能體化引擎,幫助終端廠商打造“智能體化AI手機”。
2025年MMDC上,聯發科就已經做出關鍵判斷:Agentic AI UX時代已經到來。聯發科技董事、總經理暨營運長陳冠州也同樣認為:AI的下一波浪潮屬於智能體AI。
可以看到,聯發科在AI大模型爆發、智能體AI爆發等關鍵節點均有關鍵技術佈局和落地,天璣晶片一直緊跟端側AI落地趨勢,時至今日,聯發科已經從底層晶片到上層工具鏈、生態建構了完整的全域解決方案,成為推動端側AI落地的核心力量。
對於使用者來說,出色的智能體AI手機晶片及其生態,進一步加速了端側AI使用者體驗的進化,AI真正即時常伴、主動服務、自主執行複雜任務能力大幅提升。
對行業來說,聯發科讓行業看到了端側晶片從“單一硬體算力堆疊”向“全SoC架構AI原生重構”轉變帶來的巨大潛力:AI從NPU能力延伸至整個SoC架構設計,AI深度參與各類計算,實現不同IP之間的高效協同、系統級資源的協同調度。
以聯發科為代表的晶片廠商,正從“硬體提供商”轉向“軟硬協同生態建構者”,打通AI應用落地完整鏈路,夯牢底層晶片根基,加速AI手機從“工具”進化為“助理”,讓智能體AI手機時代更快到來。
03. 結語:定義AI原生架構 天璣芯加速衝刺Agent時代
天璣9600 Pro的進化證明了一件事:紮實的底層架構創新,是真正打破晶片能力瓶頸的鑰匙。而晶片技術的創新,仍然是當前革新端側AI體驗的核心驅動力,以聯發科為代表的手機晶片廠商正成為加速手機智能體化變革的核心推手。
毫無疑問,天璣9600 Pro將成為下半年旗艦AI手機大戰的核心算力平台支撐,vivo、OPPO等各路手機廠商高管都已在發佈會上宣佈了新機的首批搭載落地,各家終端巨頭會基於這顆晶片打造出怎樣的智能體AI旗艦機,我們拭目以待。(芯東西)