
發明ChatGPT的核心科學家,閉關兩年後,反手給整個大模型行業敲了一錘喪鐘。
今天,前OpenAI核心研究員,ChatGPT、GPT-4論文重要貢獻者,現TypeSafe創始人Diogo Almeida公佈了一種全新模型:Jev,在開發者圈迅速走紅。
Jev這個名字取自傑文斯悖論(Jevons paradox),同時也寓意它在「每美元所能換取的智能」指標上表現爆表。
與現有的LLM模型相比,Jev在系統任務上達到了類似的智能水平,但速度和效率提高了兩個數量級,雖然Jev不具備字串生成功能,但它針對結構化輸出進行了最佳化,並且不會產生幻覺。
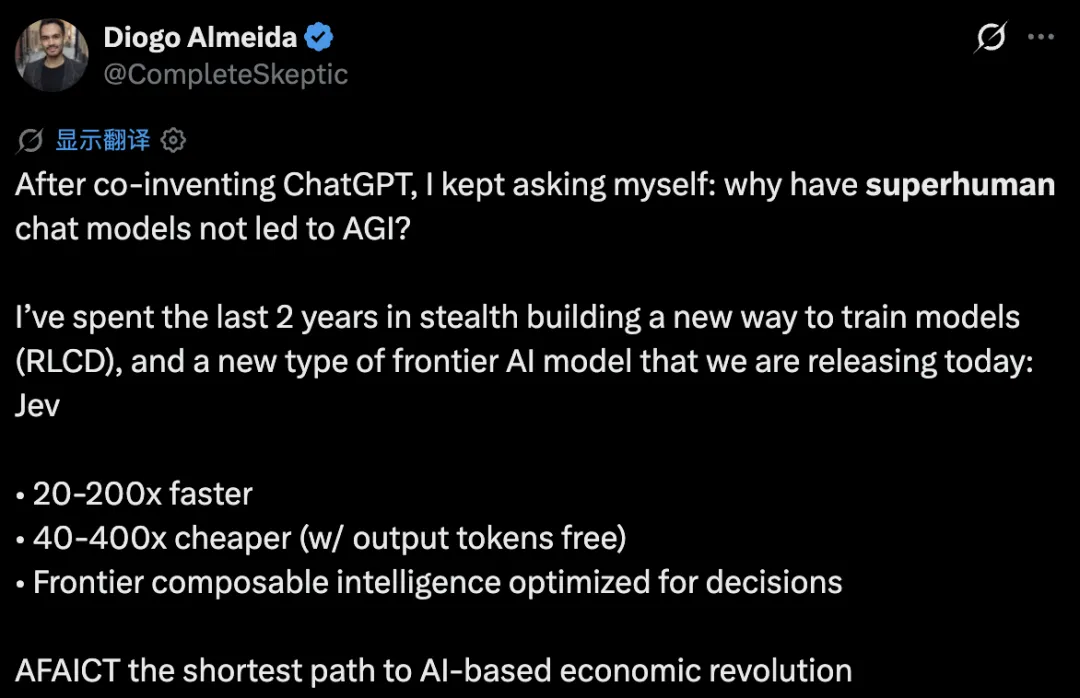
Diogo Almeida稱團隊歷時兩年“秘密”研發,建構了一個完全專注於自動化的新堆疊:採用新的模型架構、平行採樣器以實現最高效率,以及一種新的模型訓練方法(RLCD)。
簡單來說就是,開發者可以把Jev看作是一個前沿智能函數呼叫:輸入非結構化狀態,輸出類型化的機率決策。
01. 放棄出口成章的對話只專注決策能力
在所有人的慣性思維裡,大模型必須會出口成章、會長篇大論, 但Jev走向了完全相反的方向——它徹底閹割了自然語言生成能力,絕不吐半句廢話,只在毫秒級內給出最精準的機率分佈與結構化判定。
Diogo Almeida介紹,相比現有的LLM模型,Jev速度快20-200倍,成本低40-400倍(輸出令牌免費),聽起來好得令人難以置信,主要差異點如下所示:
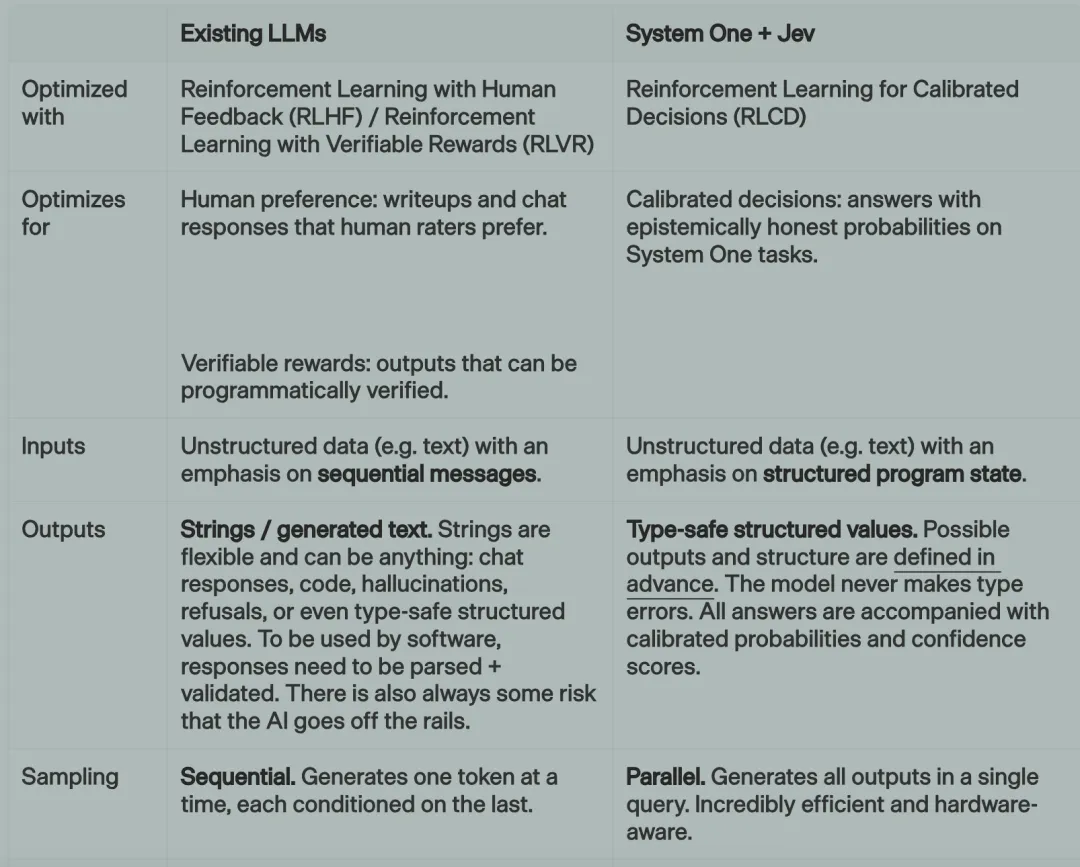
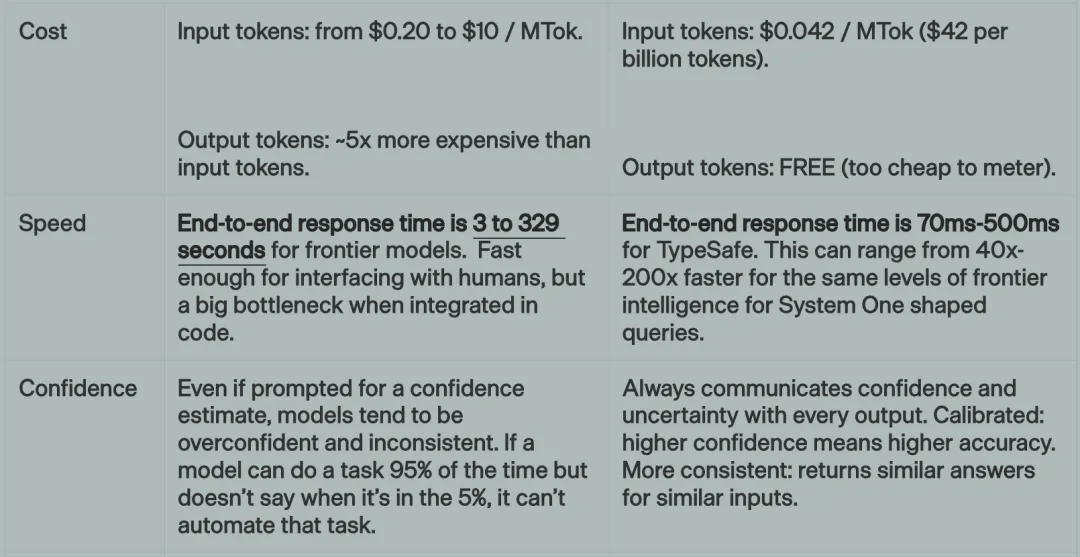
成本方面,LLM模型輸入token約0.20‑10美元/百萬token,輸出開銷約為輸入token的5倍,而Jev輸入token為0.042美元/百萬token(即每十億token42美元),輸出token不計費(成本極低,無需計量)。
訓練最佳化方式方面,LLM模型普遍基於人類反饋的強化學習(RLHF)/可驗證獎勵強化學習(RLVR);Jev的訓練方法為校準決策強化學習(RLCD)。
速度方面,前沿模型端到端響應時間:3‑329秒,對人機互動尚可,但嵌入程式碼時會成為巨大性能瓶頸;Jev模型的端到端響應為70‑500毫秒,針對系統一類任務,同等智能水平下,速度提升40‑200倍。
Jev模型可用於四類場景:
1、AI驅動業務流程/智能條件判斷。結構化輸出直接接入普通軟體,充當模糊決策規則:分類、路由、打分、資訊提取、分支判斷;替代難以維護的手寫邏輯;程式碼約束模型輸出邊界,更容易建構穩定可靠系統。
2、巨量資料Map‑Reduce處理:PB級資料提取特徵、挖掘洞察。
3、即時應用:100ms等級延遲,可用於對互動體驗要求嚴苛的產品。
4、全鏈路校驗:打分、評判、核驗、安全防護,以及檢測大模型提示詞越獄、推理鏈路、模型輸出的安全風險。
02. 平行輸出架構從底層消滅幻覺
這種性能說出來可能沒人信,該團隊在技術報告中表示歡迎質疑者自行驗證。
官方對照Demo直觀展現了Jev模型與傳統LLM模型的核心差異:Jev會平行輸出全部機率結果,而不是按token自回歸逐個生成,幾乎秒出結果;普通LLM字串文字生成雖然能力極強、通用性高,但代價高昂。
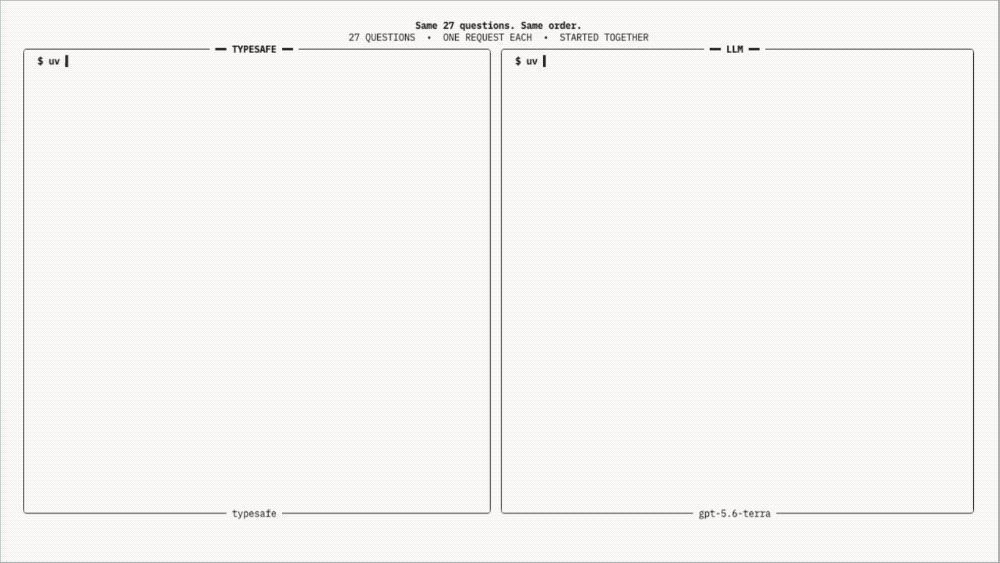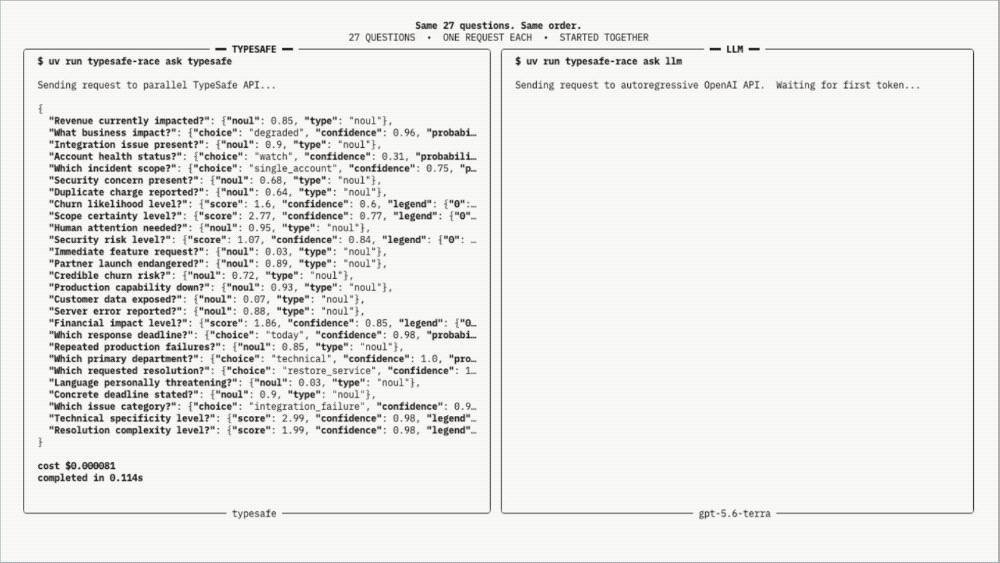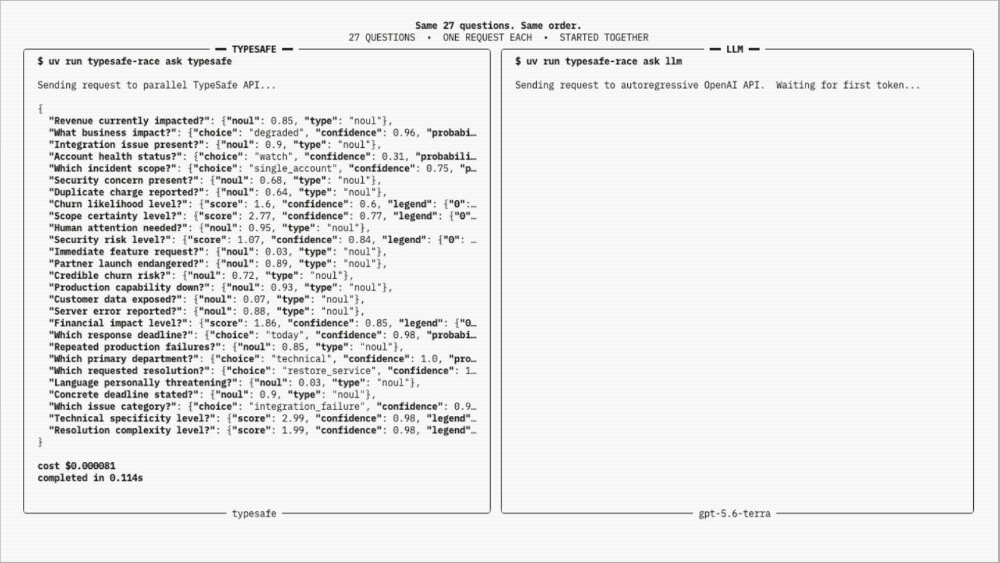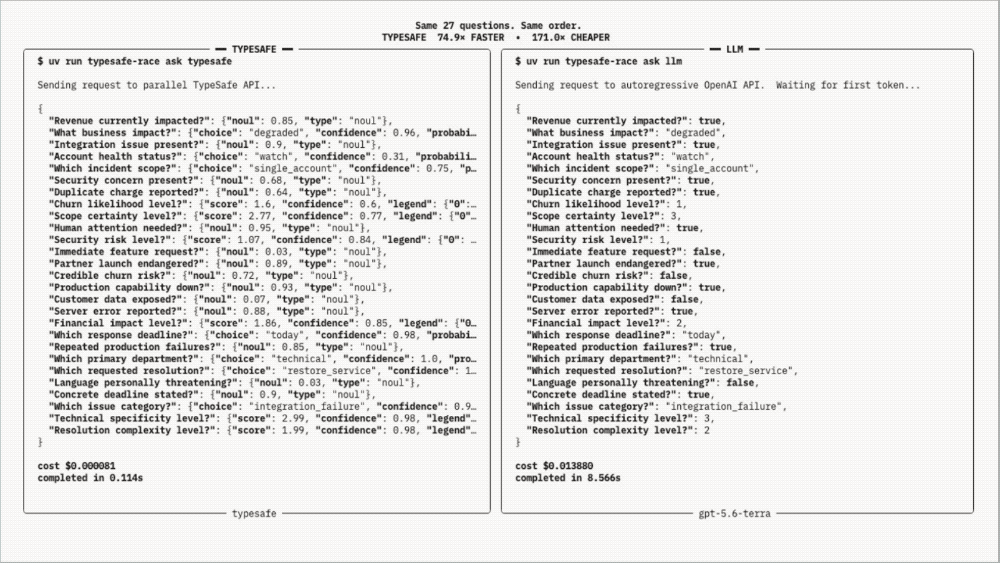
在這個示例中,該團隊選用的對照模型是默認配置的GPT-5.6 Terra,原因是它的平均智能水平與目前的Jev最為接近。
此外,該團隊還設計了一套新的評測方式,用來衡量AI在程式碼內部的實際運行效果。
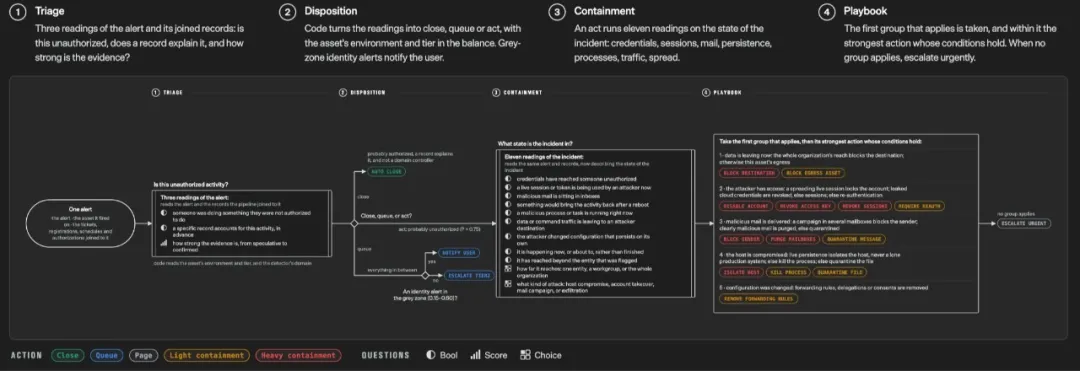
具體而言,預先設定一套正確的計算圖(以程式碼實現的“工作流”),並把業界規模最大、能力最強、成本最高的外部大模型給出的預測結果,作為參考機率基準。
所有模型運行完全相同的工作流,測試各個模型與頂尖模型集合的平均輸出之間的差距,選用的基準模型為當下的旗艦模型GPT‑6 Astra 與Claude Fable 5.1。
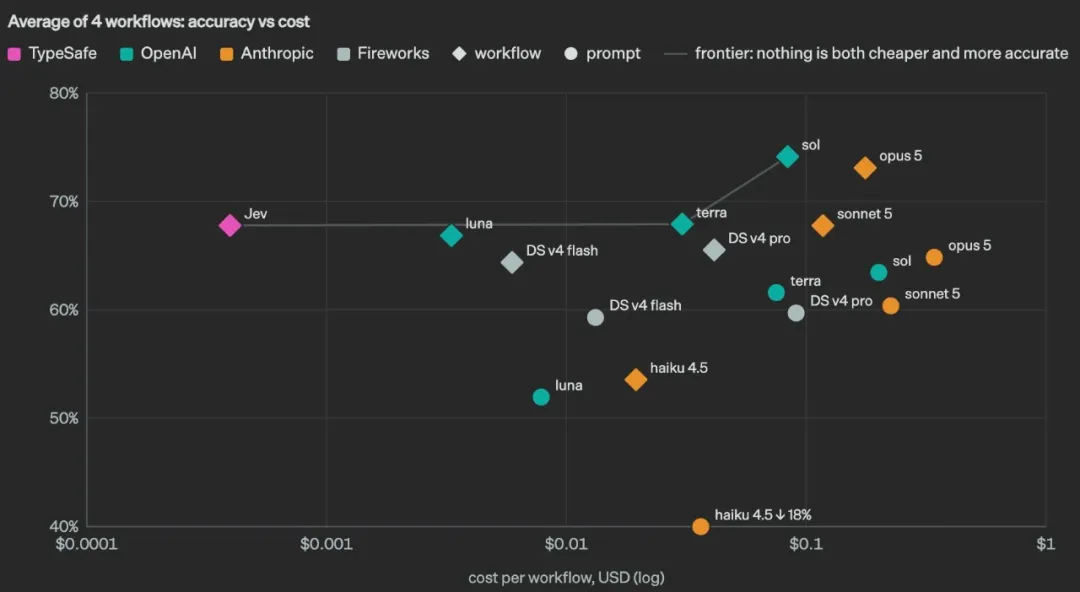
Jev的表現表現遠超預期,佔據帕累托最優前沿,性能差距接近兩個數量級,而依靠生成提示詞、把全部邏輯放在思維鏈(CoT)內部完成推理的模型,表現明顯劣於直接使用工作流本身。
該團隊展示了工作流當中最簡單的一套,對外宣稱的速度提升193.6倍、成本降低444.6倍的資料就來源於這組測試:
另一大突出優勢在於幻覺與類型安全方面。智能體場景下,發生幻覺導致工具呼叫出錯頂多帶來使用不便,但如果這套系統有延遲保障要求,或是呼叫鏈路深埋在多層依賴鏈之中,幻覺問題就會直接讓整套系統徹底不可用。
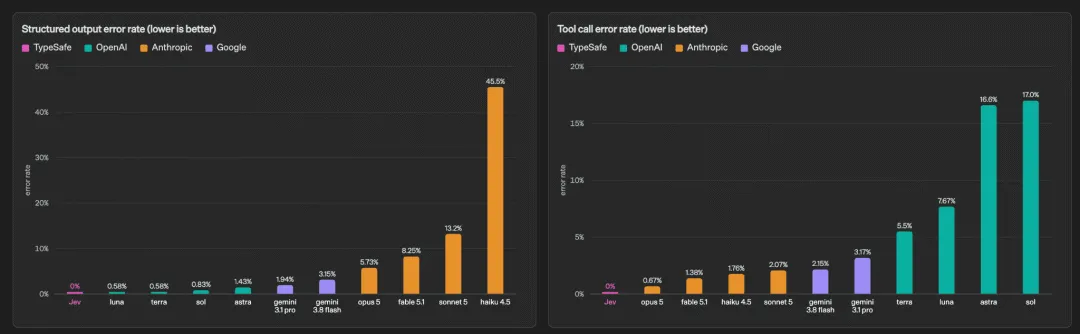
現有的大模型,最讓人抓馬的死穴是它有時候會在不知道答案時依然選擇自信地“胡說八道”,無論如今能力有多強,依然會有機率產生幻覺,同時還會出現類型錯誤。
而Jev模型輸出的每一個數值和選項,都帶著嚴格校準後的真實勝率與置信度,它很清楚自己知不知道,在數學層面上把幻覺徹底焊死降為0。
03. Agent進化的一個新方向
放到具體應用上,Jev帶來的是低成本即時智能能力,以及程式碼結合AI所能實現的效果。
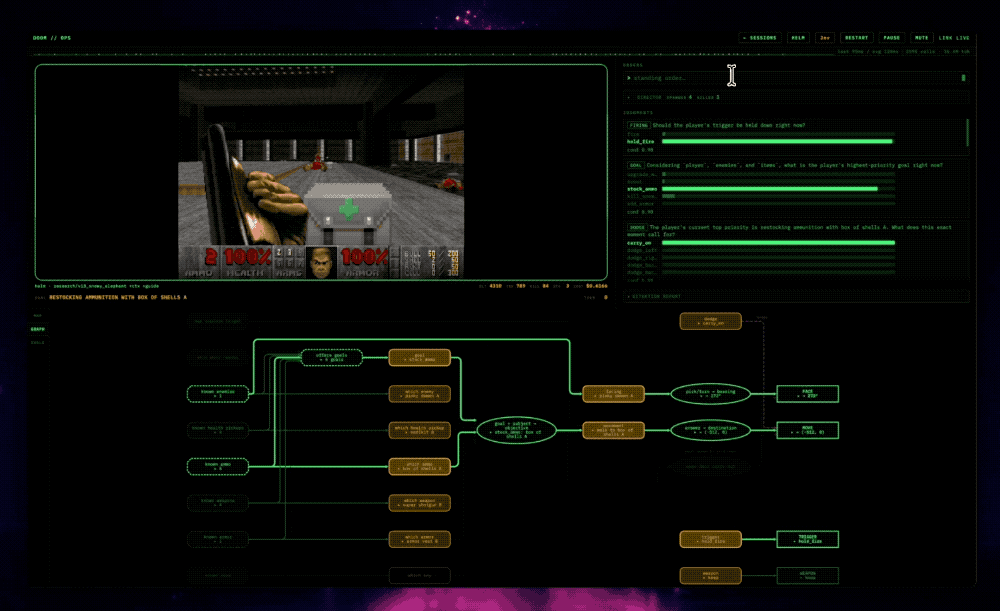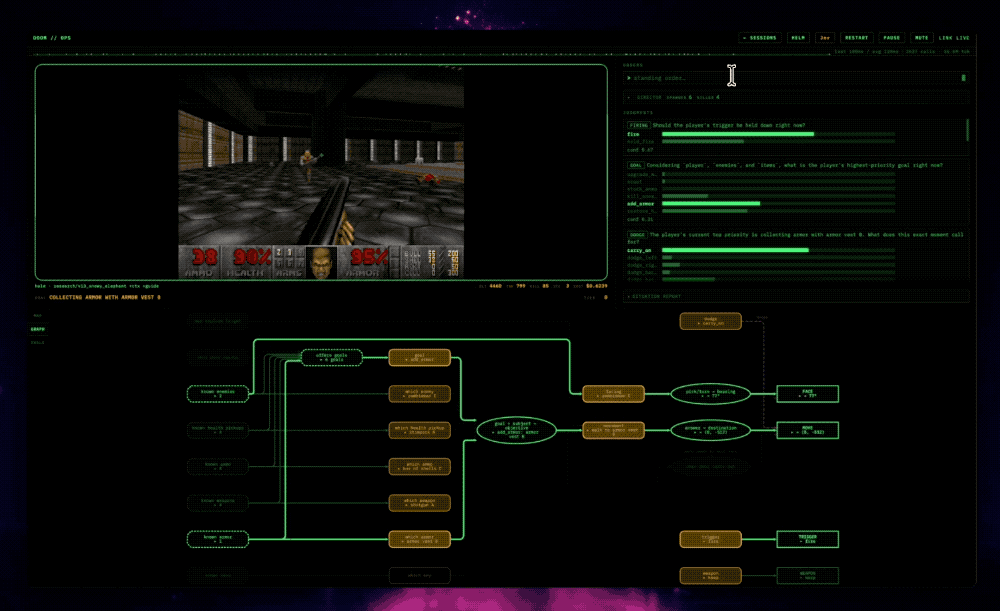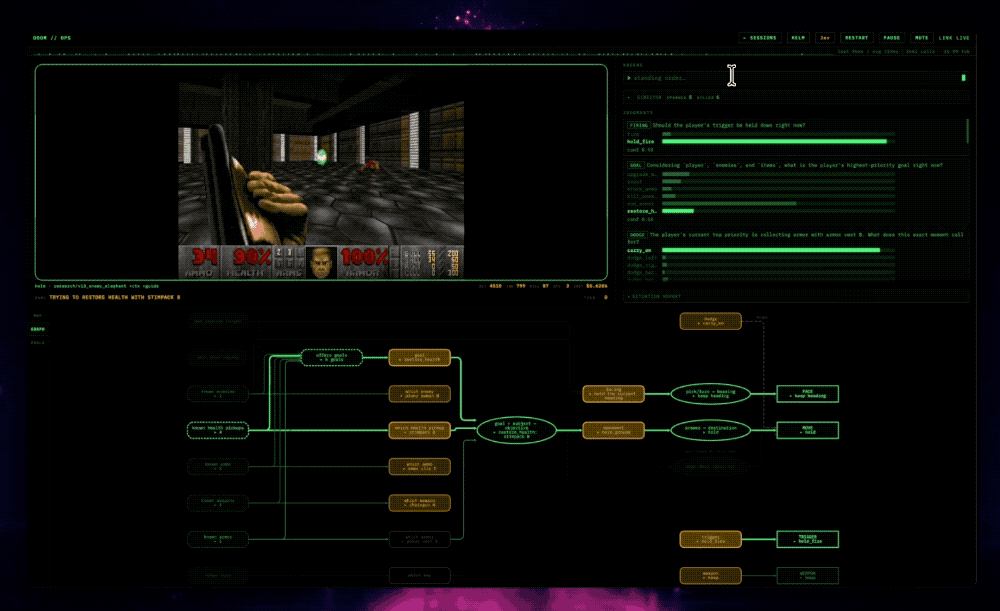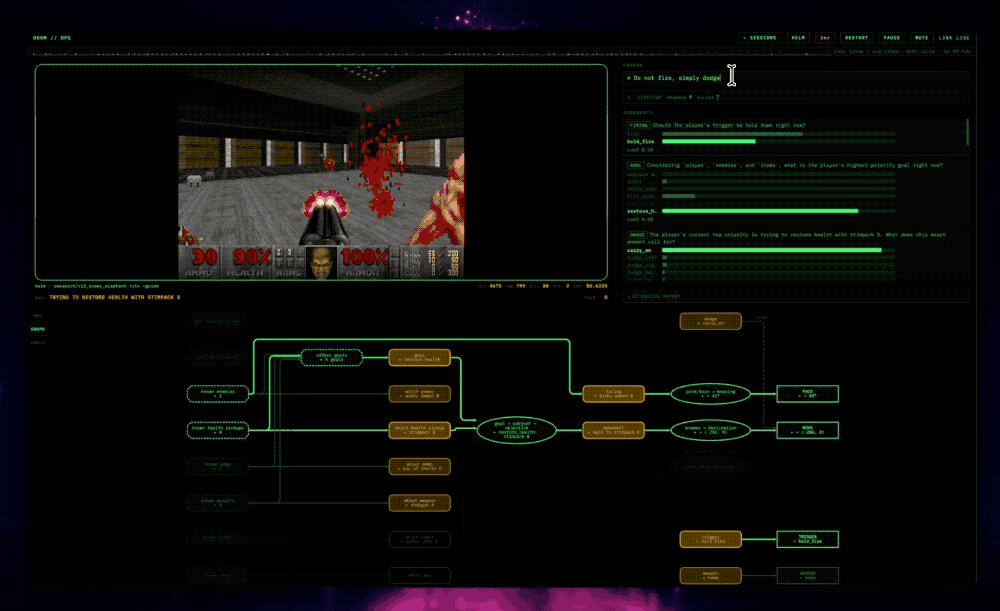
在經典射擊遊戲《毀滅戰士》測試中,Jev模型驅動Doom遊戲即時AI演示,負責開發的工程師原本還擔心每秒發起10次API呼叫的開銷會很高(高吞吐即時場景),最終測算成本僅約7美元/小時。
另一項演示是維基競速遊戲,遊戲規則是從某一個維基百科頁面出發,僅依靠頁面內的超連結跳轉,抵達指定的另一個維基百科頁面,每一步都要從數百甚至上千個連結當中做出選擇。
這是一個絕佳的測試場景,不僅可以體現每秒所能輸出的智能能力,還能充分展示在高候選集選擇場景下,杜絕幻覺所能帶來的疊加增益。
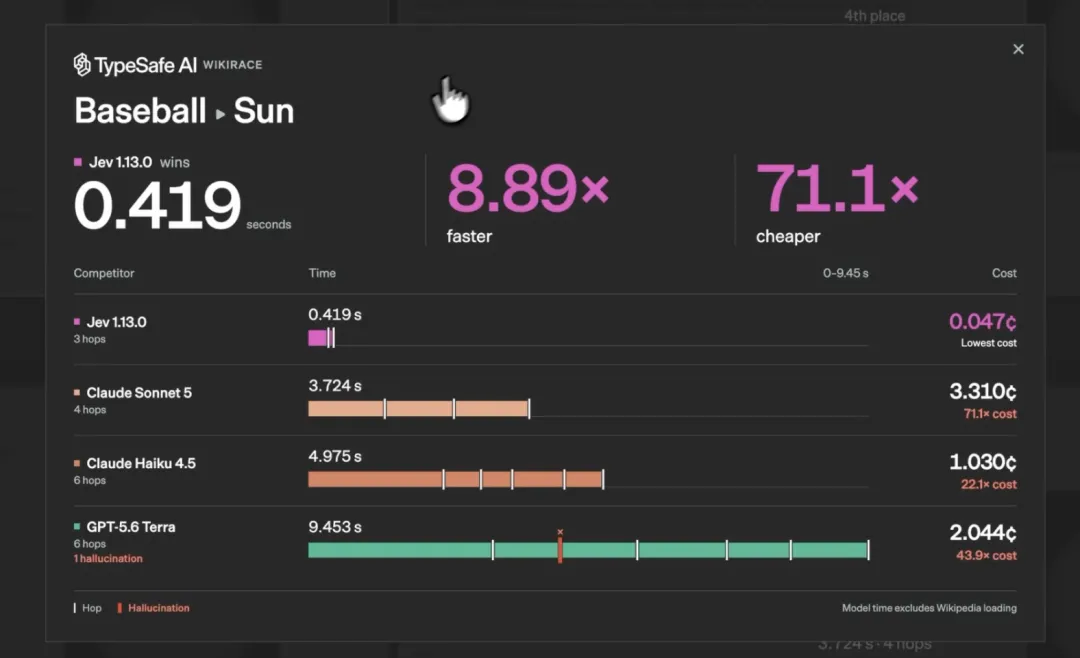
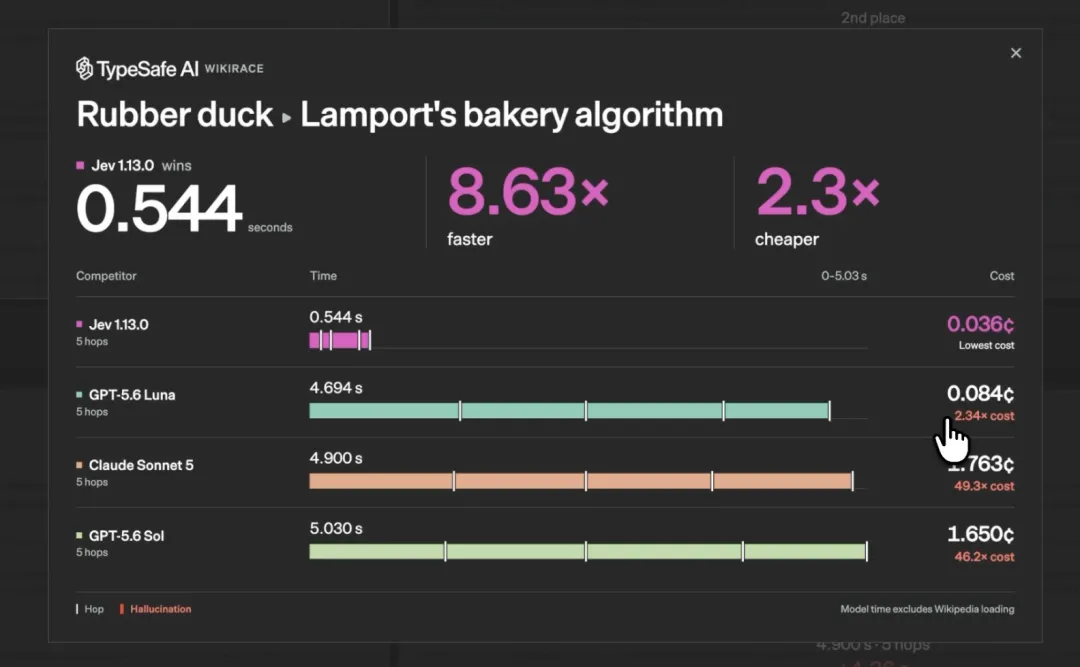
相比對照模型,Jev往往能用更少步數完成任務,最高支援255個候選選項,開啟推理能力後,LLM模型在該任務上的表現會好很多,但關閉推理後,LLM在這項任務上效果會很差。
Jev背後的公司TypeSafe AI在2024年創立時曾獲得4000萬美元融資,該團隊表示Jev目前仍處在早期階段,還有大量研發項目正在推進。
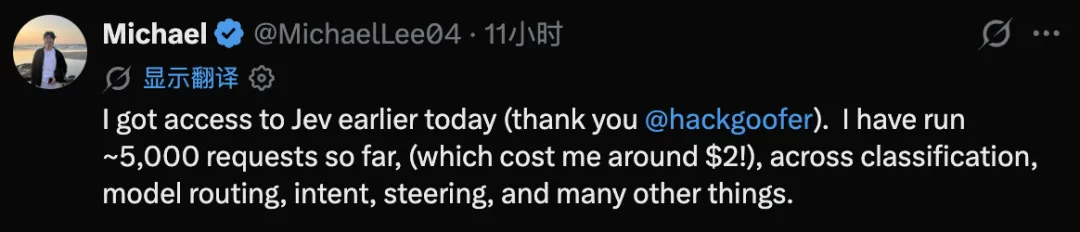
獲得早期Jev存取權的開發者直呼不可思議,測試運行了大約5000個請求僅花了大約2美元,涵蓋了分類、模型路由、意圖、引導以及許多其他方面任務。
有開發者認為,Jev指出了一個很有意思的方向:Agent可以繼續使用通用大模型思考和規劃,但真正進入生產系統的大規模自動化,可能需要另一類更快、更便宜、更受約束的決策模型。
大模型負責想,Jev負責在軟體裡每秒做成千上萬個決定,AI的下一次效率躍遷,也許不是比誰生成得更快,而是不再生成,未來智能體自動化可能會比現在還能再快一個量級。 (頭部科技)