
基於“靈衢+Hi-ONE”打造的昇騰960超節點。
作為全球首個採用NPO光引擎的超節點,昇騰960超節點採用領先的正交架構和全液冷設計,基於靈衢實現記憶體統一編址,可擴展至4096卡規模,實現8EFLOPS FP8、16EFLOPS FP4。
昇騰960超節點用5500個Hi-ONE,替代原本需要的4萬8千顆800G光模組,功耗降低超550千瓦,系統無故障執行階段間提升一倍,系統可用度達到99.8%,加速前沿模型的訓練與推理創新。
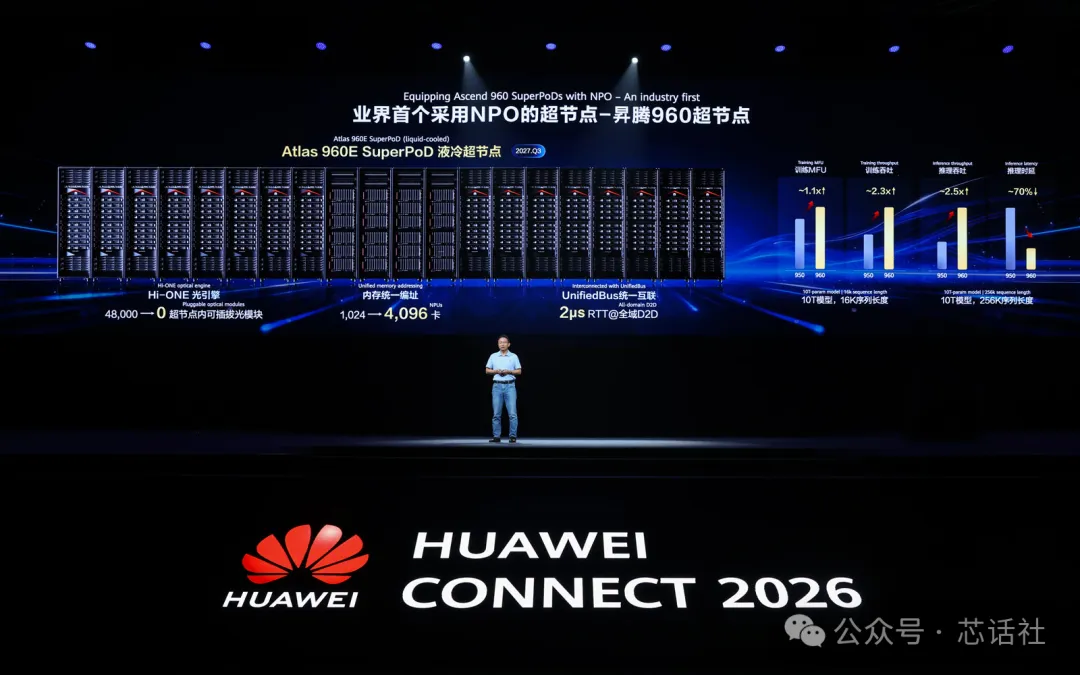
華為發佈首個採用NPO技術的昇騰960超節點,並升級鯤鵬超節點、推出OceanStor M900 AI記憶記憶體系統;基於靈衢UnifiedBus統一互聯,建構Agentic超節點叢集,支援百萬卡超大規模叢集。
昇騰910C超節點已部署超1000套,昇騰950超節點也已規模商用。
當前10萬卡叢集已成為訓練十兆級SOTA模型的標配,但傳統伺服器架構導致叢集內通訊超過訓練時間的40%,嚴重制約了MFU(模型浮點算力利用率)。
根據華為馬爾科夫實驗室模擬結果顯示,4K超節點組成的10萬卡叢集相比由8卡伺服器組成的10萬卡叢集MFU提升了2.75倍。
昇騰960晶片研發進度超出預期,實現性能翻番。
昇騰960DT 2027年Q1推出,比原計畫提前三個季度;昇騰960PR 2027年Q3推出,比原計畫提前一個季度。
後續將堅持一年一代的演進節奏,昇騰970計畫2028年推出,昇騰980計畫2029年推出。
依託τ定律的創新方向,實現算力規格繼續翻倍,訪存頻寬、訪存容量、互聯頻寬等也將大幅提升。
鯤鵬超節點與AI記憶記憶體亮相
隨著SOTA模型的參數規模達到10T級,訓練、推理系統不再是單一的AI伺服器或單一的智算超節點,而是一個複雜的算力系統。
該系統包括智算超節點、通算超節點、一套平等互聯且免協議轉換的互聯系統,在推理系統中還需要部署PB級的KV快取叢集。
鯤鵬超節點進行了升級。基於靈衢全光組網,鯤鵬超節點最大支援4096節點,並形成256TB的統一記憶體池。
此外,華為基於靈衢打造AI記憶記憶體-OceanStor M900。
Agent與長序列需要多層次KV Cache架構,面向Agent推理系統,華為提出了多層KV快取架構,推出基於靈衢UnifiedBus、支援“一跳直連”的華為L3.5層PB級KV快取——OceanStor M900叢集。
同時,M900採用混合介質加最佳化Retention演算法,可將SSD讀寫壽命提升16倍,從底層保障KV命中和長穩可靠。
同時,華為帶來全新的Agentic超節點叢集,加速10兆大模型訓練和推理。
基於靈衢UnifiedBus統一互聯,把多種互聯協議統一為靈衢協議,大幅減少協議轉換開銷,實現昇騰超節點、鯤鵬超節點、KV快取叢集等子系統平等互聯,提供多層次、高頻寬、大容量的記憶體系統,且各類KV快取均可一跳直達的KV快取。
通過二層CLOS四平面組網,最大叢集規模可達到51.2萬卡,再結合多軌道拓撲技術,最大可支援100萬卡昇騰超節點叢集。 (芯話社)