
🔷Compute增長快於I/O擴展,銅互連正面臨Reach、Bandwidth與Escape Radix挑戰
🔷從CPO/NPO到Any-to-Any Optical Mesh,光互連重構下一代AI Scale-up架構
隨著AI叢集從幾十顆XPU不斷邁向數百甚至上千顆XPU,決定系統性能的瓶頸,正在從“算力夠不夠”轉向“資料能不能高效傳出去”。
這一次,小編想和大家聊聊Lightmatter提出的Open Silicon Photonics架構。報告指出,前沿AI訓練的Model FLOPS Utilization僅約38%~43%,通訊停頓、I/O頻寬、Switch/XPU Radix以及銅互連距離,正在限制更多算力真正發揮出來。
面對這一瓶頸,Silicon Photonics正在從傳統光通訊進一步深入XPU、Switch、Package乃至整個AI Rack。從CPO、NPO、XPO、CPX,到Any-to-Any Optical Mesh,再到面向1,024+ XPU Scale-up Domain的光互連架構,Lightmatter希望用Photonics突破銅互連的頻寬、距離和功耗限制,並通過開放介面、統一Fiber Plant與標準化生態,讓AI光互連從“Walled Garden”走向真正的Open Ecosystem。
接下來,小編就帶大家看看,當Compute增長速度已經超過I/O擴展速度,Silicon Photonics究竟將如何重構下一代AI叢集的互連底座。
一、這份材料真正想說明什麼?
隨著AI叢集從幾十顆XPU向數百乃至上千顆XPU擴展,限制系統性能的瓶頸正在從“算力不足”轉向“通訊與I/O不足”。傳統銅互連在頻寬密度、傳輸距離、功耗和Radix方面逐漸觸及瓶頸,因此需要用Silicon Photonics重構AI系統的Scale-up互連;而要真正實現大規模部署,還必須從廠商封閉方案走向開放、標準化、可互操作的光互連生態。
二、AI系統真正的瓶頸,正在從Compute轉向Communication
報告首先提出一個非常鮮明的觀點:AI系統並不是簡單“再加更多GPU/XPU”就能繼續線性提升性能。
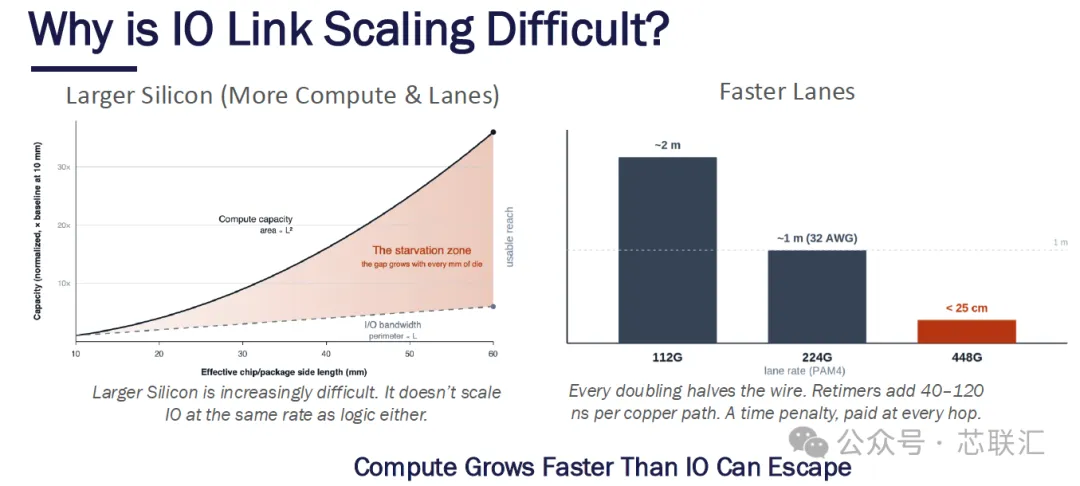
報告給出的前沿訓練場景Model FLOPS Utilization(MFU)只有38%~43%,大量計算資源實際上處於沒有被充分利用的狀態。背後的主要問題並不是Arithmetic,而是Communication Stalls。與此同時,XPU能夠向外引出的I/O數量、交換晶片的Radix,以及銅互連能夠覆蓋的距離,都在限制AI計算域繼續擴大。
進一步把這個矛盾講得非常清楚:Compute增長速度已經快於I/O“逃離晶片”的速度。隨著SerDes速率提高,銅互連距離越來越短,同時Retimer還會給每條銅路徑增加約40~120ns延遲。換句話說,晶片內部計算能力越來越強,但資料越來越難以高效地“送出去”。
這也是整篇報告的第一個核心判斷 未來AI基礎設施的競爭,不只是FLOPS競爭,而會越來越變成I/O Bandwidth、Radix、Latency和Energy Efficiency的競爭。
三、為什麼是Silicon Photonics?核心是突破銅互連的“距離+頻寬密度”限制
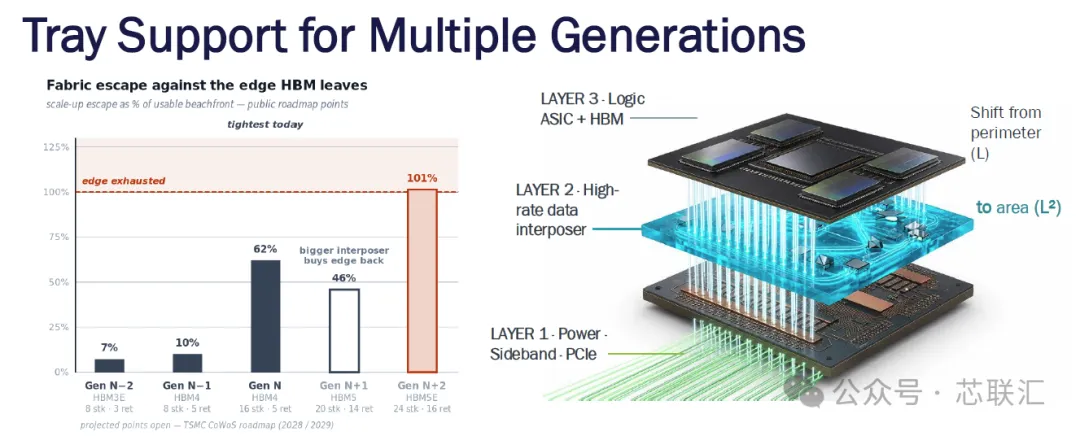
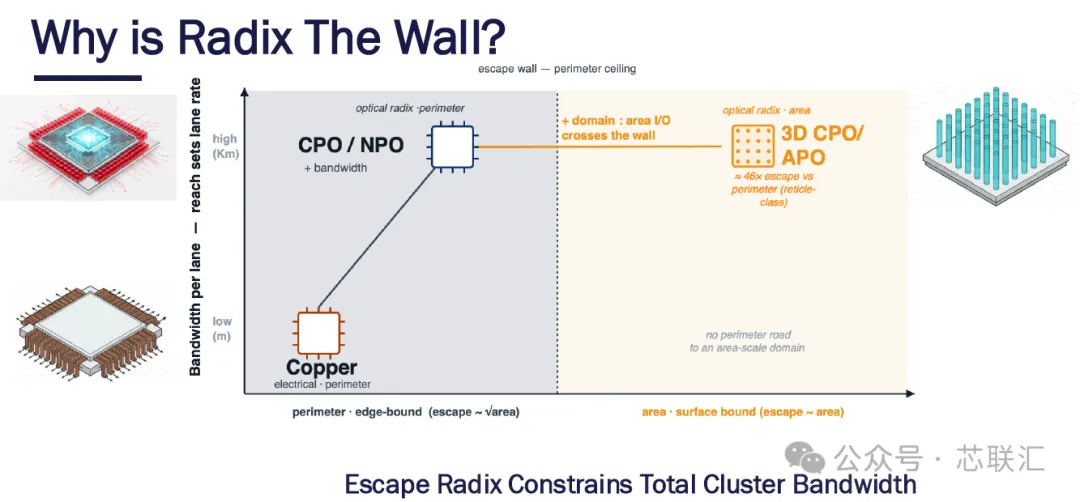
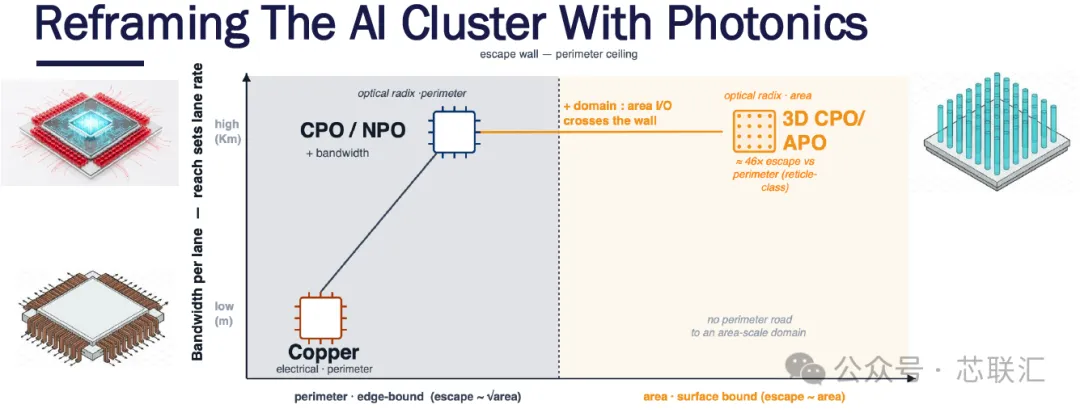
傳統Copper最大的限制,是它主要依賴晶片封裝的Perimeter(周邊)向外輸出訊號。隨著頻寬繼續增加,封裝邊緣能夠容納的高速I/O數量逐漸成為瓶頸,也就是報告反覆強調的Escape Radix問題。
架構圖把Copper、CPO/NPO以及3D CPO/APO進行了對比:銅互連受制於封裝邊緣,而光互連可以進一步突破傳統Electrical Perimeter的限制,把互連能力從“封裝邊緣”向更大面積擴展。
這個思路被進一步推進到Any-to-Any Optical Mesh:系統由ASIC+HBM、高速資料Interposer以及Power/Sideband/PCIe等層組成,通過光學Mesh把網路I/O從傳統Perimeter(L)擴展到Area(L²),從而重新釋放Package Shoreline。
所以這篇報告談光子互連,並不是簡單把“銅線換成光纖”,而是在試圖改變AI晶片I/O擴展的幾何方式和系統架構。
四、目標是把Scale-up Domain從72顆XPU推向1,024+顆
報告給出了非常激進的目標。
通過光子互連,Scale-up Domain希望從目前的72顆XPU擴展至1,024+顆XPU,同時保持Full Bandwidth並增強RAS;MFU目標從38%~43%提高到55%~65%,報告對應給出的有效利用率提升目標為30%~70%。
更關鍵的是能效。報告給出的目標是光互連 <5 pJ/bit,而Electrical Network約為15~25 pJ/bit。
這說明Lightmatter真正瞄準的不是傳統意義上的資料中心“長距離光通訊”,而是把Photonics不斷向XPU、Switch ASIC、Package和Compute Tray內部推進,讓光互連參與Scale-up、Scale-out甚至Memory Disaggregation。
五、CPO只是其中一種形態,未來需要多種光互連架構共存
這份報告還有一個很重要的特點:它沒有把未來簡單押注在單一CPO架構上。
報告明確提到FPO、XPO、NPO、CPO/OBO、3D CPO、CPC、CPX等多種整合方案,同時指出224G SerDes本身就需要大量Signal Integrity設計,而Photonics又引入新的技術能力要求。
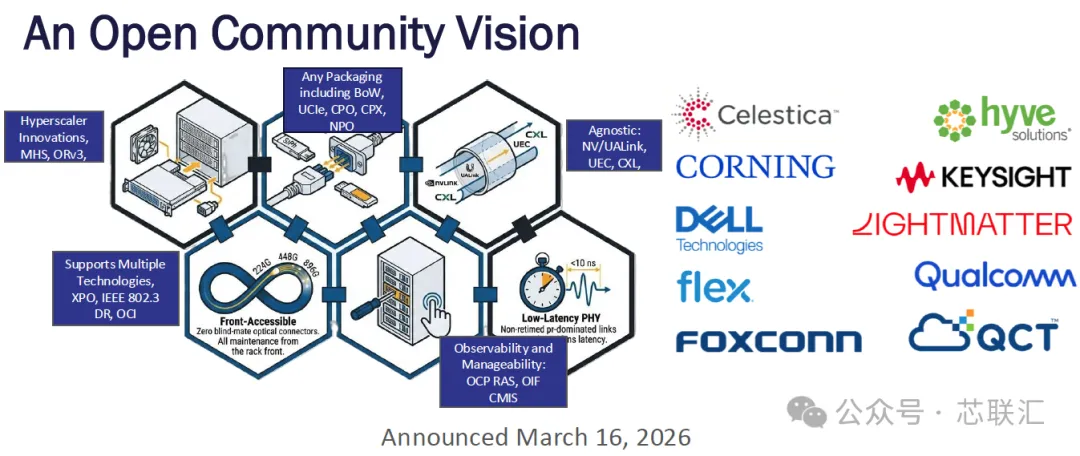
因此,報告提出建立一個Technology-Agnostic(技術中立)的開放體系,可以相容XPO、IEEE 802.3 DR、OCI等技術,協議層可以支援NV/UALink、UEC、CXL等,同時在封裝層相容BoW、UCIe、CPO、CPX、NPO等方案。
也就是說,Lightmatter想推動的並不是“所有人採用同一種CPO。”而是“無論底層採用那種Photonics和Packaging方案,都應該通過統一的介面契約、機械結構、光纖基礎設施和管理體系實現互操作。”
六、從“光模組”進一步走向XPU和Switch共享的光互連架構
報告開始從器件層進入系統架構層。
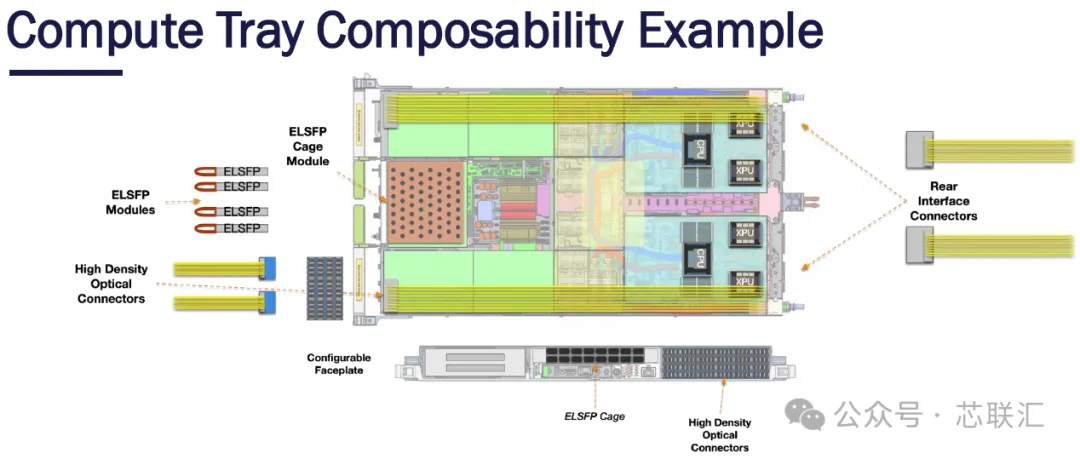
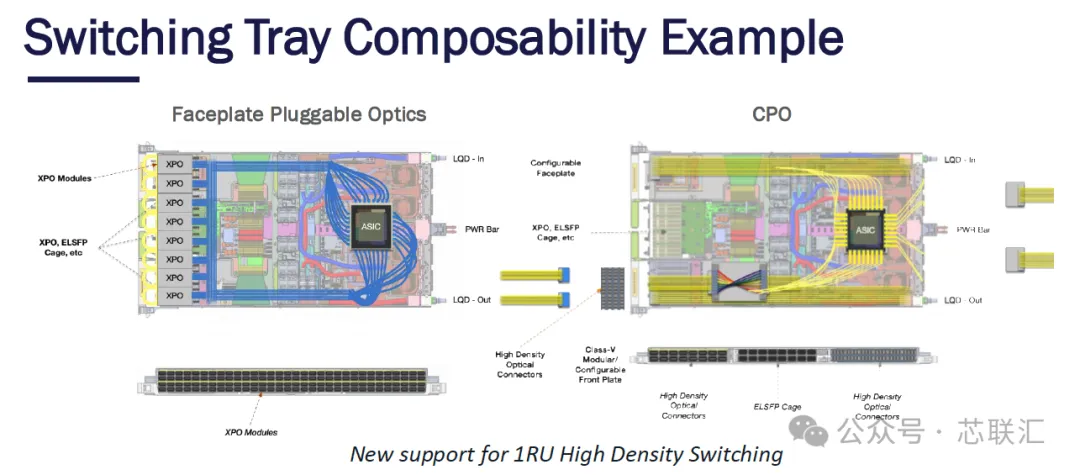
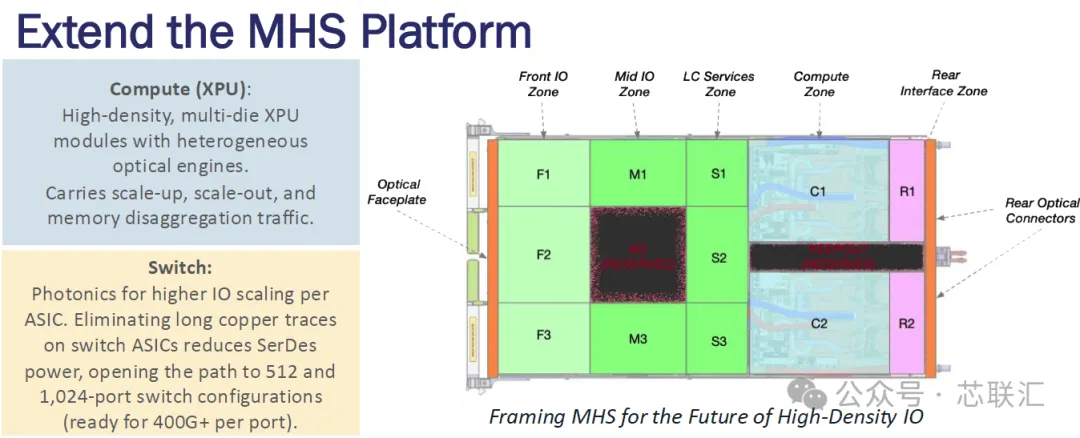
對於Compute XPU,未來可以採用High-Density Multi-Die XPU + Heterogeneous Optical Engines,同時承載Scale-up、Scale-out以及Memory Disaggregation Traffic。
對於Switch,通過Photonics減少Switch ASIC上的長距離Copper Trace,可以降低SerDes功耗,並為512-Port乃至1,024-Port Switch打開空間,而且目標面向400G+ per Port。
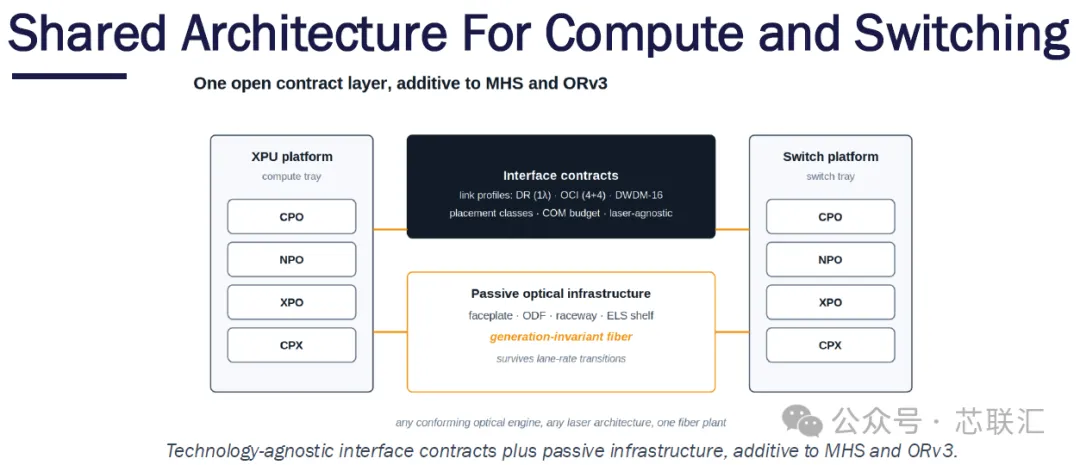
更進一步,報告提出讓Compute和Switch共享一套Architecture,通過Technology-Agnostic Interface Contracts + Passive Optical Infrastructure,把CPO、NPO、XPO、CPX等不同實現統一到共同基礎設施之上。
這其實是一個非常重要的轉變 Photonics不再只是Switch前面板上的一個“光模組”,而開始成為AI伺服器、Compute Tray、Switch Tray乃至整個Rack架構的一部分。
七、真正值得關注的是“一套Fiber Plant跨越多代晶片”
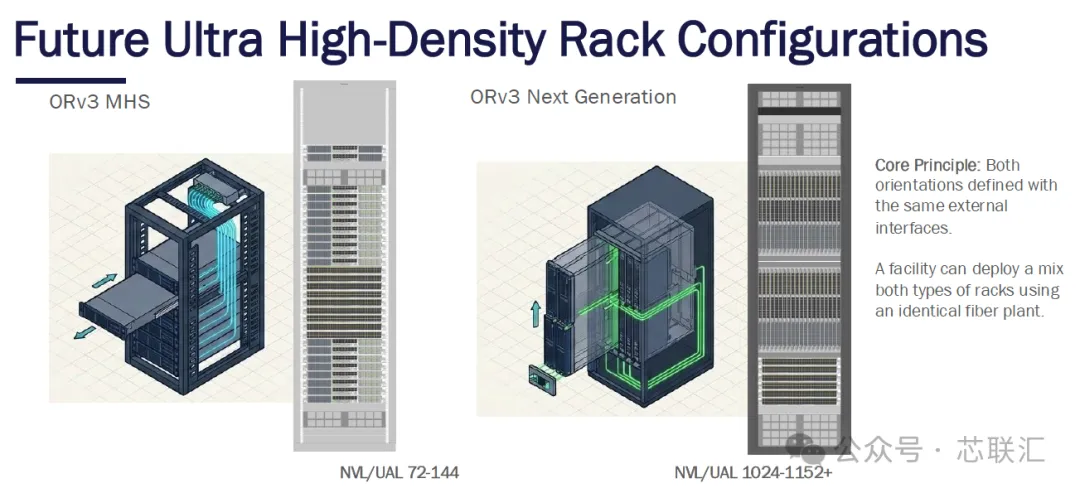
這篇報告有一個非常有意思的系統設計思想——The Passive Layer Outlives the Silicon。
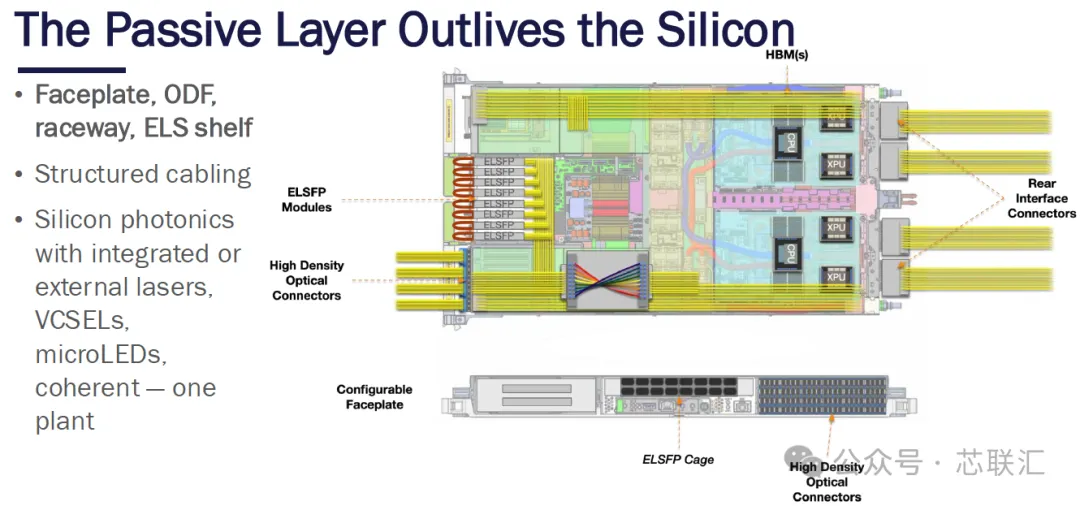
也就是說,ASIC、GPU/XPU和矽光晶片更新速度很快,但Faceplate、ODF、Raceway、ELS Shelf和Structured Cabling等被動光基礎設施應該擁有更長生命周期。
因此,無論未來採用整合雷射、外接雷射、VCSEL、MicroLED還是Coherent技術,都希望能夠運行在同一套Fiber Plant上。
進一步提出,未來72~144 XPU和1,024~1,152+ XPU的超高密度機架,可以採用相同External Interfaces,使資料中心能夠混合部署不同代際Rack,同時繼續使用同一套光纖基礎設施。
所以報告真正想解決的是AI資料中心光互連基礎設施的代際相容問題,而不只是某一代光晶片性能。
八、最大的產業問題:光互連目前仍然是“Walled Gardens”
技術並不是唯一障礙。
報告明確指出,當前Photonics Integration仍然高度Proprietary,產業協作不足,也缺少能夠擴展Supply Chain的大型開放生態。不同廠商往往需要重新解決Faceplate、Fiber、Laser和Service等問題。
因此Lightmatter把後半部分大量篇幅放到了Open Ecosystem。
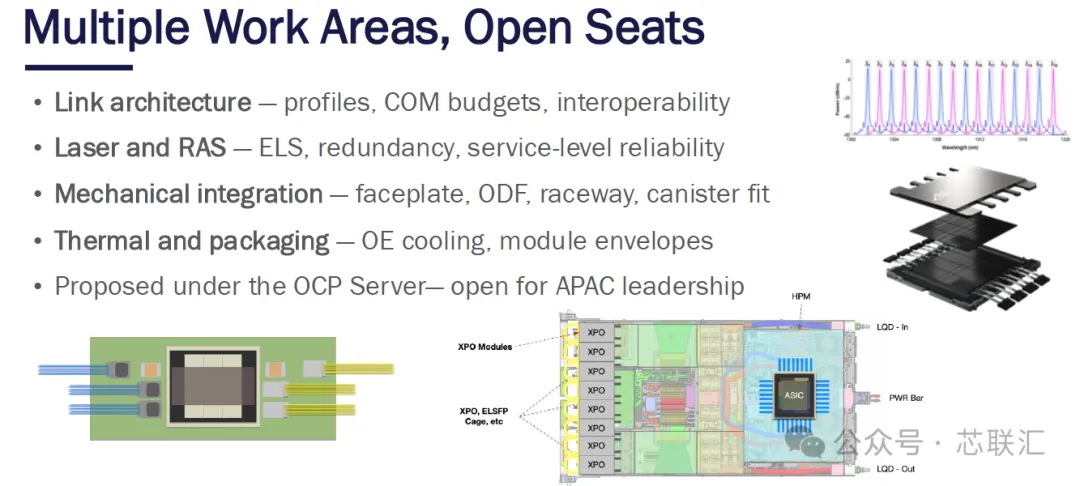
需要開放協作的內容包括Link Architecture、COM Budget、Interoperability、External Laser Source、RAS、機械整合、Faceplate、ODF、Raceway、Thermal以及Packaging等。
換句話說,未來矽光進入AI叢集的真正門檻可能不僅是“光晶片能不能做出來?”更重要的是“不同公司的光晶片、雷射器、連接器、封裝、交換機、伺服器和機架能不能真正組合在一起?”
🏁 小編總結
AI算力正在快速增長,但真正限制大規模AI叢集繼續擴展的瓶頸正在從Compute轉向Communication。傳統銅互連受制於傳輸距離、SerDes功耗、封裝邊緣I/O以及Switch/XPU Radix,越來越難以支撐數百乃至上千顆XPU組成的Scale-up Domain。Lightmatter因此提出以Silicon Photonics重新建構AI系統互連,通過CPO、NPO、XPO、CPX以及更高密度光學架構,將網路I/O從傳統封裝周邊擴展到更大面積,並進一步把Photonics深入Compute、Switch和Rack級架構;與此同時,通過開放介面、統一Fiber Plant、標準化機械/熱/封裝規範以及開放供應鏈生態,讓光互連從單一廠商的“Walled Garden”走向可互操作的Open Ecosystem。 (芯聯匯)