
9月15日前後,一個名叫Jev的新模型突然在矽谷AI開發者社區刷屏。
它顛覆了大家對當下大模型的認知,不會寫程式碼、寫文章甚至是聊天,主動砍掉了過去幾年大模型最重要的一項能力——生成文字,只保留“判斷”。TypeSafe給它的定義是:“Decisions, not strings”——要決策,不要文字。
給它一段資訊和幾個提前定義好的問題,它可以直接返回選擇、評分以及相應機率。例如收到一封客服郵件,Jev可以同時判斷應該分給那個部門、緊急程度、退款風險以及是否需要人工介入。
這個看起來更像“高級分類器”的模型很快獲得關注。Latent Space在9月16日的AI News中稱,TypeSafe發佈當天長時間位於Hacker News前列,創始人Diogo Almeida的發佈帖當時已有約420萬次瀏覽、近2萬次點贊。
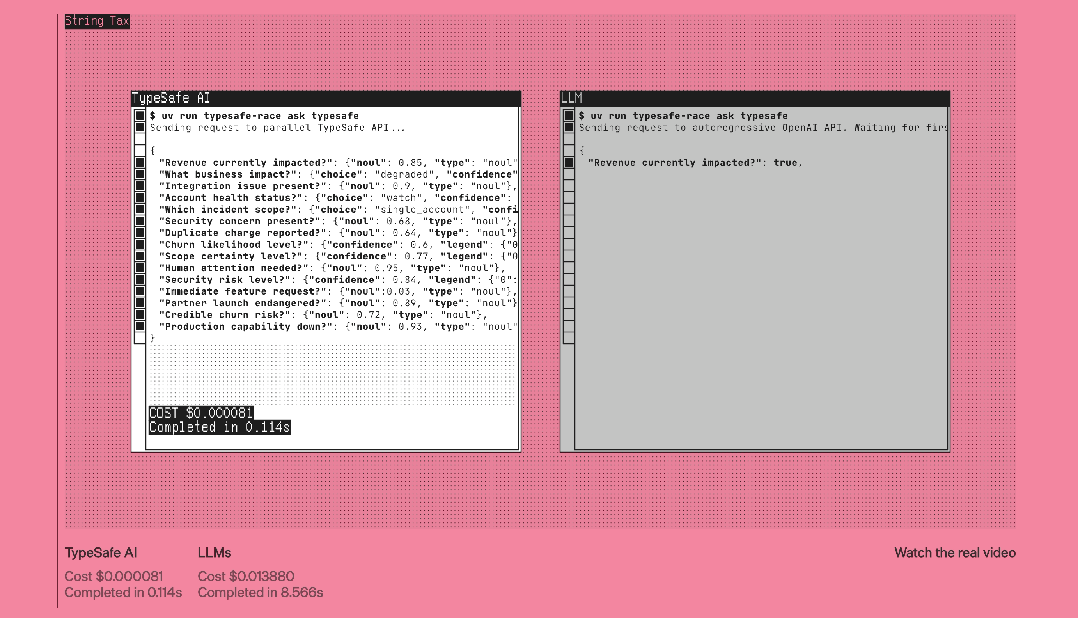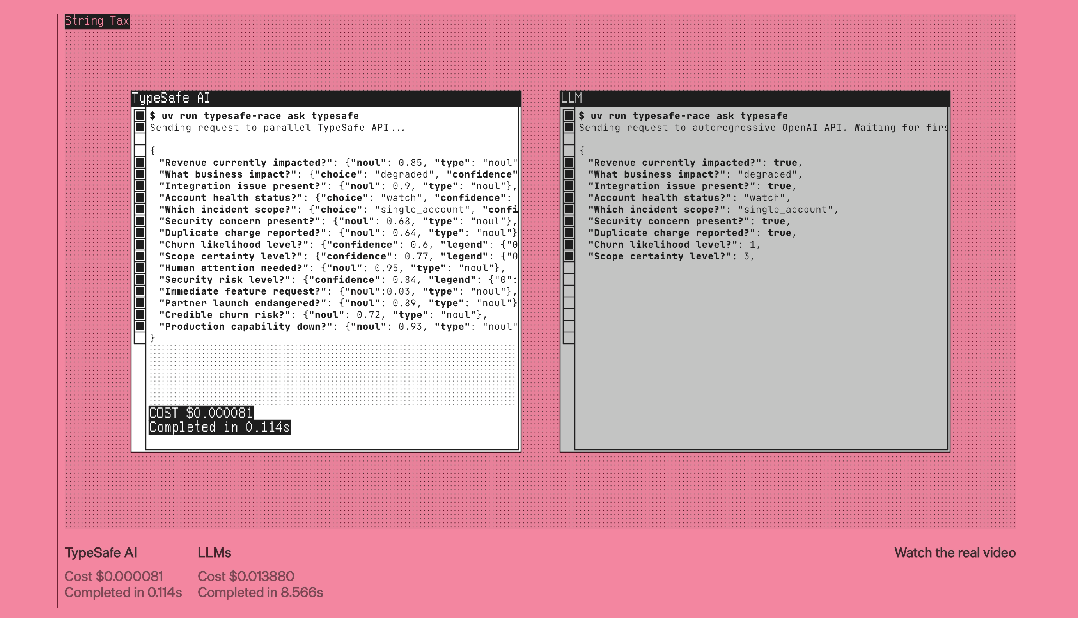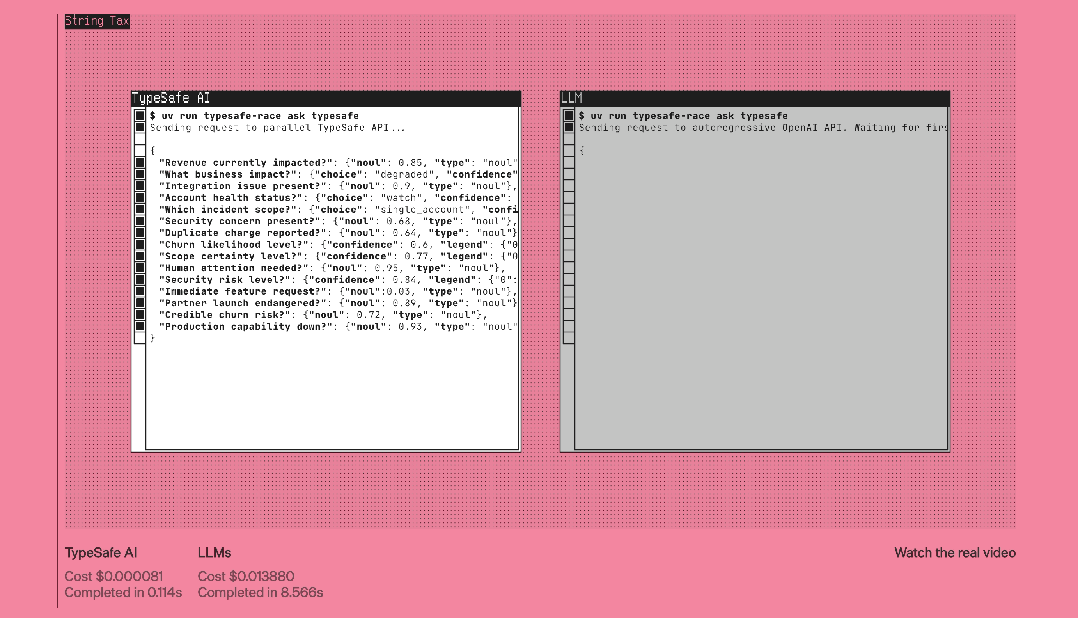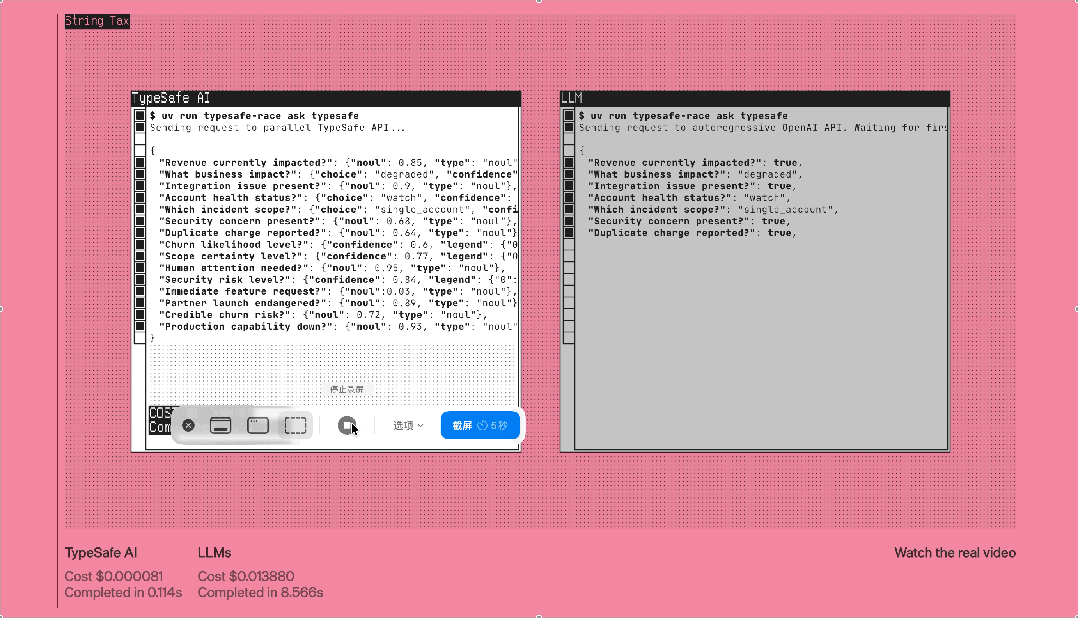
TypeSafe公佈的性能數字也很誇張:在特定工作流評測中,Jev最高比對照大模型快193.6倍、便宜444.6倍,端到端延遲70—500毫秒,輸入價格每百萬Token 0.042美元,輸出不按Token收費。
Jev背後的團隊同樣也是自帶流量。它來自剛剛走出隱身模式的舊金山創業公司TypeSafe AI,由Diogo Almeida、Erik Gafni和Sasha Sheng共同創立,剛完成DCVC領投的4000萬美元種子輪融資,Forbes援引知情人士稱估值約2億美元。
Almeida曾是OpenAI研究員,也是2022年InstructGPT論文的主要作者之一,參與建立了後來廣泛採用的RLHF訓練流程。OpenAI在GPT-4貢獻名單中也將他列入“Foundational RLHF and InstructGPT work”。
離開OpenAI後,Almeida稱自己花了兩年時間思考一個問題:如果大模型已經這麼聰明,為什麼世界上的大多數工作還沒有被自動化?
Jev可以看作他給出的第一個答案。
01 Agent真的需要每一步都“說話”嗎?
今天的大語言模型,本質上仍然是一台極其強大的Token生成機器。以一個電商Agent為例,它打開網頁後需要判斷下一步點選那個按鈕。常見做法是把網頁狀態交給GPT、Claude或Gemini,模型理解頁面後,以自回歸方式一個Token接一個Token生成答案,比如“根據當前頁面,我應該點選右下角的Checkout按鈕”。軟體隨後再從這段文字中提取Checkout,呼叫瀏覽器工具完成點選。
但從軟體系統的角度看,它真正需要的資訊可能只是“第三個按鈕”。
類似的情況大量存在於Agent內部:這個工單應該交給銷售還是售後,這筆交易風險高不高,搜尋出來的十條結果那個最相關。這些任務都需要模型具備語義理解和判斷能力,卻沒有多少開放式文字生成的必要。
Jev的目標就是這一部分工作。TypeSafe把它定義為“System One Model”,名字來自丹尼爾·卡尼曼《思考,快與慢》中的System 1——快速、直覺式判斷。
Jev這個名字則來自經濟學家William Stanley Jevons以及“傑文斯悖論”:一種資源的使用效率提高、成本下降之後,最終需求可能反而增加。TypeSafe希望同樣的事情發生在AI上,讓“智能判斷”足夠便宜後被大規模嵌入軟體。
Jev目前公開的基本輸出主要包括Choice、Score和Noul。
Choice負責在預定義選項中選擇,Score給出等級或連續評分,Noul處理yes/no判斷,同時輸出相應機率。例如一個風控系統可以讓Jev判斷某個使用者退款風險為低、中還是高,模型最終返回“高風險75%”。軟體拿到這個結果後,可以通過普通程式碼直接決定是否進入人工稽核。
從這個角度看,Jev很像一個擁有通用語義理解能力的“智能if語句”。這也是它與傳統分類器最重要的差別。
傳統分類器當然也可以判斷垃圾郵件、欺詐風險或者圖片類別,但每增加一種任務,往往需要重新定義資料、訓練或者微調模型。Jev希望把大模型已經獲得的通用知識和零樣本泛化能力保留下來,同時把輸出壓縮成軟體真正需要的選擇和機率。
這個需求在Agent時代明顯放大。一個複雜Agent任務內部可能發生幾十次甚至數百次模型呼叫,其中很多都屬於routing、classification、verification和狀態判斷。如果這些步驟全部交給完整的生成式大模型,模型不僅要理解問題,還要花時間生成一段最後不會被人閱讀的文字。這部分額外成本看起來確實沒必要。
02 新分類器?
這也是判斷Jev技術含量最關鍵的問題。
GPT、Claude、Gemini等大語言模型採用自回歸生成。模型先處理輸入,再根據此前所有Token預測下一個Token,一個句子因此必須按照順序不斷Decode。這樣的機制給予模型巨大的輸出自由度,它可以寫文章、生成程式碼、解釋原因,也可以進行複雜推理,但代價是生成過程具有順序性,輸出越長,需要執行的Decode步驟通常越多。
Jev主動限制了輸出空間。開發者提前規定可能的答案,例如refund_risk={low, medium, high},模型只需要判斷三個結果的機率,無需再生成“我認為這個使用者具有較高退款風險”這樣的自然語言。TypeSafe還宣稱Jev採用新的parallel sampler,可以在一次查詢中同時回答多個相互獨立的問題。例如處理一張發票時,同時判斷髮票類型、異常風險、審批等級和是否需要人工覆核。
這也是理解Jev效率數字的關鍵。
它和最近越來越受重視的Flash路線因此存在明顯區別。Google Gemini Flash、DeepSeek V4.1 Flash等模型依然屬於生成式LLM,通過架構、啟動參數、KV Cache和推理系統等方式降低每個Token的計算成本,解決“怎樣更快地生成Token”。
Jev是直接減少token。如果一個Agent完成任務需要100次模型呼叫,其中10次需要複雜規劃和自然語言生成,剩餘90次只是工具選擇、結果排序、風險判斷和任務狀態檢查,那麼全部呼叫同一種大型生成模型顯然存在最佳化空間。
未來更現實的Agent系統可能採用多層模型結構:複雜任務交給Frontier Model,普通推理交給Flash,路由、分類、驗證等高頻判斷交給Decision Model,確定性的部分繼續由傳統程式碼處理,Harness負責在這些能力之間調度。
這也是Jev最值得關注的產業意義,並不是“一切需要智能的地方都需要呼叫生成式LLM”。
03 零幻覺?
TypeSafe官網對Jev最醒目的宣傳之一是“Zero Hallucinations”。這句話容易讓人誤以為Jev解決了大模型長期存在的幻覺問題,但它只是能保證輸出不會超出預定義類型。
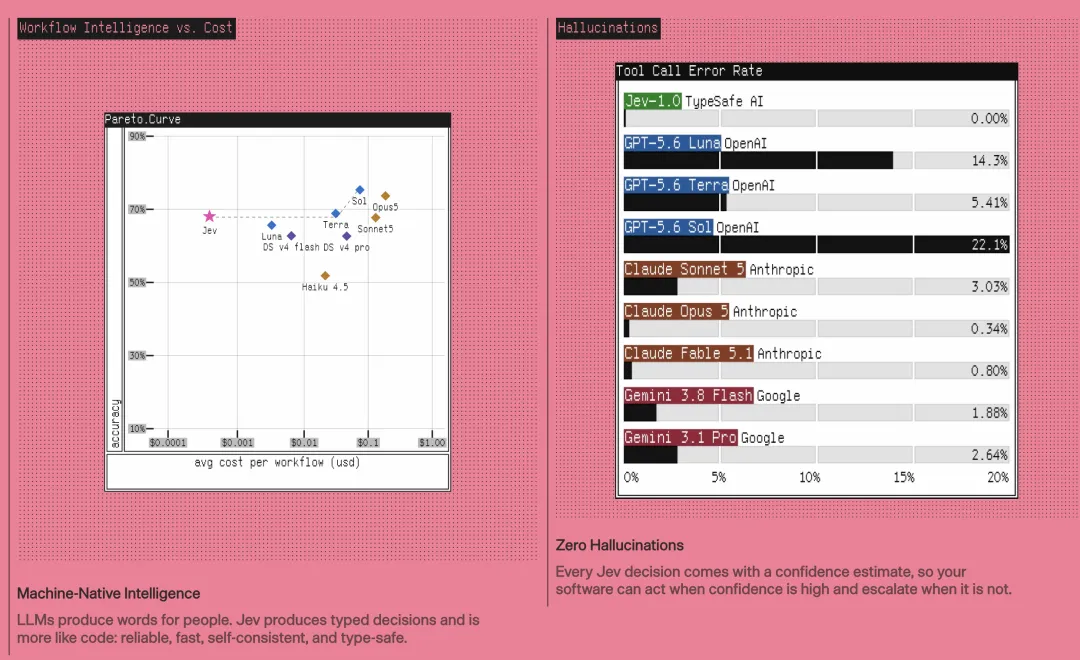
例如,開發者規定模型只能在“貓、狗、鳥”三個選項中選擇,Jev不會返回“大象”,也不會生成一段軟體無法解析的文字。
TypeSafe因此強調其type error可以做到0%。這對生產系統確實重要,尤其是在Agent自動呼叫API、修改資料庫和執行工作流時,結構化輸出越穩定,系統越容易接入後續操作。
但類型正確不等於判斷正確。如果輸入明明是一隻貓,模型卻返回“狗:97%”,它依然沒有發生type error,業務結果卻完全錯誤。因此,“Zero Hallucinations”更準確地說,是對輸出格式和類型的約束,目前沒有證據表明Jev消除了事實和判斷層面的錯誤。
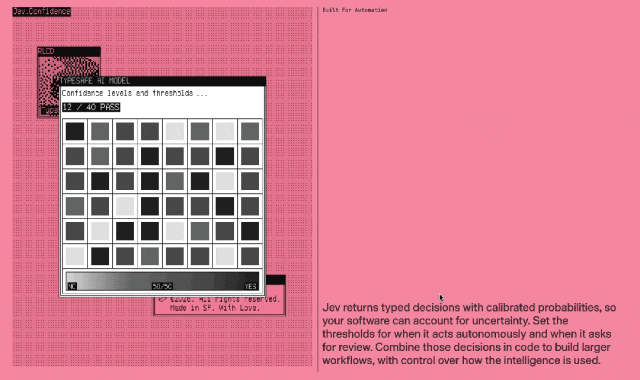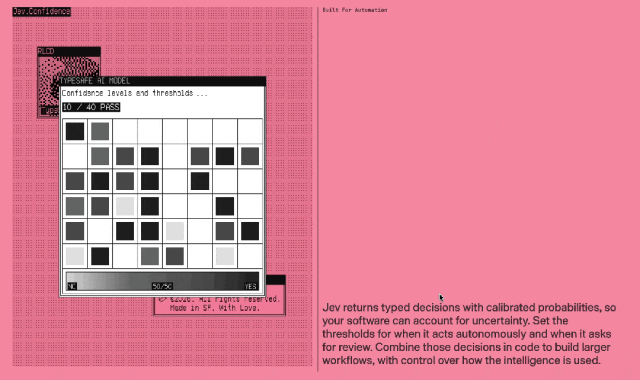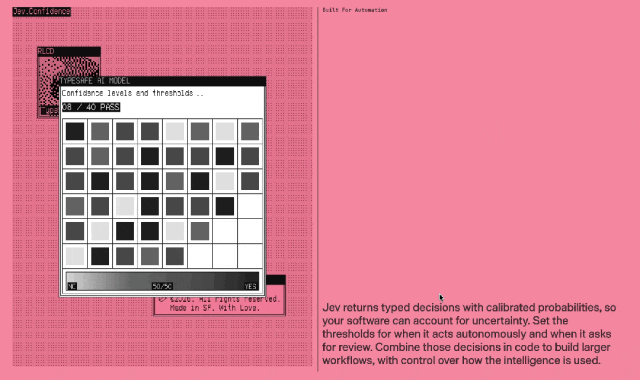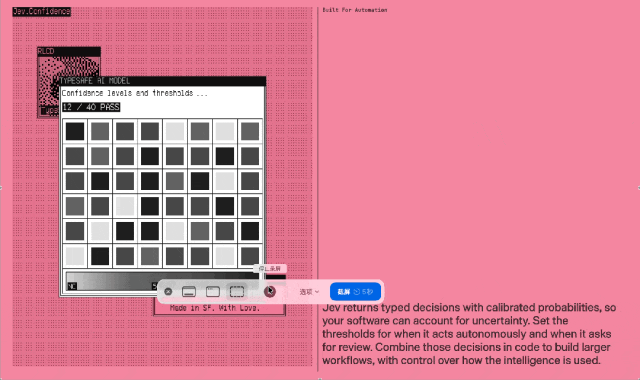
Jev更值得關注的部分,其實是TypeSafe提出的RLCD——Reinforcement Learning for Calibrated Decisions,即面向校準決策的強化學習。按照團隊的解釋,RLHF主要最佳化人類偏好,RLVR依賴可驗證獎勵提升數學、程式碼等任務能力,RLCD重點解決“模型說自己有多大把握,這個機率到底靠不靠譜”。
這對Agent進入生產環境尤其關鍵。假設一個模型實際判斷正確率只有80%,卻經常給出99%的置信度,那麼這個數字幾乎無法用於自動化決策。理想情況下,當模型對一批任務都給出90%的置信度時,其中大約90%應該判斷正確。只有做到這一點,企業才能建立穩定的分流機制:高置信度任務直接執行,中等置信度交給更強模型覆核,低置信度再轉給人工。
如果RLCD最終能夠被獨立驗證,它的實際意義很重要。一個校準良好的Decision Model,本身就可以充當Agent系統裡的路由器。
不過,TypeSafe目前尚未公開完整論文,也沒有披露參數規模、網路結構、訓練資料和足夠的消融實驗。外界因此還無法判斷RLCD究竟代表一種明顯不同的訓練範式,還是對強化學習、機率校準等已有方法的工程化組合。同樣,TypeSafe宣稱的parallel sampler和System One Model目前也缺少足夠細節,很難據此認定Jev已經完成了類似Transformer、Attention或MoE等級的基礎架構突破。
04 “193倍快、444倍便宜”?
Jev傳播過程中吸引眼球的還有一組性能數字。TypeSafe公佈的production-style workflow評測顯示,Jev在其設計的四類工作流上平均得分約67.8%,部分前沿模型大約在68%—74%區間;與此同時,Jev單個case的成本可以壓到約0.0004美元,響應時間約0.4秒。公司據此給出了最高193.6倍速度提升和444.6倍成本下降的資料。
這些數字完全不能簡單理解為“Jev擁有接近GPT的智能,同時快了193倍”。
首先,這些任務本身就是Jev最擅長的System One型任務,即分類、選擇、評分和判斷。讓一個專門為結構化決策設計的模型與通用生成模型比賽這類任務,本身就會放大Jev的優勢。其次,目前最完整的評測主要由TypeSafe自己完成,公司也承認測試任務由自己的model capabilities團隊設計,可能存在偏差;部分參考答案還來自強模型生成,而非全部使用人工標註的ground truth。
“193.6倍”和“444.6倍”也是特定任務、特定模型比較中的最大差距,並不代表Jev處理任何任務都能獲得這樣的提升。
它更能夠證明一個常識:如果任務最終只需要一個選擇或機率,那麼專門為判斷設計的模型確實有機會比完整的生成式LLM便宜很多。
更重要的是,Jev真正應該比較的對手也不只是GPT、Claude等昂貴前沿模型。今天的Flash小模型已經可以配合JSON Schema、Structured Output、Function Calling和Constrained Decoding返回結構化答案。傳統classifier以及embedding+classifier的成本還可能更低。
因此,一套真正有說服力的獨立測試,應該把Jev、Flash模型+Constrained Decoding、傳統分類器和Embedding分類器放進同一批真實生產任務,統一比較Accuracy(精準度)、Calibration(置信度校準)、Latency(延遲)、Cost(成本))、OOD Robustness(分佈外魯棒性)和Batch Scaling(批處理擴展能力)。目前看來,還沒有這類測試。
噱頭大於實質,還是真的創新?社區已經吵成一鍋粥。
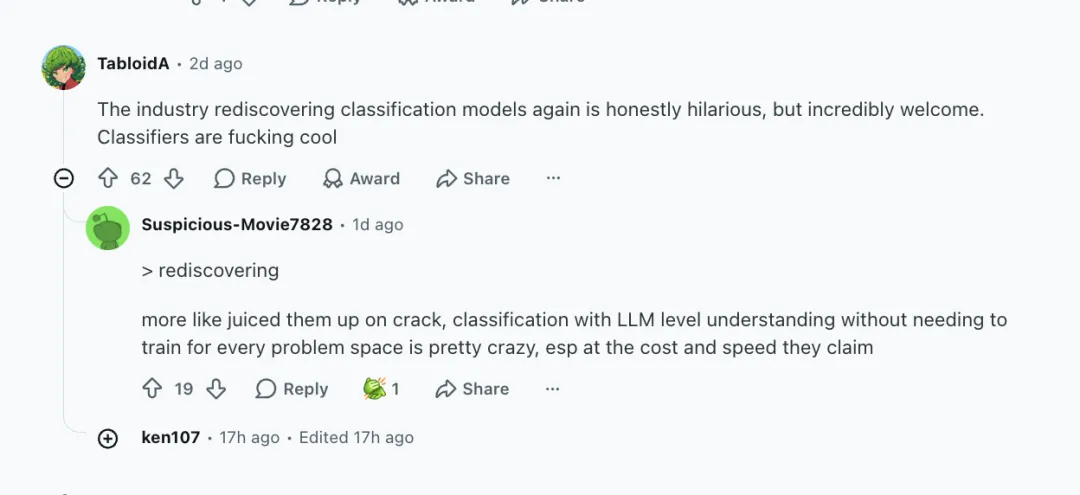
Jev確實提出了一個基於Agent範式的痛點:AI的“智能”是否一定要通過高資源消耗的語言生成來完成。還有沒有更好、更靠譜、更高效的方式?
不過,也有開發者直接對騰訊科技說:“那有這好事兒?” (騰訊科技)