
人可以走進一間陌生的屋子,立刻開始幹活,我們基於對物理世界的認知,能夠在不同環境之間遷移,但讓機器人做到這點卻很難。
所以關於“具身智能的ChatGPT時刻”, 宇樹科技王興興曾提出一個衡量標準是,在80%的陌生場景中,通過語音或文字指令,機器人能夠順利完成大約80%的任務。
現在,這個目標被Figure初步摸到了門檻。
今天,Figure公司推出最新一代神經網路模型Helix 2.5,能夠讓人形機器人進入不同陌生環境實現長時序的全身協同作業。
人形機器人能否走進一間從未見過的房間,依靠全身自主控制,立刻投入工作?為驗證這一點,該團隊使用自建的面向全球的人類行為資料集Index對Helix 2.5開展預訓練。
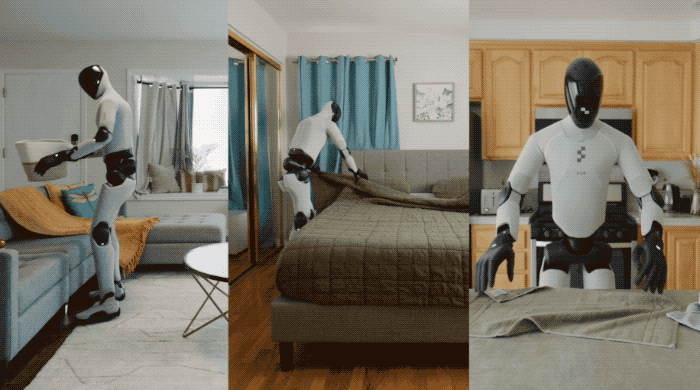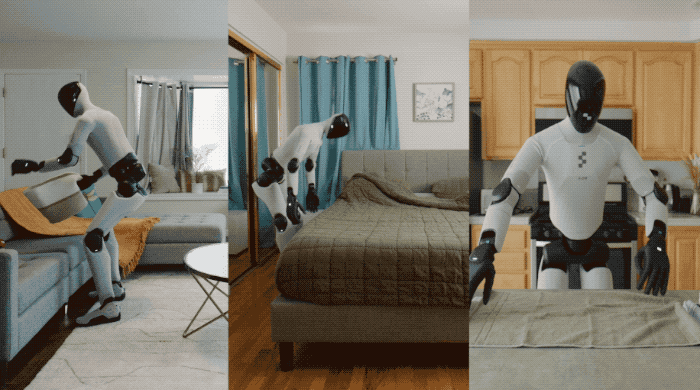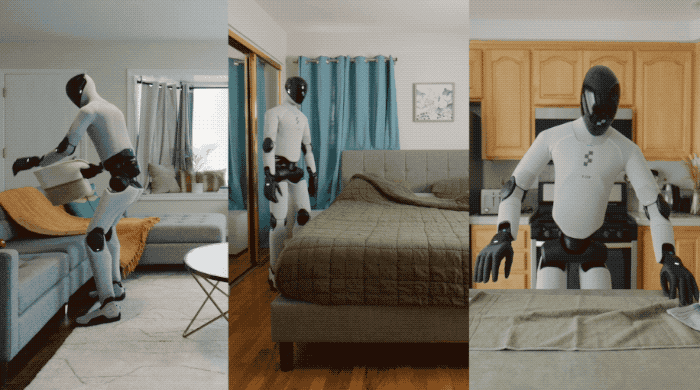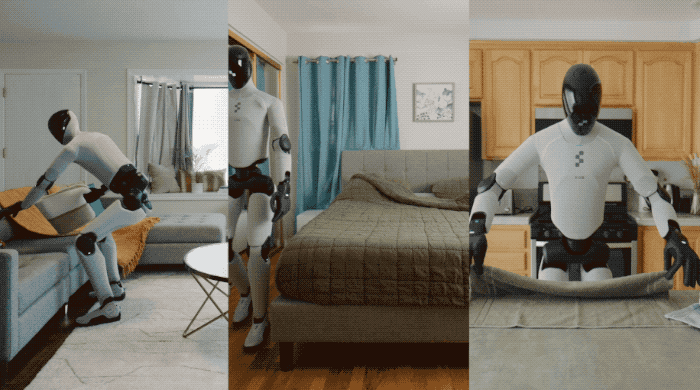
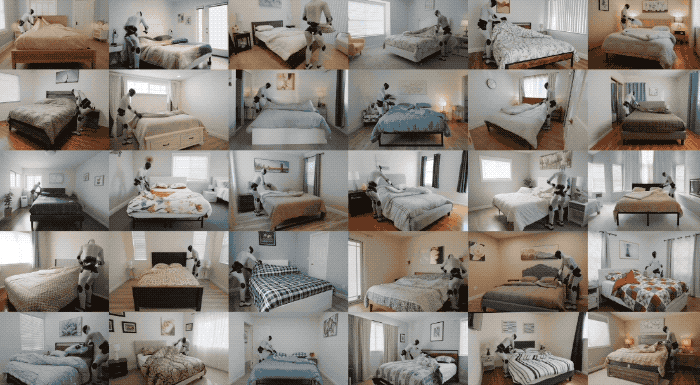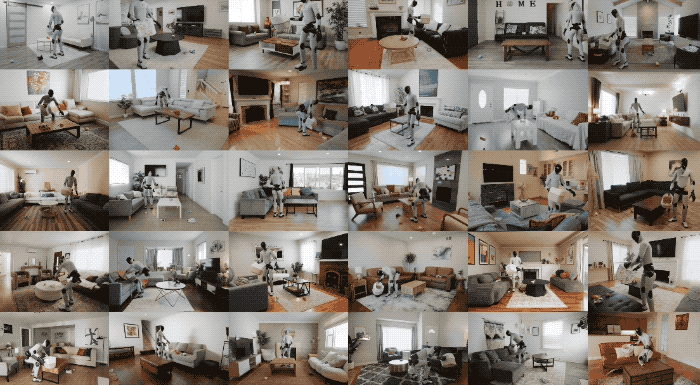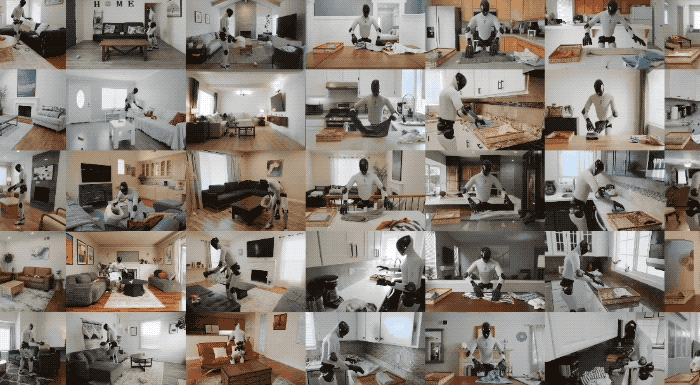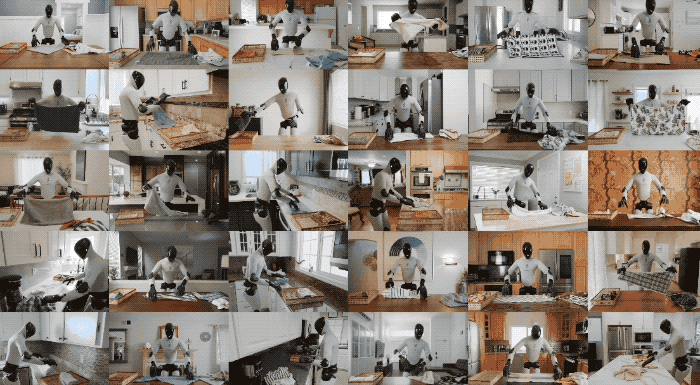
基於這個基礎模型,Figure機器人實現了三類作業能力:整理客廳、摺疊毛巾以及鋪床。隨後,該團隊將機器人帶到舊金山灣區的30戶家庭中,這些家庭沒有採集過任何前期資料,但絲毫不影響Figure機器人的幹活兒能力。
官方稱,這是人形機器人首次在該規模下完成零樣本全身泛化驗證,同時也證明:全身智能可以從人類行為經驗中學習,並遷移至全新場景,而不必每換一個環境就重新搭建整套能力。
Helix 2.5可在這30個從未見過的住宅環境裡完成三項長時序任務,全程無需在這些場景、操作對象上採集資料、微調模型或做環境適配。
Index預訓練是泛化能力的核心。在保持任務專屬資料、模型架構、訓練方式與評估方案不變的前提下,僅依靠Index預訓練,就將零樣本任務成功率提升數倍。
大部分機器人泛化相關研究,環境都是專門給機器量身打造的。桌面機械臂只能在固定範圍內幹活;輪式機器人需要足夠空曠的地面,才能移動和轉彎,但家裡的環境不會遷就機器人。
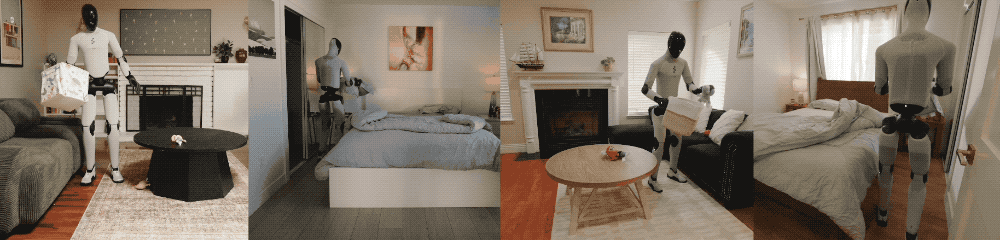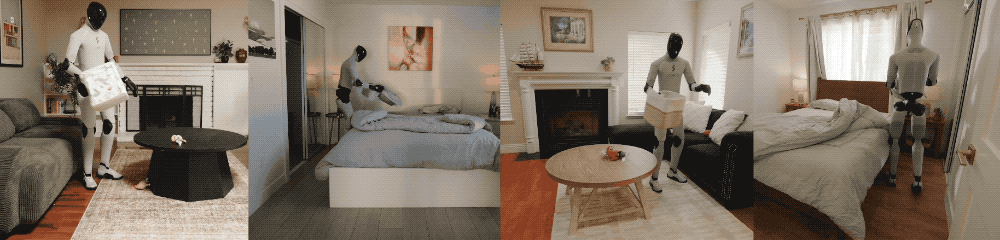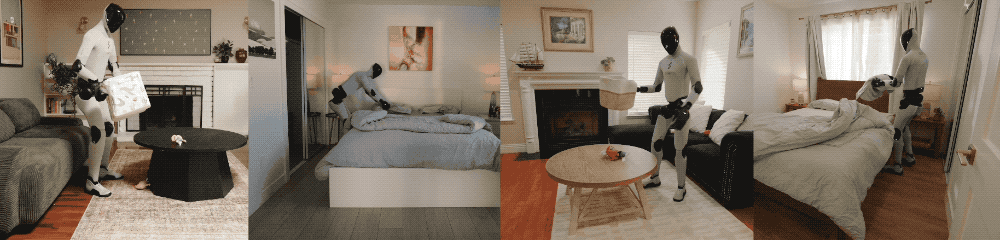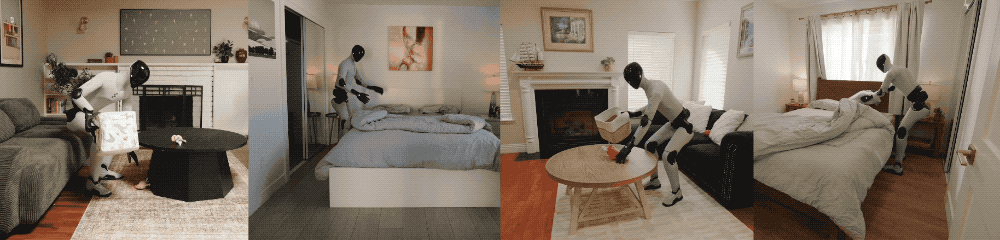
人形機器人必須一邊幹活一邊移動,調整自己的身體姿勢,在狹小雜亂的空間裡觀察、伸手、操作物品,而別的形態機器人並不能很好滿足。
零樣本泛化進一步提高了難度。機器人在訓練期間從未見過房間、佈局或物體,到達目的地後也無法進行適應,它必須利用已有的知識來解決完整的感知和控制問題。
Helix 2.5能做到零樣本幹活,能力主要來自Index預訓練,還是單純靠任務專屬訓練資料?
Figure官方做了對照實驗。用一模一樣的任務專屬資料訓練兩套策略模型,這些資料裡完全沒有測試用的家庭場景和物品。一套模型權重隨機初始化,另一套基於經過Index預訓練的Helix 2.5模型起步。Helix 2.5本身完全在Index上從隨機初始化開始預訓練,而上代模型Helix 02則從預訓練的視覺語言模型開始。
結果顯示,Helix 2.5的零樣本能力,絕大部分來自Index預訓練。在盲測裡,從零訓練出來的策略,零樣本任務成功率只有9%;經過Index預訓練的模型成功率達到56%,是前者的6倍多。
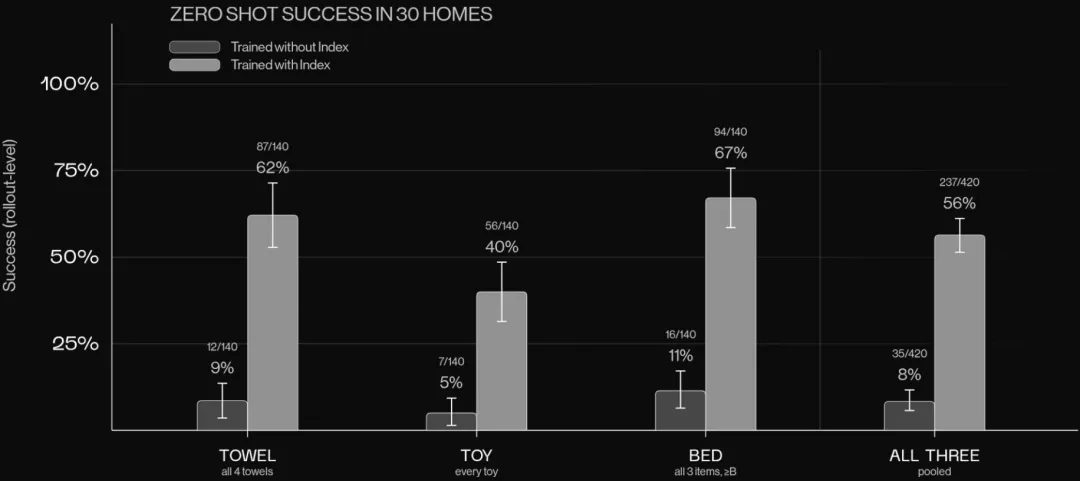
任務成功的標準是完整做完整件事:所有物品收拾妥當、每條毛巾摺疊完成、整張床鋪整理好,不接受只完成一部分的情況。預訓練資料覆蓋面很廣,目的是支援後續隨便微調,實現各類動作,但本次測試裡的任何一項任務,在Index預訓練資料集裡佔比都不超過1.90%。
兩組結果的差距,直接衡量預訓練帶來的提升效果:同樣一份任務訓練資料,如果模型已經學習過大量人類行為經驗,遷移到新場景的效果會強得多。
此外,把Helix 2.5和老版本Helix 02在同一套任務模型中做對比。Helix 02的訓練資料,是直接在它測試的那個環境裡採集的;而Helix 2.5,只用一半的適配資料,就能達到和Helix 02一樣的任務成功率,打造通用性更強的動作,所需資料減半。
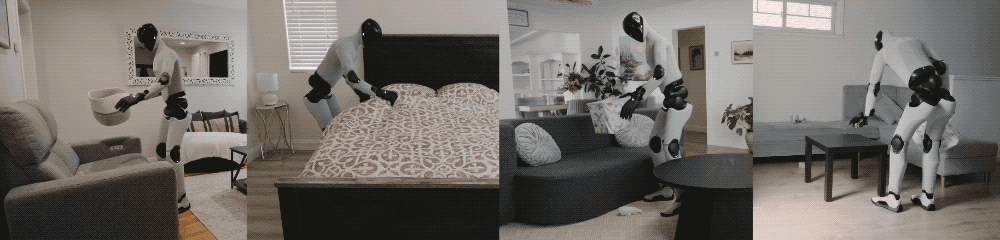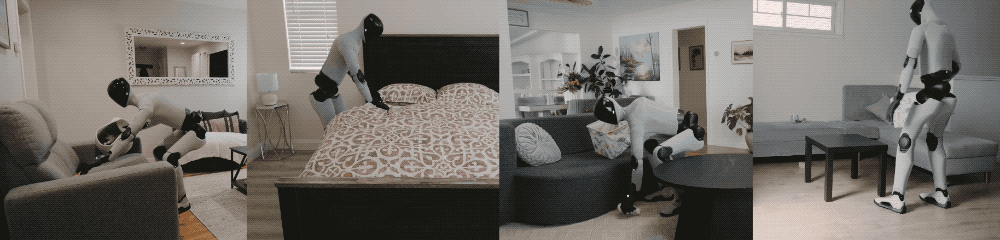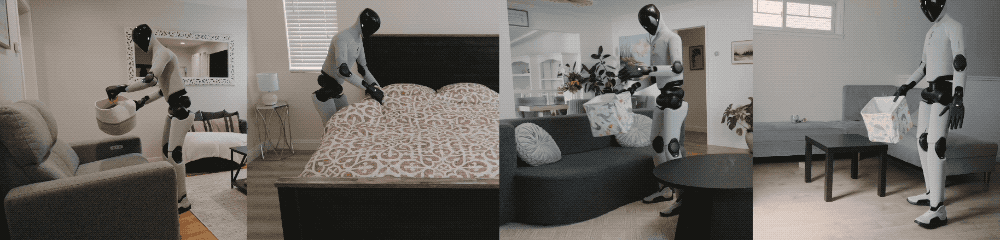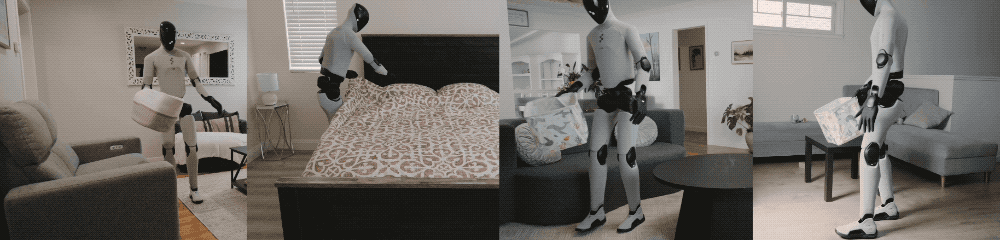
Helix 2.5還有個很亮眼的新能力:可以自己發現問題並調整。比如往後退一步重新站位、換個姿勢,或是繞著床走動,修正鋪床動作,具備出問題後自行補救、繼續完成任務的能力,有點“自進化”的感覺。
縮放定律徹底改變了大語言模型的研發,從人類行為到機器人的遷移學習,是不是也符合類似的規律?
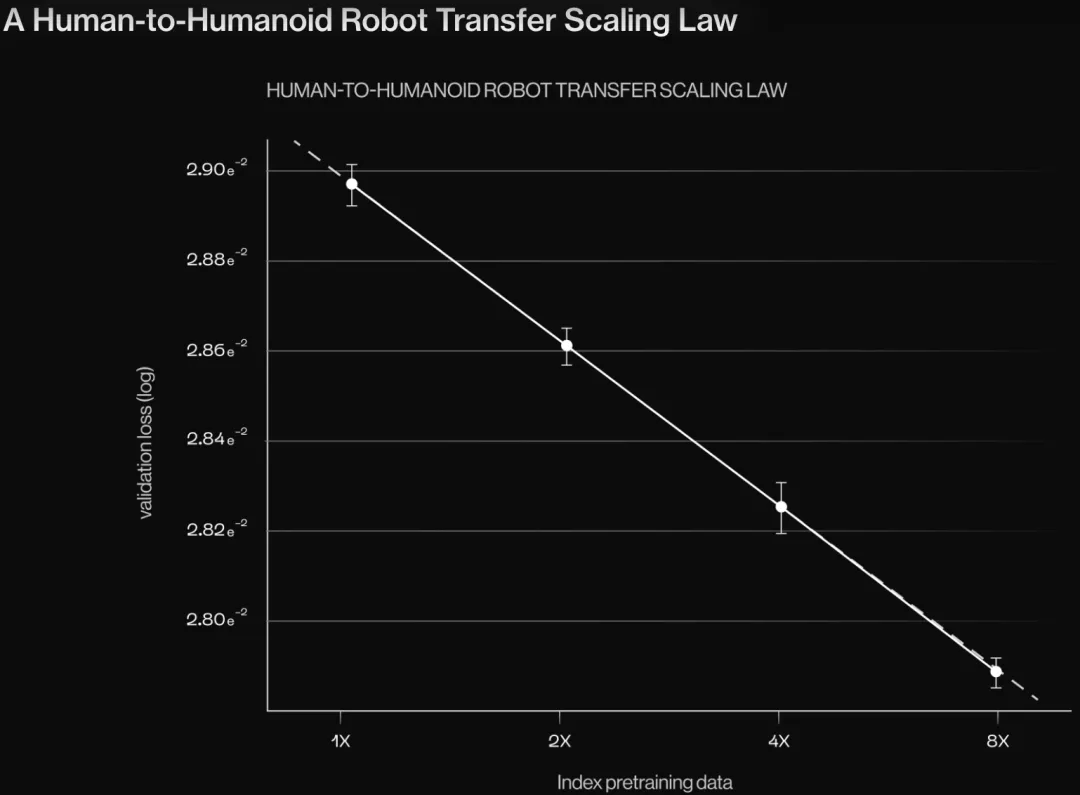
Figure團隊用Index資料集裡大小逐級擴大的4個子集訓練模型,預訓練資料總量最多擴大8倍;模型大小、後續任務訓練條件全都保持不變。所有模型都用同一套任務資料做微調,並在同一組預留測試集上評估動作預測損失。
實驗發現,每把Index訓練資料翻一倍,損失值就會按規律下降,Index預訓練可以穩定提升模型對機器人下一步動作的預測能力。
目前Index資料集每秒大約會新增35分鐘的人類行為資料,而Helix 2.5的結果證明,更多的資料與算力,將直接讓機器人在踏入陌生家庭之前,就掌握更多現實世界的物理常識,Figure官方表示,現在正是擴大規模的時刻。
人形機器人進入家庭的商業模式會是什麼?Figure首席執行長Brett Adcock曾表示,可能會是面向家庭使用者的租賃方案,例如以每月約600美元的價格租賃一台Figure 03,讓機器人在家裡幫忙干家務。
除了持續增長的Index資料集,本月初,Figure也與Nscale達成合作,將斥資35億美元在德克薩斯州巴斯托部署NVIDIA Vera Rubin平台,該平台將搭載多達10萬個GPU,計畫於2027年下半年開始初步部署,完成Helix進化所需的資料和計算能力的部署。
當前,具身智能技術演進路徑各不相同,Helix 2.5邁出的這一步,不只是一次技術演示,也是為家庭人形機器人的未來,驗證了一套全新的訓練範式。
當資料和算力持續加碼,未來的人形機器人或許不需要為每一個陌生環境單獨訓練,走進家門,它們就能自適應上手幹活。 (頭部科技)