
從AICC2026看智能體如何重構算力底座
當智能體(Agent)從“回答問題”走向“解決問題”,當單次推理變成持續互動,支撐AI運行的算力正在從“技術資源”升級為“國家戰略基礎設施”。 9月21日,AICC2026人工智慧計算大會在北京中關村國際創新中心舉行,浪潮資訊首席AI戰略官劉軍在主論壇發表《Agent時代的AI計算架構挑戰和創新》演講,核心判斷只有一個: Agent不是模型能力的簡單疊加,而是對AI計算架構的系統性挑戰。 它要求基礎設施同時支撐更高水平的智能能力突破,以及更大規模、更低成本的智能供給。
資料錨點:IDC與浪潮資訊聯合發佈的《2026中國人工智慧計算力發展評估報告》顯示,2026年中國智能算力規模預計達2576.5 EFLOPS,同比+87.9%;全球活躍智能體數量將從2026年的7940萬增長至2030年的22.16億,年複合增長率129.8%,而同期全球Token消耗量複合增長率高達4822.6%——約為智能體數量增速的37倍。
一、開篇:Agent正在重構AI計算的需求範式
1.1 從“單次推理”到“持續互動”
傳統大模型推理的負載畫像非常簡單:一個使用者輸入一段prompt,模型輸出一段文字,過程結束。其性能最佳化目標也單一:在固定Batch Size下最大化token吞吐、最小化首token延遲(TTFT)與每個token間延遲(TBT/TBT)。
Agent的工作方式完全不同:它需要在多輪對話中保持上下文,根據環境反饋反覆呼叫工具,在執行過程中動態生成新的執行圖,並可能與其他Agent協作完成長程任務。每一次“響應”都不再是終點,而是下一輪推理的起點。這意味著:
- KV Cache不再是一次性消耗品
而是需要在多輪之間被持續保留、共享、分支復用的狀態資產; - 執行圖不再是靜態的
工具呼叫的結果會反向改變下一步要生成的token結構; - 延遲與吞吐的權衡被重塑
使用者等待的是“任務完成時間”,而非“首token時間”。
1.2 三類典型Agent場景的算力特徵
這三個場景把負載從“單一模型、單次生成”拉伸為“多模型協同、長上下文保持、動態執行圖展開”。傳統面向靜態批處理的計算架構開始系統性失配。
核心論點
Agent時代的競爭,不再是“誰的模型參數量更大”,而是“誰能在可控成本內,持續、穩定、低延遲地生產出有效任務結果”。這要求從晶片、記憶體、網路、散熱到調度層的全端重構。
二、挑戰一:從“靜態計算”到“動態編排”——推理引擎的範式遷移
2.1 傳統推理框架的設計假設
vLLM與TGI等主流推理框架的最佳化基點是:固定prompt、單次生成、KV Cache隨請求結束而釋放。vLLM的PagedAttention將KV Cache切分為固定大小的塊(block),像作業系統管理虛擬記憶體一樣按需分配,顯著降低了視訊記憶體碎片,提升了並行度。
這套假設在批處理、短互動場景下表現優異。但當Agent成為主要負載,三個失效點逐一暴露。
2.2 失效點之一:多輪對話與前綴共享
在Agent會話中,80%–95%的輸入token是重複上下文——系統提示(system prompt)、工具模式、前幾輪對話。傳統框架每輪重新計算這些前綴的KV Cache,造成大量冗餘算力。
SGLang提出的RadixAttention將KV Cache組織成基數樹(Radix Tree),自動識別不同請求之間的最長共享前綴,實現任意深度的跨請求復用。相比vLLM的塊級前綴快取,RadixAttention在分支化、多輪對話場景下命中率更高。RadixAttention論文(arXiv 2312.07104)報告,在重前綴負載下吞吐最高可提升6.4倍。
2.3 失效點之二:工具呼叫與執行圖動態展開
Agent的工具呼叫輸出通常是結構化JSON。傳統框架依賴正規表示式或FSM進行語法約束,逐token校驗,導致大量時間消耗在“可預測token”的生成上。SGLang的壓縮FSM + Jump-Forward解碼可以一次性跳過結構符號,直接生成下一個語義token。在結構化JSON抽取任務中,SGLang可較vLLM標準FSM快約180%。
2.4 失效點之三:長上下文與記憶體牆
PagedAttention解決了視訊記憶體碎片化問題,但沒有改變KV Cache隨上下文長度線性增長的根本事實。當分析Agent需要處理10萬甚至百萬token上下文時,HBM容量與頻寬成為硬性瓶頸。這推動了KV Cache offload、PD(Prefill-Decode)分離、MLA/NSA等注意力壓縮等方向的發展。
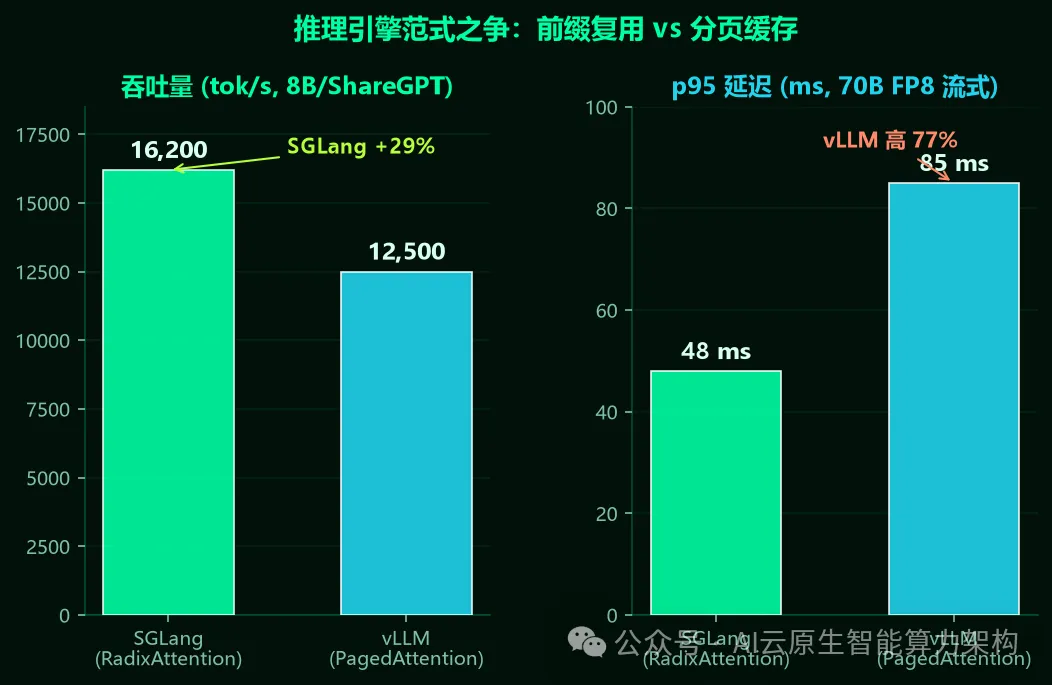
判斷:未來的推理基礎設施不會是“vLLM或SGLang二選一”,而是根據負載特徵動態路由:前綴密集、低延遲、工具呼叫繁重的Agent路徑走SGLang;大Batch、獨立請求、吞吐優先的批次任務走vLLM。架構師需要設計的是一個能感知負載形態的智能閘道器,而非單一引擎。
三、挑戰二:從“單一模型”到“多模型協同”——異構計算的調度難題
3.1 Agent工作流中的模型組合
一個典型Agent工作流往往由多個模型組成: 大模型負責決策與意圖理解, 小模型負責分類、抽取、路由等感知任務, 專用模型(程式碼、視覺、多模態)負責具體技能, 外部API與工具負責執行現實世界的動作。
這種組合對異構算力池提出了前所未有的要求:不同模型精度(FP8/FP16/INT8)、不同視訊記憶體佔用、不同批處理特徵、不同延遲要求被混合部署在同一叢集中,而Agent的端到端延遲由最慢的一環決定。
3.2 異構算力池化的三大挑戰
3.3 架構創新方向
- 統一推理調度層:遮蔽底層引擎差異,根據請求特徵(前綴長度、結構化需求、延遲SLO)自動路由到vLLM/SGLang/專用推理節點。
- 動態批處理策略:不同模型採用不同Batch窗口:小模型激進合併,大模型按優先順序搶佔,避免“大模型等 Batch 空轉,小模型排隊餓死”。
- 模型路由與快取協同:小模型結果、工具返回、知識庫片段應被快取並復用,減少重複推理。推理叢集正在成為“智能快取系統”。
四、挑戰三:從“離線訓練”到“線上進化”——計算架構的反饋閉環
4.1 Agent的自我迭代特性
Agent的價值閉環是:執行結果 → 反饋 → 策略更新 → 重新推理。一旦Agent進入生產環境,它會產生大量“推理—行動—結果”三元組。這些資料的密度和即時性遠高於傳統訓練資料。
4.2 傳統架構的斷點
當前多數企業的訓練與推理是兩套基礎設施:訓練叢集負責週期性訓練,推理叢集負責線上服務。Agent反饋資料要先離線落盤、再經過ETL、再啟動訓練任務,週期以“天”或“周”計。這與Agent需要的“分鐘級”甚至“秒級”迭代節奏嚴重脫節。
4.3 創新架構要素
- 線上微調/增量學習的算力預留:推理叢集需預留一部分彈性算力用於LoRA/DORA等低秩增量更新,使模型能在不中斷服務的前提下吸收新反饋。
- 推理資料回流到訓練的高效通道:從推理日誌、工具返回值、使用者反饋到訓練樣本的轉化應自動化,避免人工資料標註成為瓶頸。
- “推理—反饋—最佳化”的分鐘級閉環:未來 Agent Infra 的關鍵指標不是單純吞吐,而是“從一次失敗執行到策略修復”的平均時間(MTTR for Agent policy)。
4.4 案例參考
智譜 Infra Agent:智譜披露的GLM-5.3驅動的Infra Agent案例極具代表性。在超過10萬卡國產AI加速器組成的叢集上,該Agent參與搭建GLM-5.3-Flash的生產級推理服務。核心發現是: “真正卡住Agent的不是寫程式碼,而是改完之後拿到的反饋太粗。” 團隊因此建立了“稠密反饋”機制:把正確性測試、運行日誌、執行Trace、微基準、執行階段事件和端到端指標全部納入迭代流程,使Agent能在算子精度漂移、KV Transfer並行瓶頸、重複計算等局部問題上快速定位。最終,該系統在不到兩週內從首次運行到生產就緒,端到端吞吐提升至初始基線的約3倍。
Astra多Agent系統:NeurIPS 2025的Astra系統為GPU Kernel最佳化設計了四個專門Agent:Testing Agent負責正確性驗證,Profiling Agent負責性能測量,Planning Agent提出最佳化建議,Coding Agent生成新Kernel。它們形成一個“計畫—編碼—測試—分析”的自我最佳化循環,在SGLang的三個核心Kernel上取得平均1.32倍加速,最高達1.46倍。這個案例說明:Agent不只是上層應用,它正在反作用於底層計算架構本身。
五、創新方向一:存算一體與近存計算——打破記憶體牆
5.1 HBM頻寬瓶頸的量化分析
Agent場景下,KV Cache讀寫成為視訊記憶體頻寬的主要消耗者。以長上下文分析Agent為例,每生成一個token都需要訪問全部歷史KV Cache,訪存量隨上下文長度線性增長,而HBM頻寬增長卻遠慢於算力。
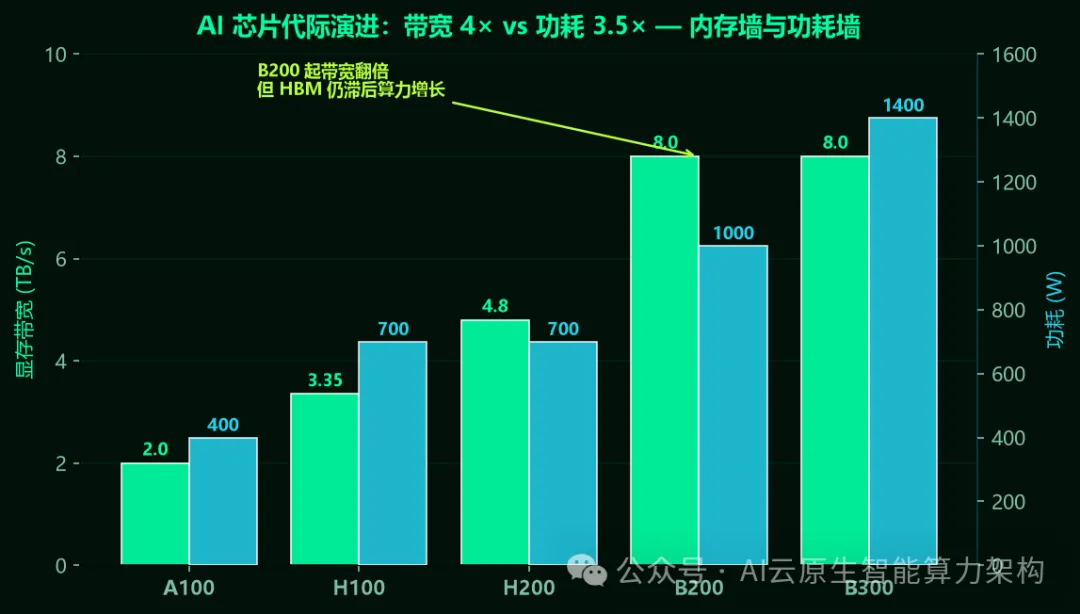
從A100到B300,單卡功耗從400W升至1400W,而視訊記憶體頻寬僅從2.0 TB/s增至8.0 TB/s—— 功耗翻了3.5倍,頻寬僅翻了4倍。 在推理負載中,算力往往受限於“資料搬運速度”而非“FLOPS”。這就是記憶體牆。
5.2 技術路線對比
5.3 產業化進展
AICC2026主論壇上,清華大學副校長吳華強將圍繞憶阻器存算一體技術發表演講,探討其如何突破傳統AI計算體系結構瓶頸。國內企業也在加速: 後摩智能、知存科技、蘋芯科技等公司已推出面向邊側和雲端推理的存算一體晶片;曦智科技的光子計算互連方案則從網路層面緩解記憶體牆。
對Agent架構而言,存算一體的最大價值不是峰值算力,而是“在儲存之處完成KV Cache讀寫和注意力計算”,從根本上降低多輪狀態保持的能耗和延遲。
六、創新方向二:Chiplet與3D封裝——算力密度的物理突破
6.1 單體晶片的物理極限
當單顆AI晶片的電晶體數量逼近光刻與良率極限,功耗牆、散熱牆、良率牆同時顯現。單晶片面積越大,製造成本呈指數級上升;片上HBM控製器和IO單元擠佔計算面積;長距離互連導致延遲和能耗增加。
6.2 Chiplet的解題思路
Chiplet將“計算芯粒、儲存芯粒、IO芯粒”按各自最優工藝節點分別製造,再通過先進封裝組合。這樣既能用成熟製程生產IO/儲存,又能用先進製程生產計算核心,在成本與性能之間取得新平衡。
國內北極雄芯由清華大學姚期智院士孵化,其基於3DIC+Chiplet的Polar Stack系列已回片點亮;其QM935系列Chiplet異構整合的AI Box可支撐端側大模型應用。
6.3 3D堆疊的頻寬紅利
硅通孔(TSV)和混合鍵合技術使多個裸片在垂直方向堆疊,互連長度從毫米級降至微米級。據行業估算,採用3D堆疊封裝的AI晶片,片間互聯頻寬可達傳統2.5D封裝的6倍,延遲下降約70%,整叢集訓練效率可提升2倍以上。
6.4 對Agent架構的意義
多模型協同的Agent系統對“計算—儲存—互連”的整合密度要求極高。Chiplet+3D封裝讓“儲存芯粒緊貼計算芯粒”成為可能,使KV Cache與啟動值的搬運距離最短化,為多模型異構整合提供了物理基礎。
七、創新方向三:液冷與全端散熱——算力可持續的基礎設施
7.1 AI算力功耗的指數級增長
輝達GPU單卡功耗從A100的400W,到H100的700W,再到B200的1000–1200W,B300約1400W;而下一代Rubin/R300功耗預計突破1800W甚至4000W。 五年間,單晶片功耗漲幅超過四倍。
機櫃功率密度隨之水漲船高:傳統風冷機櫃20–30kW已難以為繼,GB200 NVL72機櫃可達130–250kW,華為昇騰384超節點總功耗達559kW。風冷在物理層面已觸及天花板。
7.2 液冷的技術要點
7.3 經濟賬:PUE下降與TCO最佳化
2026年被行業視為液冷放量元年,機構預測全球智算中心液冷市場規模將達1147億元,同比增長273%。國內液冷滲透率從2021年的不足3%升至2025年的20%,2026年預計達37%,2027年有望突破50%。
從TCO角度看,液冷帶來的電費節省與空間節省可在1.5–2年內收回額外投資。京東雲算力中心通過冷板式液冷將PUE從1.3降至1.1;常州移動資料中心每年節電約600萬度。對高密度AI叢集, 液冷已從“可選項”變為“必選項”。
八、創新方向四:開放超節點與國產算力底座
8.1 千卡/萬卡叢集的通訊瓶頸
在千卡、萬卡規模下,網路通訊時間佔總訓練時間的比例急劇上升。分佈式訓練中的All-Reduce、All-to-All等集合通訊對頻寬、延遲、無損傳輸提出了極高要求。RDMA已成剛需,但實現方式分兩大陣營:
輝達官方基準顯示,大規模訓練中RoCE吞吐可比InfiniBand低10%–15%。但對多數企業級智算中心而言,RoCEv2在成本和通用性上仍是更務實的選擇;當規模邁向萬卡、且對延遲極度敏感時,InfiniBand仍是首選。
8.2 開放超節點標準的意義
“超節點”通過Scale-up高速互聯將多塊GPU/NPU組成統一記憶體域。浪潮資訊在AICC2026期間發佈新一代超節點AI伺服器與多元算力機組,強調通過開放多元架構與軟體演算法協同,支撐智能體時代的規模化推理。
開放超節點標準的意義在於: 解耦硬體與軟體,避免單一廠商鎖定; 統一互聯協議,使不同廠商的晶片、網路卡、交換機可以互操作; 降低生態遷移成本,讓國產晶片更快融入主流AI框架。
8.3 國產AI晶片的生態突圍
國產AI晶片正從“單卡性能追趕”走向“叢集效率最佳化”。華為昇騰910B在FP16算力(約376 TFLOPS)、視訊記憶體頻寬(1.6 TB/s)、互聯頻寬(HCCS 392 GB/s)等硬指標上與H100存在差距,但其通過 CloudMatrix 384超節點等系統級方案,將384顆910C晶片整合為大規模計算單元,實現叢集級性能補償。
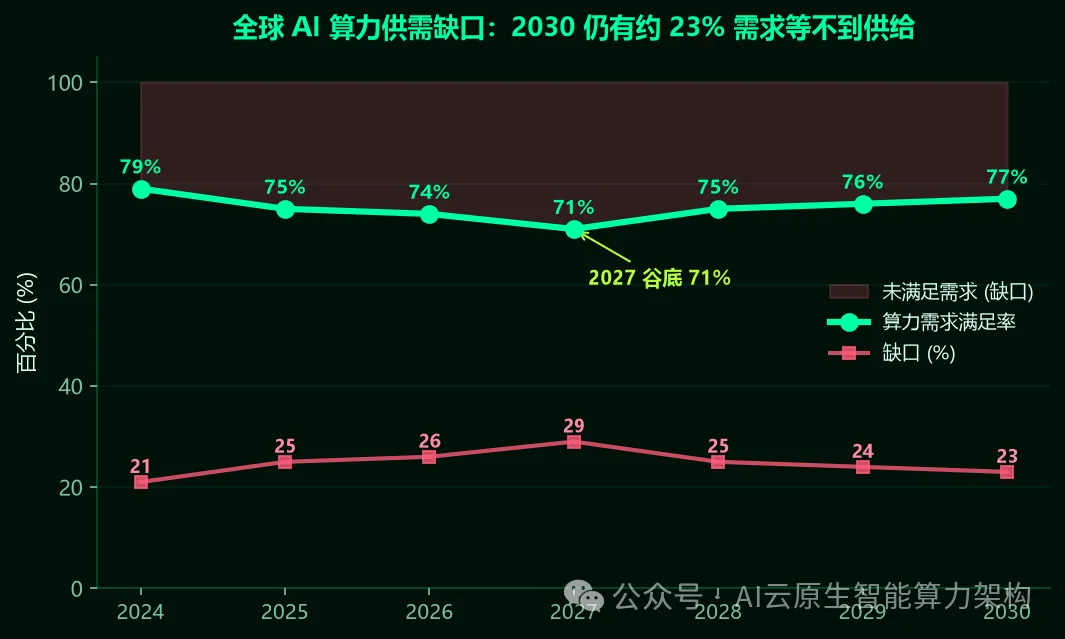
智譜Infra Agent在超過10萬卡國產加速器上的成功部署也表明: 軟體最佳化可以在一定程度上彌補硬體差距。 當算力供給受限時,工程效率——而非單純FLOPS——成為決定可用算力的關鍵變數。
九、結語:架構師的思維轉變
Agent時代的計算競爭,已經從“單點性能”升級為“系統效率”。浪潮資訊首席AI戰略官劉軍在AICC2026上提出的“從提供算力走向生產智能”,本質上是對架構師提出的新要求: 不再只關注GPU峰值FLOPS,而要關注Token產出效率、任務完成時間、系統可用性與TCO。
- 三個關鍵判斷
推理成本將繼續下降,但下降速度取決於架構效率,而非單純硬體降價。
PD分離、KV Cache最佳化、動態批處理、量化壓縮的組合將持續壓低單Token成本。
- Agent將吞噬傳統API呼叫。
當Agent可以自主規劃、呼叫工具、迭代執行時,大量硬編碼的業務邏輯API將被“自然語言意圖 + 模型編排”替代,呼叫形態發生根本變化。
- 開放架構將勝出。
單一廠商的全端鎖定在智算中心層面越來越不可持續。開放超節點、統一調度層、多引擎推理閘道器、國產算力相容,將成為基礎設施選型的核心標準。
給架構師的行動建議
最終判斷
Agent不是大模型的“應用層裝飾”,而是對AI基礎設施的一次“壓力測試”。
它正在倒逼晶片、儲存、網路、散熱、調度、反饋閉環全面重構。
能夠用開放系統架構高效“生產智能”的玩家,將成為下一階段計算產業的主角。 (AI雲原生智能算力架構)