
就在剛剛,馬斯克SpaceXAI正式發佈,全新主力模型Grok 4.7!
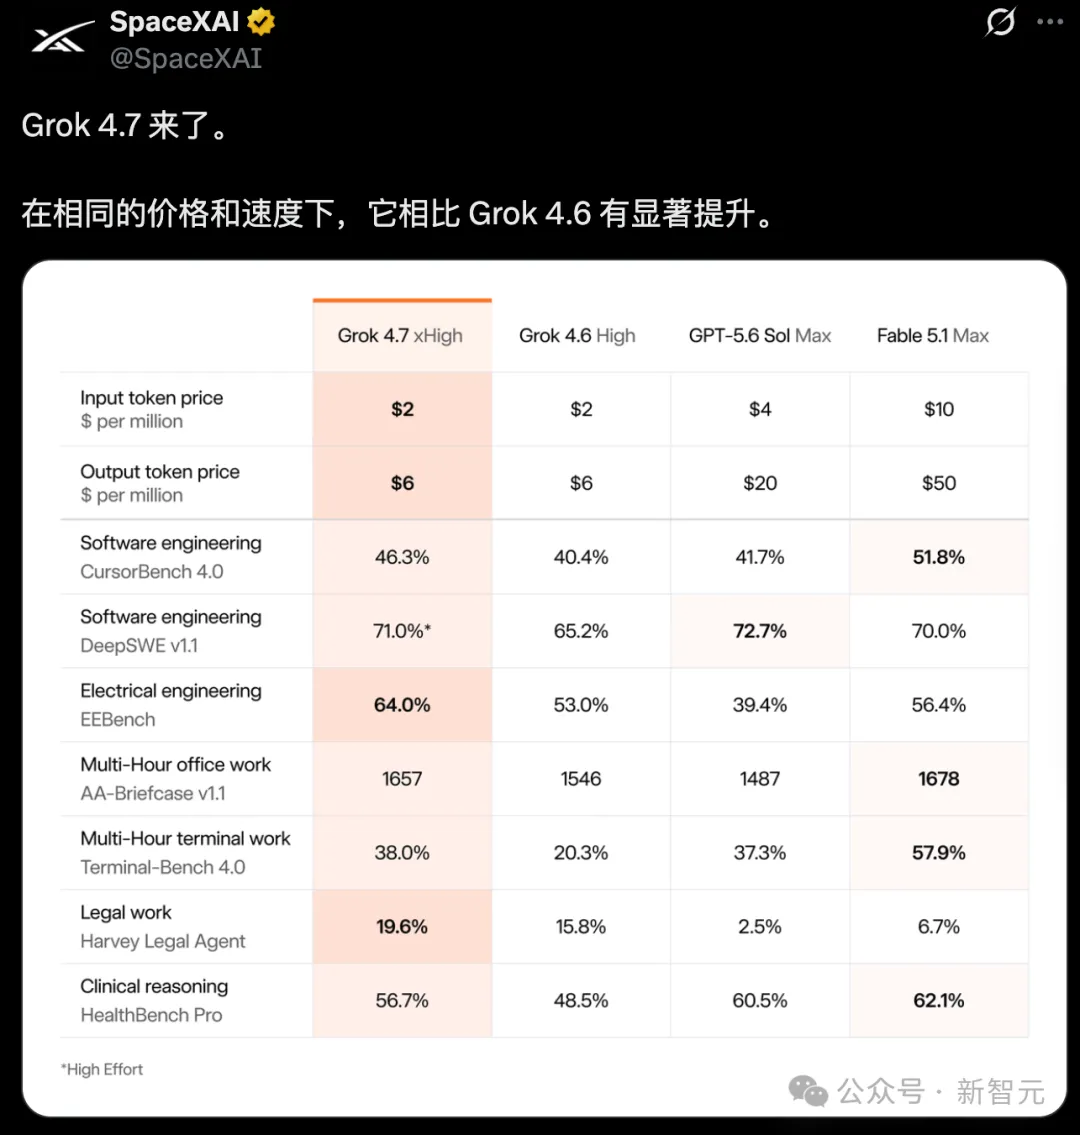
核心賣點主打一個,同樣的價格和速度,超強的性能。
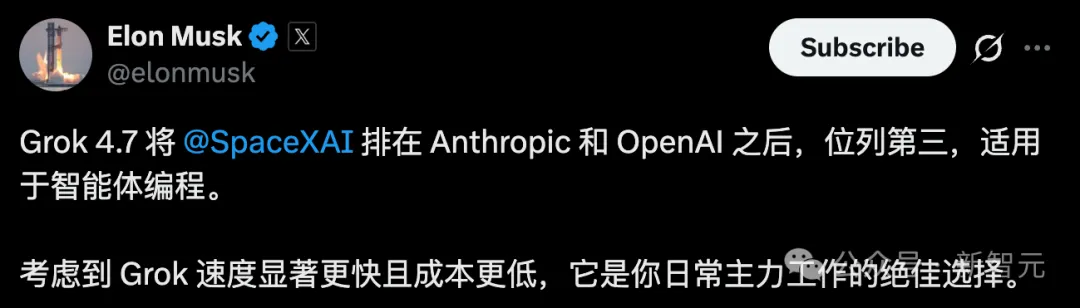
馬斯克第一時間喊話,「Grok 4.7把SpaceXAI送上了智能體程式設計的第三把交椅,僅次於Anthropic和OpenAI」。
速度又快,價格又低,Grok 4.7是個人搬磚幹活的首選。
SpaceXAI官博中,官方給出的定位:史上最強Grok,專為程式設計和知識工作而生。
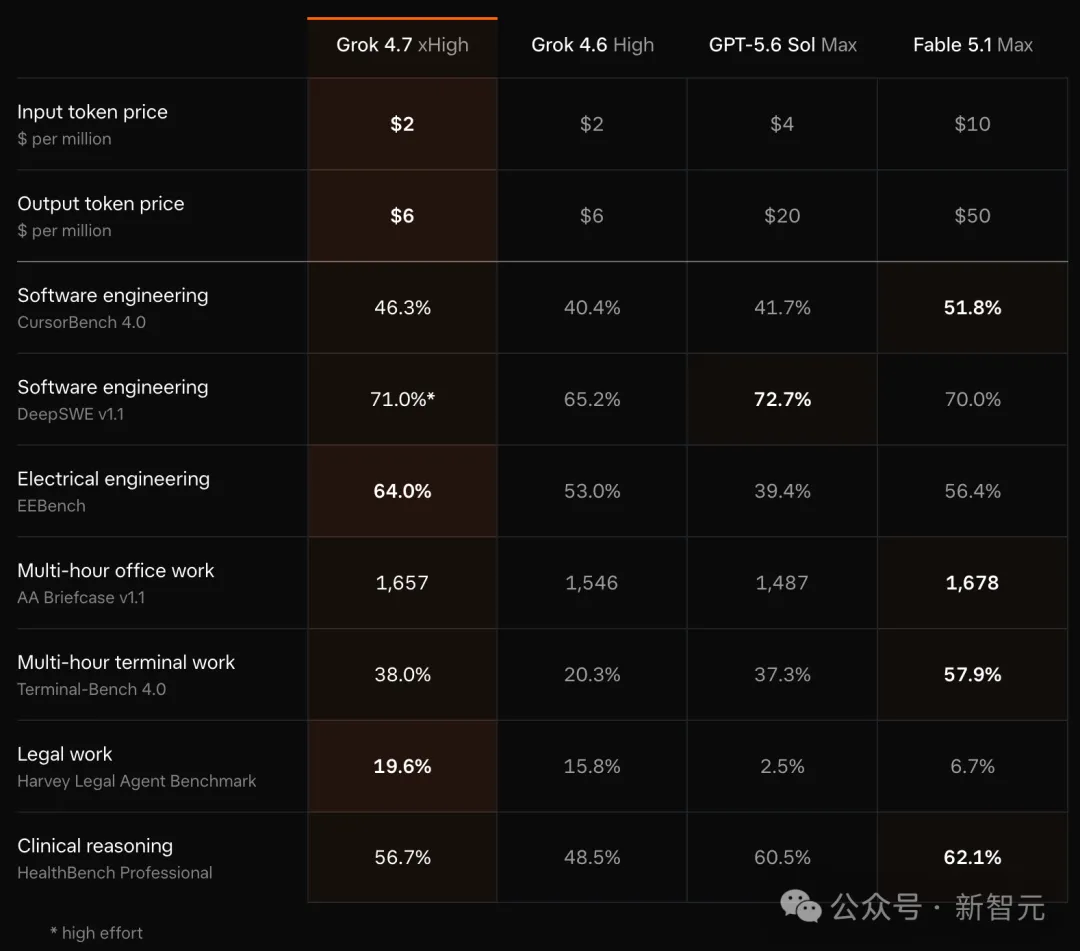
具體來說,Grok 4.7在程式設計和知識工作基準上,成績幾乎蓋過了GPT-5.6 Sol Max,直追Fable 5.1 Max。
輸入每百萬Token 2美元,輸出6美元,和Grok 4.6一模一樣。
但底層模型徹底大換血,基座模型更大,強化學習訓練拉長,任務難度加權向「需要數小時才能完成的工作」傾斜。
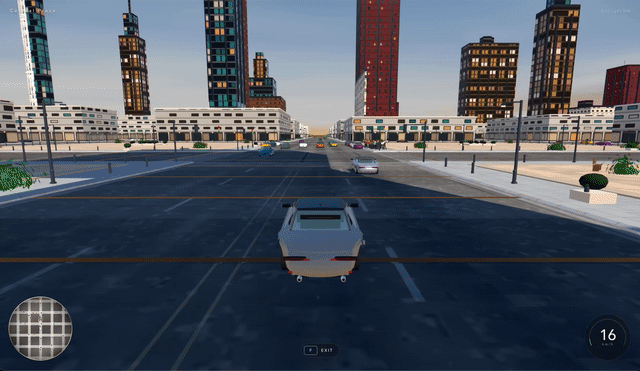
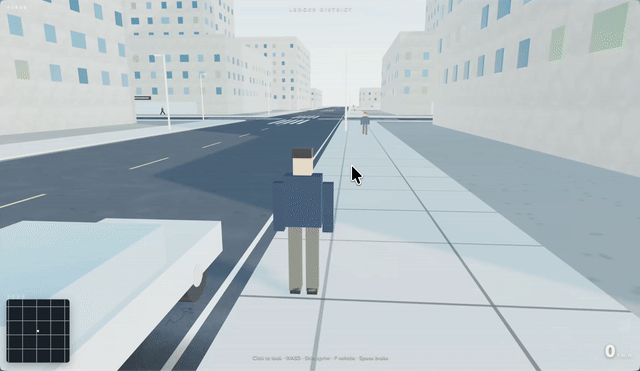
讓Grok 4.7和Grok 4.6去搓個開放世界城市遊戲,差距真的是肉眼可見。
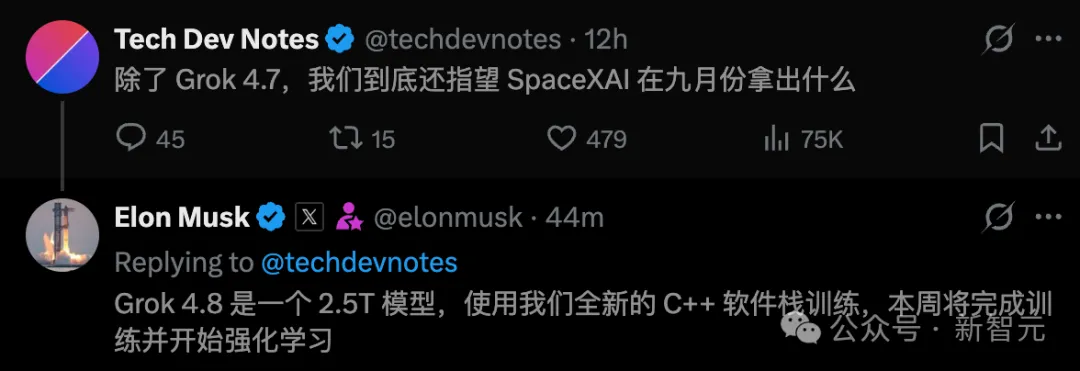
值得一提的是,下一代2.5T新模型Grok 4.8也訓完了。
馬斯克的拿手好戲,才剛剛開始。
Grok 4.7登場
程式設計追進第一梯隊
更能量化Grok 4.7這輪進步的,還是程式設計測試。
拆開AA的榜單,資料很有意思。
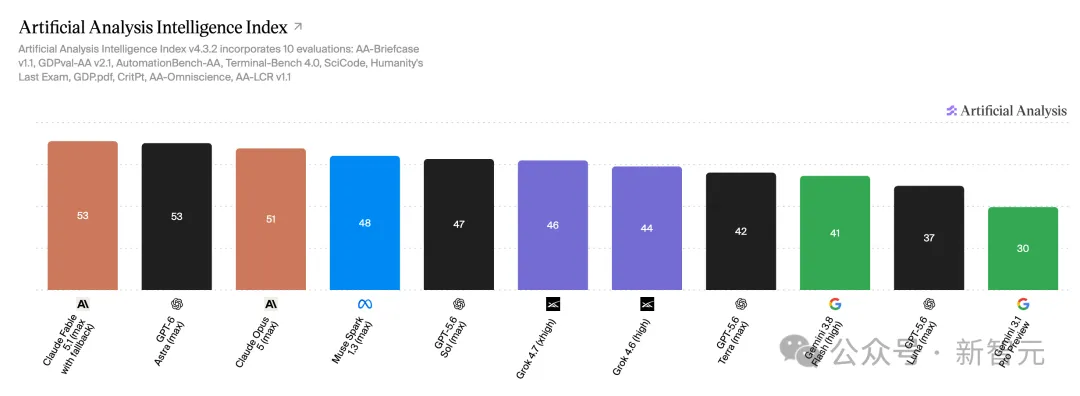
綜合智能指數上,Grok 4.7拿下46分,相比4.6隻寒磣地漲了2分。而第一梯隊的Fable 5.1和GPT-6 Astra全是53分。
按單模型算,它排在第16名;按實驗室排,剛好擠到了第四。
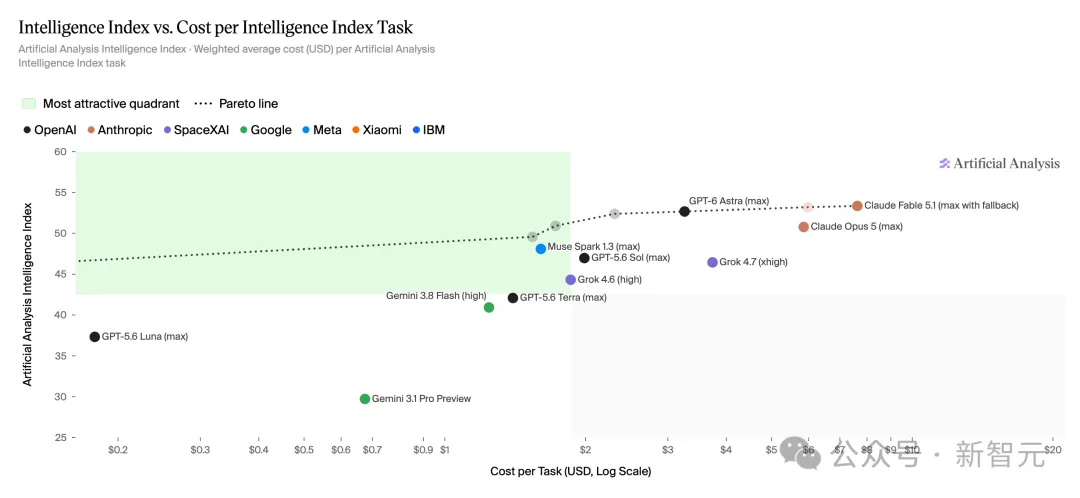
而真正讓馬斯克吹上天的程式設計榜,其實是兩張。
1. 套上GrokBuild框架,Grok 4.7飆到56分,排在Fable 5.1、GPT-6 Astra和Opus 5之後。馬斯克口中的「全球第三」,是偷偷把Anthropic的兩個模型並成了一家。
2. 換到統一基準的Terminal-Bench4.0後,Grok 4.7的通過率當場暴跌到26%~27%。作為對比,GPT-6 Astra是60%,Fable 5.1是55%。
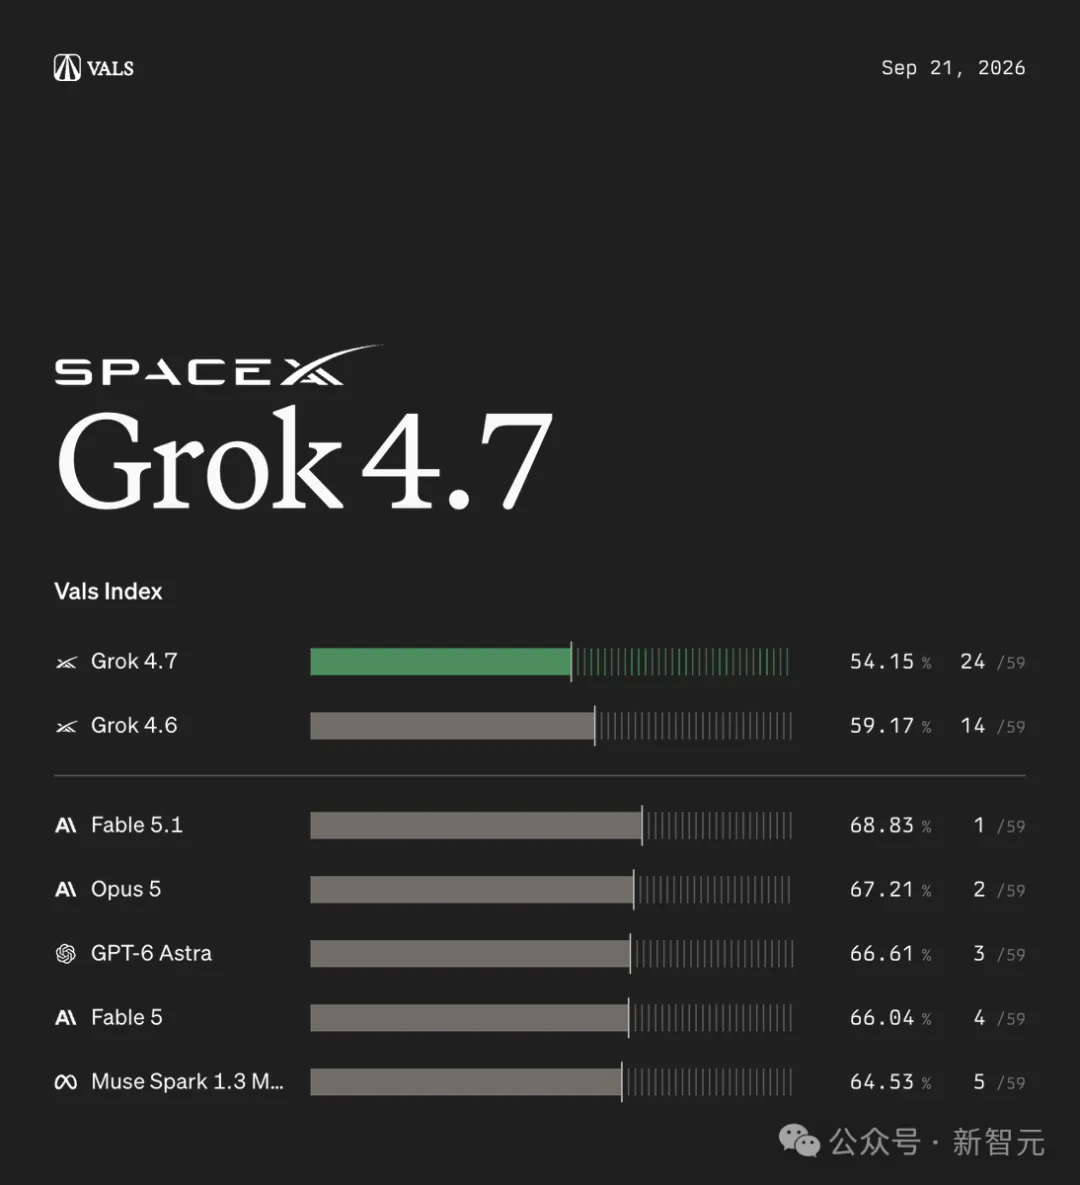
不過,在評測機構ValsAI這裡,Grok 4.7不升反降,直接從第14名一路跌到第24名,比上一代4.6還倒掛了5分。
馬斯克為什麼要拚命給Build框架站台?答案就藏在官方公告的附註裡——
Grok4.7在預訓練階段,深度對齊了GrokBot框架的互動模式。
換句話說,它極度依賴自家工具的呼叫邏輯和任務拆解套路。一旦走出溫室,戰鬥力瞬間打折。
知識能力,也非常能打
這次升級的另一塊重點,便是離所有人更近的一個場景——辦公。
在長流程知識工作測試AA-Briefcase中,Grok 4.7拿到1657 Elo,比Grok 4.6的High檔增加111分。
在GDPval-AA上,它拿到1695 Elo,比上一代高出90分。
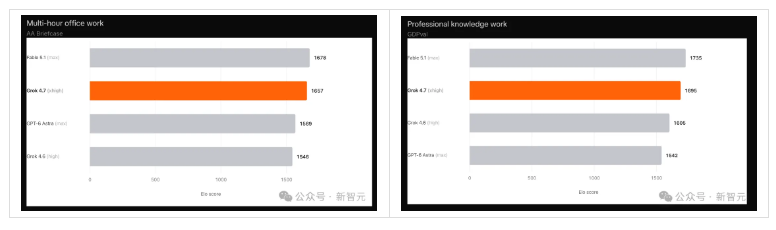
這些任務看重的,是AI到底能不能幫專業的人把活兒幹完、交出像樣的東西。
比如,整理材料、製作文件、完成分析與簡報,Grok 4.7明顯比上一代大幅提升。
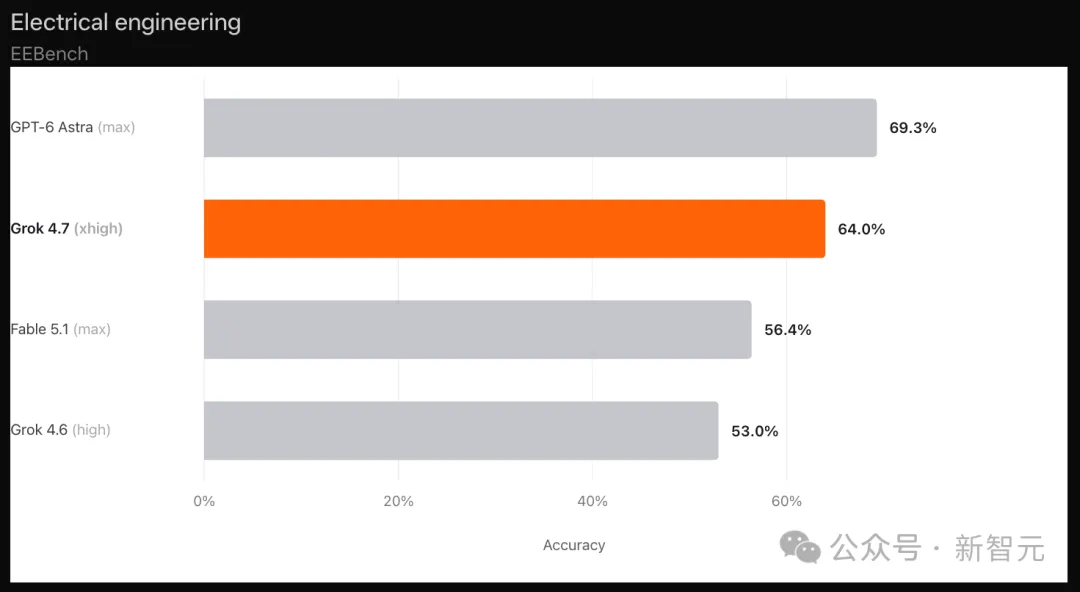
此外,在電氣工程測試EEBench上,Grok 4.7拿下64.0%,在所列四款模型中最高。
全網首測
有驚喜也有翻車
Grok 4.7一上線,不少人早就摩拳擦掌,上手嘗鮮了。
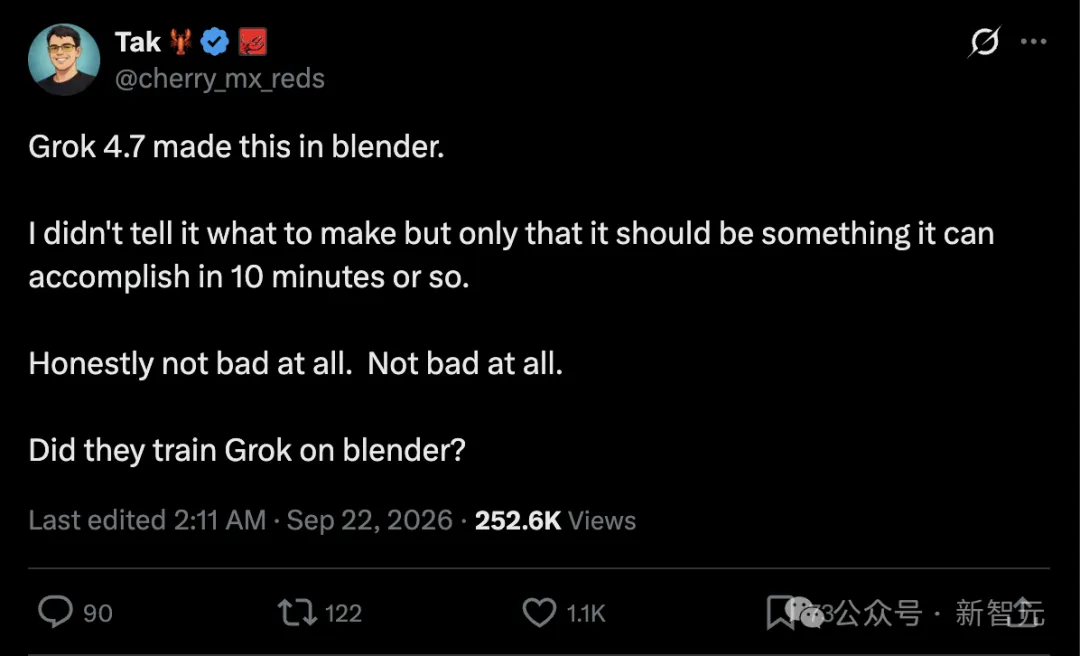
最出圈的一個demo,來自開發者Tak。
他壓根沒給Grok 4.7具體要求,就留了一句「你10分鐘內能做啥就做啥」。
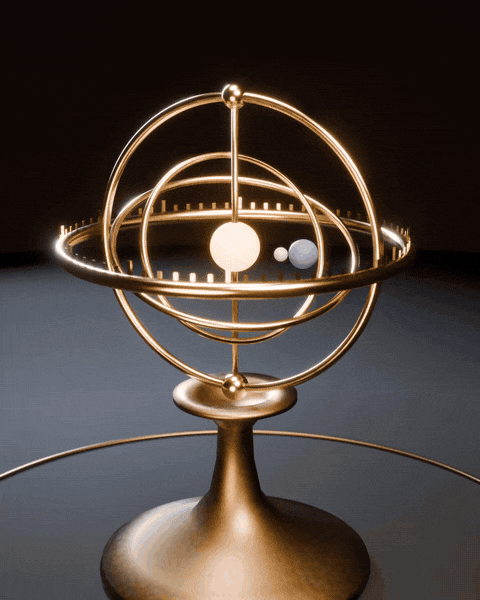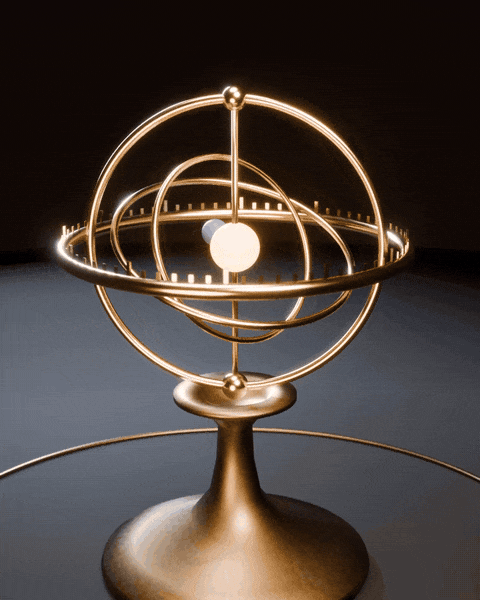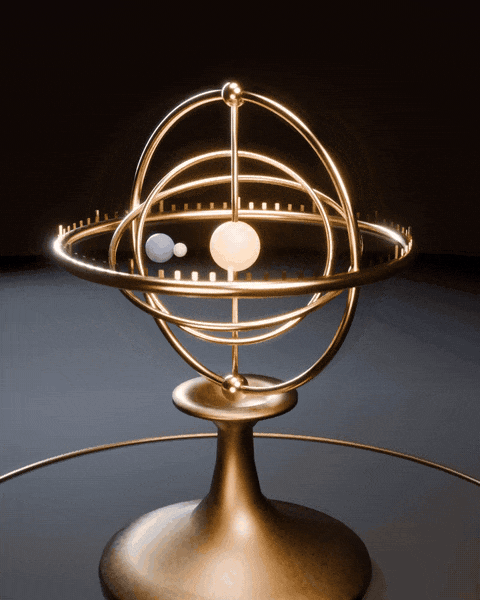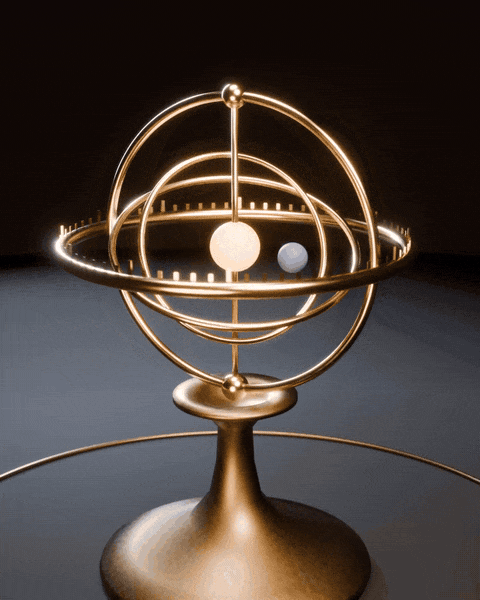
結果 Grok 自己跑去 Blender 裡搓了個黃銅渾天儀,上面的行星甚至還能轉,引全網25萬人圍觀。
Tak本人點評,「講真,一點也不差」。
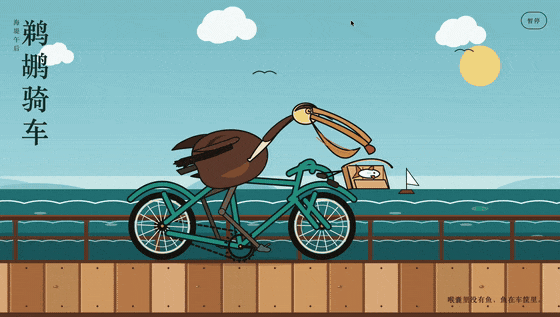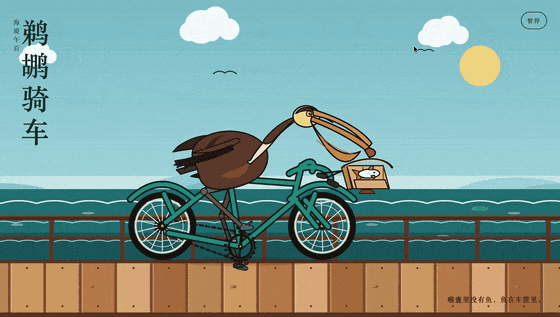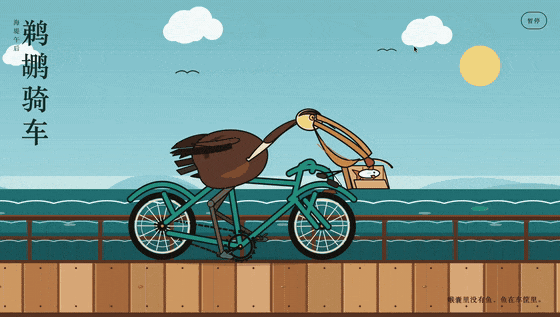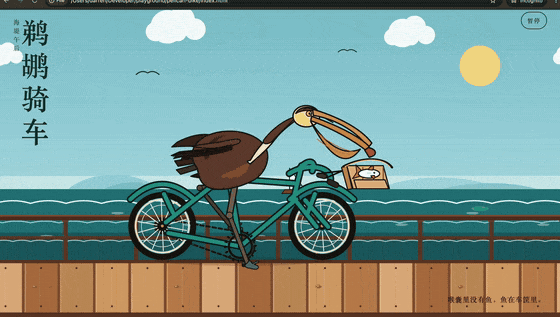
然後是經典節目,鵜鶘騎自行車。
有人直接拉滿組態,開了xhigh加fast模式開跑,燒了整整18分鐘,3.16美元。
結果出片還真像那麼回事,白鵜鶘在海邊騎車,翅膀搭在車把上。
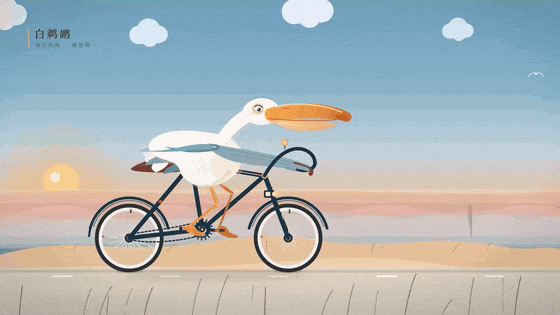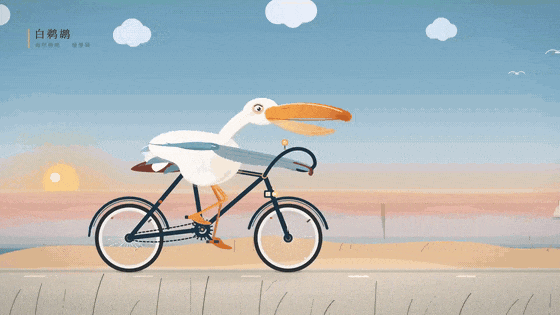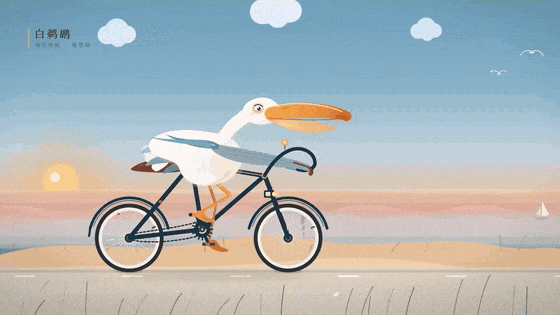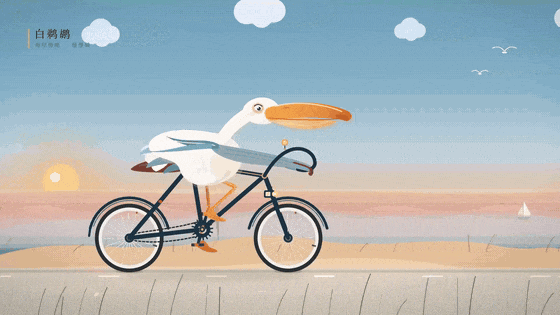
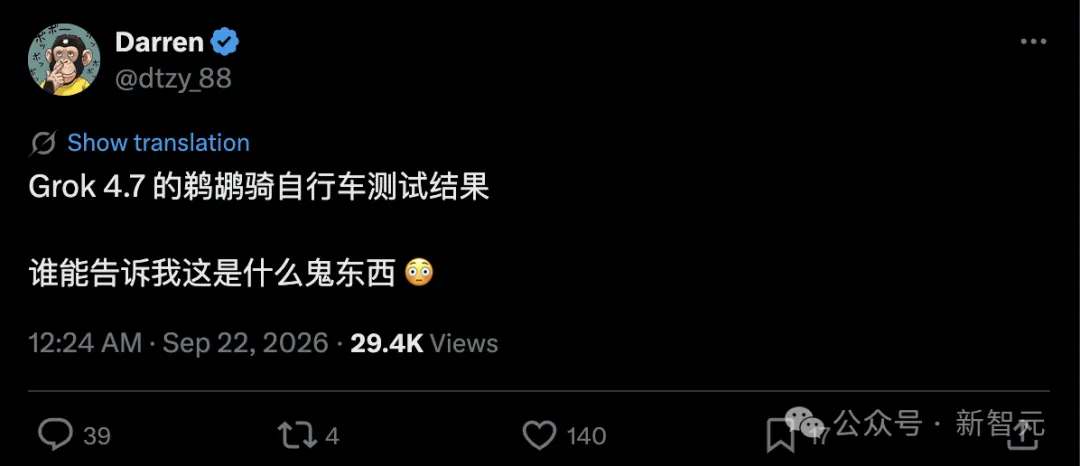
另一個人跑出來的就拉胯多了,生成的棕色鳥直接癱在自行車上。
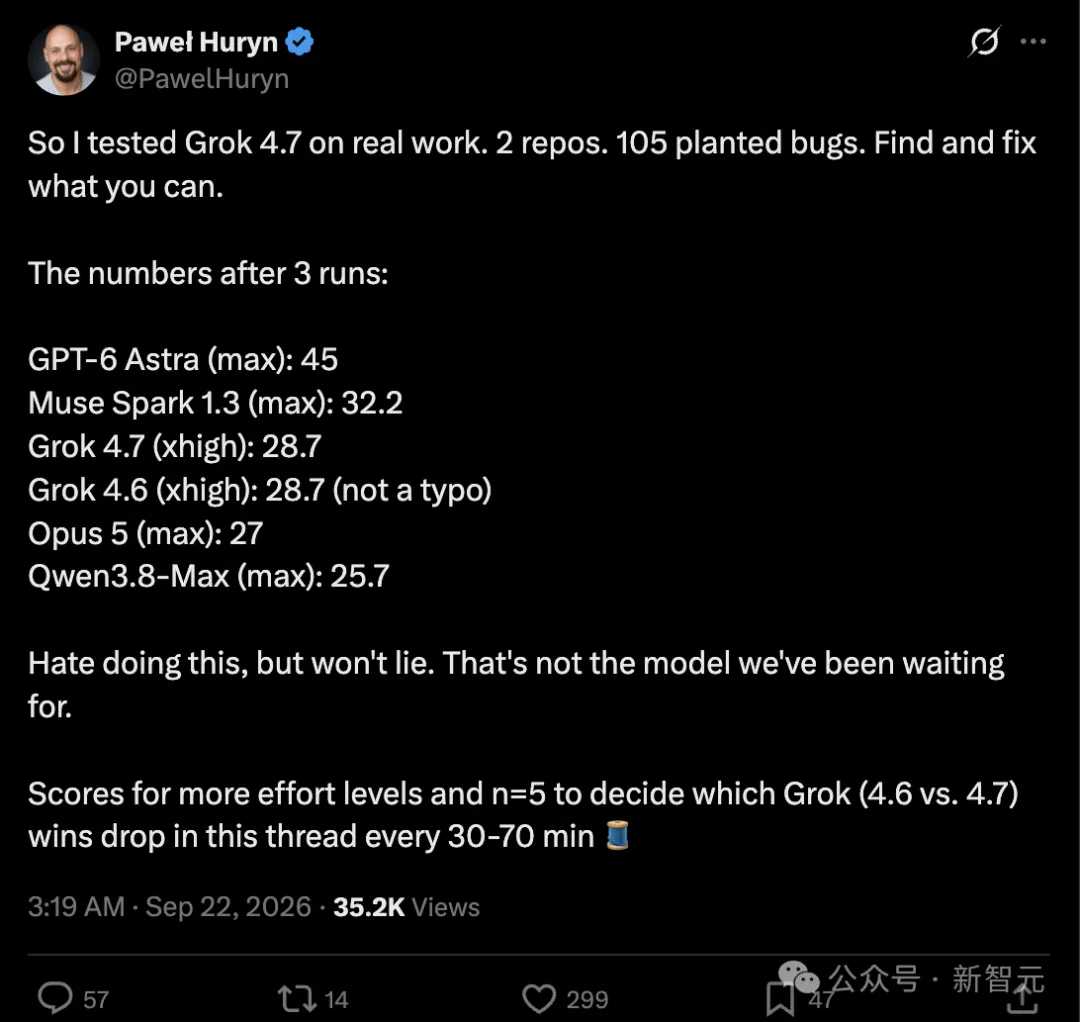
產品博主Paweł Huryn拿了兩個真實程式碼庫、埋了105個bug測了三輪。
結果是,GPT-6 Astra能修好45個;Grok 4.7搞定了28.7個。戲劇性的是,上一代Grok 4.6也是28.7個。
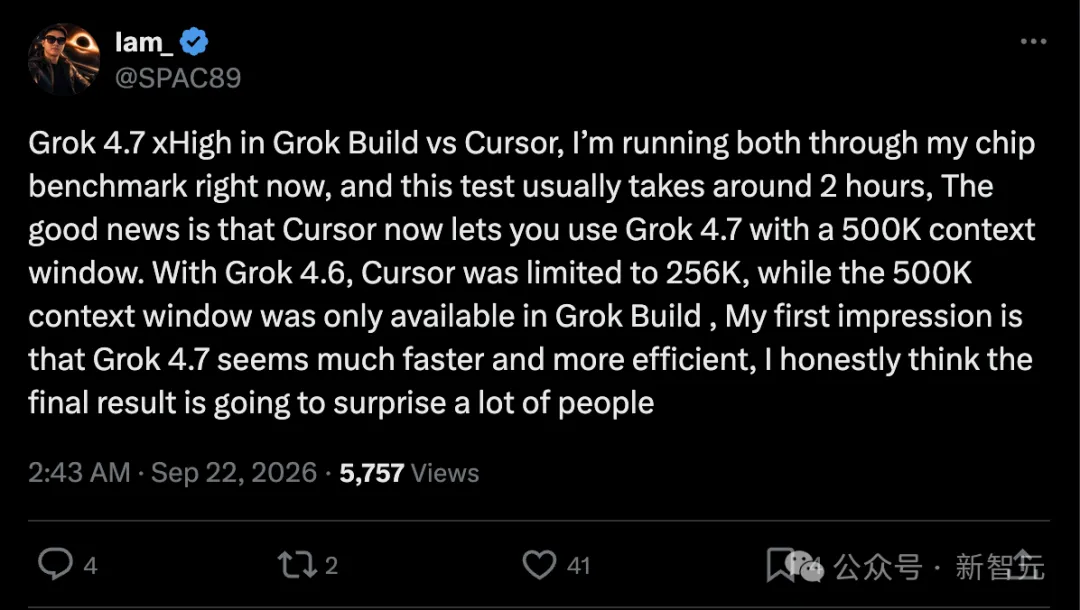
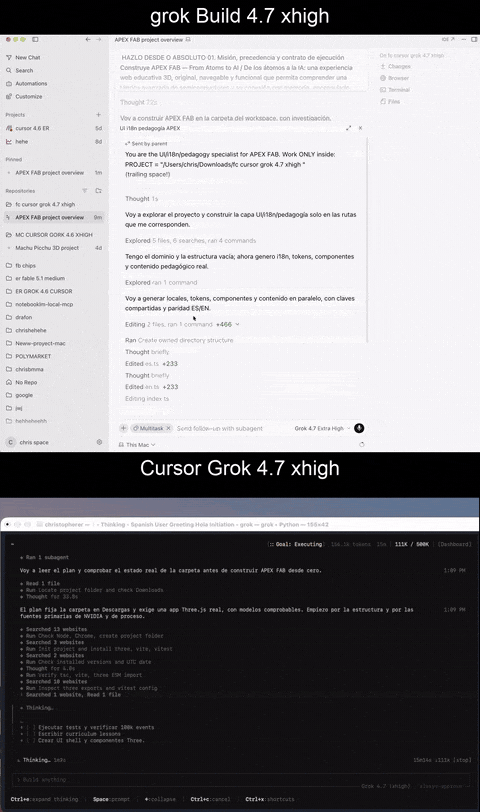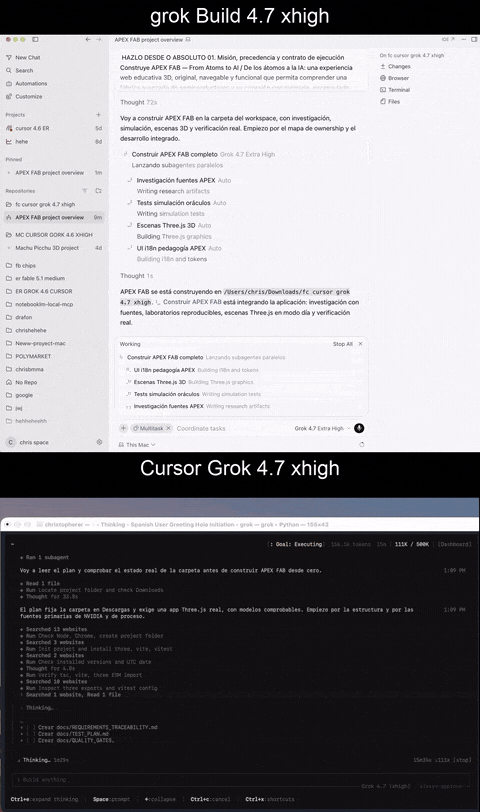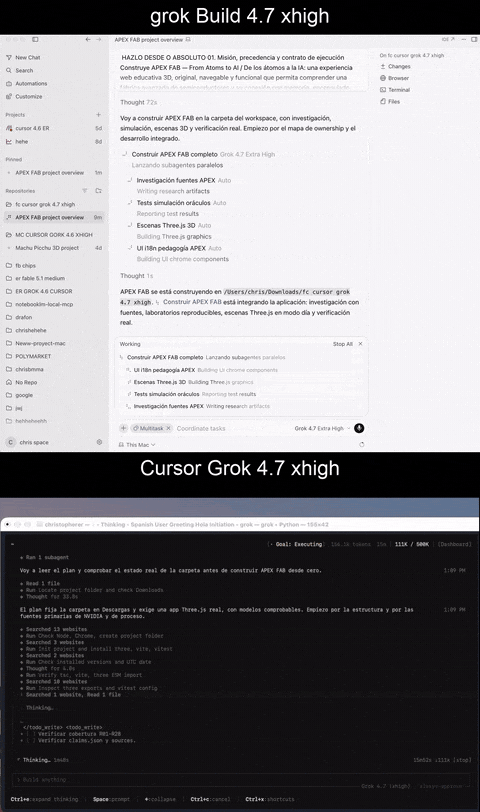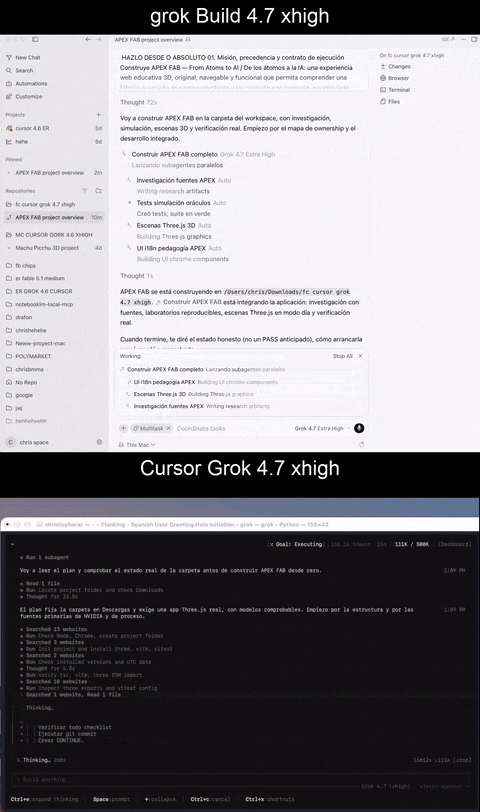
還有人直接上了硬碰硬的對照試驗:把同一個晶片項目,同時甩給Grok Build和Cursor裡的Grok 4.7。
整整兩小時,測下來最直觀的感覺就是四個字:又快又省。
順帶還扒出個新彩蛋,Cursor 居然悄悄把Grok 4.7的上下文頂到了500K,要知道上一代4.6可只有256K。
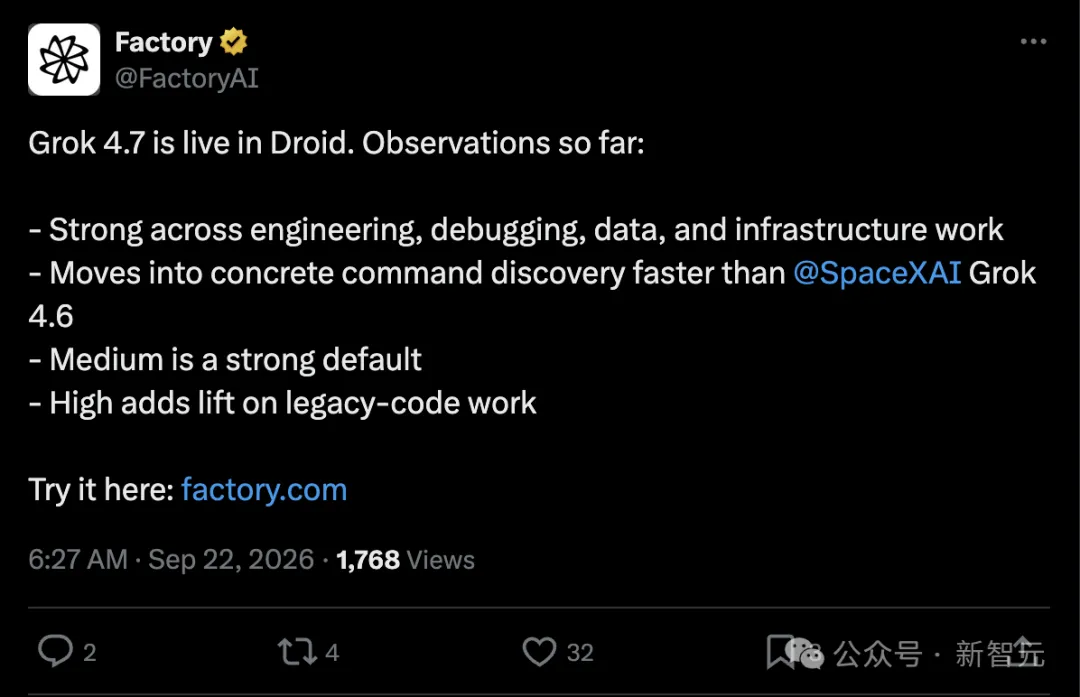
做程式設計Agent的Factory也第一時間接進了自家的Droid,給的評價比較克制。
工程、偵錯、資料、基礎設施的活都能幹,找命令比4.6快,medium檔夠用,high檔在老程式碼上有加成。
定價便宜五倍
一算總賬卻遭背刺
這次,Grok 4.7官宣的另一大亮點,是價格是同類一半。
不得不說,她的單價確實誘人:輸入2美元、輸出6美元。
對比Astra和Fable動輒10刀輸入、50刀輸出的刺客價格,Grok單價便宜了5到8倍。
官方曬出的Cursor Bench 4.0性價比曲線上,Grok 4.7最高檔拿下46.3%,解一道題成本6.01美元;Fable 5.1中檔46.8%,一道題7.05美元。看上去像是一場平分秋色的精準狙擊。
但只要拿放大鏡掃一眼圖表底部的細節,這筆賬就全變味了。
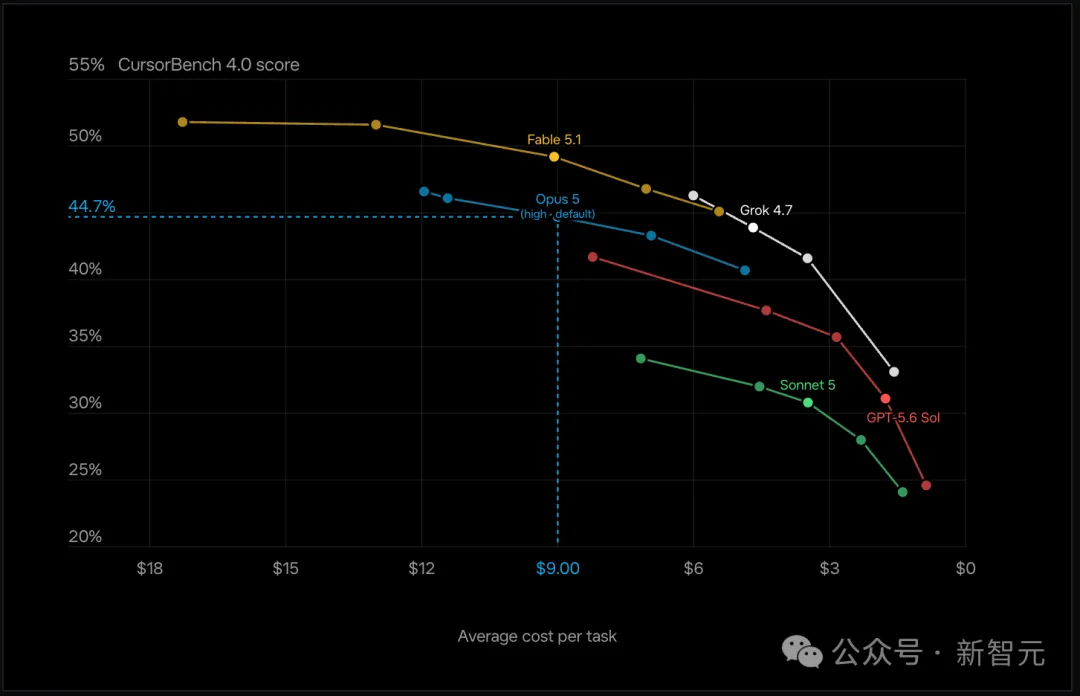
Fable 5.1低檔跑出45.1%,單題成本只要5.44美元,比Grok的最高檔還要便宜;而上一代的GPT-5.6 Sol高檔拿下35.7%,單題只需2.85美元。
玄機依然在於那驚人的「話癆體質」。
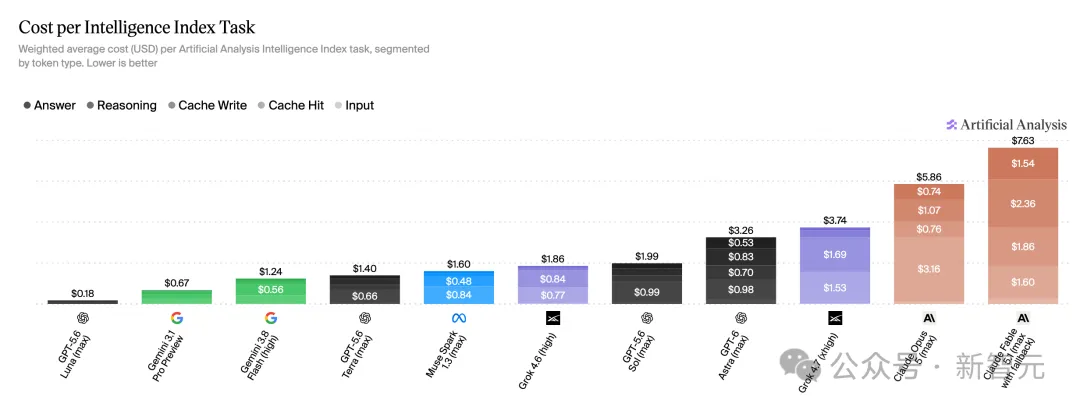
8.1萬輸出token,幾乎是GPT-6 Astra的三倍。單價便宜5倍,但廢話多了3倍,實際賬單優勢被生生腰斬。
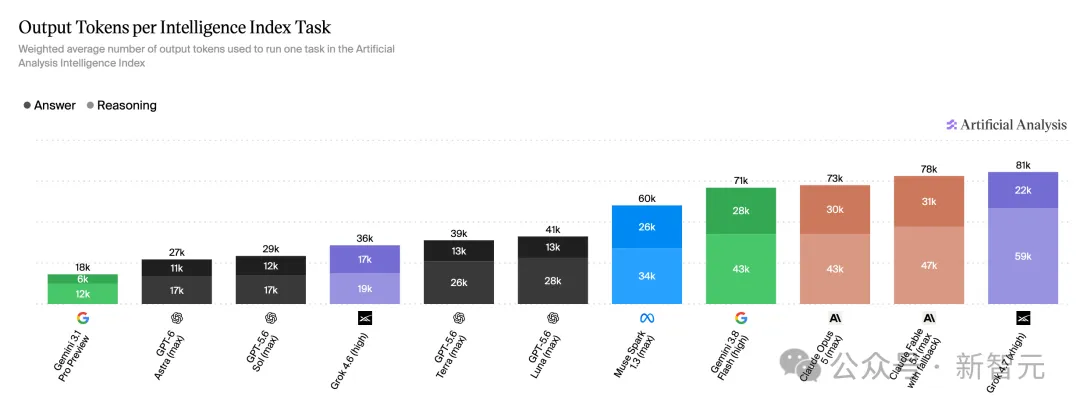
Hacker News上有開發者算清總賬後吐槽:Grok 4.7的快取讀取單價甚至反超了Sol。
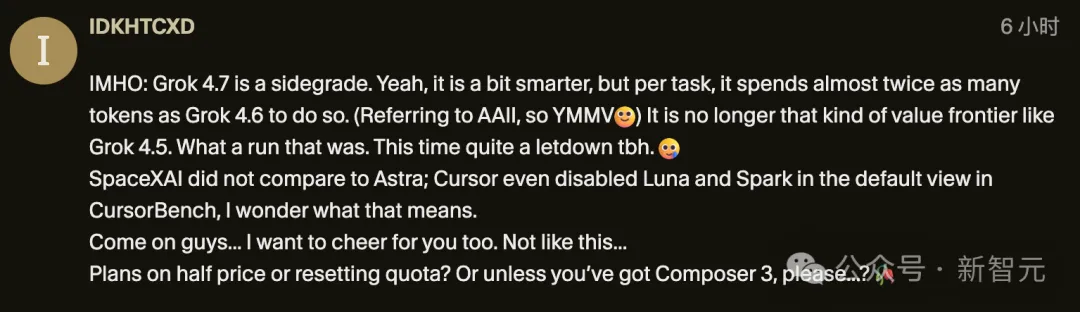
Cursor社區更是直接破防:「這根本不是什麼劃時代的性價比怪物,花掉的token幾乎是4.6的兩倍,4.5時代那種極致廉價感徹底沒了。」
不過在純速度上,它確實快得凶殘。
AA實測每秒狂飆188個token,fast模式更是原地翻倍。
模型加框架,才是下一個戰場
如今再看Grok 4.7的戰術意圖,已經徹底明牌。
它不打算碰AGI的絕對王座,而是退守前沿第二梯隊,卡住最便宜、最快的高地,專打性價比。
但這場發佈暴露出的真正行業趨勢——單體模型的時代,正在過去。
Grok 4.7的高分,有一大半是靠著Grok Build的量身定製硬頂上去的;一旦脫離自家的腳手架,分數立馬露餡。
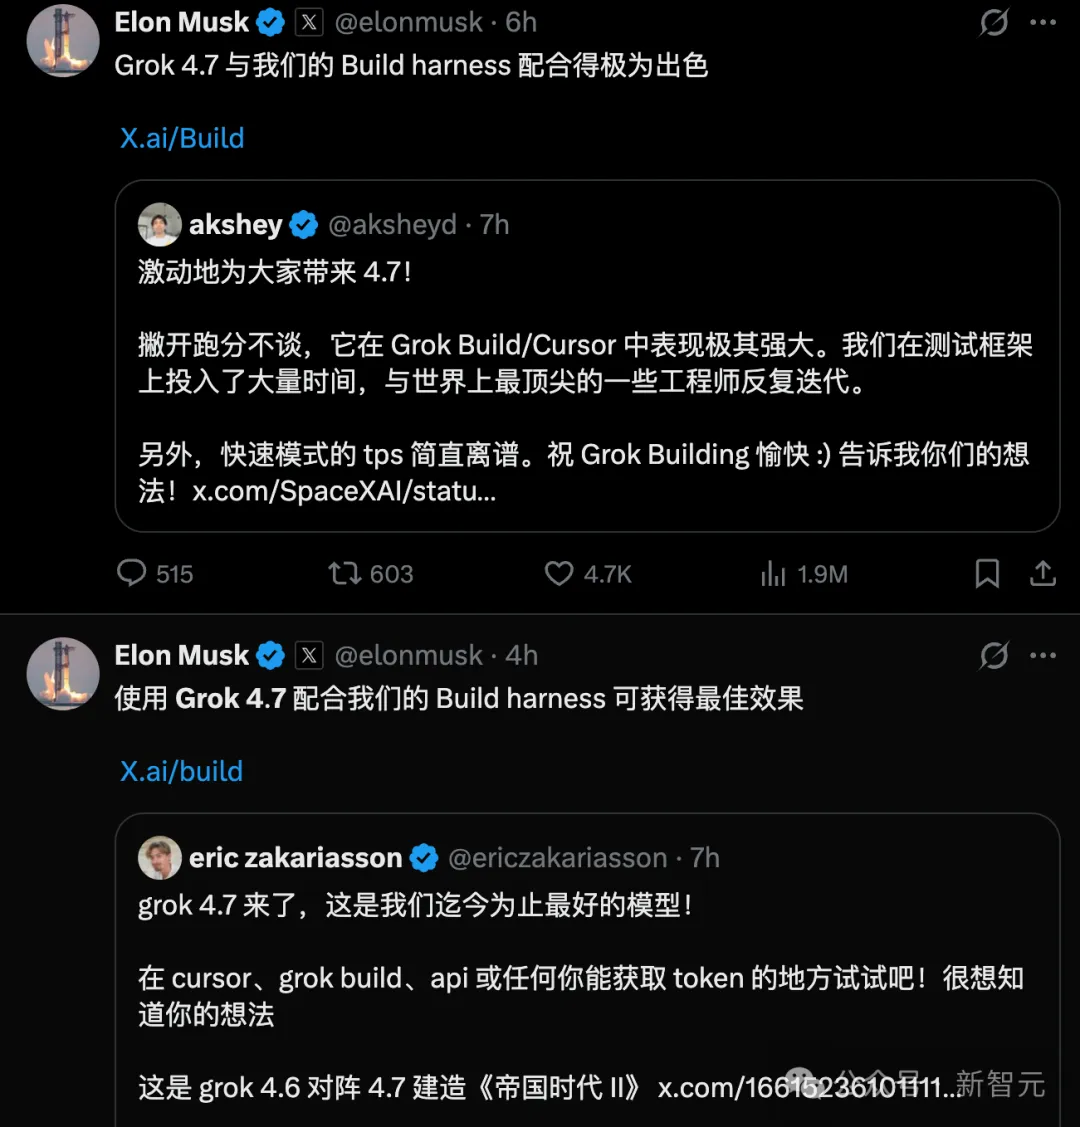
Anthropic用Claude Code鎖死長程任務,OpenAI用Codex把持生態,xAI也終於走上了用私有框架捆綁開發者的路子。
未來的第三方評測榜單將徹底失去純粹性,以後再看到所謂的跑分排名,第一句話必須先問:
你到底是用什麼框架測的? (新智元)