
Google工程師Patrick推測,Opus 5.5模型可能由Anthropic內部更強的"教師模型"Model 2通過知識蒸餾訓練而成,並可能是首個體現"遞迴自我改進"路徑的產品模型。目前無公開證據證實,但Anthropic已確認Model 2存在,且其程式碼庫中逾80%程式碼由Claude撰寫。該趨勢表明模型能力提升與推理成本下降有望同時實現。
Anthropic最新發佈的Claude Opus 5.5,在性能大幅躍升的同時將運行成本壓低40%,這一反常規的組合引發了業界對其訓練方式的密切關注。
社交平台X上,Google工程師Patrick C Toulme據此提出一個推測:Opus 5.5可能經由Anthropic內部更強大的"教師模型"Model 2蒸餾而來,並可能是首個體現"遞迴自我改進"(RSI)路徑的產品模型。
目前沒有公開證據直接證實這一推斷,但Anthropic已公開確認Model 2的存在,且該公司發佈的RSI相關文章顯示,AI參與AI研發的程度正在快速深化,這使得上述猜測具備一定背景。
對於投資者和行業觀察者而言,這一事件真正值得關注的,是它將三條此前相對分散的趨勢串聯在了一起:更強的內部模型持續迭代、AI深度介入AI研發流程、以及更小更便宜的產品模型同步湧現。
如果這條路徑成立,模型能力提升與推理成本下降將有可能同時發生。
01 Opus 5.5為什麼值得關注?
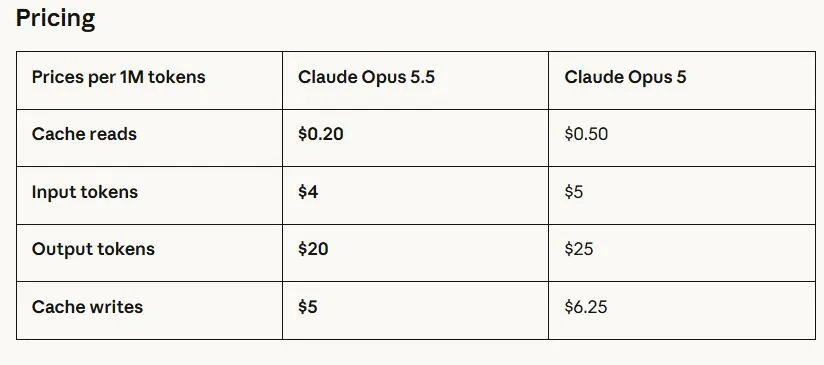
華爾街見聞提及,Anthropic將Claude Opus 5.5定位為其5.5系列的首款發佈,性能在多數任務上與Claude Fable 5.1持平,但運行成本較Opus 5下降40%,輸出速度提升逾30%。
定價層面的降幅尤為顯著。輸入和輸出token價格分別為每百萬4美元和20美元,較Opus 5下降20%;而在代理任務和程式設計場景中佔主要成本的快取讀取,則從每百萬0.50美元降至0.20美元,降幅達60%。
從實際使用表現來看,早期測試者完成了680,000行程式碼遷移,耗時不足一天,而此前類似工作需要工程團隊數周;另一項測試中,Opus 5.5將一個Web應用全站頁面載入時間最佳化成功率達到39/40,Opus 5在同等任務上則出現了改動應用行為的副作用。
在將HAProxy從C語言重寫為Rust的內部測試中,Opus 5.5耗時9.5小時,較Fable 5.1的12小時縮短逾20%,成本節省51%。
Anthropic表示,效率優勢還體現在token消耗層面——Opus 5.5不僅每個token價格更低,完成同等任務所需的token數量也更少,兩者疊加共同形成了40%的綜合成本降幅。
02 Patrick所說的“教師模型”到底是什麼?
Patrick C Toulme在X上寫道:
Opus 5.5顯然是由一個更大的教師模型訓練出來的,很可能是Model 2 Mythos。
Opus 5.5是首個經過RSI訓練、同時由內部教師模型蒸餾的模型。規模更小、成本更低,正是教師模型蒸餾的產物。
這裡涉及的核心技術概念是"模型蒸餾":讓能力更強的教師模型生成高品質訓練訊號,再用這些訊號訓練規模更小的學生模型,從而在保留較高能力的同時顯著降低推理成本。
Anthropic已公開確認,其內部存在一個比Mythos 5更強大的Model 2,並被大量用於程式碼生成、資料生成及代理任務。然而,目前沒有任何公開材料直接證明Opus 5.5是由Model 2蒸餾而來。Anthropic在發佈文件中也未提及具體訓練方式。
值得注意的是,Anthropic在安全條款中將"蒸餾攻擊"單獨列為一類威脅——即攻擊者通過大量虛假帳戶從模型中批次提取能力,並為此在Opus 5.5上引入了"保留推理鏈"等反蒸餾機制。
這一細節從側面說明,蒸餾技術本身在Anthropic的技術體系中具有相當重要的地位。
03 AI開始參與AI研發
無論Opus 5.5的具體訓練路徑如何,Anthropic自身發佈的RSI相關文章提供了一幅更宏觀的圖景:AI介入AI研發的深度,正在以可量化的速度加快。
截至2026年5月,Anthropic程式碼庫中逾80%的程式碼由Claude撰寫,而在2025年2月Claude Code推出研究預覽版之前,這一比例僅為個位數。
在工程產出層面,Anthropic工程師人均每日合併程式碼量較2024年增長約8倍。
Anthropic文章同時指出,2026年4月,Claude在約800小時內將某類API錯誤降低了1000倍,而據主導此項工作的工程師估計,人工完成同等任務需要約四年時間。
在研究判斷力層面,Anthropic設計了一項內部測試:在研究員與Claude的協作會話中,找出人類研究員選擇了"次優"方向的關鍵節點,再比較不同版本的Claude與人類在這些節點上的判斷優劣。
結果顯示,2025年11月的Opus 4.5模型在51%的情況下給出了比人類更優的下一步建議,而2026年4月的Mythos Preview這一比例升至64%。
不過,該文章也明確指出了當前的邊界:
在選擇那些問題值得研究方面,Claude與人類之間仍存在較大差距。這正是今日AI與能夠自主設計下一代AI的未來系統之間的距離所在。
Anthropic同時強調,完全意義上的遞迴自我改進目前尚未實現,也並非必然到來。
但分析認為,過去模型競爭很大程度上是“誰擁有更多算力”,現在開始出現另一條路徑:讓更強的模型幫助訓練和改進更便宜的模型。如果這條路徑成立,模型能力提升與推理成本下降可能同時發生。 (硬AI)