
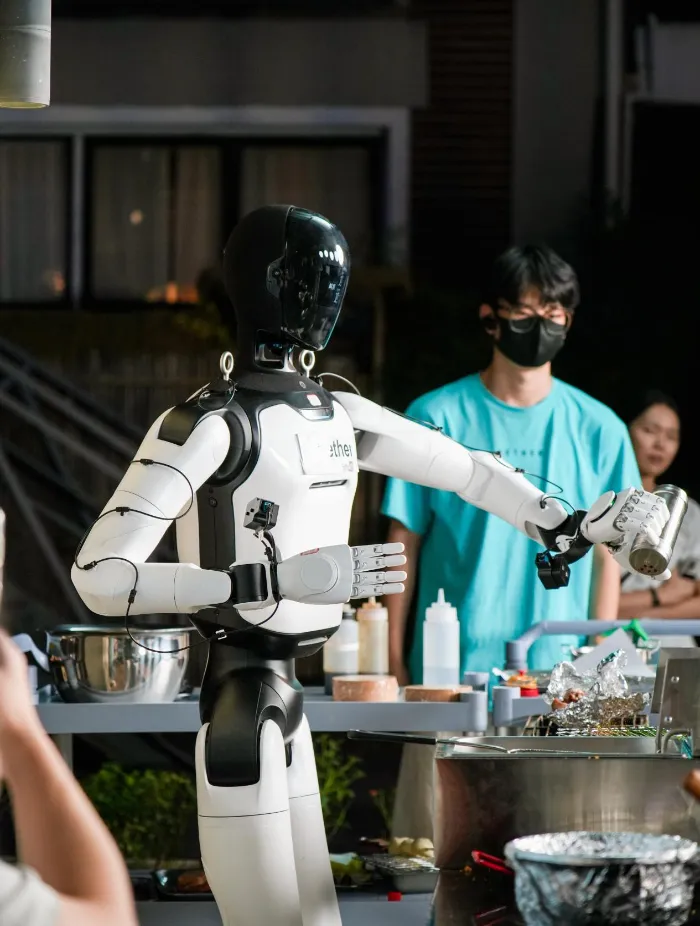
上海的一處戶外燒烤現場,顧客們正在等燒烤上桌。現場負責服務的是兩台機器人,一位守在爐前烤串,另一位穿梭在烤爐和餐桌之間,點單、傳遞資訊、上菜。一位顧客招呼了一聲:“幫我拿瓶水!”服務員就先放下手頭的工作,把水遞過去。遞完水後,“他”便繼續被打斷的點單工作。
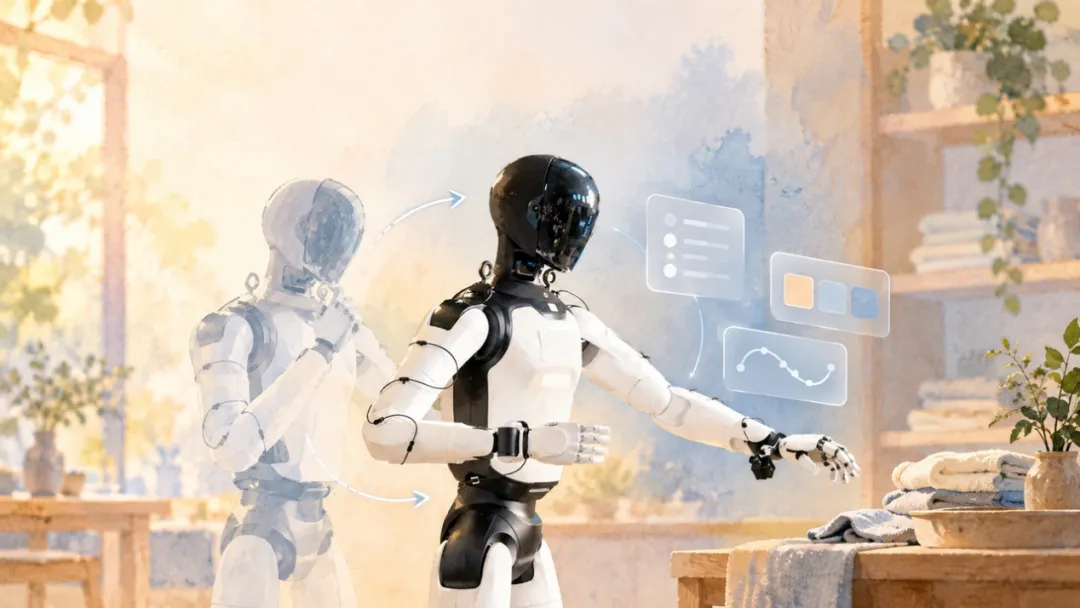
這是 9 月 16 日樂享科技在上海舉行的一場戶外燒烤直播裡的片段。承擔工作的“燒烤師傅”和“服務員”,是搭載了以太大模型(Aether)的機器人。
沒有預設指令碼,沒有遙操作兜底,也沒有剪輯掉“失誤”的機會,機器人要在真實的街頭環境裡,自主連續完成近一小時的燒烤服務。據樂享科技介紹,這場全球首次戶外機器人全自主直播,線上觀看人次超過 550 萬。這場近 1 小時的直播,為觀察具身大模型在開放環境中的表現提供了一個窗口。在開放環境裡,意外是一定會來的。這場直播真正的看點,恰恰是那些“出問題”的時刻。
01. 機器人可以自己拿主意了?
直播中,負責點單、傳菜的機器人被觀眾稱為“二爺”,另一位負責燒烤的機器人,則被叫作“五弟”。當“二爺”接到顧客“少放辣”的要求後,隨即用手勢把這條資訊傳遞給“五弟”。
兩台機器人相互傳遞資訊這件事,並不新奇。但是,它們怎麼知道什麼時候與對方互動、哪些資訊需要同步?按照直播中的介紹,這場雙機協作並未提前預設互動的觸發條件,而是全交給機器人根據現場情況自主完成。
類似的臨時變化,貫穿了整場直播。直播中,它完成送水這個臨時新增任務後,繼續完成了剩下的點單,沒有讓顧客重新點菜,也沒有遺漏還沒上菜的訂單。取水只是顧客給機器人出的難題之一,現場參與者還可以改動訂單、挪動物品,或在機器人幹活時提出新要求。
這些變化有的會影響下一步操作,有的則會打斷正在進行的工作。機器人需要處理眼前的新情況,也需要保留此前的任務進度:顧客還有哪些菜沒點完,剛才的工作停在了哪一步,處理完臨時需求後,又該從哪裡接著做。
對於人類來說,這幾個過程看起來很日常,也沒什麼難度。但是,它要求機器人能夠分清臨時插入的任務和原本的任務,在兩者之間切換,並保留之前的任務記憶。而不是完成臨時任務後,就把此前的工作一併清空。這就決定了,這場直播沒法靠預設程序完成。
因為,預設流程可以覆蓋一部分常見情況,但很難窮盡現場各種臨時出現的變化。這場直播提供的觀察窗口,正是當現場情況偏離原有安排時,機器人能否把工作繼續做下去。
02. 思考的過程,如何發生
“處理變化”對機器人來說並不新鮮。工業機器人可以依靠視覺定位與力控修正抓取位置,移動機器人能繞開路上的障礙。但當任務和場景更加多樣,機器人還需要把使用者的要求與眼前的環境聯絡起來,判斷接下來該做什麼、怎麼做。這類變化很難僅靠預設程序逐一覆蓋,它要求模型能夠基於即時環境自主理解、判斷和決策。
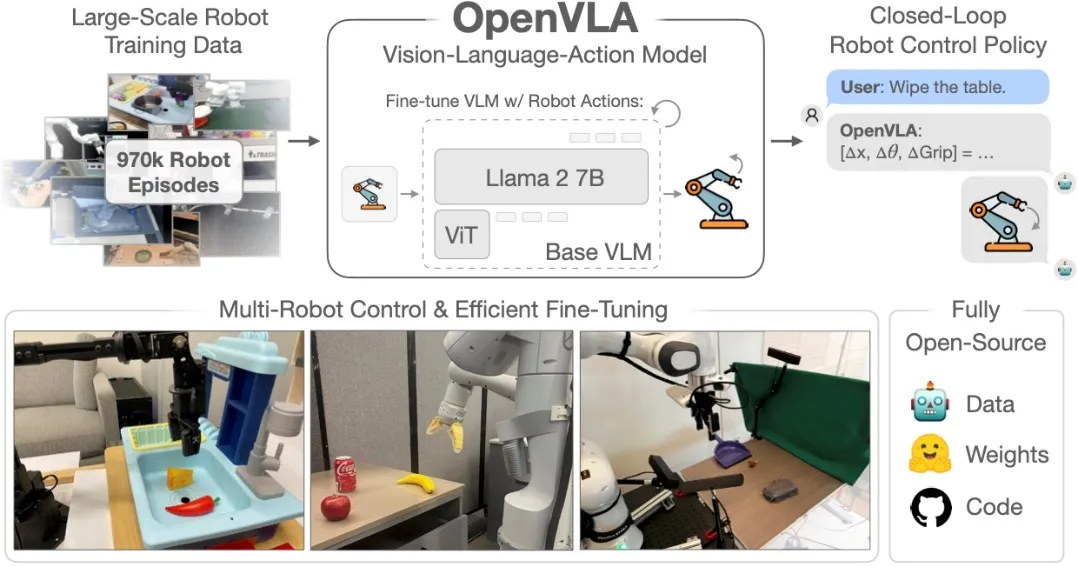
市面上的主流模型路徑能完成這些目標嗎?首先看視覺—語言—動作模型(VLA),它提供了一種實現方式:將場景和指令對應為動作。顧名思義,機器人會結合看到的內容和訓練的指令來生成動作,它學習的是輸入與動作之間的關係,能夠在一定範圍內泛化到新的任務或場景;實際系統也可以持續接收新畫面並重新生成動作,形成反饋閉環。
以 OpenVLA 為例,它利用視覺語言模型與機器人示範資料學習動作策略,並支援在不同機器人平台上應用和適配。當你說“把杯子放到盤子旁邊”,模型會結合攝影機畫面和指令,輸出機械臂該怎麼移動、夾爪何時開合。
比起 VLA 的“學後做”,世界動作模型(WAM)更注重“想後做”:採取某個動作後,環境可能會發生怎樣變化?這種預測可以幫助系統規劃,也可以用於訓練動作策略。
例如,Dreamer 通過學習環境模型,在內部預測的情境中改善行為。拿杯子來說,它可以先預測,往某個方向推,杯子會移動到哪裡,繼續推會不會到桌邊,再根據預測的結果行動。
不過,無論是 VLA 還是世界模型,都還面臨一個更難的問題:現實世界的變化幾乎無法被窮舉。
VLA 的能力很大程度上取決於訓練資料覆蓋了多少任務、場景和變化。世界模型要精準建模複雜的物理環境,需要學習大量狀態變化和互動規律,資料與計算成本也隨之提高。
而樂享選擇的路徑,更強調在目標與約束之間持續尋找可行的行動方案。仍以放杯子為例,機器人既要讓杯子到達指定位置,也要考慮手臂是否夠得到、移動時是否會碰到其他物品等因素,如果眼前的資訊不足以作出判斷,還需要補充觀察。重點在於,要讓這些要求共同參與動作的生成,並在執行結果返回後繼續調整。
樂享提出的“能量驅動”,正是試圖通過統一的能量函數,協調任務目標與不同約束。
“能量”在這裡可以理解為衡量狀態或方案是否合適的數值。在能量模型的一般表述中,可以用 E(x, y) 衡量已知條件 x 與候選答案 y 的匹配程度。x 代表已知條件,比如環境、任務和身體狀態;y 代表待尋找的答案,比如一段動作軌跡。
按照其公開說明,以太大模型將目標完成度、物理後果、記憶一致性,以及動作能否執行、是否穩定等因素,納入統一的能量函數,模型沿能量梯度開展持續推理、主動探索和動作生成。
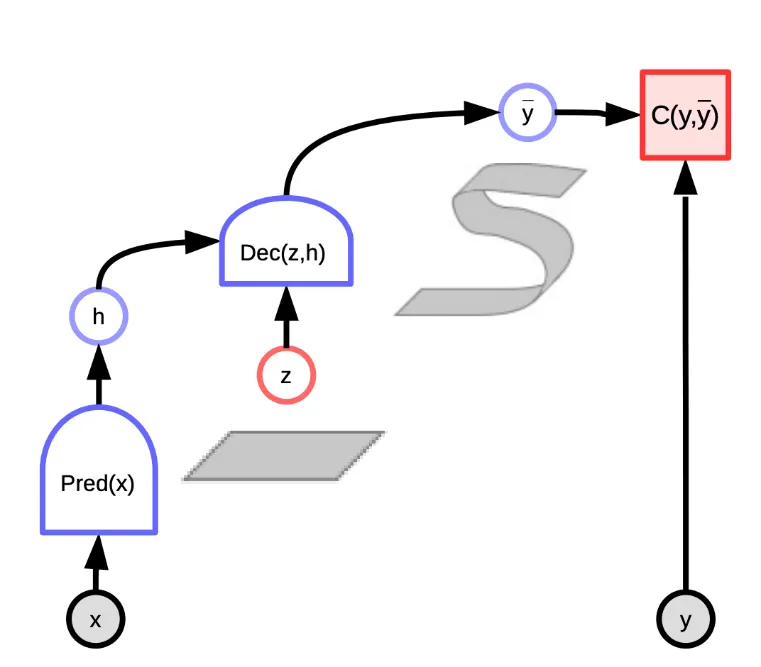
通俗地說,系統需要尋找一個既接近目標、又滿足執行條件的方案。各種選擇由統一的能量評價引導,讓資訊獲取、任務判斷與動作生成圍繞共同的目標展開。
不過,評價一個方案是否合適,還需要感知、記憶和身體控制提供支援。系統要知道眼前發生了什麼、此前做到了哪一步,以及這副身體能夠完成哪些動作。以太大模型所強調的“仿生架構”,正是對這些功能的組織。
03. “仿生大腦”的經驗法則
“仿生”其實是仿人,要讓機器人像人一樣,就得參考人的大腦。以太公開的架構圖,展示了以太大模型參照腦區功能組織系統的思路。視覺、本體感知、聲音指令和觸覺構成輸入;“上丘”模組負責主動獲取資訊,“角回”負責多模態感知,“內嗅皮層”負責情景記憶編碼,“頂上小葉”對應動力學約束與物理後果模型;隨後是負責推理與抽象的“前額葉”、規劃運動軌跡的“運動皮層”和承擔運動執行的“小腦”。
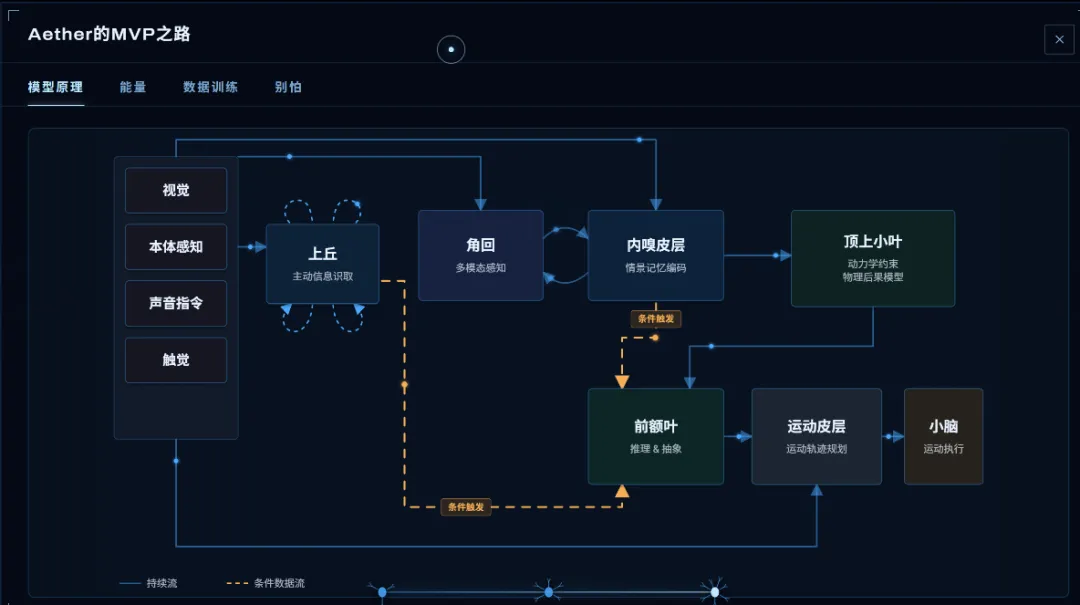
這種分工的意義,可以從動作失誤的處理來理解。抓取時出現輕微偏移,可能只需修正軌跡;如果目標超出可達範圍,就需要改變站位或重新安排任務。不同程度的問題,需要影響不同層次的決策。這套仿生架構成功的關鍵,在於反饋能否及時到達相應模組,並帶來有效調整。
如果要調整,機器人就必須對自身能力和環境同時進行評估。不同機器人的身體條件,也會改變任務的執行方式。樂享此前的居家演示,提供了一個不同本體協作的例子。
在這個 Demo 中,兩台不同品牌的機器人自主協作完成了任務,身材較矮的機器人試圖把圍巾放到高處的櫃子上,伸手卻夠不到。它找到旁邊的箱子,嘗試借此墊高,彎腰搬動未果後,又改用腳推,但仍未解決問題。隨後,較高的機器人接過圍巾,完成了放置。
相同任務換到不同身體上,動作方案也不相同:身高、臂長、關節範圍和末端執行器,都會改變可行的路徑。這段協作展示了如何利用本體之間的能力差異,繼續推進工作。
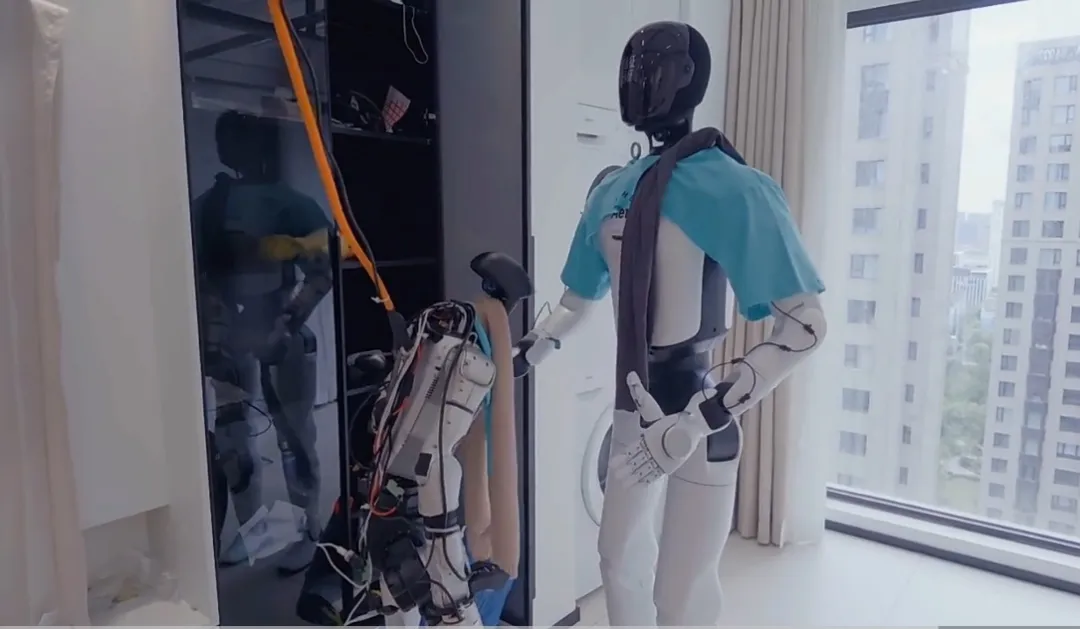
這就是樂享強調的“跨本體”能力所指向的目標:讓同一套模型理解共同的任務,再根據不同機器人的身體條件選擇可行的動作。按照樂享對自我模型(Self Model)的介紹,系統需要表徵自身的能力邊界,將“任務要求做什麼”與“這副身體能夠怎麼做”聯絡起來。
除了調整當前動作,樂享還希望機器人從執行中積累經驗。在前述的直播中,“五弟”試圖抓取一個調料瓶,最初它抓不穩,經過一次嘗試後,它終於找到合適的角度,抓取也逐漸變得穩定。機器人把調料瓶越抓越穩的能力背後,對應著樂享一項與自進化相關的能力:讓執行結果進入記憶與復盤,影響此後的判斷和策略。
這種基於真實互動反饋、持續修正自身的過程稱為“自我迭代”(Self-iteration)。機器人行動前形成預測,行動後比對結果,偏差直接驅動系統更新。新經驗不會無差別寫入,系統會先評估它是否可靠、能否泛化,可靠的規律才會進入長期記憶乃至模型參數。樂享團隊有個更形象的說法:機器人可以給自己建“錯題本”。有價值的不是記住某一次失敗,而是從失敗裡分離出下次能用的規律。
而以太大模型的架構特色也應該放在整套系統中理解:用統一評價機制協調感知、記憶與動作,用功能分層連接任務推理和身體執行,再嘗試將真實互動轉化為後續可用的經驗。
回到戶外燒烤,機器人面對的任務變了,需要解決的問題卻相通:理解新增要求,根據現場條件調整行動,並記住尚未完成的工作。直播進一步把這些能力放進了連續服務的過程,模型需要在變化不斷髮生的情況下,維持整個任務的進度。
雖然說,近 1 小時的直播還不足以驗證長期運行的穩定性,但它提供了一個更接近實際使用的觀察窗口:讓外界看到,機器人能否自主判斷、持續行動和進化,並把事情做完。
對具身智能而言,真正的能力邊界,最終要在真實世界中被定義。機器人真正走向通用,靠的不只是學會更多工,而是形成持續理解、判斷和自我調整的能力。以太大模型正在沿著這個方向,探索具身智能的下一階段。 (DeepTech深科技)