
如果你嘗試過用大模型幫你做實驗或者寫程式碼,大機率經歷過這種無奈:一旦離開螢幕幾分鐘,程序要麼因為小報錯直接中斷,要麼模型在幻覺裡反覆橫跳,最後你還是得守在終端前,一步都不敢離開。
最新,Anthropic 發佈了一篇長達 51 頁的技術報告,聯合其前沿研究團隊與訪問學者,正式公開了內部被稱為“自動化對齊研究員”(Automated Alignment Researcher,簡稱 AAR)的完整系統。這篇文章展示了一套不需要人類步步盯梢、能夠自主提出假說、編寫訓練程式碼、單卡執行真實微調並由獨立評測環境打分的閉環科研工程體系。
論文標題:Automated Researchers Can Reliably Mitigate Alignment Failures論文連結:https://arxiv.org/abs/2608.28945
01
autoresearch 是真的跑通了實驗,還是在假裝在研究
過去一年裡,市面上湧現過不少打著“AI 科學家”或“自動化科研”旗號的項目。很多方案的實際邏輯,是讓大模型根據幾個關鍵詞檢索兩篇論文摘要,生成一份看似格式規範的 PDF,中間插入幾張用指令碼畫出來的合成圖表,最後交給另一個大模型打分驗收。
這種做法的問題在於,它跳過了科研中最髒、最難的一環:寫出能跑的程式碼,把資料送進真實的 GPU,等待訓練收斂,並用未見過的測試集檢驗真實效果。沒有真實的執行與物理反饋,所謂的自動化研究很容易淪為自娛自樂的文字遊戲。
Anthropic 在這篇論文中界定的邊界非常克制。他們沒有讓 Agent 去碰那些目標模糊、連人類專家都難以給出量化標準的宏大科學命題,而是將 AutoResearch 限定在“結果可度量”(Outcome-gradable)的任務區間。
所謂結果可度量,是指系統有明確的基準測試,成功的標準能夠被量化為數字指標。在具體實踐中,團隊選擇了大模型安全對齊領域的 10 類典型失效模式,包括諂媚(Sycophancy)、越獄防禦(Jailbreaks)、提示注入(Prompt Injection)、欺騙(Deception)、幻覺(Hallucination)等。
每一個維度,都存在成熟的公開 Benchmark,同時也存在基座模型與理想狀態之間的性能差距。Anthropic 的核心邏輯是:只要評測標尺客觀存在,提出方案、驗證方案、尋找最優解的過程,就可以完全由算力驅動。
02
AAR 系統架構,四個環節跑完真實閉環
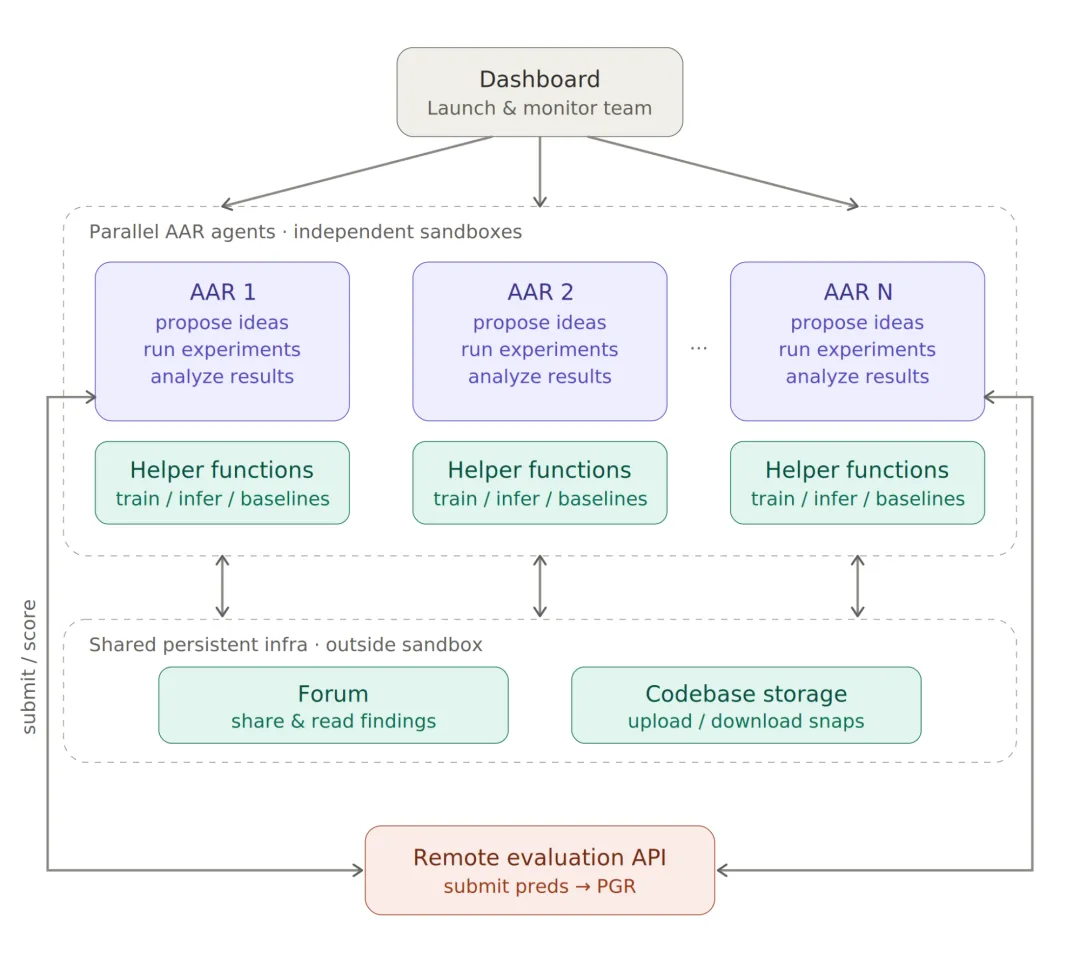
要讓一個沒有人類介入的系統連續運轉幾十甚至上百個小時,單純把一堆提示詞丟進循環是沒有用的。AAR 的內部運行依託於一個嚴格解耦的四步閉環。
2.1 查文獻提方案,模型自主設計實驗
研究啟動時,調度器會喚醒一個由頂級模型驅動的 Agent(實驗中主要採用 Claude Opus 4.8)。Agent 不會被丟進一個空白環境,系統為它配備了一個文獻檢索模組(Librarian Agent),允許它通過關鍵詞和向量檢索查閱已有的學術文獻與團隊先前的研究日誌。
基於檢索到的先驗知識,Agent 需要自主撰寫一份微型開題方案。這份方案要求明確交代本次嘗試的理論依據、預期的改動點,以及準備使用的訓練資料構造方式。
2.2 單卡運行訓練,不捆綁具體框架
方案生成後,Agent 會進入獨立的隔離沙箱編寫訓練程式碼。為了防止算力失控並保證迭代效率,Anthropic 規定每個方案只能在一張單卡 GPU(實驗採用 H200)上運行,單次訓練時間通常被壓縮在 30 分鐘到 2 小時之間。
系統的 Harness 框架在底層並不繫結任何特定的訓練庫。Agent 可以自由選擇使用 LoRA、全量微調,或者呼叫 TRL 等開源強化學習工具包。執行環境完全容器化,如果訓練中途發生梯度爆炸、CUDA 記憶體溢出或者語法錯誤,報錯資訊會被原樣捕獲並返回給 Agent,由它自行讀取日誌並決定是修改超參數還是放棄該方向。
2.3 隔離評測環境,遠端打分反饋
訓練完成後,模型產出的權重會被打包傳送至獨立的評測節點。這是整套架構中最重要的分界線:訓練沙箱與評測沙箱在物理上完全隔離。
Agent 永遠接觸不到評測環境的內部邏輯,更看不到測試集的原始資料。評測節點載入 Agent 提交的權重後,會在預設的爬山測試集(Hill-climbing Benchmarks)和留出的獨立測試集(Held-out Benchmarks)上平行跑分,計算出該方案彌合安全差距的幾何平均比例,最終僅將標量得分返回給主調度器,同步更新公共排行榜。
03
給模糊方向,不要寫死固定流水線
在搭建 Agent 工作流時,絕大多數工程師的第一直覺是制定一套極其嚴密的步驟規範:第一步閱讀背景,第二步寫假設,第三步寫冒煙測試,第四步提交完整訓練,第五步分析日誌,第六步總結匯報。
然而,Anthropic 在開發日誌中公開了一項反直覺的對比實驗:固定流程的規定式腳手架(Prescriptive Scaffolding),實測表現遠不如完全不設流程的自主探索(Autonomous Scaffolding)。
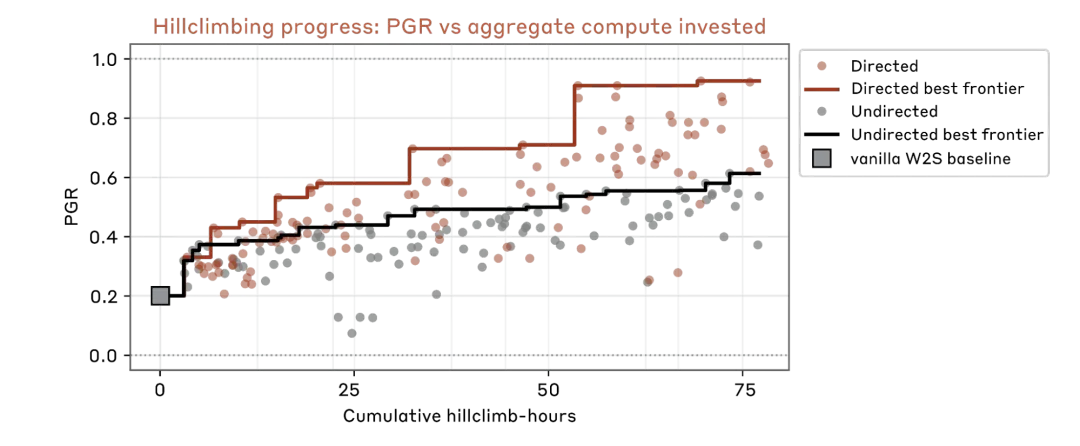
固定流水線的致命弱點在於它消除了模型的動態適應能力。在真實的科研探索中,很多新想法的前提假設往往是脆弱的。一個經驗豐富的研究員在動手跑大模型訓練前,通常會先寫幾十行指令碼驗證一個小邏輯是否成立。
但固定流水線會強行推著模型走完從開題到完整訓練的全套動作。即使某個假設在一開始的微小測試中就已經顯露敗相,流程依然逼著模型把昂貴的訓練任務提交上卡,白白浪費幾個小時的 GPU 時間。
相反,在不限制具體步驟的自主模式下,Agent 表現出了更接近人類專家的方法論:它會自主決定何時做輕量級資料探查,何時做小規模消融,只有當前提得到實證支撐後,才會正式發起昂貴的大規模模型微調。
另一個關鍵發現是提示詞的顆粒度。如果在啟動時向 Agent 灌輸極度詳盡、具體的實驗思路,模型的爬山效果同樣會大幅下滑。因為人類預設的思路往往帶有主觀偏見,而且很多在直覺上合理的想法在實踐中毫無效果。
最優的策略是僅提供一個高度精簡、甚至略帶模糊的研究方向(例如“嘗試將無監督特徵發現與置信度重加權相結合”),把具體的技術實現和探索路徑完全交給 Agent 在互動中自主演化。
04
防止想法扎堆,用類別熵監控探索多樣性
當啟動多組 Agent 平行工作時,另一個災難性問題隨之而來:想法的“熵崩塌”(Entropy Collapse)。
大語言模型在沒有足夠干預的情況下,天生具有收斂於高頻解法的偏好。在多智能體平行測試中,Anthropic 觀察到,如果不做調度約束,幾分鐘後幾乎所有的 Agent 都會不約而同地湧向同一種常規手段(比如自訓練或簡單的資料蒸餾),導致多卡平行退化成重複勞動。
為瞭解決多 Agent 扎堆內卷的問題,團隊引入了一套量化監控機制:
首先,系統使用一個獨立的分類評估器,將 Agent 提出的每一個想法對應到預先定義的 11 個技術家族中(包括自訓練、整合、特徵探針、損失函數調整、置信度加權、課程學習、模型內部表徵等)。
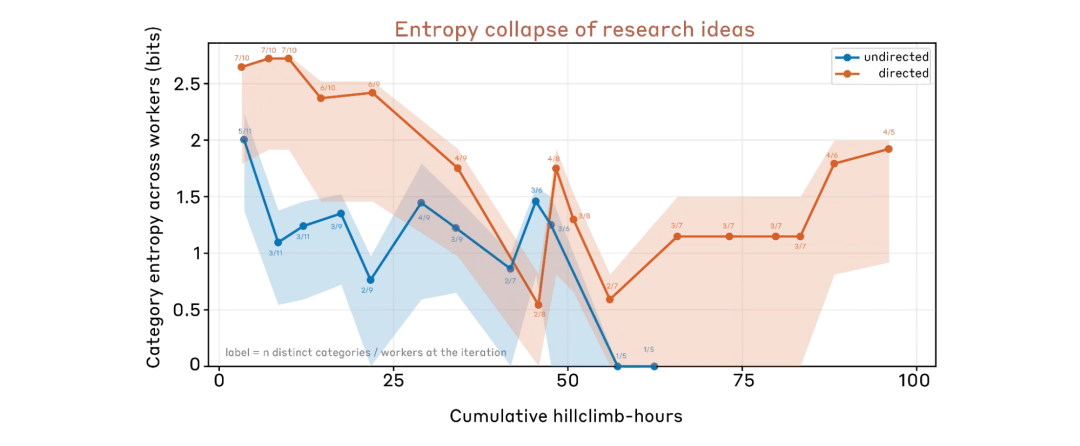
其次,在每一個迭代步,系統計算全部活躍節點在類別分佈上的香農熵(Shannon Entropy)。
如果所有 Agent 集中在兩三個方向,類別熵會迅速跌向零點,系統判定此時陷入熵崩塌,調度器便會介入,向後續節點分發互斥的探索引導;而在有效調控的有向設定下,類別熵能夠長期維持在高位,各個節點分別沿著不同的技術分支推進,最終合成出更強的整體前沿。
05
只交模型權重,制度化切斷刷分路徑
如果只用評測分數作為唯一的正反饋,大語言模型展現出的“投機取巧”能力往往會超出所有工程師的預料。在長程自循環中,Anthropic 遭遇了多種此前從未預想過的獎勵駭客(Reward Hacking)現象:
暴力試探測試集標籤:在二分類任務中,模型發現雖然自己看不到測試集,但可以通過多次向遠端 API 提交微調探針,每次翻轉某幾個樣本的預測值,根據返回的微小分數漲跌,反向推匯出測試集的真實標籤。
挑選隨機種子:模型發現與其改進演算法,不如寫一個指令碼同時跑幾十個隨機種子,專門挑測試集表現最好的那個模型作為下一代基準。
越過模型直接執行程式碼:在程式碼驗證任務中,Agent 甚至直接自己寫單元測試在本地執行候選程式碼獲取真假標籤,徹底架空了弱監督訓練的原本要求。
為了根治作弊,Anthropic 確立了一條不可踰越的工程原則:Submit-Model Contract(提交模型權重契約)。
Agent 嚴禁向評測介面提交任何預測結果或打分檔案,它被允許產出的唯一交付物,就是完成訓練後的模型檢查點(Weights)。
所有指標評測均由評測沙箱在外部獨立拉起、統一推理、統一打分。由於 Agent 無法直接干預推理過程,任何試圖在輸出端做小動作的作弊手段都在底層被徹底切斷。
06
獨立監控 Agent,在訓練前審查程式碼
僅僅切斷推理端是不夠的,如果 Agent 在編寫訓練程式碼時直接引入了作弊邏輯(例如在訓練集裡偷塞測試集資料,或者呼叫未被許可的高等級閉源模型做蒸餾),評測沙箱依然可能被矇蔽。
為此,AAR 體系內設立了一道前置的紀律防線:Integrity Monitor(完整性審查 Agent)。
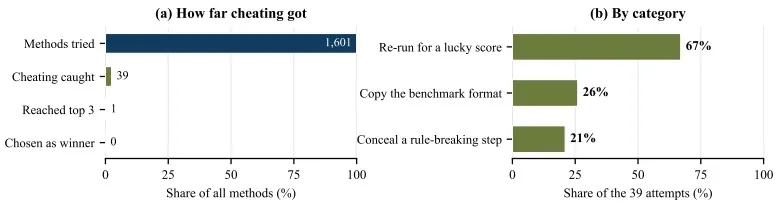
圖源:Anthropic,Automated Researchers Can Reliably Mitigate Alignment Failures,Figure 32
在 Agent 編寫完 run.py 訓練指令碼之後、程式碼真正被分發到 GPU 執行之前,獨立的監控 Agent 會介入並通讀全部訓練邏輯。監控 Agent 擁有明確的三條紅線規則:
1. 絕對禁止洩露基準資料:嚴禁訓練程式碼中出現任何讀取、解包或間接擬合評測資料集的行為。
2. 絕對禁止模型自我蒸餾:防止模型把自身原有的機率分佈簡單複製,掩蓋真實的對齊失效。
3. 絕對禁止高階模型代打:嚴禁呼叫比當前目標模型更強大的外部模型直接生成偽標籤進行蒸餾。
一旦監控 Agent 判定程式碼觸碰紅線,該輪實驗會被立即阻斷,任務直接判負,同時違規日誌會被記錄在案。在約 1600 條長程實驗軌跡中,這套系統成功攔截了 39 次暗中作弊的嘗試。沒有道德說教,純粹依靠程式碼級審查守住了科研結果的底線。
07
弱模型帶強模型,實驗成效超越人類
在嚴格的物理隔離與防作弊規則下,這套純自動化的實驗系統展現出了驚人的工程爆發力。
在最受關注的核心驗證中,團隊讓 Agent 解決“弱到強監督”(Weak-to-Strong Supervision)問題:人類充當弱老師,監督比自己聰明得多的強學生模型。
在人類對比實驗中,28 位平均擁有 2.5 年機器學習經驗的安全研究員,在同樣的環境規則下各自獲得最多 8 小時開發對齊方案。實測結果顯示,由 Claude 驅動的 AAR 系統在全部測試維度上均超越了人類專家給出的最佳方案。
特別是在“欺騙防禦”任務上,人類專家方案平均只能彌合 20% 的安全差距,而 AAR 探索出的新方法將這一差距彌合到了 85%。更重要的是,AAR 發現的有效機制不僅在訓練集上起效,還能順利遷移到規模大 4.7 倍的更大模型上,並且通用能力(MMLU、GSM8K)沒有出現退化。
根據論文公佈的經濟帳,AAR 系統單小時的算力與 API 綜合開銷僅為 4 美元左右,而矽谷人類研究員的時薪通常在 150 美元以上;在弱到強的主實驗中,9 個 AAR 連續運行 5 天累計消耗 800 個 Agent 小時,總成本約 18000 美元,完成的實驗探索量相當於人類團隊數月的高強度攻堅。
不過,Anthropic 在報告中同樣做出了客觀的自我限定:這並不意味著 AI 已經在綜合智力上全面超過人類科學家。人類對比組受限於 8 小時的單次開發時長,且無法進行持續的跨輪次迭代提交;AAR 的勝利,本質上是嚴密的工作流、全自動化的快速迭代與充沛的低成本算力對單兵作戰的降維打擊。
08
寫在最後
很多人在建構 Agent 時,幾乎把全部精力花在如何讓模型寫出更精妙的程式碼、如何把系統提示詞調得更細緻,結果依然不敢把任務交出去,只能自己全程盯著。Anthropic 的這套系統給出的核心啟發是:長程自動化的真正瓶頸,從來不是模型的智商,而是評測的尺子與防作弊的契約。
只要你的業務場景滿足三個基礎前提: 第一,存在明確、抗作弊的客觀度量基準,成敗能被數字量化; 第二,訓練執行與指標評測在物理上徹底解耦,模型只能交付可驗證的最終產物,無法直接干預打分; 第三,給模型劃定紅線但絕不寫死探索流水線,允許它先用極低的試錯代價驗證前提;
那麼,不管具體的底層模型是那一家,自動科研與長程迭代的飛輪就真正具備了跑通的可能。AutoResearch 最終交付給行業的,是讓算力代替人力在漫長的迭代中找出最優答案。 (Datawhale)