
Claude Sonnet 5.5是比Opus 5.5更快、更低成本的補充,是迄今速度最快的Sonnet模型,在低或中等努力水平下,以約Sonnet 5十分之一的成本就超過Sonnet 5的最佳得分;首次擁有與Anthropic最強模型類似的網絡安全防護機制和fallback機制。據獨立平台Artificial Analysis測試,Sonnet 5.5能力逼近Opus 5.5,但在最高推理強度下,單任務平均耗用輸出Token為各模型之最。
繼上周發佈旗艦模型Claude Opus 5.5後,Anthropic再次擴充Claude 5.5家族,推出Opus 5.5的低成本替代互補方案Sonnet 5.5。
美東時間28日周一,Anthropic推出Claude Sonnet 5.5,稱這是Claude 5.5家族的第二款模型。與上一代Sonnet 5相比,新模型輸出速度提升超過30%,在保持API價格不變的情況下,由於完成相同任務通常所需的Token更少,單項任務成本最高可下降30%。
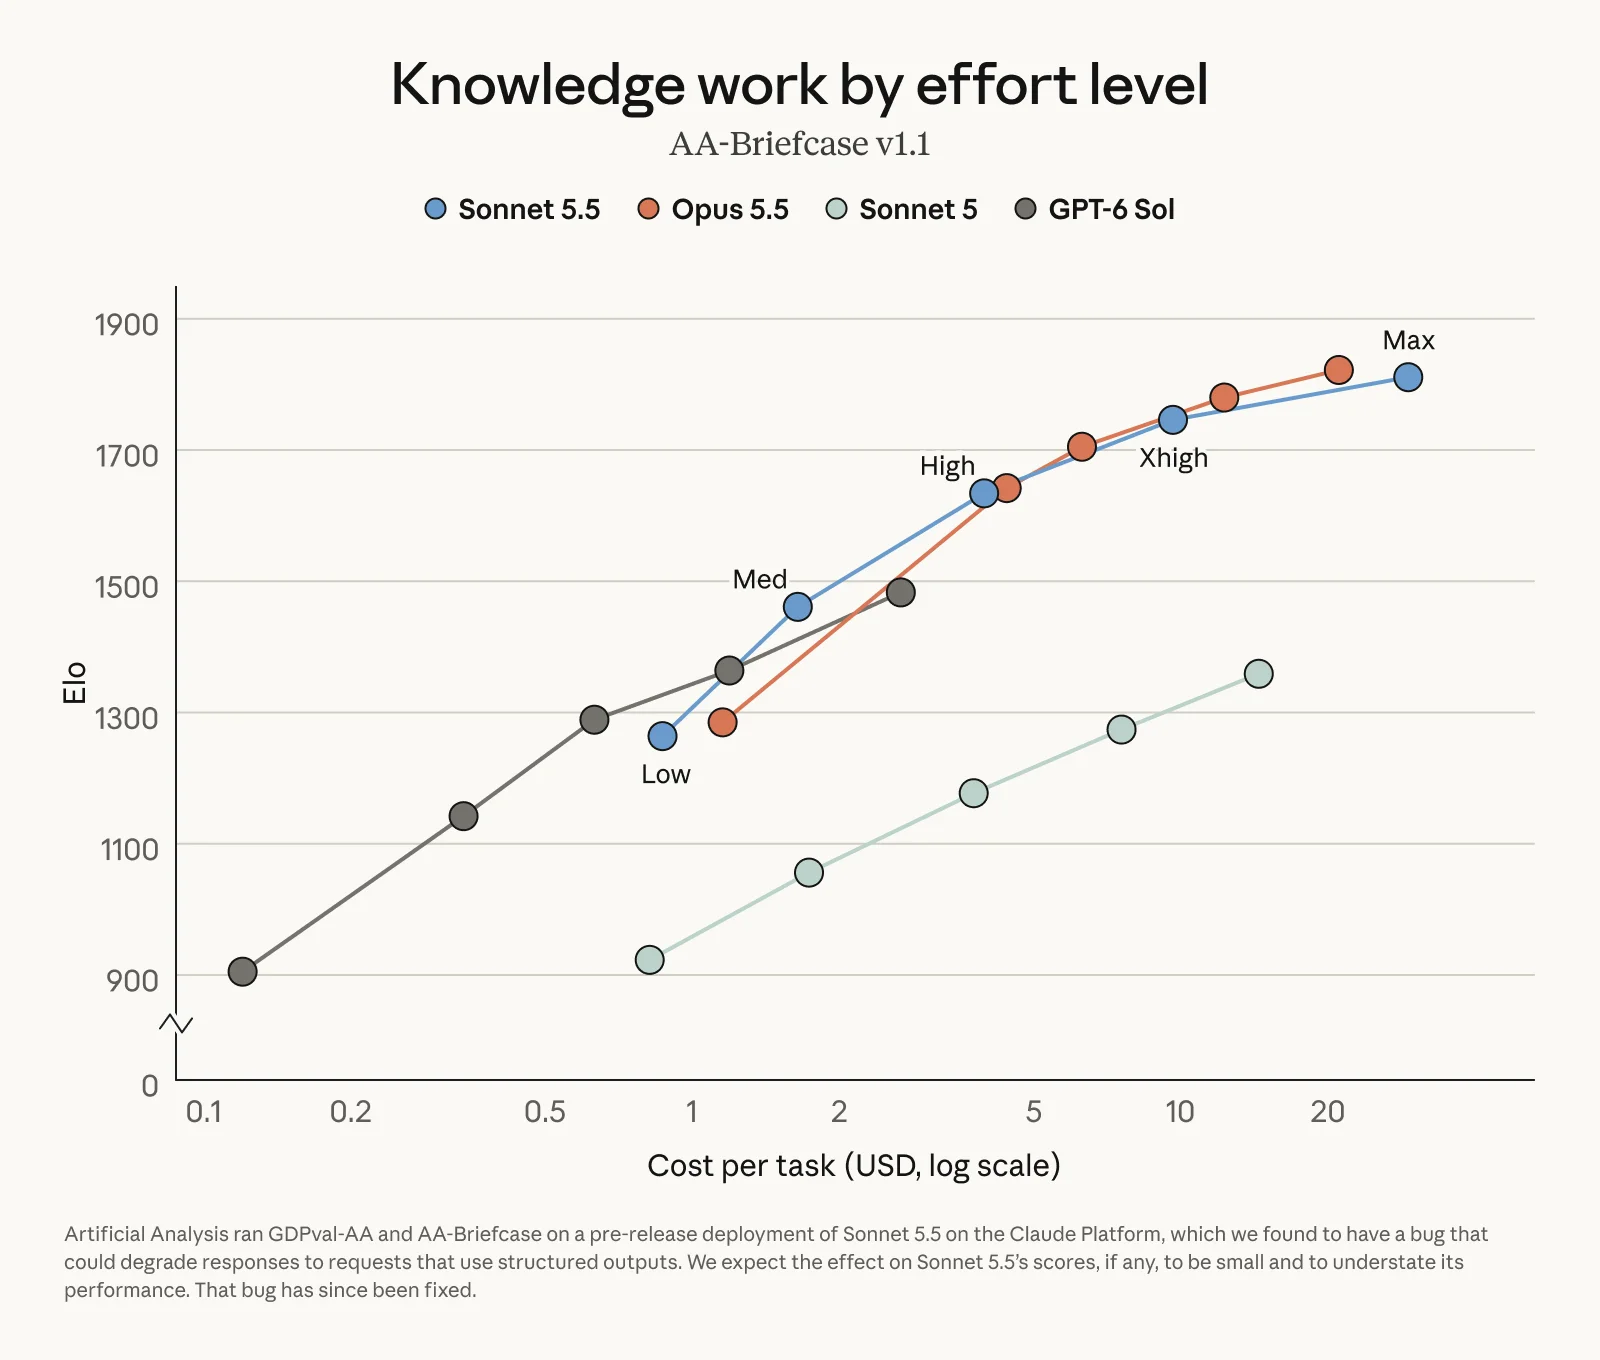
在多項基準測試中,Sonnet 5.5 在低或中等努力水平下,以大約Sonnet 5十分之一的成本就超過了Sonnet 5的最佳得分。
Anthropic表示,Sonnet 5.5尤其適合日常知識工作、修復代碼、製作文檔、幻燈片和電子表格等「邊界清晰」的任務,是更強大的Opus 5.5之外、更快且成本更低的工作夥伴。公司同時稱,新模型是迄今速度最快的Sonnet模型。
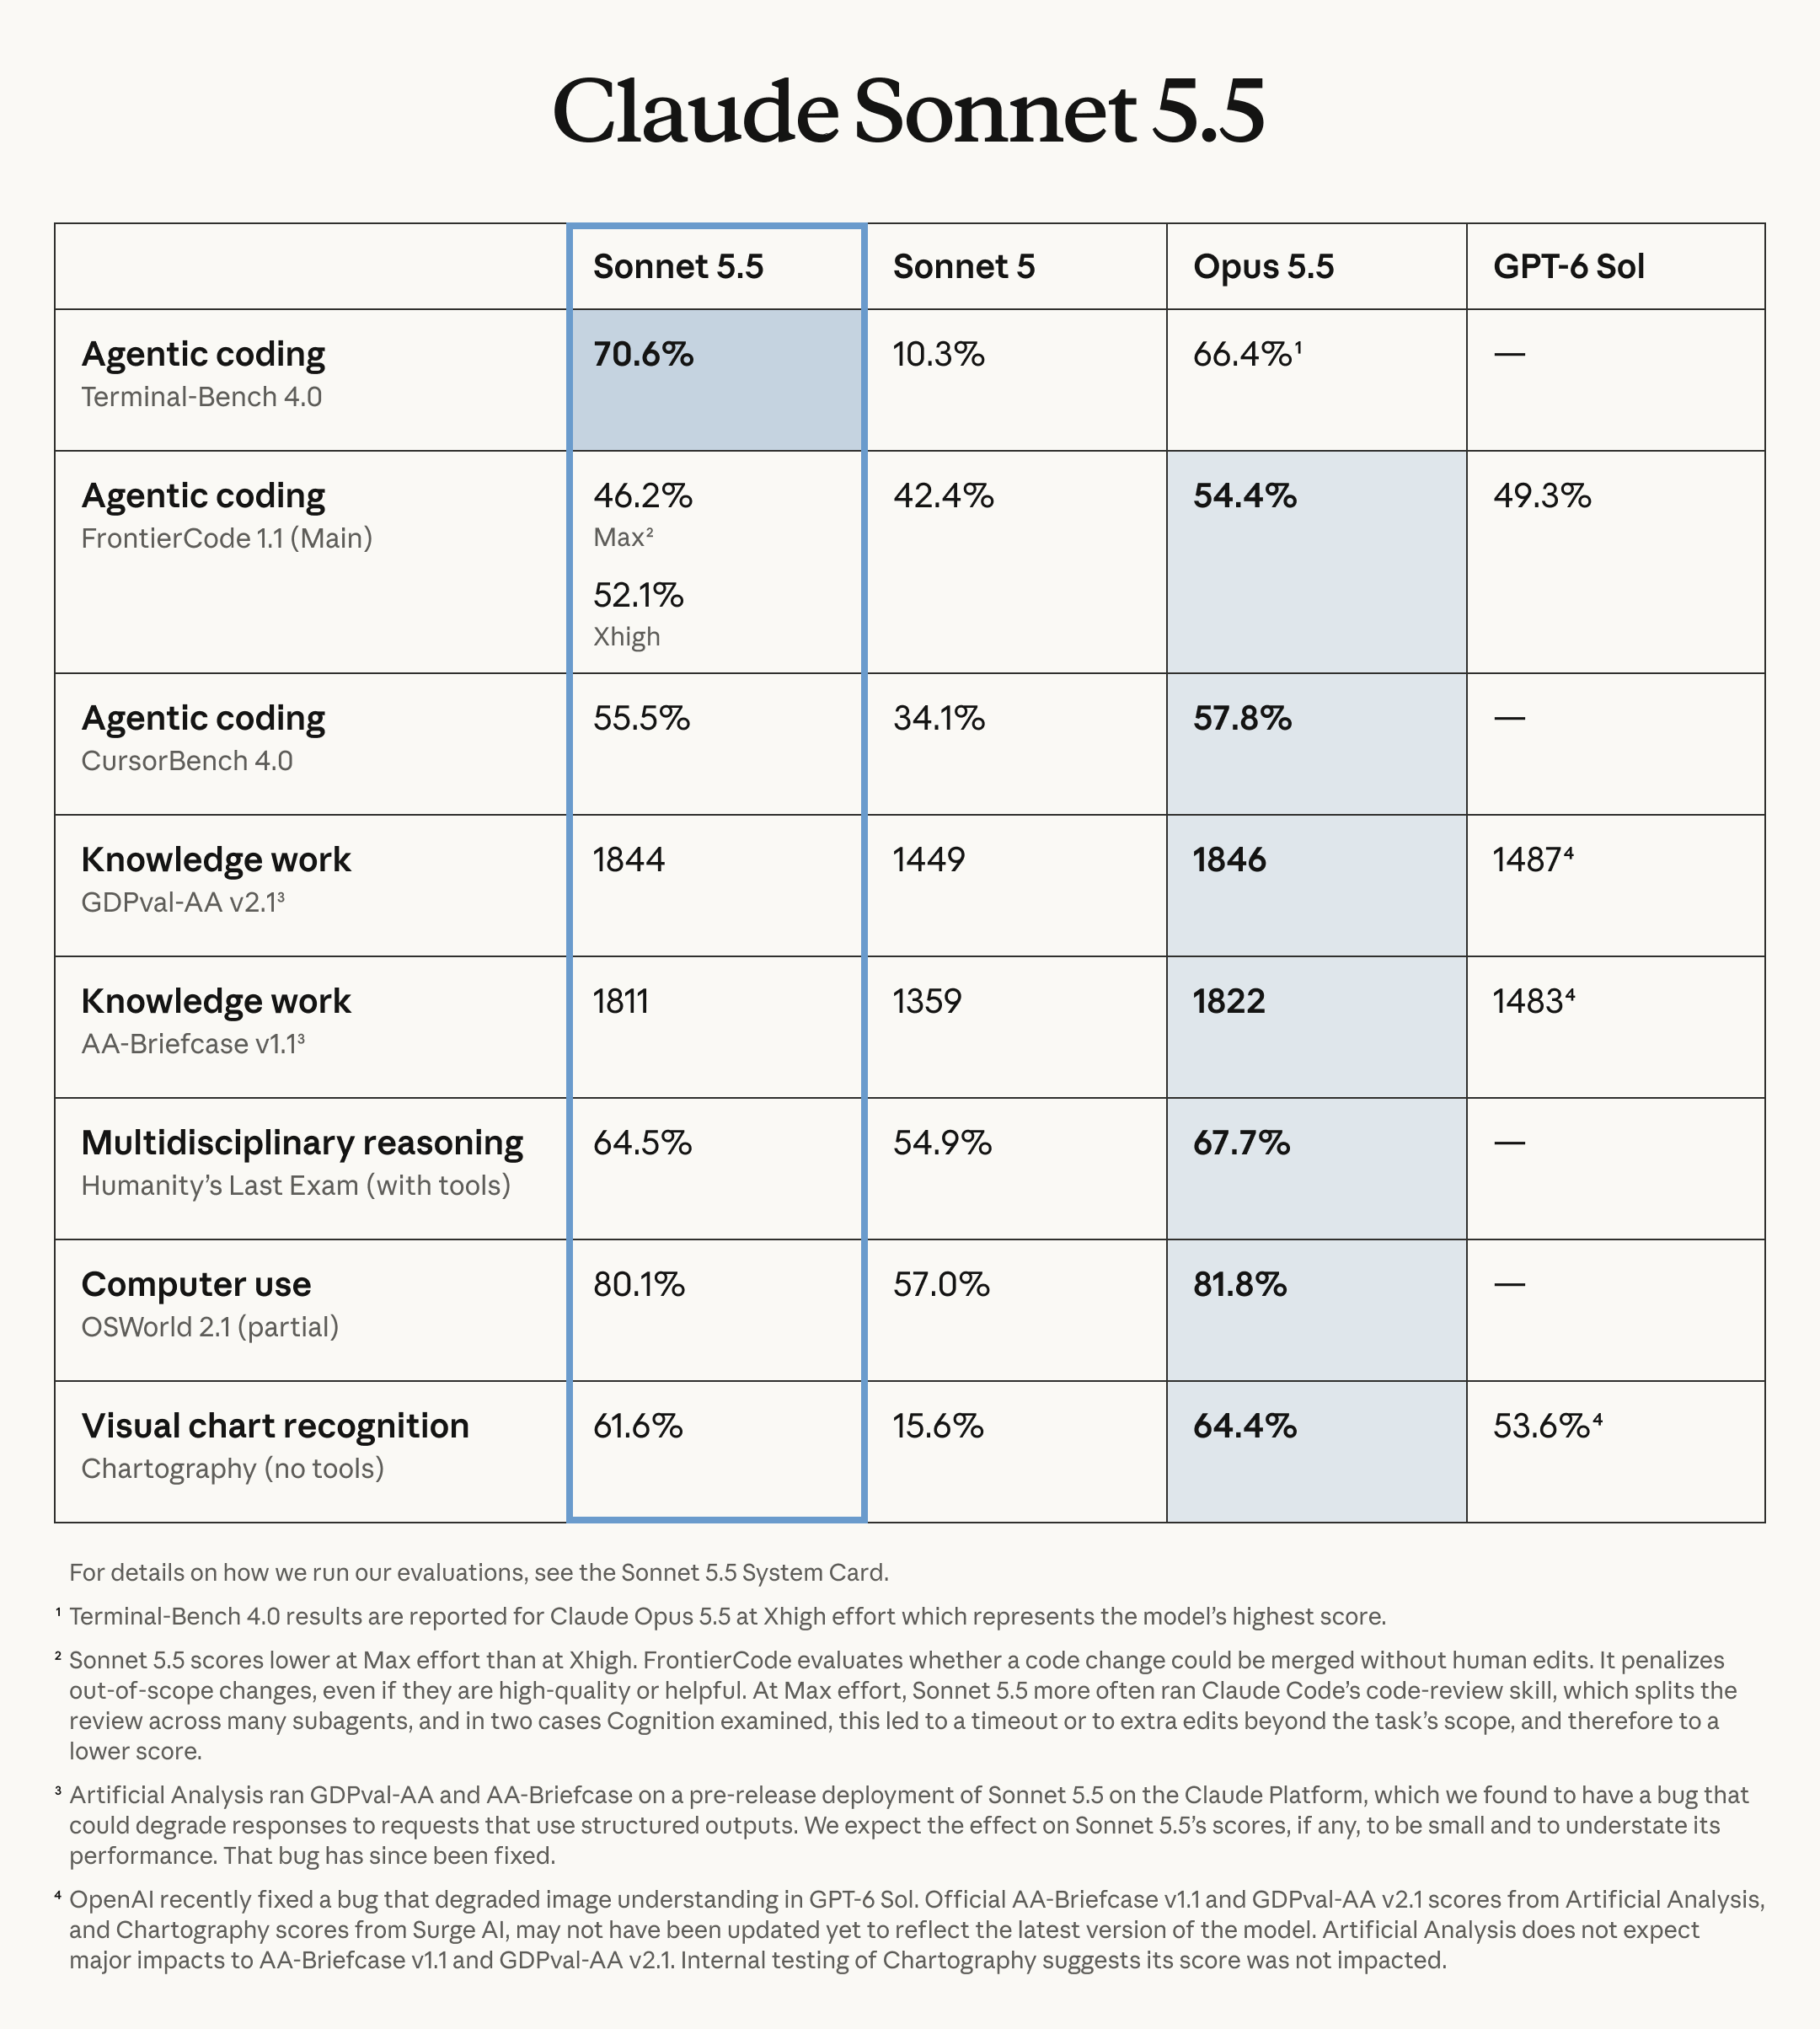
值得注意的是,第三方AI基準測試平台Artificial Analysis的數據顯示,在最高推理強度下,Sonnet 5.5的綜合智能指數達到56分,僅比Opus 5.5低2分,並在部分智能體和知識工作測試中與Opus 5.5基本持平。不過,要達到接近Opus 5.5的表現,Sonnet 5.5也付出了較高的Token消耗代價。
不漲價,卻能把單任務成本壓低三成
Sonnet 5.5此次最直接的賣點並不是降低API標價,而是用更少的Token和更快的生成速度完成相同任務。
Anthropic表示,Sonnet 5.5的API價格與Sonnet 5保持一致,為每百萬Token輸入2美元、輸出10美元;但在內部測試中,新模型完成相同工作通常需要明顯更少的Token,因此單任務成本最高可以下降30%。
與此同時,Sonnet 5.5的輸出速度比Sonnet 5快30%以上。Anthropic稱,這意味著用戶不僅能夠以相同的Token單價獲得更快響應,還能夠在更多任務中減少模型調用和工具調用次數,從而進一步壓低實際使用成本。
媒體指出,Anthropic此次強調的「30%成本下降」實際上更多來自效率提升,而非價格下調:模型通過更少的工具調用、更少的Token以及更快的輸出速度完成工作,因此實際每項任務的成本下降。
Anthropic還表示,在部分基準測試中,Sonnet 5.5在Low或Medium推理強度下,就可以超過Sonnet 5此前的最佳成績,而成本約為後者的十分之一;在另一項編程測試中,Sonnet 5.5在High模式下的成績比Sonnet 5高約10個百分點,但單任務成本約為後者的十五分之一。
這意味著,Anthropic此次升級的重點並不是簡單地把模型推向「更強」,而是試圖擴大性能—成本曲線上的可用區間:對於不需要旗艦模型的日常任務,用戶可以用較低的推理強度換取更快、更便宜的結果;而在複雜任務上,則可以提高推理強度,進一步逼近Opus級別的能力。
第三方測試:能力逼近Opus,但Token消耗創紀錄
Artificial Analysis的測試則提供了另一幅更復雜的圖景。
該平台表示,Sonnet 5.5在其Intelligence Index中獲得56分,在最高推理強度下較Sonnet 5提升18分,排名僅次於Opus 5.5。其在Terminal-Bench 4.0中的得分達到64%,高於Opus 5.5和GPT-6 Astra的60%;在AA-Briefcase、GDPval-AA和AutomationBench-AA等測試中,也與Opus 5.5達到近似水平。
但Artificial Analysis同時指出,Sonnet 5.5為獲得這樣的成績消耗了非常多的輸出Token。
在最高推理強度下,Sonnet 5.5每個Intelligence Index任務平均使用約19.3萬個輸出Token,這是該平台測試過的模型中最高的水平,比Opus 5.5或Sonnet 5高出約60%,更是GPT-6 Astra的約7倍。
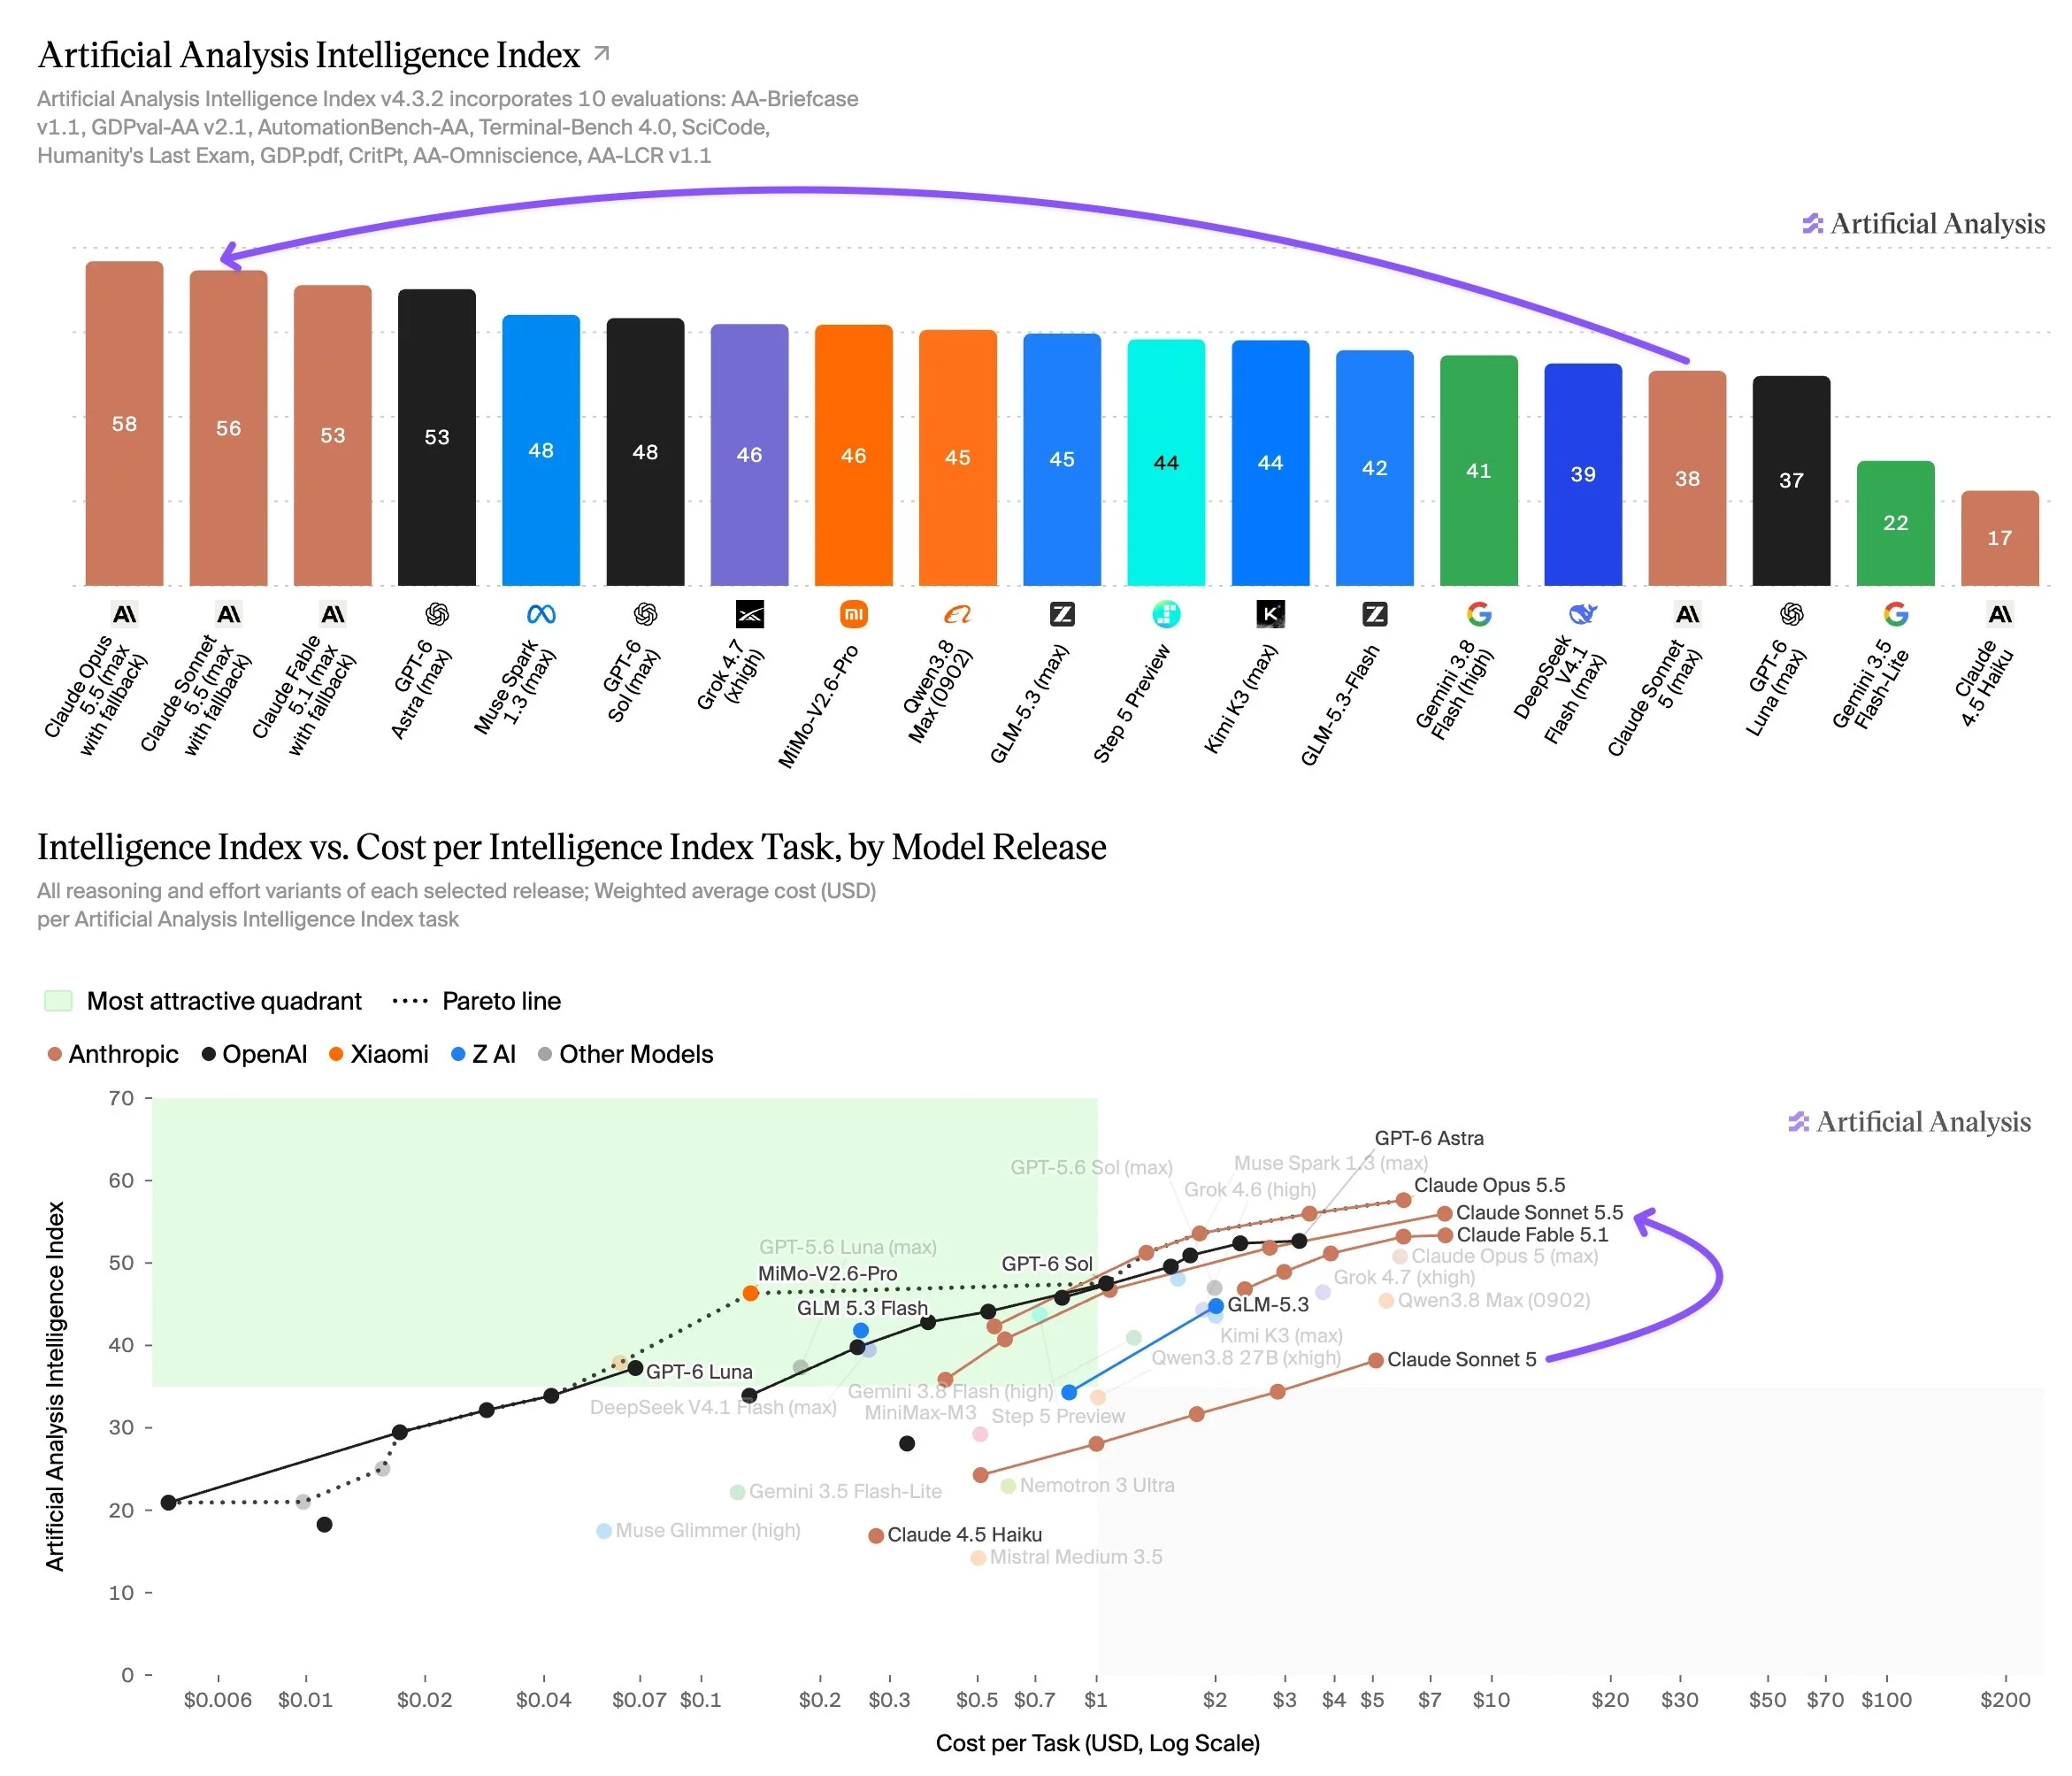
這也形成了此次發佈一個頗值得關注的反差:Sonnet 5.5的API標價沒有上漲,但如果用戶選擇最高推理強度,模型為了追求更高性能所消耗的Token可能大幅增加。
Artificial Analysis據此認為,在「智能水平—單任務成本」的比較中,Sonnet 5.5並非所有推理強度都處於最具成本優勢的位置;高強度模式下,其性能已經非常接近Opus 5.5,但Token消耗也隨之明顯上升。
不過,這些測試是在Sonnet 5.5正式發佈前的版本上進行的。Artificial Analysis表示,Anthropic後來發現該預發佈版本存在一個可能影響結構化輸出請求的Bug,並已在正式版本中修復,因此相關評測還將重新進行。由此來看,目前第三方數據更適合作為參考,而非最終性能定論。
從「寫代碼」擴展到辦公生產力
相比Opus 5.5主要面向複雜編程、智能體和知識工作,Anthropic對Sonnet 5.5的定位明顯更加偏向日常生產力。
Anthropic稱,新模型擅長修復Bug、製作經過潤色的文檔、幻燈片和電子表格,同時具備更強的設計能力,可以進一步完善用戶介面,並根據範本製作只需少量人工修改的簡報。
公司還特別強調了模型的文字表達能力。Anthropic表示,和上一代模型相比,Sonnet 5.5能夠寫出更加清晰的內容,而更快的速度也使其適合快速迭代和多人協作。
從產品策略來看,這意味著Anthropic並沒有試圖讓Sonnet 5.5完全替代Opus 5.5,而是進一步拉開兩者的產品定位:Opus承擔最複雜、最需要能力的任務,Sonnet則爭奪規模更大的日常工作和高頻任務。
TechCrunch也將Sonnet 5.5描述為Anthropic更偏向日常工作的「更快、更便宜的工作夥伴」,並指出其重點應用場景包括編程和辦公文檔處理。
安全護欄首次向Sonnet級別下沉
除了速度和成本,安全能力也是此次升級的重要變化。
Anthropic表示,Sonnet 5.5在自動化行為審計中,大多數alignment和誠實性指標都優於或持平Sonnet 5。同時,新模型首次擁有與Anthropic最強模型類似的網絡安全防護機制和fallback機制。
當模型面對特定高風險網絡安全任務時,可以啓用更嚴格的安全護欄並將部分請求轉交給其他模型;而對於普通軟件開發任務,Anthropic稱這一機制不會產生影響。
這一變化尤其值得關注,因為此前Sonnet系列與Opus系列在網絡安全能力和安全防護上的定位存在明顯區別。Anthropic此次讓Sonnet 5.5獲得更接近旗艦模型的安全機制,也意味著隨著中端模型能力越來越接近前沿水平,安全控制正在從旗艦模型向更廣泛的模型層級下沉。
而這也延續了Anthropic此前發佈Opus 5.5時的產品思路:模型能力提升與安全護欄同步推進。上周發佈的Opus 5.5同樣強調了網絡安全等高風險場景的安全機制。
Claude 5.5家族還缺最後一塊拼圖
Sonnet 5.5是Claude 5.5家族繼Opus 5.5之後的第二款模型。
Anthropic表示,Sonnet 5.5現已全面上線,未來幾周還將推出Claude Haiku 5.5。屆時,Claude 5.5家族將進一步覆蓋從高端複雜任務到日常高頻任務、再到更強調速度和成本的不同應用場景。
這也是Anthropic近期連續更新模型家族的延續。9月22日發佈的Opus 5.5定位於更高端的智能體編程和知識工作,運行成本較Opus 5下降40%;如今Sonnet 5.5則在保持原有價格的基礎上,通過降低Token消耗和提升速度來降低單任務成本。
從商業化角度看,Anthropic正在將模型競爭的重點從單純的「誰的基準測試分數更高」,進一步推向單位任務成本、響應速度、Token效率和安全性。
而Artificial Analysis此次測試暴露出的另一個趨勢同樣值得關註:當中端模型通過提高推理強度不斷逼近旗艦模型時,「模型本身的API價格」可能已經不足以衡量真實使用成本,完成一項任務究竟需要多少Token、多少次工具調用以及多長時間,正在成為AI模型商業競爭的新變量。(華爾街見聞)