
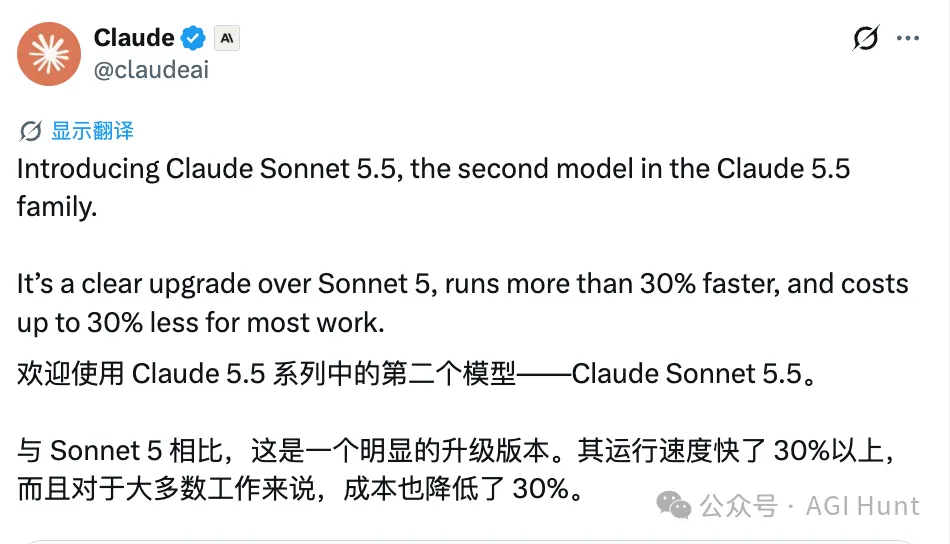
剛剛,Anthropic 發佈了 Claude Sonnet 5.5,這是 Claude 5.5 家族的第二個模型。
距離上周 Opus 5.5 的發佈,剛好過去了一周。
Sonnet 5.5 官宣
Claude 的官宣推文中寫道:
相比 Sonnet 5,這是一次明確的升級:速度快了 30% 以上,大多數工作的成本最多降低 30%。
價格則和 Sonnet 5 保持一致,輸入 $2、輸出 $10(每百萬 token),正好是 Opus 5.5 的一半。
而這個價格,也和上周剛發佈的 GPT-6 Sol 一毛一樣……
01 跑分貼著 Opus 5.5
先來看官方的 benchmark 表:
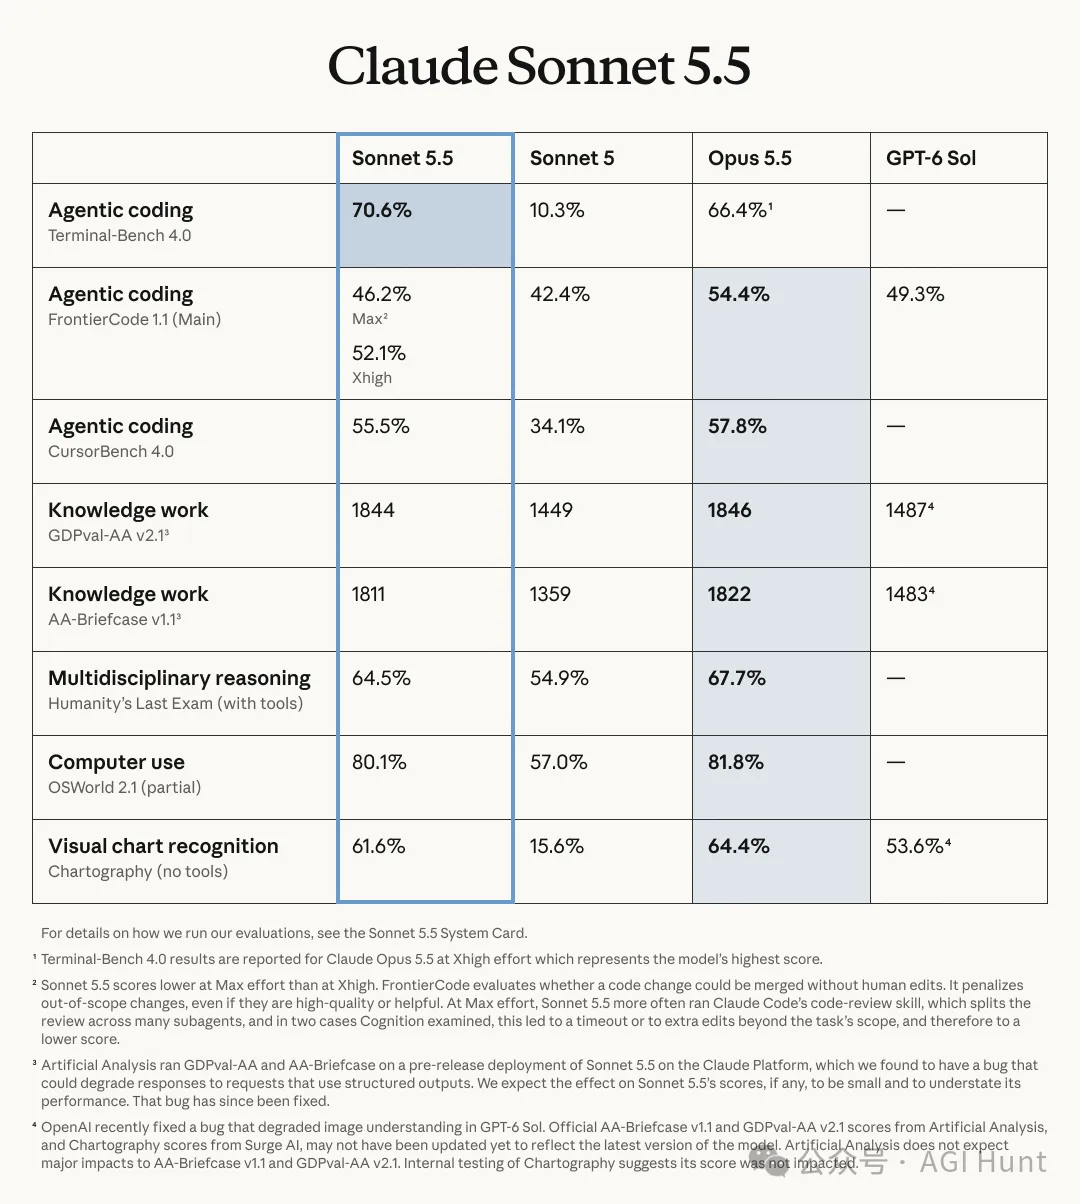
最離譜的當屬 Terminal-Bench 4.0:Sonnet 5 隻有 10.3%,而 Sonnet 5.5 直接幹到了 70.6%,反超了自家大哥 Opus 5.5 的 66.4%。
要知道,Opus 5.5 的這個成績,已經是它開 Xhigh 時的最高分了。
看圖表的 Chartography 也類似,從 15.6% 漲到了 61.6%,差不多翻了四倍。
知識工作的兩項裡,GDPval-AA 上 Sonnet 5.5 拿到了 1844 分,和 Opus 5.5 的 1846 隻差 2 分。OSWorld 的 computer use 上是 80.1% 對 81.8%,CursorBench 上是 55.5% 對 57.8%,也基本是貼著走的。
而同價位的 GPT-6 Sol,在兩項知識工作和 Chartography 上都落後了 Sonnet 5.5 一大截,只有 FrontierCode 的 49.3% 比 Sonnet 5.5 開 Max 時要高(但不如開 Xhigh 時的 52.1%)。
怎麼說呢,一半價格的 Sonnet 5.5,在多數項目上幾乎和 Opus 5.5 性能相當。
官方給它的定位,是 Opus 5.5 的一個更快、更便宜的搭檔,最擅長的是範圍明確的日常任務、修 bug,以及做出精緻的文件、幻燈片和表格。
02 快 30%,也更省 token
Sonnet 5.5 的單價雖然沒降,但干同樣的活,需要的 token 要少得多。在官方的測試中,單個任務的成本比 Sonnet 5 最多能低 30%。
輸出速度也同樣快了 30% 以上,是 Anthropic 迄今為止最快的 Sonnet 模型。
官方放了一段速度對比,讓 Sonnet 5 和 Sonnet 5.5 同時寫一個 boids 鳥群模擬:
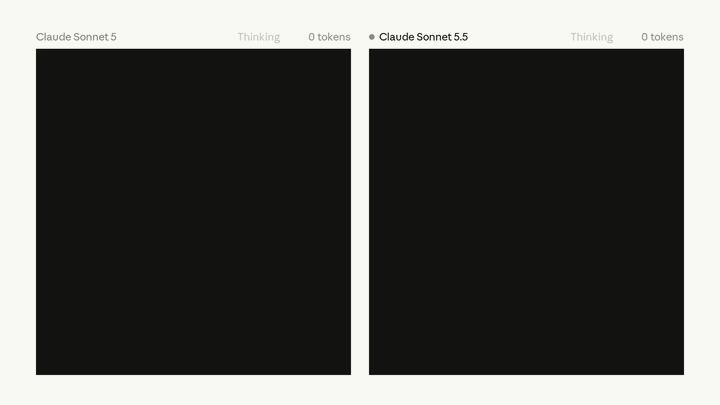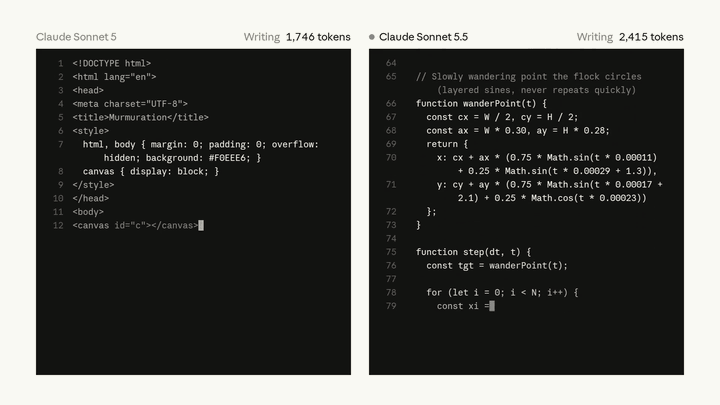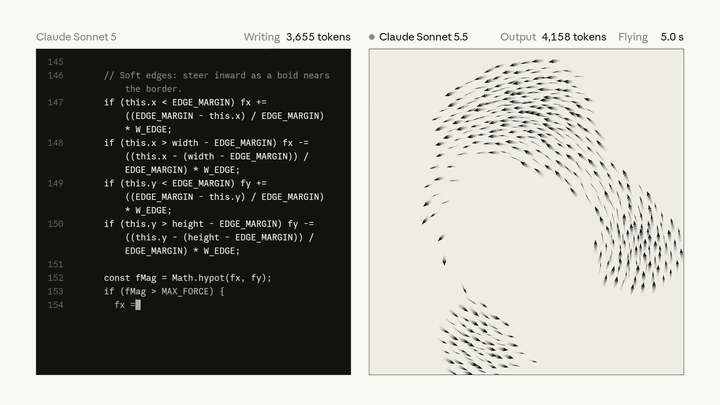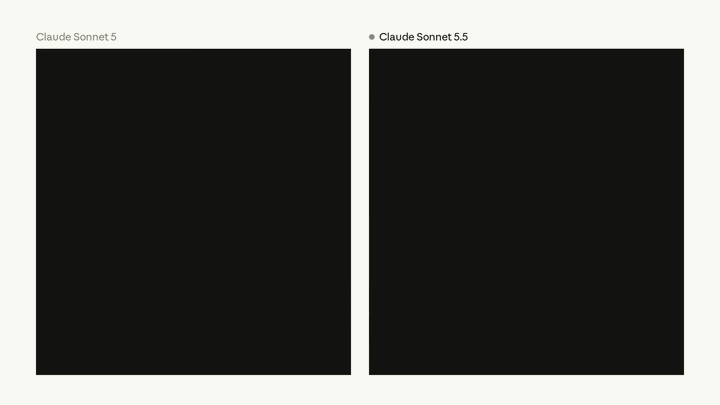
Sonnet 5.5 用了 4,158 個 token 先寫完,鳥群已經飛起來了,這時 Sonnet 5 還在一行行往下寫程式碼,最後多花了將近 500 個 token 才完工。
等到 Sonnet 5 的鳥群開飛,Sonnet 5.5 那邊已經飛了 13 秒多……
早期客戶給出的數字,也是同樣的反饋:
Balyasny 資產管理:金融類任務中,Sonnet 5.5 每個回答大約用 12.1 萬 token,Sonnet 5 則要 49.7 萬。
Box:速度快了 2.4 倍,總 token 少了 12%,找出原始文件裡錯誤的精準率也更高。
Slack:離線評測中超過了 Sonnet 5,用的步數更少,輸出 token 也少了約 14%。
Zendesk:工單處理快了 20%,錯誤決策也更少。
Atlassian:Rovo Agents 換上 Sonnet 5.5 後,最多快了 30%。
Epic Games:在動輒數萬行程式碼的系統設計審計、資料流審查上,達到了「你對更高檔模型才會有的質量標準」。
低 effort 打贏 Sonnet 5 滿配
03
更誇張的一組資料,是關於 effort 檔位。官方稱:
在多個 benchmark 上,Sonnet 5.5 開 Low 或 Medium,就能以大約十分之一的成本,超過 Sonnet 5 的最好成績。
Sonnet 5.5 提供 Low、Medium、High、Xhigh、Max 五檔 effort,Claude 應用裡默認是 Medium,Claude Platform 上默認則是 High。
effort 到底調的是什麼,可以看我前兩天的那篇 Claude Code 官方部落格:Claude Code Thariq:如何設定不同模型的 effort?
先看知識工作的 AA-Briefcase:
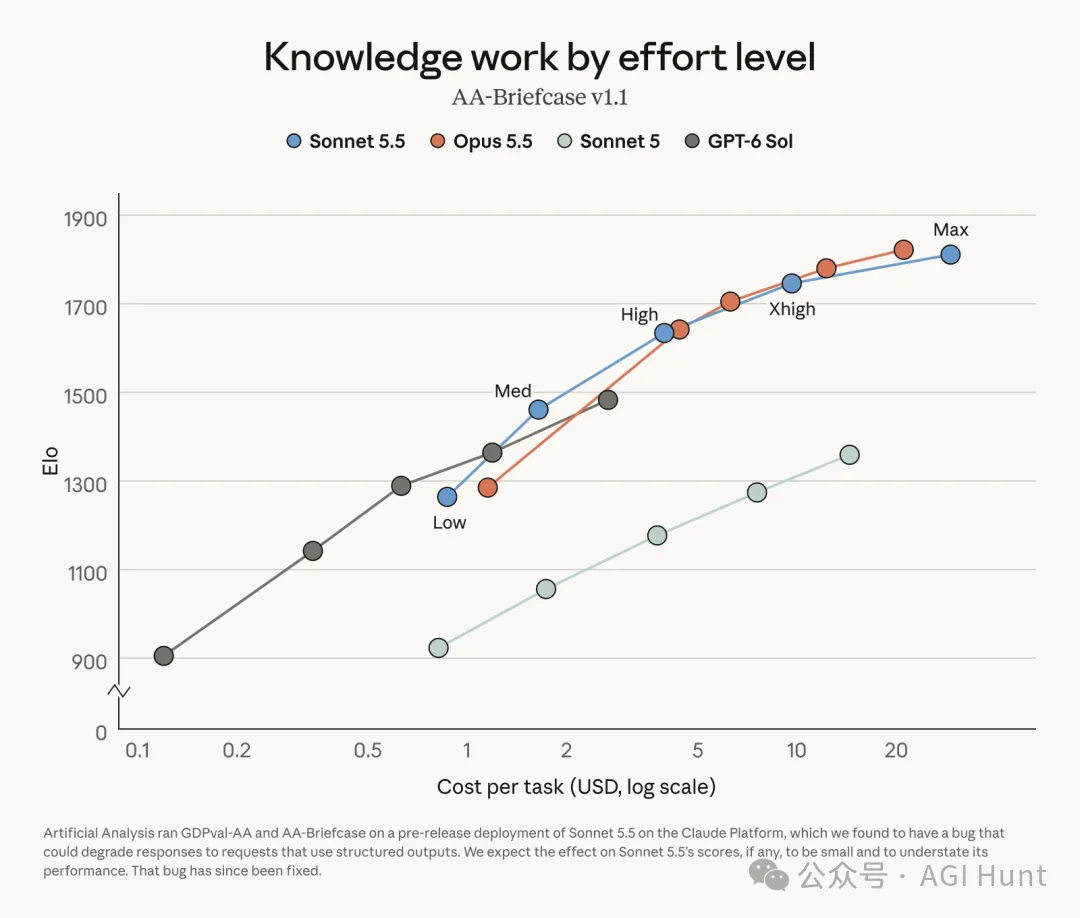
Sonnet 5 開到最高檔,每個任務大約要花 14 美元,Elo 在 1360 上下;而 Sonnet 5.5 隻開 Medium,每個任務 1.6 美元左右,Elo 就已經到了 1460 附近。
CursorBench 4.0 上更直觀,Sonnet 5.5 最低的 Low 檔(每個任務約 0.5 美元)就有 36% 左右,已經超過了 Sonnet 5 滿配的 34.1%:
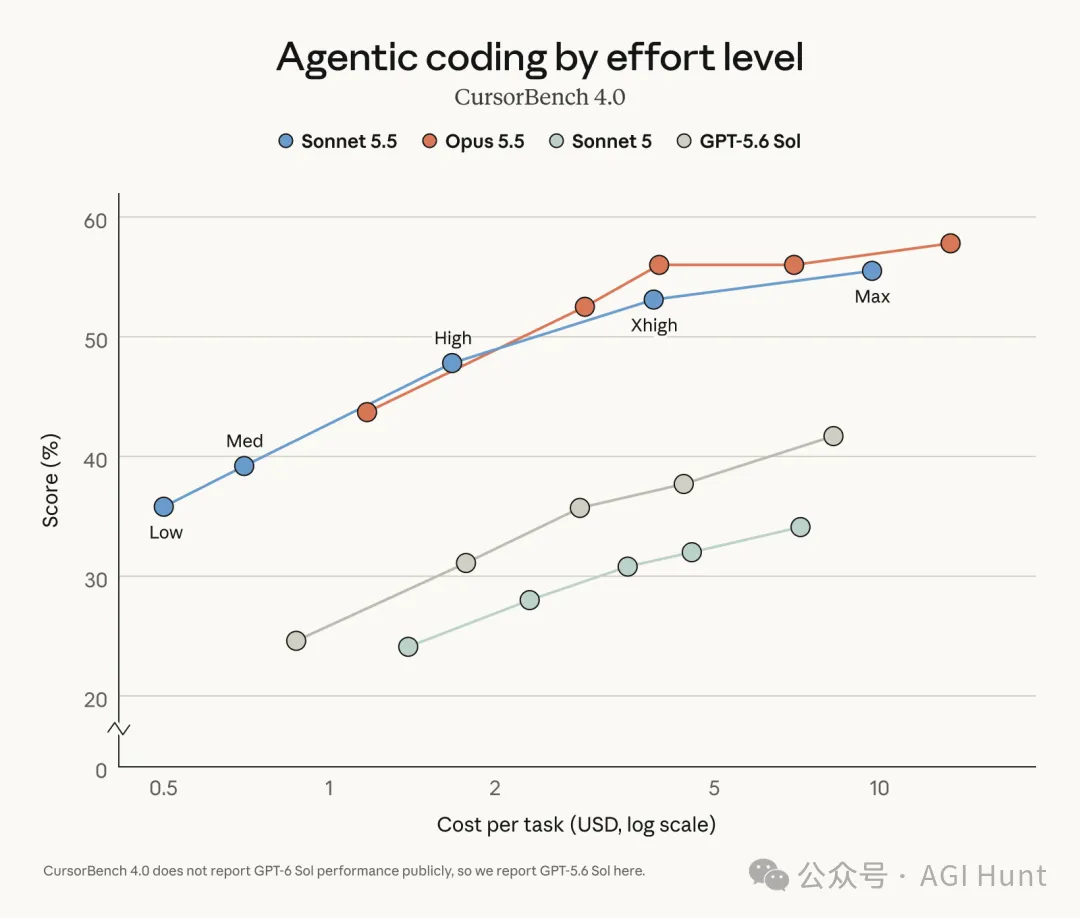
Terminal-Bench 4.0 也是如此,Low 檔的 20% 左右,就已經是 Sonnet 5 最高分的兩倍了。
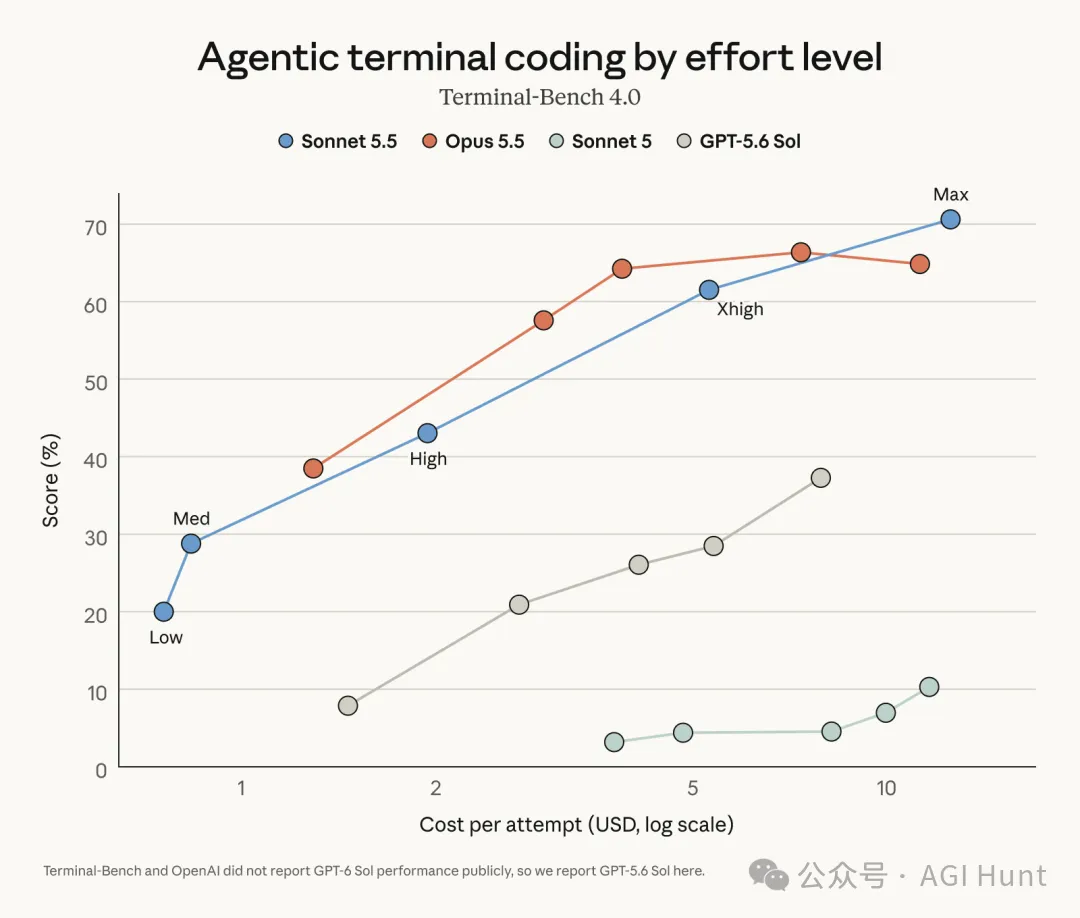
而在 FrontierCode 這張圖裡,則有個挺好玩的小插曲:
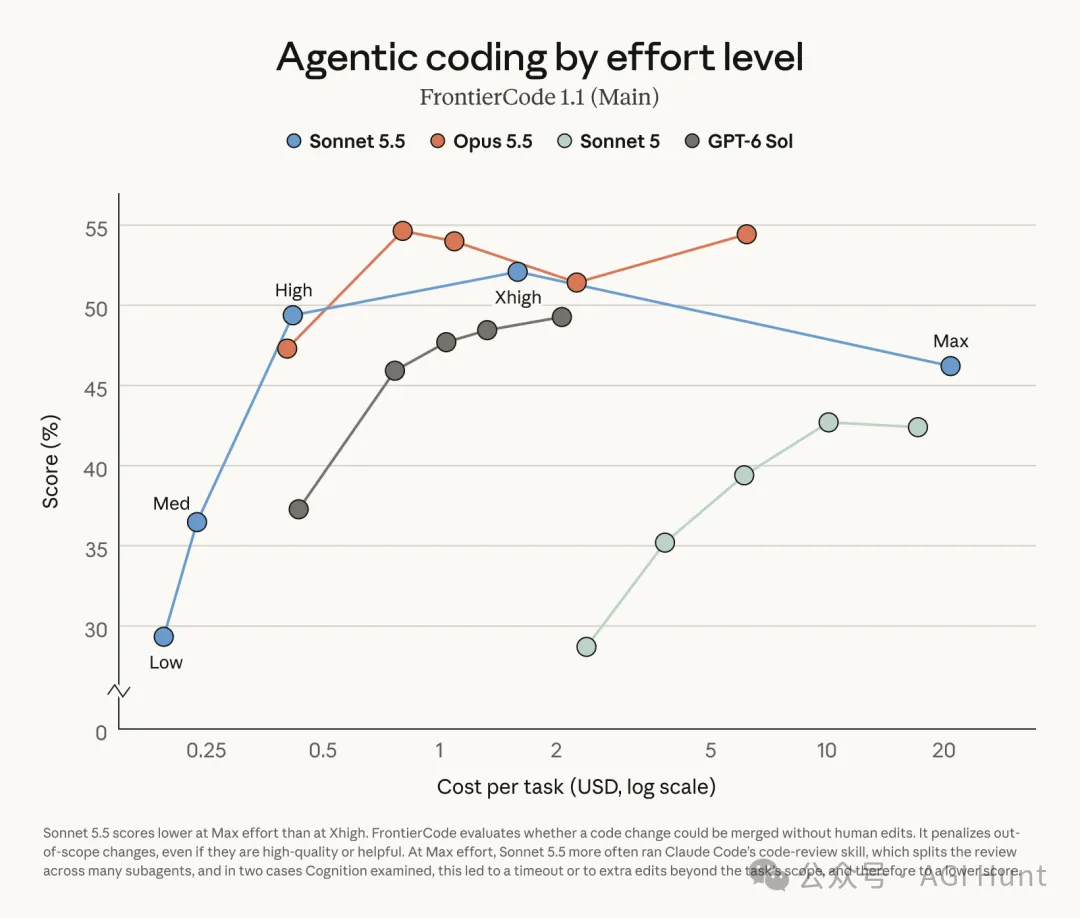
Sonnet 5.5 開 Xhigh 能拿到 52.1%,開到 Max 反而掉到了 46.2%。
原因在於,FrontierCode 考的是程式碼改動能不能不經人工修改就直接合併,改了任務範圍以外的東西,那怕改得再好、再有幫助,也是要扣分的。
而開到 Max 的 Sonnet 5.5,會更頻繁地去呼叫 Claude Code 的 code-review skill,把審查拆給一大堆 subagent 去做。結果在 Cognition 檢查的兩個案例裡,要麼是跑超時了,要麼是多改了任務範圍之外的程式碼……
活幹多了,也是會被扣分的。
04 沙丘與寶可夢
Sonnet 5.5 另一個被官方拿出來說的,是設計能力:能給使用者介面加上更多打磨,按範本做出來的幻燈片,基本也不太需要再改。
官方又放了一段對比,prompt 是「用一個 HTML 檔案做出風吹沙丘」:
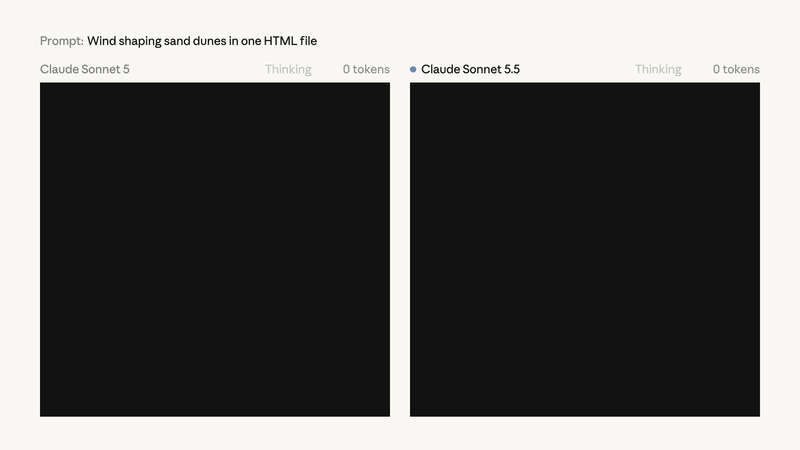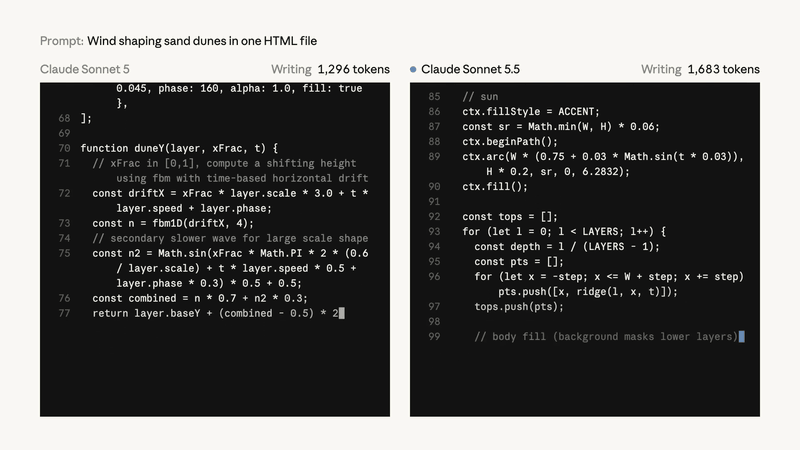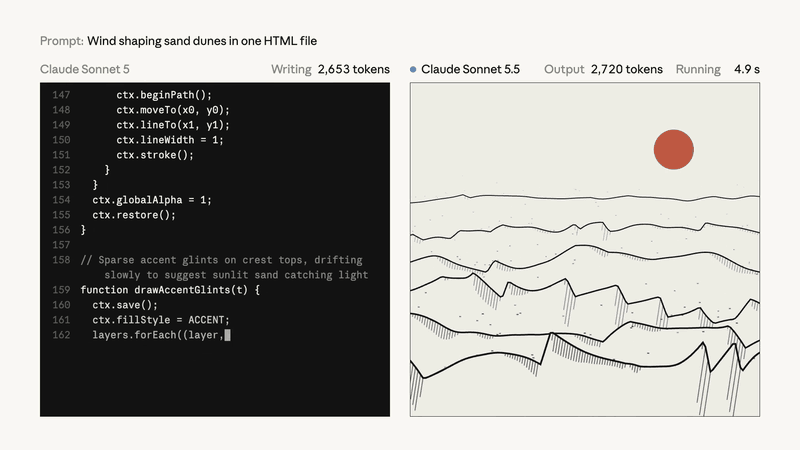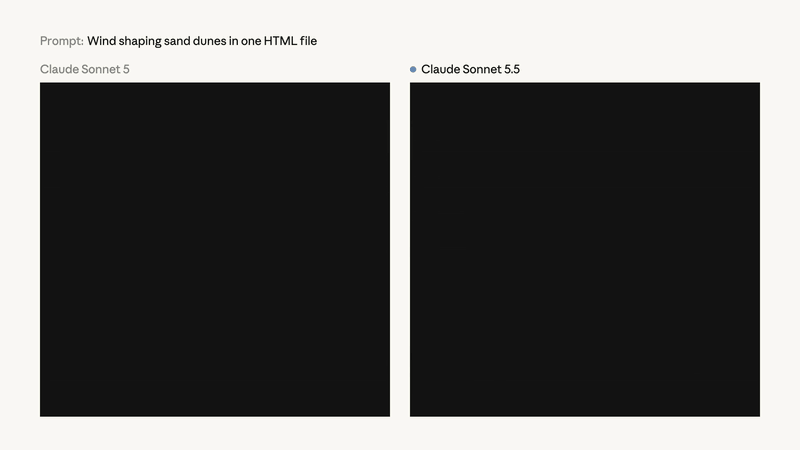
Sonnet 5 畫出來的是幾條平滑的曲線,Sonnet 5.5 則多了一輪紅日,沙丘也有了陡峭的落沙坡和陰影線條,畫面講究了不少。並且它還更早完工,少用了 368 個 token。
寫作上,官方稱 Sonnet 5.5 和 Opus 5.5 一樣,比上一代模型寫得更清楚。再加上速度快,很適合拿來快速迭代,以及在不那麼複雜的任務上來回協作。
Anthropic 的 Alex Albert 也在 X 上表示:
Sonnet 5.5 有我喜歡 Opus 5.5 的那種感覺。它寫得很清楚,非常快,能力相比 Sonnet 5 是一次大躍升。非常適合拿來迭代。
另外還有個小彩蛋:Sonnet 5.5 是第一個只靠截圖,就通關了《寶可夢 紅》的 Sonnet 模型。
05 安全與防蒸餾
在 Anthropic 的自動化行為審計中,Sonnet 5.5 在大多數對齊和誠實性指標上,都比 Sonnet 5 更好或者持平。
它也是第一個帶有網路安全防護和兜底機制的 Sonnet,這套機制此前只用在 Anthropic 最強的幾個模型上。日常的軟體開發、偵錯不受影響,而風險較高的網路安全任務,則會回退給 Sonnet 5 來處理。做網路防禦工作的團隊,可以申請擴大後的 Cyber Verification Program(網路安全驗證計畫)。
生物安全方面,則沿用了 Sonnet 5 的那套防護,大多數科研、教育和臨床工作不受影響,相關機構可以申請 Life Sciences Verification Program。
還有個有些朋友可能關心的,是防蒸餾。
Sonnet 5.5 是第一個配備了防推理提取安全分類器的 Sonnet 模型,同時擴大了 preserved thinking(保留思考)的範圍,讓思考內容沒法脫離發起請求的帳號被單獨拿走。
A 社今年 2 月曾公開點名 DeepSeek 和 MiniMax 等一眾國產模型公司對 Claude 發起了「工業級蒸餾攻擊」,而這回,防蒸餾也終於下放到了 Sonnet 這一檔。
06 可用性
Sonnet 5.5 今天已經全面上線,Claude 應用、Claude Code,以及 API(模型 ID claude-sonnet-5-5),同時登陸 AWS、Google Cloud 和 Microsoft Azure,支援零資料保留。
API 價格(每百萬 token):
• 輸入:$2
• 輸出:$10
• 快取讀取:$0.20
• 快取寫入:$2.50
至於面向高並行、成本敏感場景的 Haiku 5.5,官方表示會在未來幾周內發佈。
評論區的網友們,則是一半在問 Haiku 呢,另一半在求再來一次額度重設……(上周 Opus 5.5 發佈時剛送過一次,懂的都懂)
而如果你的 cc 額度常年告急,那最實在的用法,大概是把 Claude Code 裡的 subagent 都換成 Sonnet 5.5,再讓 Opus 5.5 來當指揮了。(AGI Hunt)