
距離上一款旗艦模型發佈已經過去7個月,Google終於拿出了新東西。這一次,它想用更寬的能力覆蓋面和更低的價格,把自己重新拉回前沿第一梯隊。
美國當地時間9月30日,GoogleDeepMind正式發佈Gemini 4 Argon,這是該公司半年多以來首款超越Flash等級的前沿專有模型,主打軟體工程、企業知識工作和網路防禦三大場景。
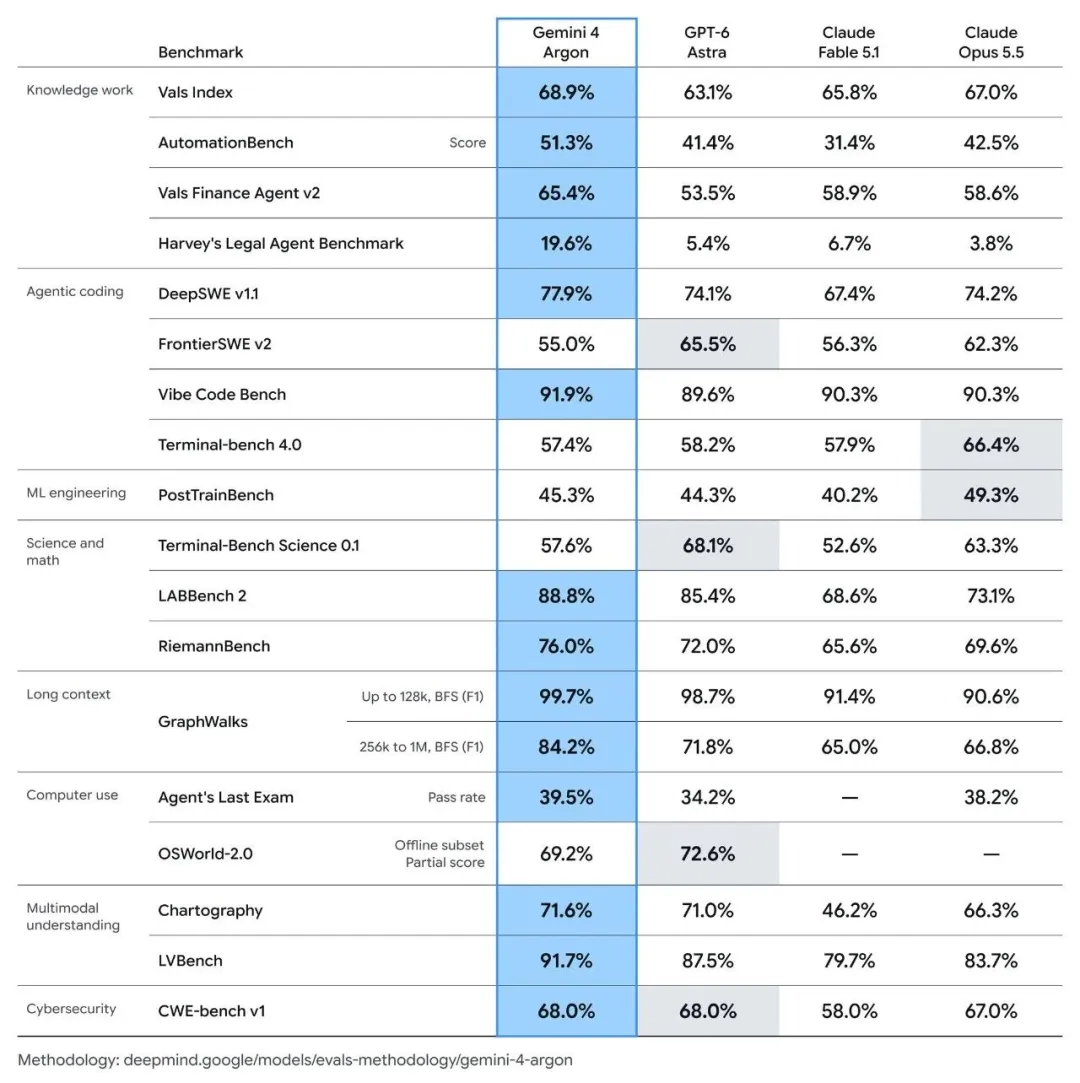
Gemini 4 Argon的測試成績相當亮眼:在Google公開的18項基準對比中,該模型在12項中領先、1項並列第一,超過了GPT-6 Astra和Claude Opus 5.5。
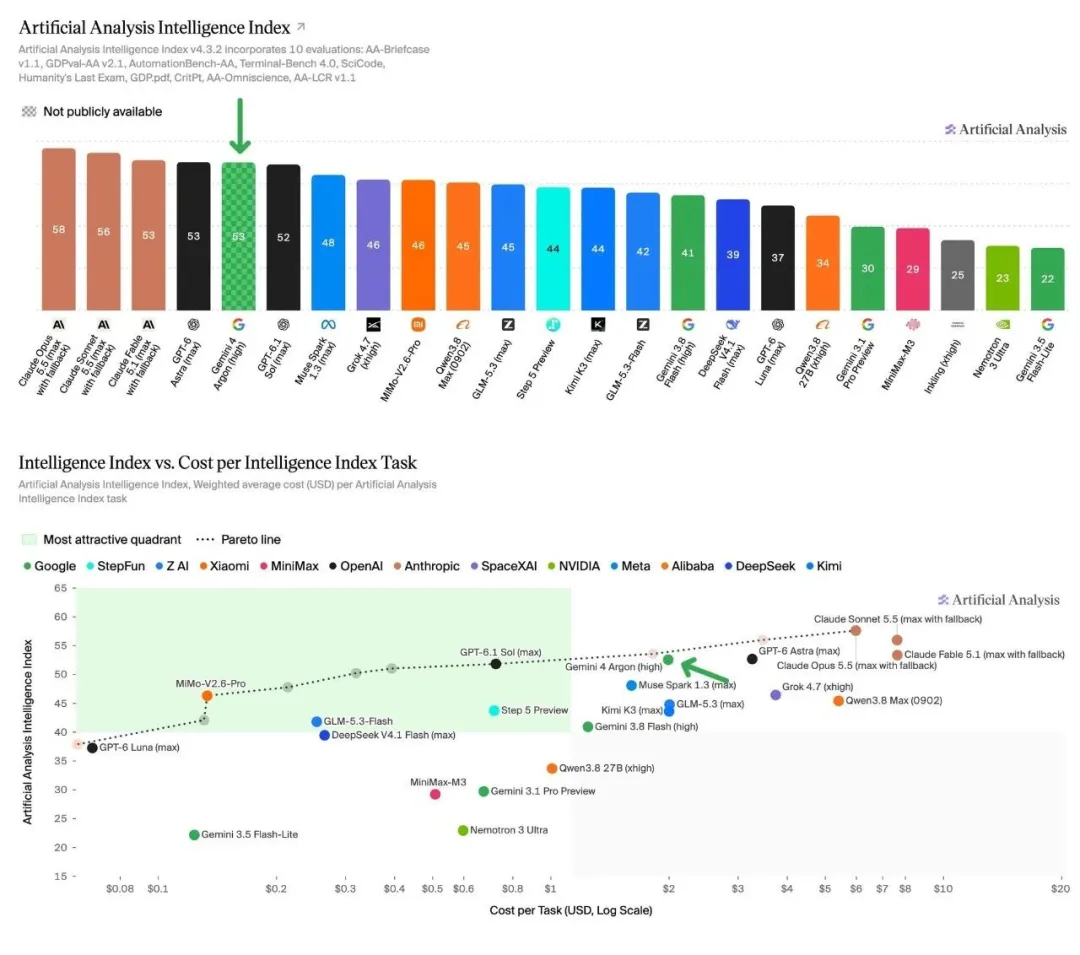
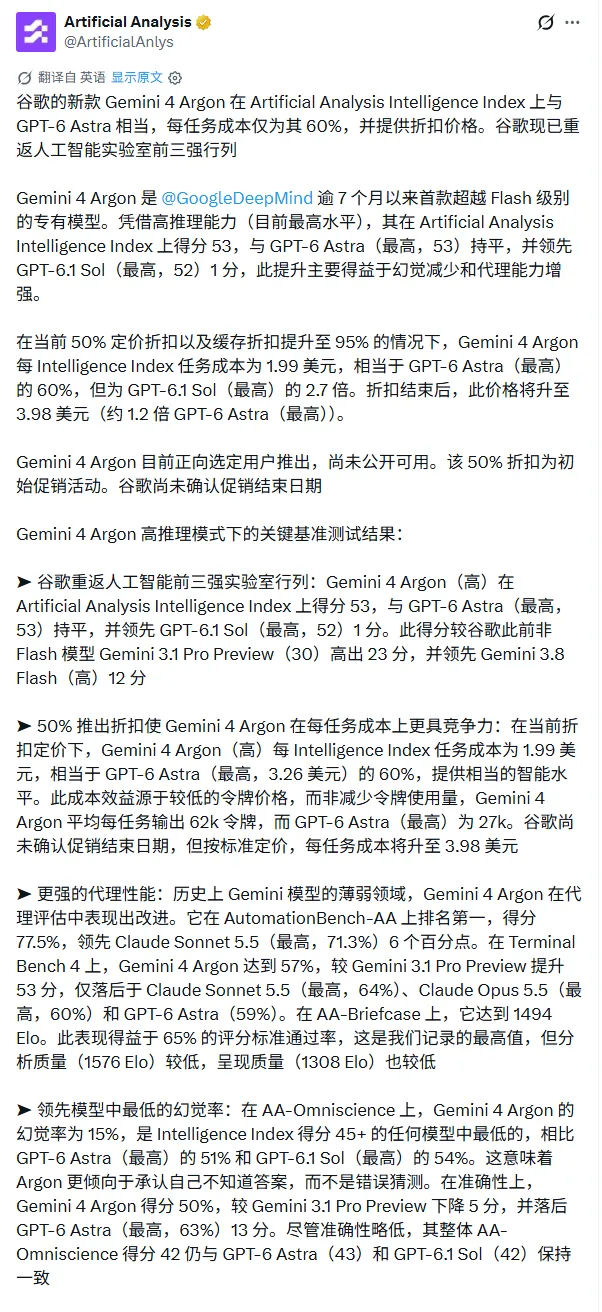
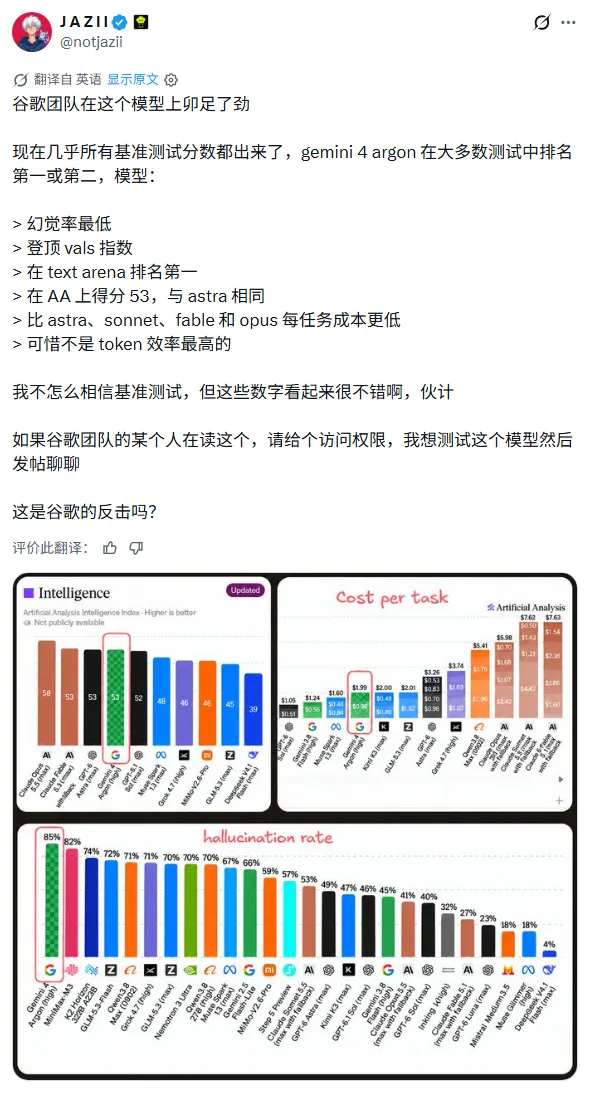
獨立評估機構Artificial Analysis的智能指數中,Argon得分53,與GPT-6 Astra持平。
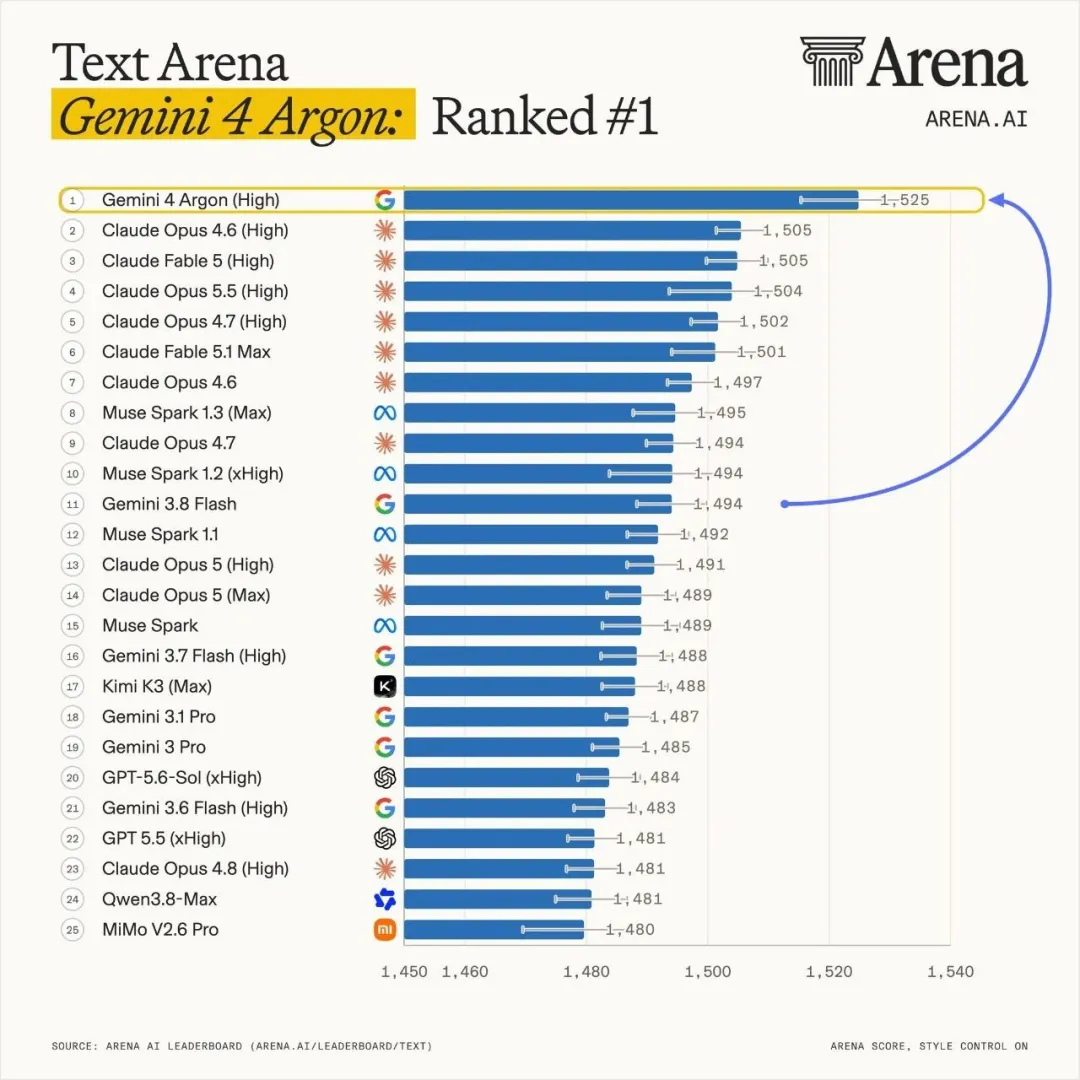
第三方測評Arena.ai的Text Arena榜單上,Argon以1525分登頂。
價格同樣是Argon的一張王牌。Google沒有把它定位成高價旗艦模型,而是通過更低的呼叫成本和快取優惠降低使用門檻,試圖讓Argon在性能之外,再建立一層價格優勢。
但普通使用者暫時還拿不到。Argon首先通過Fairwind計畫向可信的網路防禦者開放,同時正在參與美國政府的自願預發佈程序。更廣泛的開放從付費API客戶和Google AI Ultra訂閱使用者開始,具體時間表未公佈。
對於Google來說,這次發佈的意義遠不止一款新模型。過去大半年,Gemini 3.5 Pro幾經推遲後夭折,OpenAI和Anthropic快速迭代拉大差距,內部人才流失和領導層調整不斷。Argon是Google對“已經掉隊”敘事的集中回應。
01. 跑分第一梯隊,但不是全面碾壓
從基準測試看,Argon交出了一份不錯的答卷,其優勢主要集中在企業和長上下文工作流。Harvey法律代理基準中,Argon得分19.6%,是第二名的三倍以上。Zapier的AutomationBench端到端業務執行測試中,Argon以51.3%領先。
金融方面,Vals Finance Agent v2得分65.4%,超過Claude Opus 5.5和GPT-6 Astra。程式設計方面,DeepSWE v1.1長周期軟體工程測試以77.9%位居第一。長視訊理解基準LVBench上,Argon得分91.7%。網路安全CWE-bench v1上,則與GPT-6 Astra並列第一。
Artificial Analysis重點強調了Argon的兩大亮點:
一是Argon的幻覺率僅15%,是智能指數得分45分以上模型中最低的,遠低於GPT-6 Astra的51%。Argon更傾向於承認自己不知道,而不是錯誤猜測。
二是Argon輸出token限制達到100萬,是此前6.4萬的15倍以上,對智能體程式設計、審計、遷移等長鏈條工作尤為關鍵。
AI測評人@notjazii評論稱,Google團隊在這個模型上卯足了勁。幻覺率最低、登頂Vals指數、Text Arena排名第一、AA上得分53追平Astra、每任務成本更低——幾乎在大多數測試中都排第一或第二。
但Argon不是全面碾壓,它也有幾個明顯落後的項目,尤其是FrontierSWE v2和Terminal-Bench Science 0.1,GPT-6 Astra在這兩項中都領先10個百分點以上。Claude Opus 5.5在Terminal-bench 4.0上領先約9個百分點。
同時,彭博社披露稱,一些Google員工對Gemini 4的實際表現持懷疑態度,尤其是在程式設計領域。基準測試分數不錯,但真實工作場景中處理某些編碼任務時表現不如人意,前端設計能力尤為薄弱。
內部有人將這種現象歸因於“benchmaxxing”——工程師更專注於在基準測試上取得好成績,而不是打造真正好用的產品。AI初創公司Surge AI創始人埃德溫·陳(Edwin Chen)打過一個比方:這就像孩子SAT考了高分,但分數並不一定能轉化為現實世界的表現。
02. Argon已在Google內部上崗
基準測試之外,更有說服力的是Argon已經進入Google內部真實業務流程。
GoogleDeepMind高級副總裁兼首席AI架構師科雷·卡夫克丘奧盧(Koray Kavukcuoglu)表示,已有數千名Google員工開始使用Argon,應用場景覆蓋程式碼開發、工程最佳化、研究分析等多個方向。
其中,Argon最具代表性的能力體現在複雜工程任務上。量子計算團隊曾用Argon最佳化瓶頸子例程的時空資源,一個案例在幾分鐘內就比已發表的基線提升了40%。
在記憶體最佳化方面,一組Argon智能體分析Google全艦隊性能資料,自主識別並執行最佳化方案,部署後已釋放超過300TiB記憶體,預計總節省規模達到500TiB至1PiB。
科技分析師@kimmonismus稱,最值得關注的是,這些智能體已經開始在Google自身基礎設施中承擔真實任務,包括分析遙測資料、最佳化記憶體以及遷移程式碼庫,而不是停留在演示環境中。
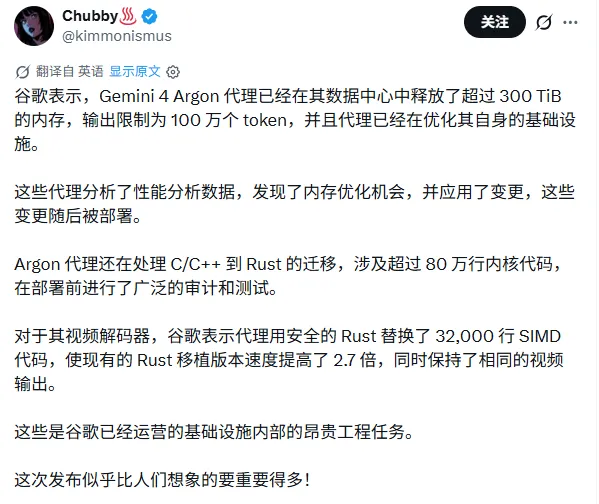
程式碼遷移是Argon落地的另一項重點工作。它正在幫助Google將內部C/C++程式碼遷移至Rust,涉及範圍從核心庫的數萬行程式碼,到Fuchsia作業系統Zircon核心的80萬行以上程式碼。由於這些系統承擔關鍵功能,所有遷移結果都需要經過自動化檢測和人工審計後才能部署。
其中,libgav1視訊解碼器是一個較為具體的案例。Argon使用3.2萬行安全Rust程式碼替換原有SIMD程式碼,並通過編譯器自動向量化,最終生成的記憶體安全解碼器相比此前Rust移植版本速度提升2.7倍,同時保持視訊輸出完全一致。
網路安全方面,Google專門訓練了Argon的防禦能力,它可以自主發現、驗證並修補關鍵漏洞。對於可信防禦者和內部團隊,Google將提供不帶網路安全護欄的版本,使其發揮全部前沿級防禦能力。
雲安全公司Wiz已經通過其“善意掃描”計畫使用Argon。早期驗證中,模型發現了一個全球醫院醫療軟體中暴露敏感個人資訊的關鍵漏洞,而此前的前沿模型都沒有發現。
03. 半價搶市場,但普通人買不到
Argon的定價策略,簡單說就是“便宜、但你暫時買不到”。
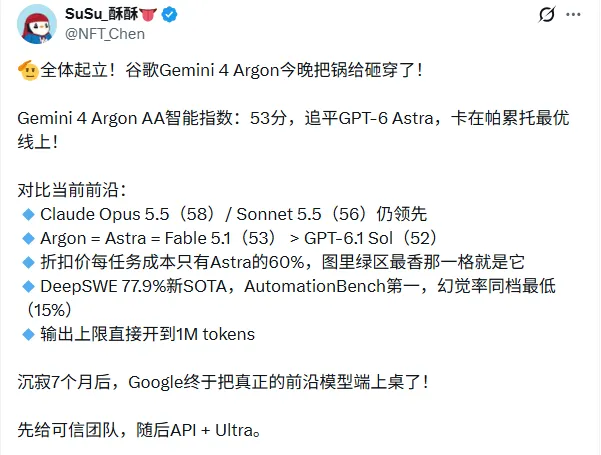
首發促銷價輸入2美元、輸出10美元每百萬token,只有GPT-6 Astra標價的五分之一,是Claude Opus 5.5的一半。快取輸入折扣95%,折後僅0.10美元。Artificial Analysis測算,折扣下Argon每智能指數任務成本為1.99美元,相當於GPT-6 Astra的60%。促銷結束後標準價與Opus 5.5持平,每任務成本約為Astra的1.2倍。
AI行業觀察者@NFT_Chen稱,Gemini 4 Argon正好卡在帕累托最優線上。折扣價下每任務成本只有Astra的60%,DeepSWE新SOTA,AutomationBench第一,幻覺率同檔最低,輸出上限1M tokens。沉寂7個月後,Google終於把真正的前沿模型端上桌了。
安全方面,Google強調四大防護領域:防止網路和CBRN濫用、抵禦提示注入攻擊、監控錯位行為、加固沙箱環境。
其中Gray Swan間接提示注入測試中,Argon的攻擊成功率僅0.7%,低於Claude Opus 5.5的1.0%和GPT-6 Astra的8.5%。Google還部署了錯位緩解系統,監測Argon的思維鏈和行動,必要時停止執行,並明確主張在能力提升的關鍵階段保持推理透明度。
04. Google能重回牌桌嗎?
Argon的發佈,是Google對“已經掉隊”的大眾印象的一次集中回應。
過去大半年,Google在前沿模型領域的存在感下降。Gemini 3系列發佈於2025年11月,原定的Gemini 3.5 Pro幾經推遲後最終被放棄。彭博情報分析師曼迪普·辛格(Mandeep Singh)估算,訓練這樣一款模型的成本可能高達4億美元。同期OpenAI和Anthropic快速迭代,差距越拉越大。
內部動盪也加劇了擔憂。2026年8月,戴密斯·哈薩比斯(Demis Hassabis)卸任DeepMind CEO轉任Alphabet董事長兼首席科學家,傑夫·迪恩(Jeff Dean)離職創業,卡夫克丘奧盧接任最高職位,這被稱為Google自2023年OpenAI動盪以來最大的AI領導層洗牌。
傳奇工程師傑夫·迪恩、諾貝爾獎得主約翰·江珀(John Jumper)、諾姆·沙齊爾(Noam Shazeer)等明星研究者也相繼離開。
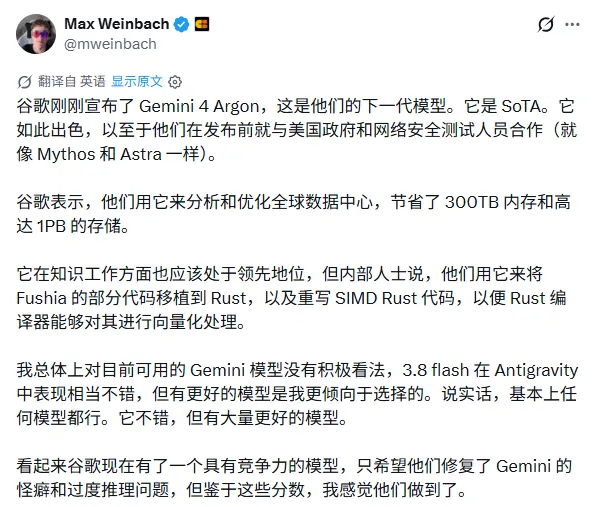
Creative Strategies分析師馬克斯·溫巴赫表示,他此前對Gemini整體評價不高,但從目前的表現來看,Google似乎終於拿出了有競爭力的前沿模型,也可能解決了過去的過度推理等問題。
Argon就是在這樣的背景下登場的。它至少在紙面上給出了一份有說服力的答卷。但要真正重回前沿競爭,光靠基準測試還不夠。
首先是真實可用性。基準高分不等於生產環境好用,前端設計等場景的短板、模型過大帶來的推理成本壓力、以及“為跑分最佳化”的傾向,都需要在實際部署中驗證。
Google首席執行長桑達爾·皮查伊(Sundar Pichai)在社交媒體上表示,將盡快且儘可能安全地使Argon可用,“還有很多內容即將推出,你將看到我們快速迭代。”
沉寂7個月後,Google終於拿出了新的前沿模型。它能不能真正扭轉局面,讓Google重新站回AI前沿的中心舞台?答案,或許就在接下來幾個月的快速迭代裡。 (騰訊科技)