
2026 年 5 月的一場業績說明會上,中芯國際聯席 CEO 趙海軍講了一句話:
人工智慧在海外的「虹吸效應」,讓消費和 IoT 客戶跑到內地來找產能。訂單在往回流。
他還說了一句更要緊的:客戶因為擔憂供應不足,在提前備貨。這話翻成大白話就是,現在買卡的人最怕的,是以後買不到。
那為什麼買不到?得從產能說起。
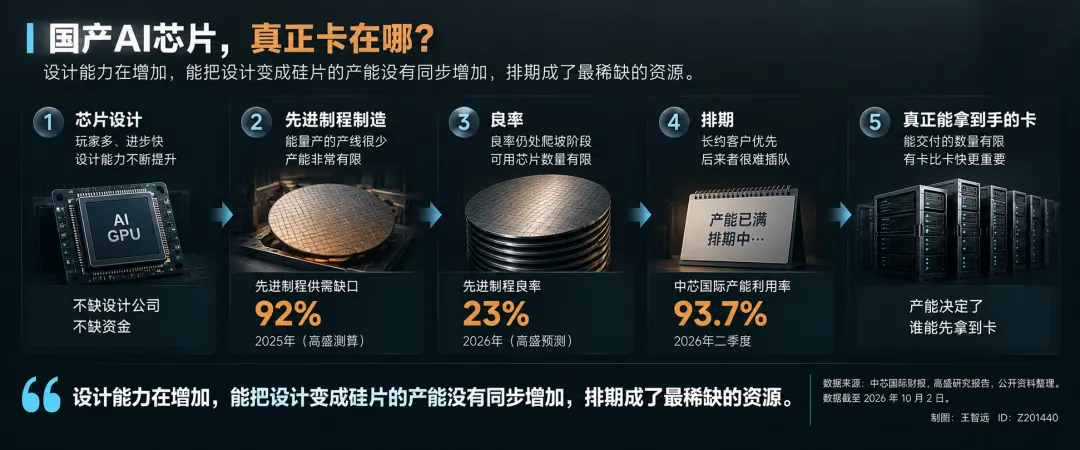
中芯國際最近一個季度的產能利用率是 93.7%,這是它自己財報裡寫的數。
更實在的一條在 2 月,趙海軍說,去年公司新增了大概 5 萬片 12 英吋產能;今年年底比去年年底,月產能還要再增 4 萬片。
一年多擴產,折成 12 英吋晶圓 4 萬片。對一家公司不算少,對一個行業是杯水車薪。中芯自己講得清楚,我們不做 GPU 等 AI 主晶片。
它做電源管理、資料傳輸這類配套晶片,這些也供不應求。趙海軍的原話是「公司受限於自身產能,正在積極調配資源優先支援」。
真正造 AI 晶片的那條線,全國能規模量產的,就一條。它一年能出多少東西?
高盛 8 月 24 日發了份報告,算先進製程晶圓的供需缺口。2025 年這個數是 92%。什麼概念,一百片的需求,國內只能供上八片,剩下九十二片得看別人的臉色。
這份報告的話說到 2035 年。那一年缺口縮小到 34%,中國先進製程月產能 41 萬片,國內需求 61.9 萬片。
十年時間,缺口從 92% 降到 34%。壓缺口靠供給端,每年 46% 的復合增速,需求端只有 17%。
頭幾年得先把良率這道檻補上。高盛假設中芯的先進製程良率,從 2026 年的 23% 往上爬,2030 年到 50%,2035 年到 75%。
對照台積電,2018 年量產 7 奈米起,良率現在已超過 90%。23% 是什麼意思?同樣一百片晶圓,能湊合用的只有二十來片,剩下七十多片全是白扔的。
到 2026 年,五家已上市的國產 AI 晶片公司,按券商引用的市場一致預期,收入同比要增長 120%,加起來盤子 257 億。錢在往這個方向湧。
而去年,國產 AI 加速卡出貨 165 萬張,全市場 400 萬張,國產佔了四成。
這個四成算全部 AI 加速卡,各種製程一鍋端。前面那個 23% 算 7 奈米以下的先進製程,兩筆帳不在一個池子。
份額聽著不低,可這裡有個錯位。國內做 AI 晶片的,設計這一側從來不缺人,也不缺錢,設計能力在往上走,製造能力卡在那兒。真正稀缺的是把圖紙變成矽片的地方。
中芯國際今天最搶手的產能,握在簽了長約的人手裡。
趙海軍在業績會上講過,產能分給誰的先後次序,第一原則是過去跟客戶之間的相互承諾。「並不是一個後來者突然出現,給了更高的價錢,我們就去做。」
活兒是中芯先挑的。可對排在後面的人呢?
去年出貨 165 萬張裡,有一部分設計能力不差,就是排期靠後;有人的流片從一季度推到二季度,再推到等通知,投資人問量產時間,他答不上來,答案不在他手上。
所以,卡住國產AI 晶片的是排期表。
產能不夠,那就買不到;買不到,就只能用國產的。可用國產的這件事,比買不到更難對付。
一個寫了五六年 CUDA 的工程師,換到另一套晶片上,攢下的調優經驗全要重來,查資料的路徑、手裡的工具鏈也一樣。
晶片跑得快不快,早就不是卡點了。性能上來了,用的人上不來。卡點在人,在會不會用,這道檻比造晶片還難。
......
9 月 30 日,DeepSeek 開源了六個元件,它要解的就是這後半截。晶片能不能跑,DeepSeek 三年前就交過捲了,現在輪到人。
那六個元件,編譯器、計算庫、通訊庫都有,公告末尾有一句關鍵的話,所有元件與此前面向輝達平台的開源元件一一對應。
評論區當天挺熱鬧。這句話的份量,得自己去倉庫裡數。我去數了三件事。第一件,六個元件裡四個早就有了。
DeepGEMM-Ascend 是矩陣乘法的庫,建在 9 月 29 日晚上;DeepEP-Ascend 是通訊庫,建在 30 日凌晨。這兩個確實是新的。
剩下四個。跑向量計算的 TileKernels 是今年 4 月,做注意力算子的 FlashMLA 去年 2 月;做資料篩選的 DeepSelect 是 9 月 9 日,TileLang 更早,2024 年 10 月。
六個倉的建倉時間都在 GitHub 上擺著。官方說的「開源」,是這六個東西當天對齊到昇騰,不等於當天從零寫了六套。
第二件,TileLang 到底是誰寫的?
一直有人說這是 DeepSeek 自研。去年 9 月它開源 V3.2 算子時就有這說法。
梁文鋒在投資者交流會上也講過,訓練 V3 時已幾乎不依賴輝達的軟體生態,全部基於自研的 TileLang 完成。
可論文的署名擺在那兒。核心作者十一個人,北大六個,帝國理工一個,微軟亞洲研究院四個,裡頭沒有一個 DeepSeek 的人。
所以嚴格說,這門語言不是它寫的。「自研」這個說法,多半是把「深度參與」講成了「自研」。
論文發在 2025 年 4 月,項目當年 1 月開源,比這次公告早一年半。
DeepSeek 在裡頭另做了兩件事。
先用 TileLang 寫了自家模型訓練裡的大部分算子,拿產品給這門新語言做壓力測試。
「算子」就是模型裡一個個具體的計算動作。然後它把訓練裡用到的每個算子在昇騰上重做一遍。官方的原話是,訓練中用到的每一個 TileLang 算子,在昇騰上都有對應的高性能實現。
先有模型,後有算子清單,再讓晶片照著清單去適配。DeepSeek 出題,晶片動手。
華為那邊出的力也不少。超節點組網是兩邊一起定義的,128 卡做到 3.2Tbps 單層交換,成果還在華為自己的 CANN 社區同步開源。
第三件,性能數字的實測口徑。
官方的說法是,跨卡傳送的頻寬做到每秒 375 GB,把結果聚回來的每秒 347 GB,接近硬體上限。數字沒錯。
卡和卡之間要交換一大堆數字。跨卡傳送,等於一屋子人互相遞東西,人手一份;聚合,等於各人手裡的東西收回到一個人手上。人多了必慢,官方報的那個上限,是 8 卡規模下的成績。
375 是 8 卡規模下的最好成績,卡數往上翻,32 卡落到 335,128 卡掉到 313;聚合那頭更明顯,347 一路降到 272。
卡數翻了十六倍,單卡分到的頻寬掉了不到兩成,這個成績不算難看。
再往後還有個時間差。這組數字出自給 DeepSeek 的測試版硬體,加手工配置。要讓滿頻寬跑起來,得等配套的那版商用韌體。
按 DeepSeek 自己開源倉庫的說明,那版韌體計畫 10 月中旬公開,大概 15 日,並註明這是廠商計畫,以華為發佈為準。硬體已經在賣了,缺的是讓它跑滿的那一版。
口徑差這麼一點,決定這套東西眼下解決了什麼。適配一個昇騰算子,過去按周按月算;現在寫在 TileLang 裡,後端換個編譯器。省下的是時間。
有人會問,中立層這活兒不是早有人幹嗎?
FlagOS 2.0 今年 3 月發佈,二十三家公司一起做,覆蓋十八家廠商三十二款晶片,統一表示層第一批適配名單裡就有昇騰。
不過它管系統軟體棧那一層,統一表示、算子庫、框架外掛、跨晶片發佈都在它那兒,TileLang 管的是語言這一層。
北大在兩邊的名單裡都有,上游下游,誰也替不了誰。這兩層合起來要解決的就是這後半截。人會不會用,得有人把路先攤平。
......
7 月流出來的那份交流記錄,有句話最怪。
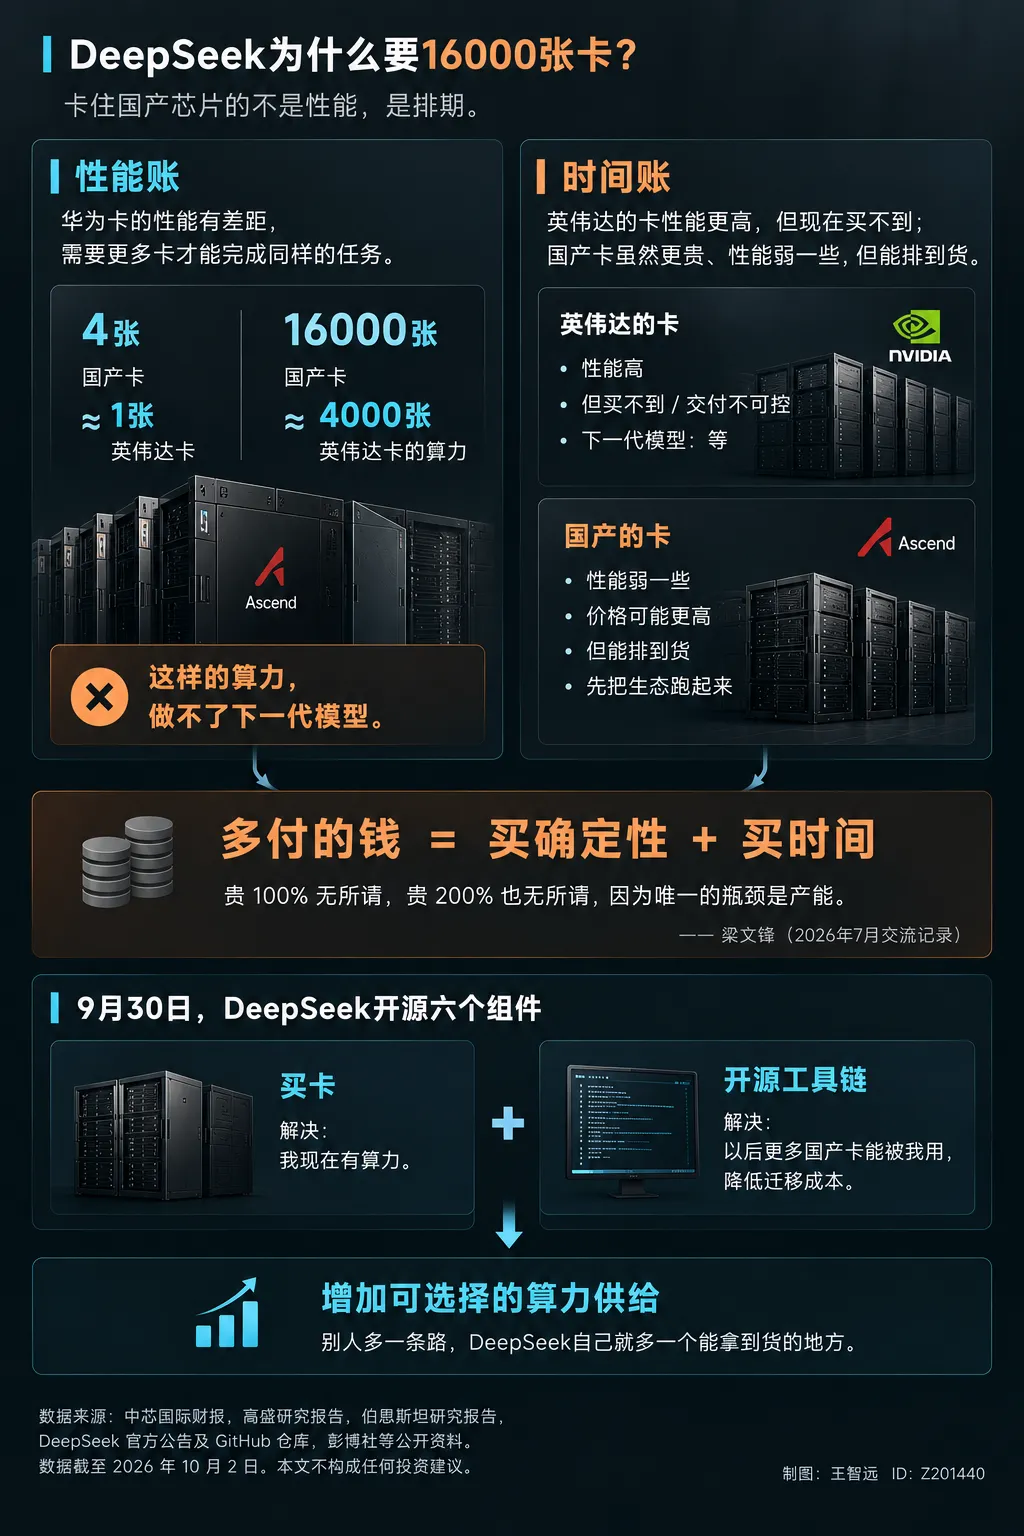
梁文鋒談起華為超節點和輝達的價格差,說了一句,貴百分之一百無所謂,貴百分之兩百都無所謂。買家的本分是砍價。他這話等於把價簽當場撕了。
正常情況,嫌貴可以不買。他嫌貴,還準備買,那兩倍溢價在他眼裡換的就是別的。
一個準備下單十六萬顆晶片的人,把價格放這個位置,不是姿態。他那本帳裡,晶片的價錢已排不到前頭。
那他買的到底是什麼?同一場交流,他還說過一句,唯一的瓶頸是產能。
華為要四張卡才頂輝達一張,迭代節奏還落後大概兩年,這些他都認,擺完還說貴兩倍無所謂。
帳要這麼算才通。他要的是能確定拿到手的卡,價格往後放。
他說,華為給 DeepSeek 的產能大概一萬六千張卡。同一場裡他還提了一句,網際網路大廠拿十幾萬張。
一萬六千張是什麼量級?按他自己的演算法,相當於四千張輝達的卡,做不了下一代模型。
他還留了後半句,但足夠幫華為把生態跑通。先認不夠用,再說夠幹什麼,這順序有講究。
訂單那頭還有個數:
彭博社 9 月的報導說,DeepSeek 計畫部署至少十六萬顆昇騰 950DT,用在內蒙烏蘭察布在建的 1GW 資料中心。報導裡提到,華為這顆晶片年產能約幾十萬顆,這一筆得慢慢交,可能拖上一年。
一頭下了一年的單,一頭一年只出得來幾十萬顆。誰手上有卡,誰就是稀缺的那一方。
他多付一倍兩倍的錢,換先把卡拿到手。
一個做模型的人最怕的,是手裡這些卡不夠支撐下一代模型,那下一代就得等。等多久,誰也說不準,決定權不在他手上。
錢是肯定要花的,花多少也大致有數。往後拖多久,沒數。所以兩本帳放一起,他的演算法很簡單,多掏錢,換時間。
還有一句更硬的話在後面。
他說,如果是在一個正常的商業環境裡面,我能買到輝達的卡,那麼國產替代是比較難的;但是在輝達的卡買不到的情況下,所有人都迫不得已,都要去做國產晶片。
這話把因果說反了嗎,沒有。他把國產替代的動力,從「國產更好」挪到了「買不到別的」。
這個前提是很脆的,那天輝達的卡重新買得到,用國產的理由就少了一大半。
開源這件事放在這個前提下,就說得通了。
它讓多幾家晶片公司能把卡做出來,也讓用卡的人敢下手,DeepSeek 手上就多幾張牌。
別人多一條路,它自己多一個能拿到貨的地方。做慈善和留後手,在這兒是同一件事。
9 月 30 日那天,市場沒給這套元件定價;滬指漲了 0.31%,科創綜指跌 1.81%,半導體類股集中調整,寒武紀跌了 2.97%。
一條消息能不能變成錢,得看它離訂單有多遠。這套元件還隔著好幾層。
過去國產晶片要證明自己能用,得先說服客戶;現在多了一個正在用的人,而且這個人是當下最有資格挑刺的那個。
它一邊買著華為的卡,一邊把工具鏈開源給所有晶片廠。買和送,是一套動作。
這動作看著往外給,為的還是往裡拿。多幾家廠能出卡,它就不必只盯一家;三年前它解的是「晶片能不能跑」,現在解的是「能不能排上」。題換了,人也是。
......
寫到這兒,估計有人會想,這事在二級市場怎麼落?先看中芯國際:
二季度產能利用率 93.7%,資本開支 18.36 億美元,毛利率 25.3%;三季度公司預期回到 95% 上下,訂單已收到年尾。
為什麼是中芯?能規模量產先進製程 AI 晶片的產線,國內就它一條,簽長約的也是它。誰簽了多少、排到那兒,都在它帳上。
它半年報裡有個 10.29%,是應收帳款餘額最大客戶的比重,前五大加起來 42.43%。欠款口徑跟收入不一回事,但下游的錢往頭部走,這兒看得見。
再往上游看,擴產得先買裝置。
伯恩斯坦八月把中國晶圓廠裝置市場的盤子,調到 2027 年 730 億美元、2028 年 1010 億美元,還說裝置股今年漲了 60% 到 110%。漲的是預期,接下來看交付。
旁邊的配套也順手看一眼,中芯二季度把產能往 AI 計算、HBM 和高毛利記憶體上挪,標準邏輯、聯網晶片、利基記憶體的供給就緊了。誰在漲價、誰的單排到明年,看這兒。
這三條線要是看反了,各有各的記號。
良率明顯偏離高盛那個 23%,先進製程這筆帳得重算;10 月中旬那版韌體實測低於現在這組資料,性能口徑得收回;長約客戶在應收款裡佔比掉下來,排隊那套說法得改口。
所以,DeepSeek 開源這套底層框架,給自己多開幾條隊;有得選,是最貴的一樣東西,也是唯一花錢買不到的。
資料參考來源
[1].中芯國際的產能、毛利率與客戶應收款資料,出自業績公告;趙海軍、梁文鋒的引述分別出自中芯業績說明會與 2026 年 7 月流出的投資者交流會文字稿,
[2].產業側資料來自高盛、華泰證券、中信建投、伯恩斯坦的研報;開源元件的倉庫與性能資料,出自 GitHub 各倉庫及 DeepEP-Ascend 的說明檔案。
[3].DeepSeek 採購昇騰晶片與昇騰開發者規模;資料截至日期為10月2日;本文不構成任何投資建議
(王智遠)