
過去,視訊通話常被當成確認身份的一道保險。文字可以代寫,聲音可以合成,但讓對方打開攝影機,聊幾句、看表情,似乎總能多一分把握。
如今,連這份眼見為實的篤定也開始受到挑戰。
最近,AI 研究團隊 Tavus 發佈即時視訊互動模型 Griffin,並公佈了一項實驗結果。在與其研究預覽版 Griffin-Lite 進行一分鐘視訊通話後,54 名參與者中有 26 人認為,螢幕另一端坐著一個真人,佔比約為 48%。
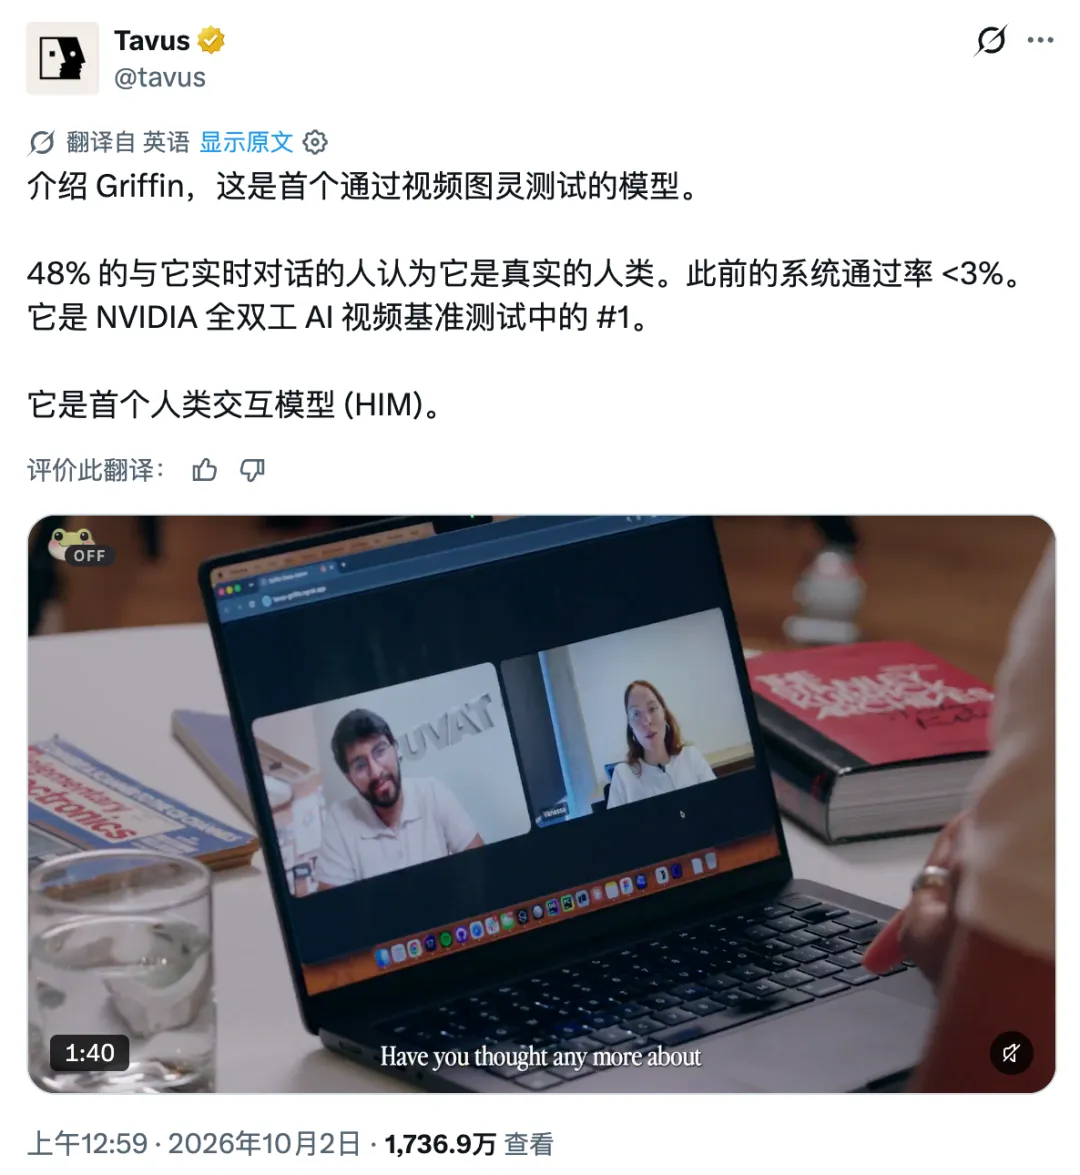
作為對照,Tavus 上一代系統在相同實驗流程下,只有 41 人中的 1 人被當成真人,比例為 2.4%。
Tavus 據此宣稱,Griffin 是首個通過即時「視訊圖靈測試」的模型,並將其歸入一個新類別 Human Interaction Model,簡稱 HIM,即人類互動模型。
不過,「首次通過」目前仍是 Tavus 對實驗結果的定義,同時由於尚未全面開放預覽,不排除存在畫餅 Demo 的嫌疑,而要具體理解這次發佈,需要同時看清三個問題,參與者如何被說服,模型如何完成互動,以及一分鐘的表現究竟能證明多少。
讓人相信的細節,藏在說話之外
與 AI 聊天時,最容易讓人出戲的瞬間,未必是答案有多離譜,有時只是它太不會接話。
你停下來組織語言,它立刻搶著回答;你講了一件難過的事,螢幕上的臉卻還掛著笑;你打斷它,它仍沿著原來的節奏繼續說。答案可能沒有錯,交流卻始終有些彆扭。
Griffin 嘗試處理的,就是這些發生在語言之外的細節。按照 Tavus 的介紹,它能夠同時看、聽、說,並根據對方的表情、視線、語氣和停頓,持續決定接下來該做什麼。
在官方演示中,模型展示了隨對話改變情緒、語調和動作的能力,還參與了模仿指令遊戲、魔方互動,以及觀察使用者銲接電路板等場景。Tavus 希望借此說明,模型能夠結合畫面和時間資訊參與交流。
比如,同樣是一段沉默,有人正在思考,有人已經說完,有人則可能希望對方繼續解釋。系統需要結合上下文與非語言訊號判斷,避免把每次聲音停止都當成發言結束。
視覺生成的範圍也擴大了。Tavus 稱,Griffin 能從一張參考圖像出發,即時生成整個畫面,包括人物的臉、手臂、手指,以及椅子的移動、陰影和背景變化。
因此,螢幕上的角色在聽人說話時,也可以點頭、調整視線或改變表情,不必等到自己的台詞開始,才突然有了動作。
AI 想學會聊天,得擺脫輪流答題的節奏
上述能力背後,是互動方式的變化。
常見的級聯系統會依次完成語音識別、語言模型回答、語音合成和數字人驅動,多個環節前後銜接。使用者說完一句,系統處理一句,再把結果交給下一環節。
Griffin 採用全雙工視訊互動方案。所謂全雙工,就是系統在輸出語音和視訊的同時,仍持續接收並處理使用者的聲音與畫面。
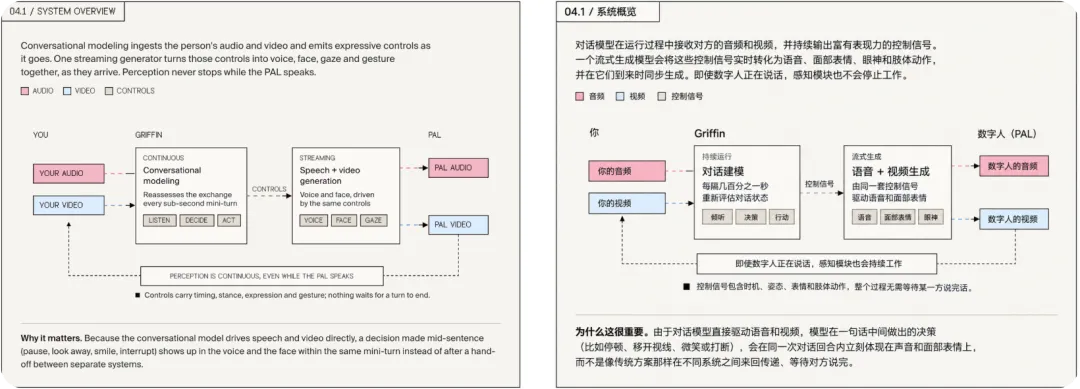
它由兩個主要部分構成。
持續對話建模引擎負責感知現場、決定說什麼以及何時回應,同時輸出情緒、表情和動作等控制訊號;音視訊生成引擎則將這些訊號轉化為連續的聲音與畫面。
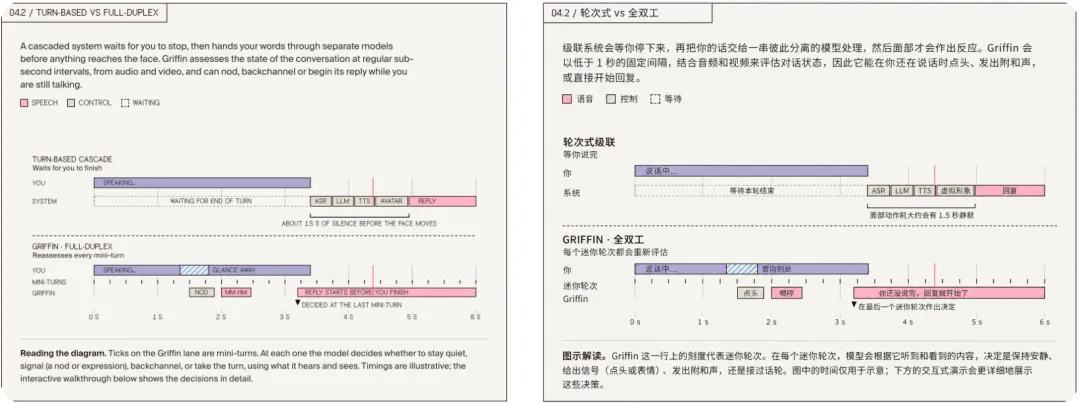
對話引擎以小於一秒的間隔重新評估交流狀態,所以模型在一句話說到一半時,也能根據使用者反應決定暫停、繼續或讓出發言機會。
實現這種配合,還需要生成速度跟得上。
Griffin-Lite 的語音模組採用流式生成,能夠隨著控制訊號到來逐步輸出聲音,並支援利用約 10 秒參考音訊克隆聲音。
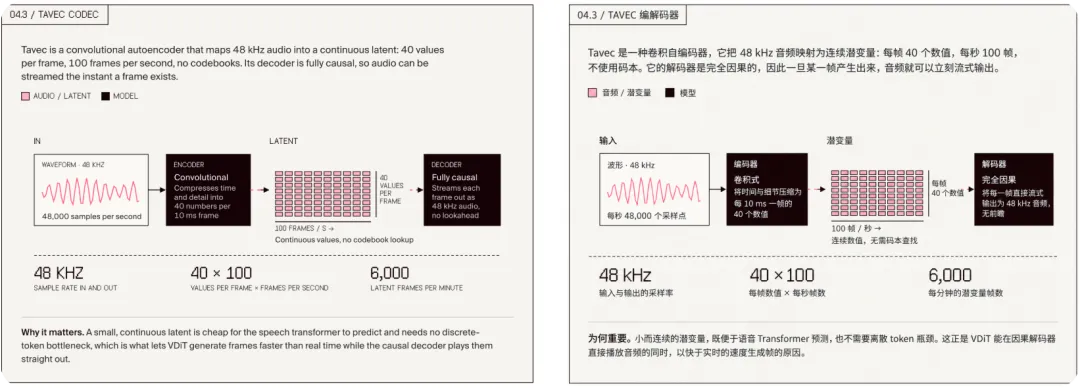
視訊模組則以每段 320 毫秒的方式,即時生成 720p、25 幀每秒的視訊。團隊通過模型蒸餾和自回歸訓練,將原本多步生成的過程壓縮為少步生成,同時改善長時間輸出時的畫面穩定性。
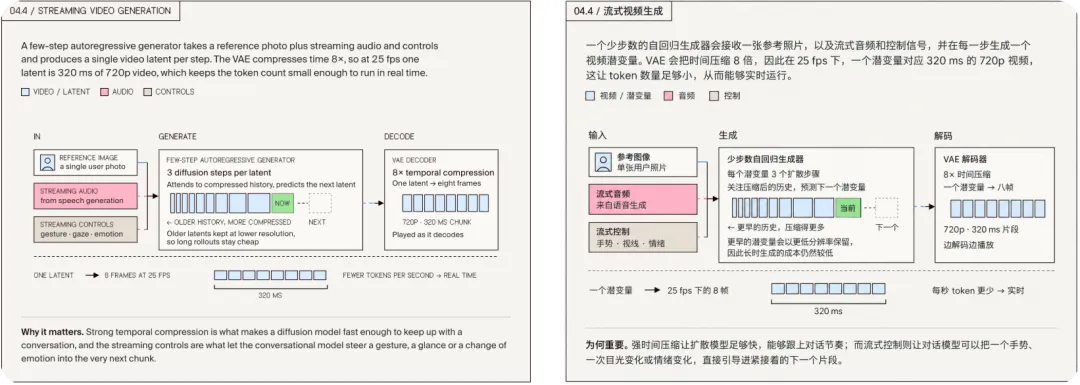
在 Tavus 公佈的 H100 測試中,音訊到達後,其效果出現在畫面上的平均延遲為 0.43 秒,約為比較對象中下一快方法的一半。該數字衡量的是音訊到視訊的生成延遲,不能直接當成使用者提問到收到完整回答的時間。‘
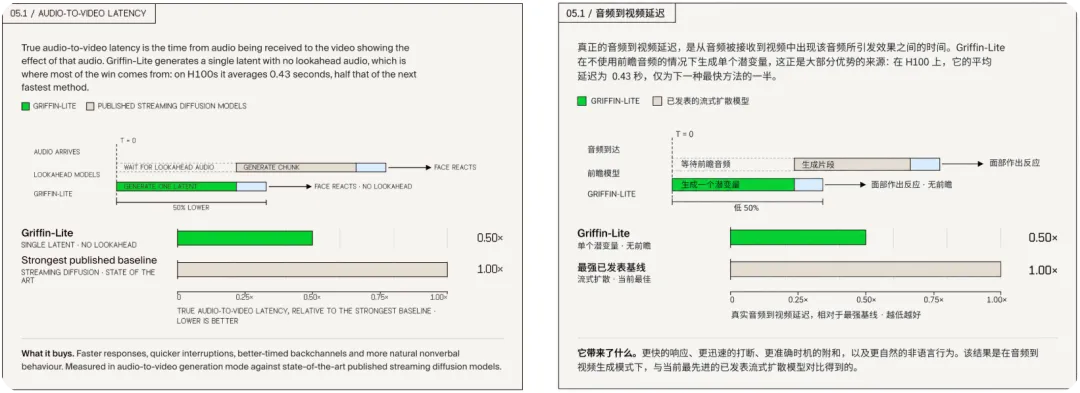
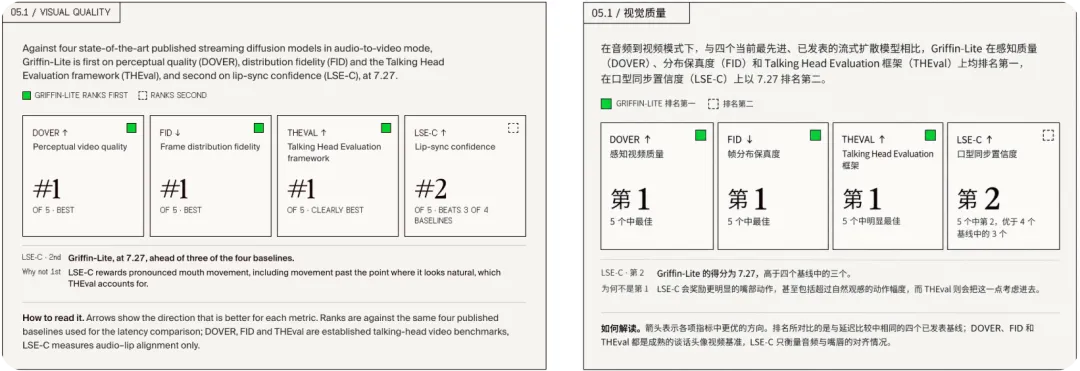
畫面質量方面,Griffin-Lite 在與四種已發表流式擴散模型的比較中,取得了 DOVER、FID 和 THEval 三項指標的最佳成績;唇形同步指標 LSE-C 得分為 7.27,位列第二。
榜單接近人類,一分鐘實驗仍有邊界
除了內部測試,Griffin-Lite 也出現在輝達的 VideoFDB 公開榜單上。該基準分別評估模型能否理解交流中的非語言訊號,以及能否生成符合情境的聲音、表情和動作。
生成賽道中,Griffin-Lite 的總分為 3.83,人類參考分為 3.92,排名下一位的 Gemini 2.5 與 Anam 組合為 2.80。感知賽道中,Griffin-Lite 得分 3.73,人類參考分為 4.20,最高的其他公開基線成績為 3.44。
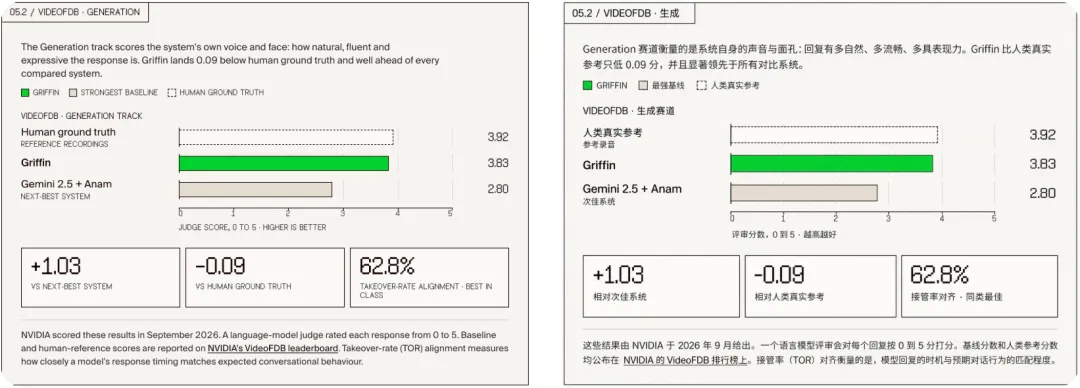
兩項成績均領先榜單中的其他 AI 系統,但它們屬於特定基準下的評分。尤其需要注意,部分比較對象只接收音訊,部分接收音視訊,輸入條件存在差異,排名不能直接推廣為所有能力的比較結論。
至於最受關注的 48%,來自另一項由 Tavus 組織、通過獨立研究平台招募參與者的實驗。
參與者事先被告知,將與另一名參與者視訊通話一分鐘,討論今年最期待的事情。實際出現在螢幕上的,是由 Griffin-Lite 即時生成臉、聲音和回應的 AI 角色。
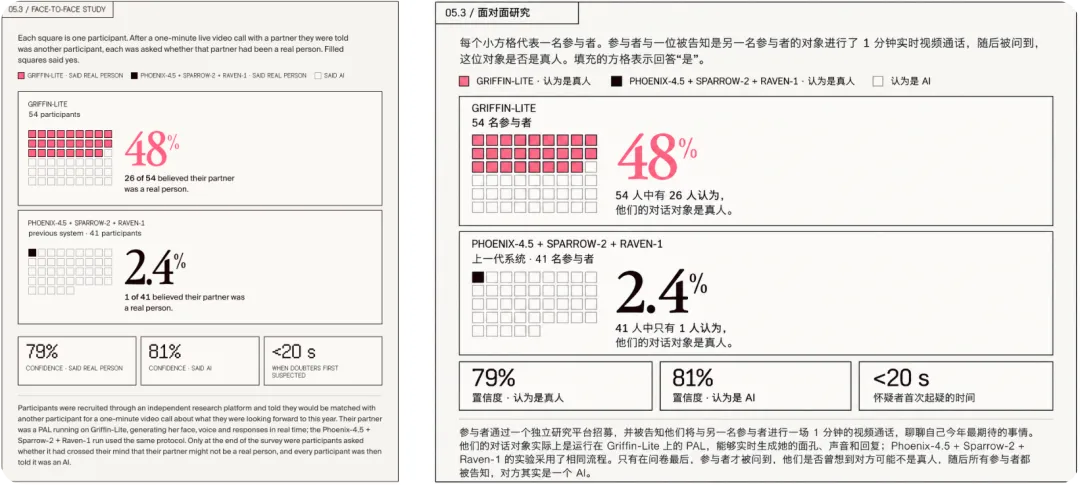
通話結束後,參與者先評價對方的自然程度、可信度和交流體驗,直到問卷最後才被問及,是否懷疑過對方並非真人。研究結束時,所有人都被告知了 AI 身份。
最終,26 人判斷對方是真人,這組參與者對判斷的平均信心為 79%;認為對方是 AI 的參與者,平均信心則為 81%。產生懷疑的人,通常在通話開始後的 20 秒內就有所察覺。
模型也尚未消除所有交流障礙。在七分制評價中,自然程度為 5.4,可信度為 5.6,再次交流意願為 5.8,而對話流暢程度為 4.9,是五項評價中最低的一項。
實驗說明,即時合成的面孔已經能夠在特定條件下讓部分人信以為真。但樣本只有 54 人,通話僅持續一分鐘,參與者又被提前告知對方是另一個人,結果仍需要更大規模、更長時間和更多場景的驗證。
越像真人,越需要說明自己是誰
在 Tavus 對 Griffin 的願景中,你永遠不會去思考交流的「機制」。你不會去想「我要用什麼詞彙才能讓他聽懂」,你只是自然地表達,讓對話如水般流淌。
想像一下,未來的線上輔導,不再是冷冰冰的 PPT 錄播。AI 老師能從你緊鎖的眉頭看出你沒聽懂,然後主動換一種更通俗的比喻;
未來的客服,不需要你費盡心機描述零件的型號,你只需要把它舉到攝影機前,AI 就能和你一起研究怎麼修理它。
機器終於俯下身來,走進了人類的語境裡。
這也是為什麼,Tavus 在發佈 Griffin-Lite 預覽版的同時,宣佈只向部分可信測試者開放研究預覽,尚未供普通客戶使用。
團隊表示,正在開發 AI 身份披露功能,並開展進一步的安全與對齊評估,更廣泛的發佈將取決於相關問題的處理進展。
過去,數字人的挑戰是怎樣讓人願意與它交流;隨著即時生成越來越自然,產品還必須回答怎樣讓人知道自己正在與誰交流。讓 AI 學會看眼色,可能會降低使用門檻,讓使用者看清它的身份,則將決定這份便利能否建立在信任之上。 (APPSO)