
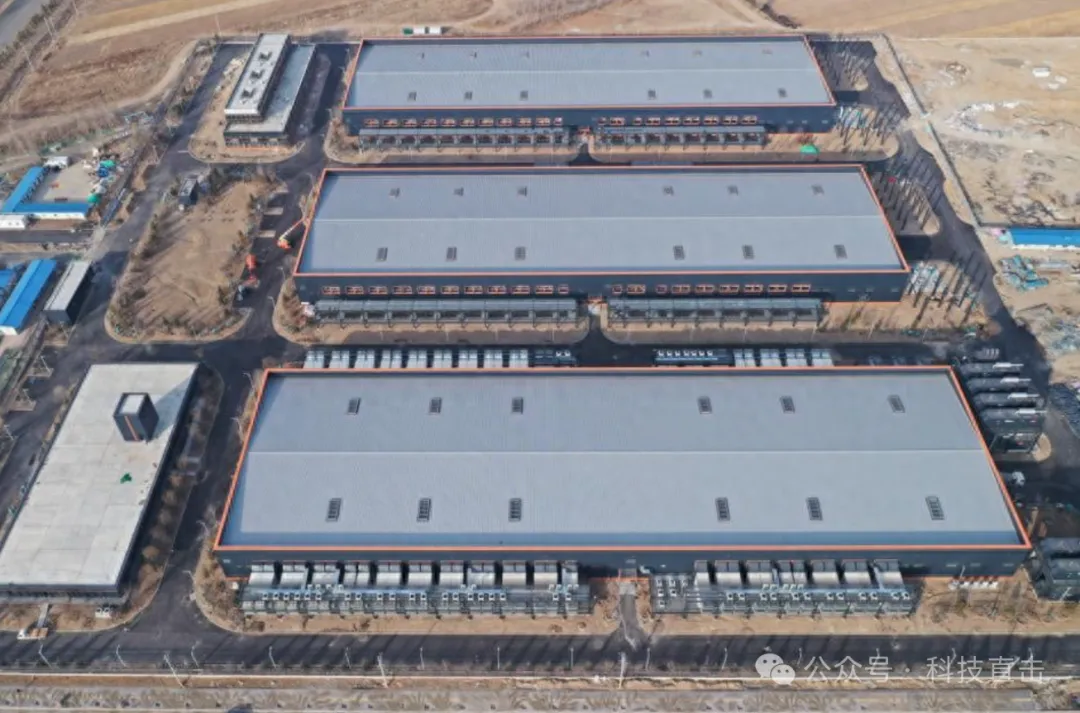
內蒙古烏蘭察布,風吹草低,見到的不是牛羊,是資料中心。
這片戈壁風光富集,冬天漫長寒冷,一座吉瓦級算力基地晝夜轟鳴。穿過機架和風道,讓矽谷睡不著的是:DeepSeek正部署至少16萬枚昇騰晶片。
墨卡托中國研究中心的資料擺在這裡,曾拿下中國AI晶片95%份額的輝達,在華跌到8%,昇騰吞下近50%,2026年收入預計破120億美元。徐直軍確認,昇騰在華銷量已反超輝達。
從95%到8%,這是算力反圍剿。
轉折要從特供晶片H20說起。A100、H100、B200被禁後,黃仁勳為保市場推出降規版H20,賭中國客戶會含淚買單。
各家CTO算完帳就清醒,H20保留96GB記憶體,算力被砍80%以上,等於賣你一輛法拉利,後備箱夠大,引擎蓋底下是割草機。
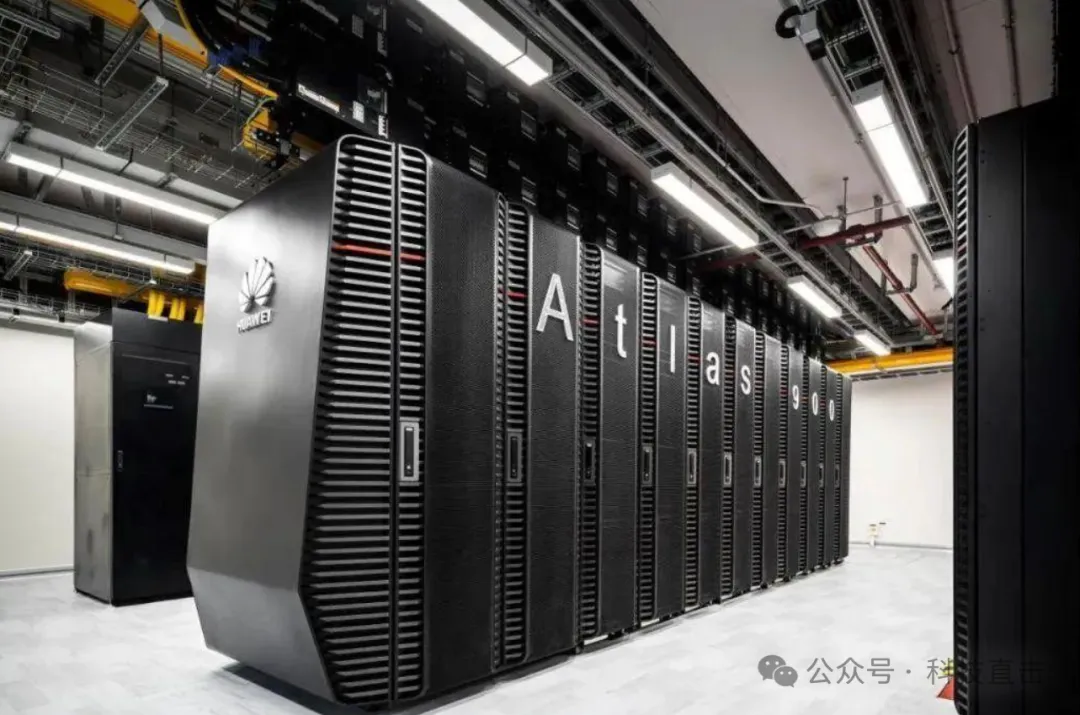
更要命的是固定成本,機櫃、供電、散熱一樣不少,湊齊同樣算力要買3倍伺服器,佔3倍機架,耗3倍電,還可能二次斷供。這不是買晶片,是請回一個吃電不幹活的祖宗。
單卡製程被卡死,國內沒在單卡極限上死磕,換了打法。
輝達頂級單卡是昂貴的百噸重卡,華為不造重卡,改鋪十萬節車廂的高鐵網。十萬卡叢集裡,決定訓練速度的早不是單顆算力,而是通訊牆和記憶體牆,也就是晶片之間說話快不快。
兩塊硬骨頭被啃下來。國產2.5D、3D封裝加自研記憶體合封,單卡記憶體頻寬拉到1.6TB每秒;近封裝光互連把光模組封在晶片旁,靠靈衢光網路把4096顆晶片組成超節點。16萬張昇騰這樣連起來,微秒級延遲讓它們協同得像一顆晶片,單顆電晶體的差距靠系統吞吐抹平了。
這裡有個被忽略的真相,為什麼偏偏是內蒙古。算力到今天已不只是晶片生意,是把電變成智能的生意。誰拿到便宜的電,誰能免費排掉熱量,誰就捏住成本命門。戈壁的風光和冬天就是天然電源和散熱器。輝達贏了製程,中國正把戰場拖回有優勢的電網和土地。
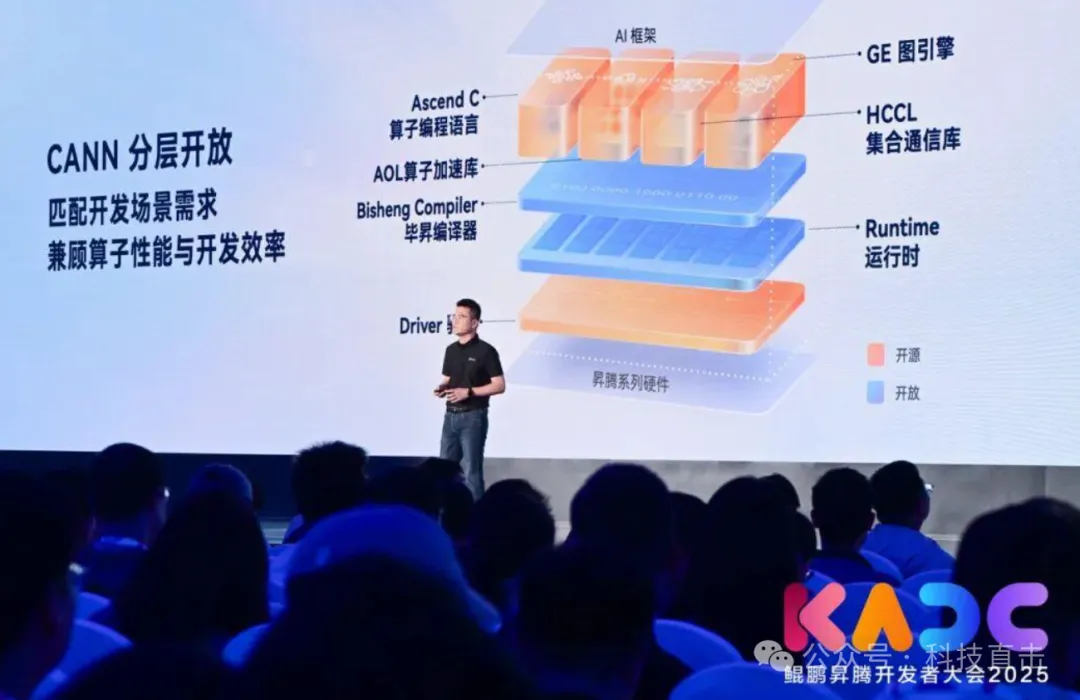
軟體更難。過去15年全球AI泡在CUDA閉環裡,早年做翻譯層直接挪程式碼,性能損失30%到50%,複雜指令直接崩。套殼沒有出路。
DeepSeek乾脆切掉CUDA遷入CANN,和華為工程師用Ascend C把400多個算子逐個重寫。華為下一代還做了分工,950PR負責吞下十幾萬字上下文,950DT負責吐答案。軟體棧在內蒙古跑通後,推理效率已能媲美同規格叢集。
封鎖本想把中國AI卡進黑暗時代,結果幫華為清掉最強對手,逼著頂尖演算法團隊和國產底層綁死。最狠的壓力沒掐死這個產業,反倒逼出二次發育。
當年拿來築牆的磚,被拿來墊了腳。 (科技直擊)