
這幾天除了Personal Agent(個人智能體)之外,AI圈還有條新聞受到關注:DeepSeek下場幫華為開放晶片算子的新聞。
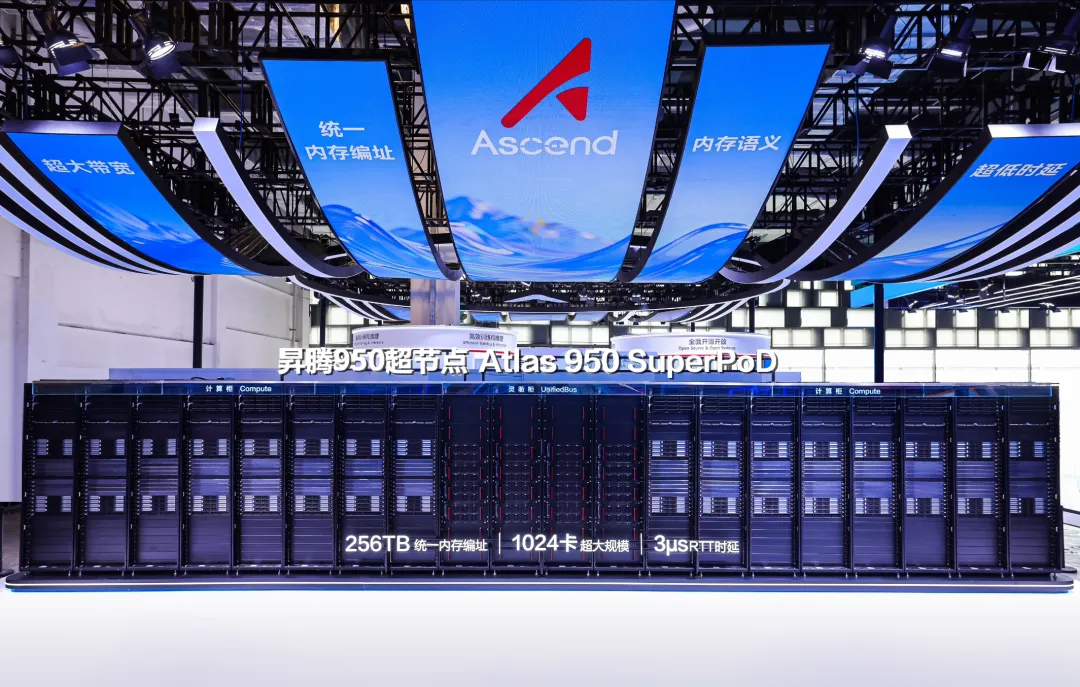
9月30日,DeepSeek宣佈與華為合作,圍繞昇騰AI晶片開源一系列程式設計基礎設施,包括計算庫、通訊庫,並推進一套基於128顆昇騰950的Supernode(超節點)方案。
這其中最值得注意的是TileLang,一種試圖讓AI晶片程式設計變得更簡單的高層程式語言。
不少媒體都在說:“老黃最擔心的事還是發生了,華為即將攻破CUDA生態。”
事實真的如此嗎?
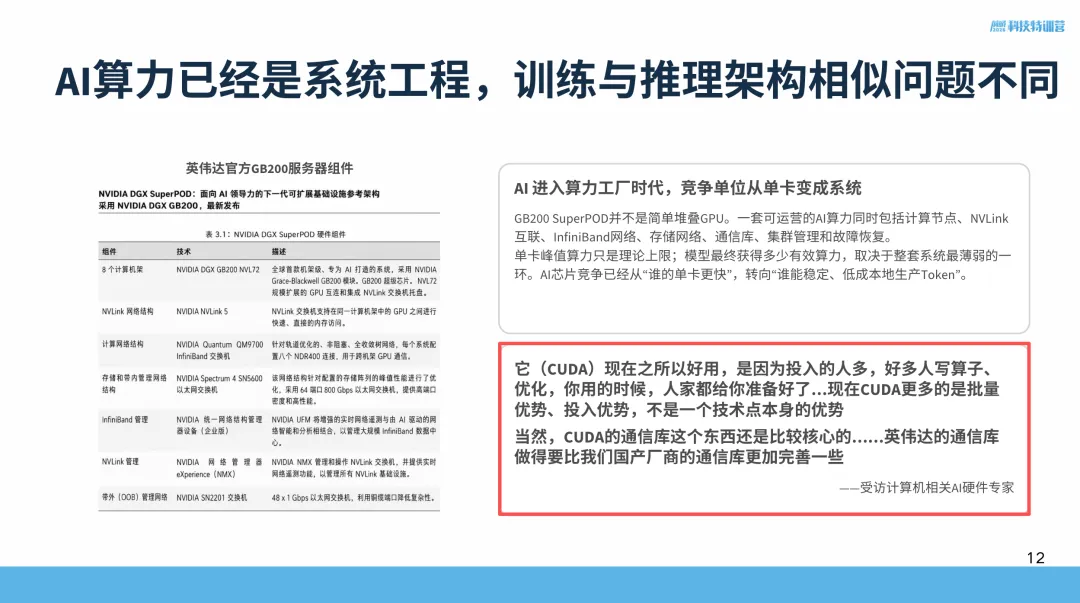
前哨會員對此應該不會太陌生。王煜全早在2023年就和大家討論過:輝達真正的壁壘早已經不只是CUDA。
今年的AI產業追蹤裡,我們又反覆提醒大家,CUDA這道曾經最難複製的軟體壁壘,也正在被AI一點點拆解。
DeepSeek和華為這次合作,更像AI時代產業範式加速變化的一個縮影:AI一邊降低舊壁壘的追趕成本,一邊又把競爭推向超節點、AI工廠和更完整的產業生態。
DeepSeek為什麼要親自下場幫華為寫軟體?
先看這次DeepSeek到底在做什麼。
一顆AI晶片真正跑起來,中間其實隔著好幾層。
最底下當然是昇騰950這樣的硬體,但有晶片不等於模型就能高效運行。
你還需要大量針對硬體最佳化過的Kernel(計算核心),去完成矩陣乘法、Attention(注意力計算)、量化、MoE(混合專家模型)路由這些最基礎的操作。
這就是DeepSeek這次開放計算庫的意義。
同樣一個計算任務,普通程式碼可能只能發揮一半晶片性能,一個高度最佳化的Kernel卻可能把硬體性能吃到八九成以上。
所以很多時候,我們看到的“晶片性能差距”,裡面其實混著巨大的軟體差距。
第二層是通訊。
現在的大模型早就不是一張卡獨立完成計算。幾十張、幾百張甚至幾萬張晶片必須一起工作,尤其是DeepSeek這樣的MoE模型,不同專家可能分散在不同晶片上,每一次訓練和推理都需要大量資料來回交換。
如果通訊庫做不好,128顆晶片並不會自動變成一台強大的機器,只會變成128座互相堵車的小島。
所以DeepSeek這次開放通訊庫,和華為推進128顆昇騰950組成的Supernode(超節點),其實是一體兩面,解決“一群晶片怎麼一起算”。**
然後才輪到TileLang。
過去想把GPU(圖形處理器)性能壓榨到極致,工程師往往要非常理解底層硬體:資料怎麼分塊、記憶體怎麼搬、線程怎麼排、那些資料放進快取記憶體。
CUDA厲害的地方,就是輝達用了近二十年,把這套複雜工作逐漸包裝成成熟的軟體棧和開發體系。
TileLang則試圖再往上一層。開發者不必從頭告訴晶片“每個線程具體怎麼幹”,描述“我要完成什麼計算、資料如何分塊、資料之間是什麼關係”,再讓編譯器把它翻譯成適合不同硬體的底層實現。
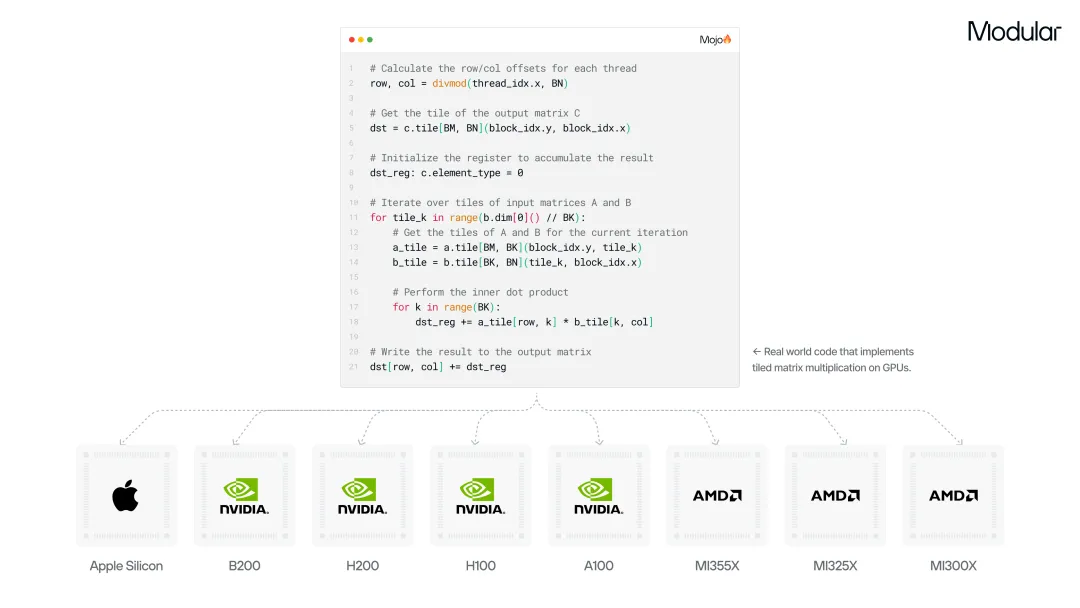
TileLang已經開始支援CUDA、ROCm(AMD開放計算軟體棧)、Metal(蘋果圖形與計算介面)等不同後端,面向華為昇騰也出現了TileLang-Ascend(TileLang昇騰適配)。
DeepSeek還基於TileLang開源了TileKernels(高性能計算核心庫),把MoE路由、量化等真實大模型裡的高性能算子放進去。
所以DeepSeek親自來做這件事一點也不奇怪。
晶片公司知道硬體怎麼設計,模型公司卻最清楚真實的大模型到底怎麼“折磨”硬體:那個算子最耗時間、MoE的資料怎麼流動、通訊堵在那裡、那些環節最值得最佳化。
過去是華為造晶片,模型公司來適配;現在開始變成模型公司反過來參與定義,下一代晶片到底應該怎麼被使用。
這才是這次合作真正重要的地方。
AI正在成為攻克CUDA的一件新武器
如果只看DeepSeek,很容易誤以為這是中國特有的國產替代故事。
實際上,今年整個AI晶片行業都在發生同一件事:大家開始用AI寫“運行AI的軟體”。
AMD就是最典型的例子。
過去開發者把CUDA項目遷到AMD的ROCm,雖然已經有HIPIFY(CUDA程式碼遷移工具)這樣的自動翻譯工具,但仍然麻煩,要改算子、調記憶體、適配不同GPU架構,再不斷修Bug(程序缺陷)。
現在AMD正在把Agent(智能體)直接引進這個流程。
它的MOAT(多智能體遷移工具)可以讓Claude Code(Claude程式碼智能體)或者Codex(程式碼智能體)自動閱讀一個CUDA項目:一個Agent分析程式碼,一個負責遷移,一個審查修改,另一個直接在AMD GPU上測試,失敗後再返回繼續調整。
今年推出的ROCm.AI(AI原生ROCm開發環境)又往前走了一步。
Claude、Codex、Cursor(AI程式設計工具)、Gemini(GoogleAI模型)都可以直接呼叫AMD提供的Skills(技能),幫助開發者安裝環境、部署模型、尋找問題;Hyperloom(自動性能最佳化工具)甚至會自己尋找推理瓶頸、修改Kernel,再驗證性能有沒有提高。
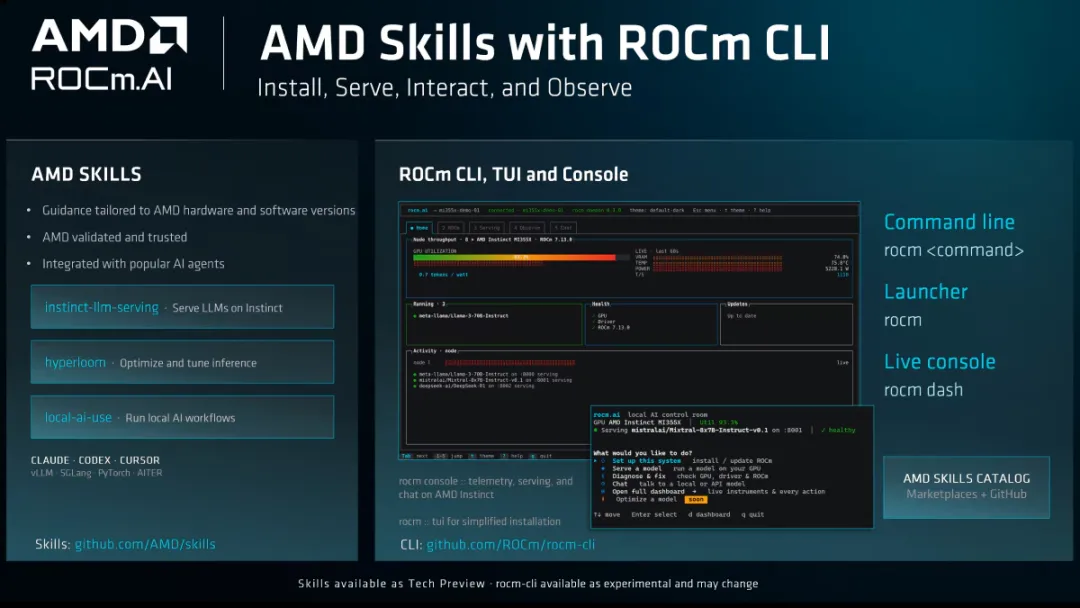
今年7月,Anthropic和AMD簽署大規模合作時,雙方還明確寫進協議:Claude會幫助AMD最佳化GPU工作負載,加速ROCm開發。
這已經非常接近“AI自己幫助競爭晶片補軟體生態”。
另一邊,我們介紹過的Modular也一直在做類似的事情。
它用Mojo(程式語言)和MAX(AI推理平台),希望開發者寫一次程序,底層系統儘可能替他處理不同晶片之間的差異。
OpenAI的Triton(高層GPU程式設計框架)走的也是這個方向。有意思的是,輝達自己今年也開始給Triton提供CUDA Tile IR(CUDA分塊中間表示)後端,讓開發者繼續使用更高層的程式設計方式,再由底層系統對應到輝達硬體。
Google甚至發佈了JAXBench(TPU核心最佳化基準),專門測試AI Agent能不能自主最佳化TPU(張量處理器)的底層Kernel。
這些看起來分散的動作,其實都在指向同一個變化:CUDA鎖住開發者的軟體壁壘,正在被AI快速攻破。
AI競爭的單位,已經從公司變成生態
這才是DeepSeek和華為這次合作更值得關注的地方。
如果只是比較一顆晶片快多少、一個程式設計工具好不好用,很容易低估今天AI產業的複雜程度。
輝達這些年真正做的,就是不斷把競爭單位往上推:從GPU到CUDA,再從CUDA走向NVLink(高速晶片互連)、NVSwitch(高速交換晶片)、網路、機架、超節點和AI Factory(AI工廠)。
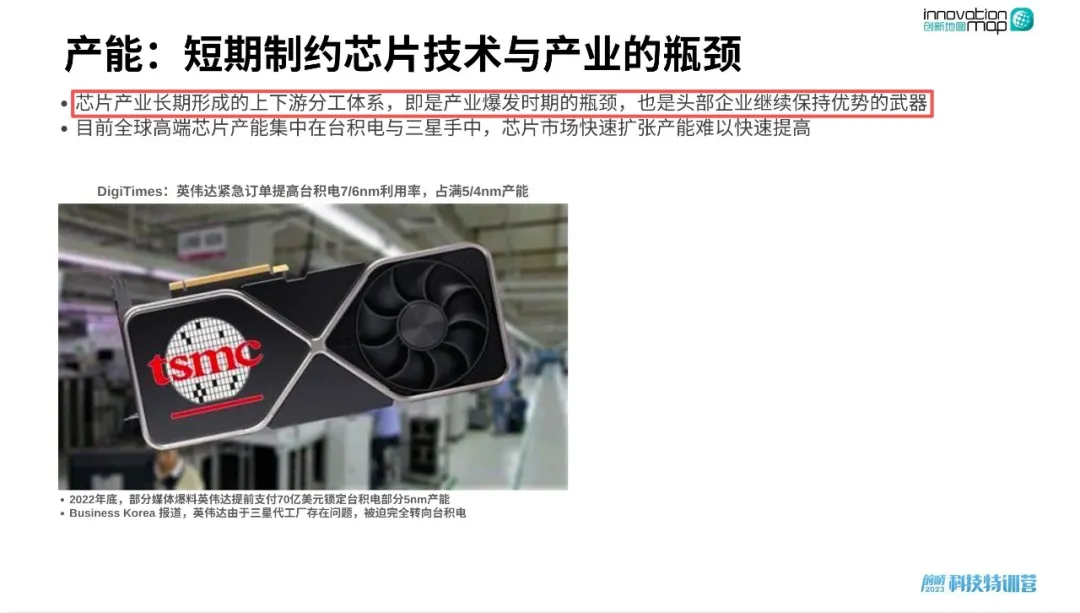
所以前哨早在2023年就提醒大家,輝達真正的生態壁壘已經不只是CUDA。
今年我們繼續追蹤AI如何反過來降低CUDA這樣的舊軟體壁壘,看到AI的競爭早已不是DeepSeek對輝達、華為對輝達這種簡單的“一家公司打另一家公司”。
它越來越像一組生態和另一組生態之間的競爭,而且競爭與合作會同時存在。
大家會爭標準、爭入口、爭利潤,也會在不同層級上彼此合作。
這才是這件事真正反映出的趨勢:AI正在加速技術迭代,也在加速產業重新組合。
未來決定勝負的,是誰能把模型、晶片、軟體、開發者和應用組成一個迭代速度更快、成本更低、協同效率更高的生態。(創新地圖)