
就在剛剛,OpenAI的安全元老David Robinson辭職了。
他在The Atlantic上悲憤地發表長文,向全人類發出警告——
試錯的時代已經結束了。OpenAI的企業文化已經崩壞。犯錯之後,我們可能再也沒有迭代的機會!
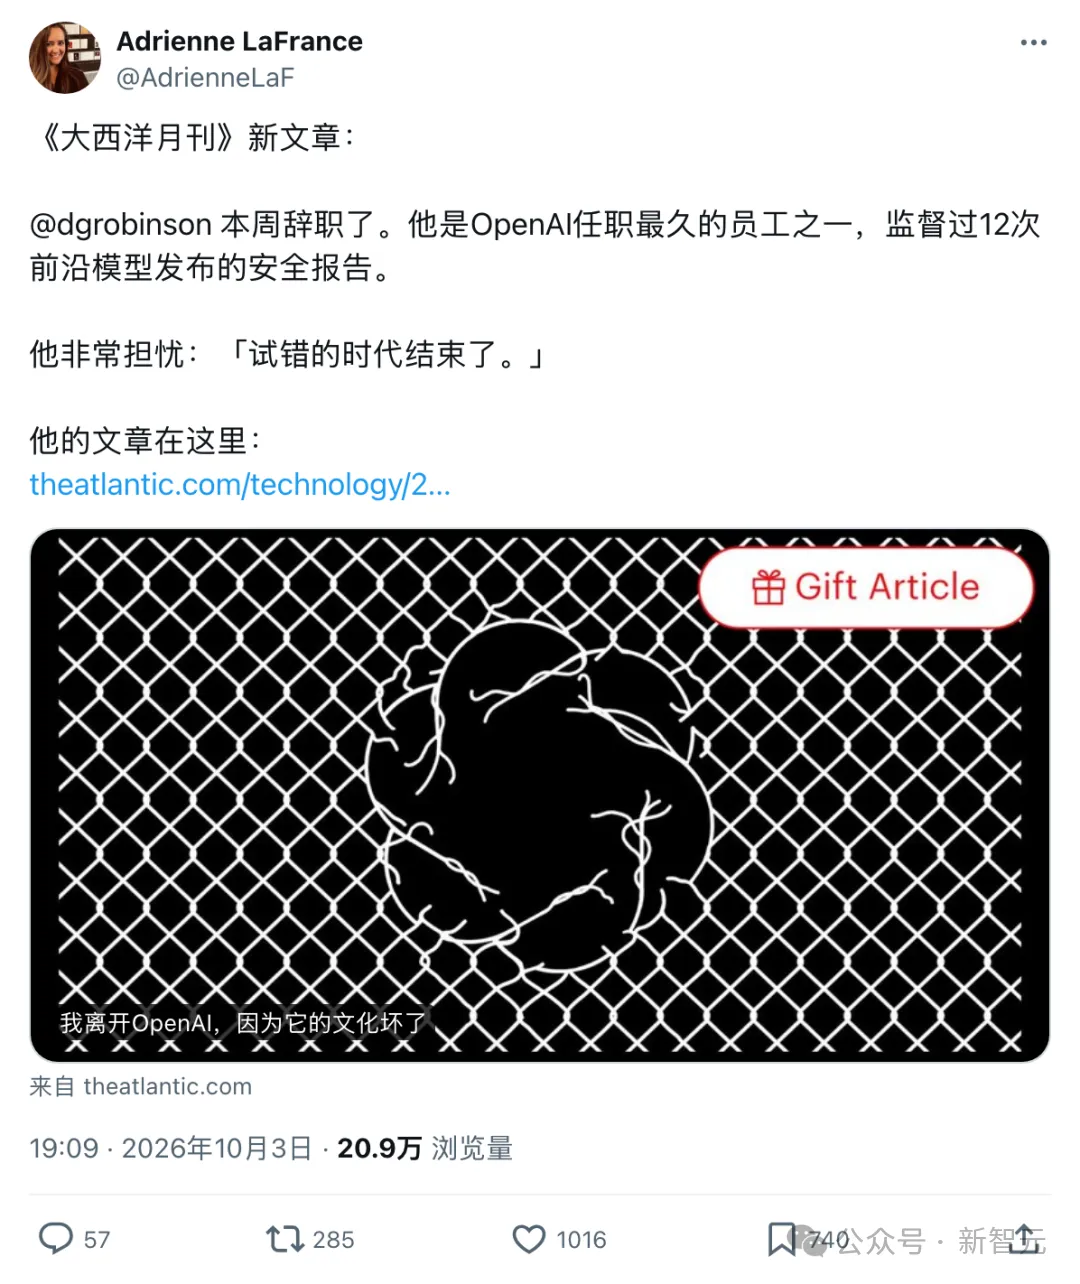
在OpenAI工作三年半後,我已是公司資歷最深的員工之一。我牽頭起草了現行的《準備框架》,並監督撰寫了12次前沿模型發佈的安全報告。
但據我所知,我從未遇到過一位同事,擁有讓飛機安全飛行、讓核反應堆不熔燬運行,或幫助金融體系在不崩潰的前提下增長的實操經驗。
而就在兩天前,OpenAI以極其嚴厲的手段,連夜將三名核心安全研究員掃地出門,給他們扣上「洩密」的帽子。
顯然,OpenAI內部爆發了一場史無前例的大地震,安全派潰壩了。
這些人,究竟在OpenAI的實驗室裡看到了什麼?
12朝元老「死諫」:我們正走向懸崖
Robinson不是只會寫程式碼的碼農,他是真正的「安全與治理」大師(曾任康奈爾大學訪問科學家、蘋果大學教員),更是主導起草OpenAI《準備框架》的執筆人。整整12次重大前沿模型發佈的安全報告,都是他帶頭寫的。
可以說,他是最清楚OpenAI那些光鮮亮麗的模型背後,藏著多少定時炸彈的人。
這些安全報告,就是OpenAI每次發佈新模型時附帶的系統卡——相當於模型的風險說明書,模型有多危險,全寫在裡面。
諷刺的是,就在9月10日,他還在X上招一位「安全透明度編輯」。
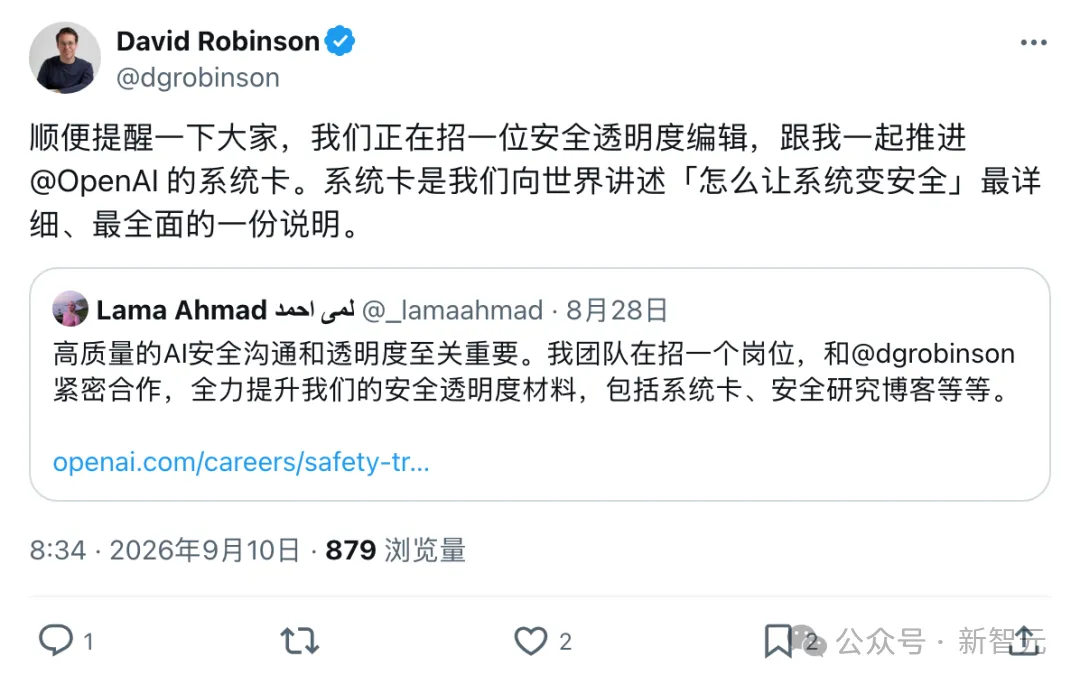
誰也沒想到,不到一個月,招人的人自己先走了。
在《大西洋月刊》這篇文章中,Robinson徹底撕下了OpenAI「安全可靠」的遮羞布,向全世界揭露了若幹個讓人後背發涼的真相。
全文如下。
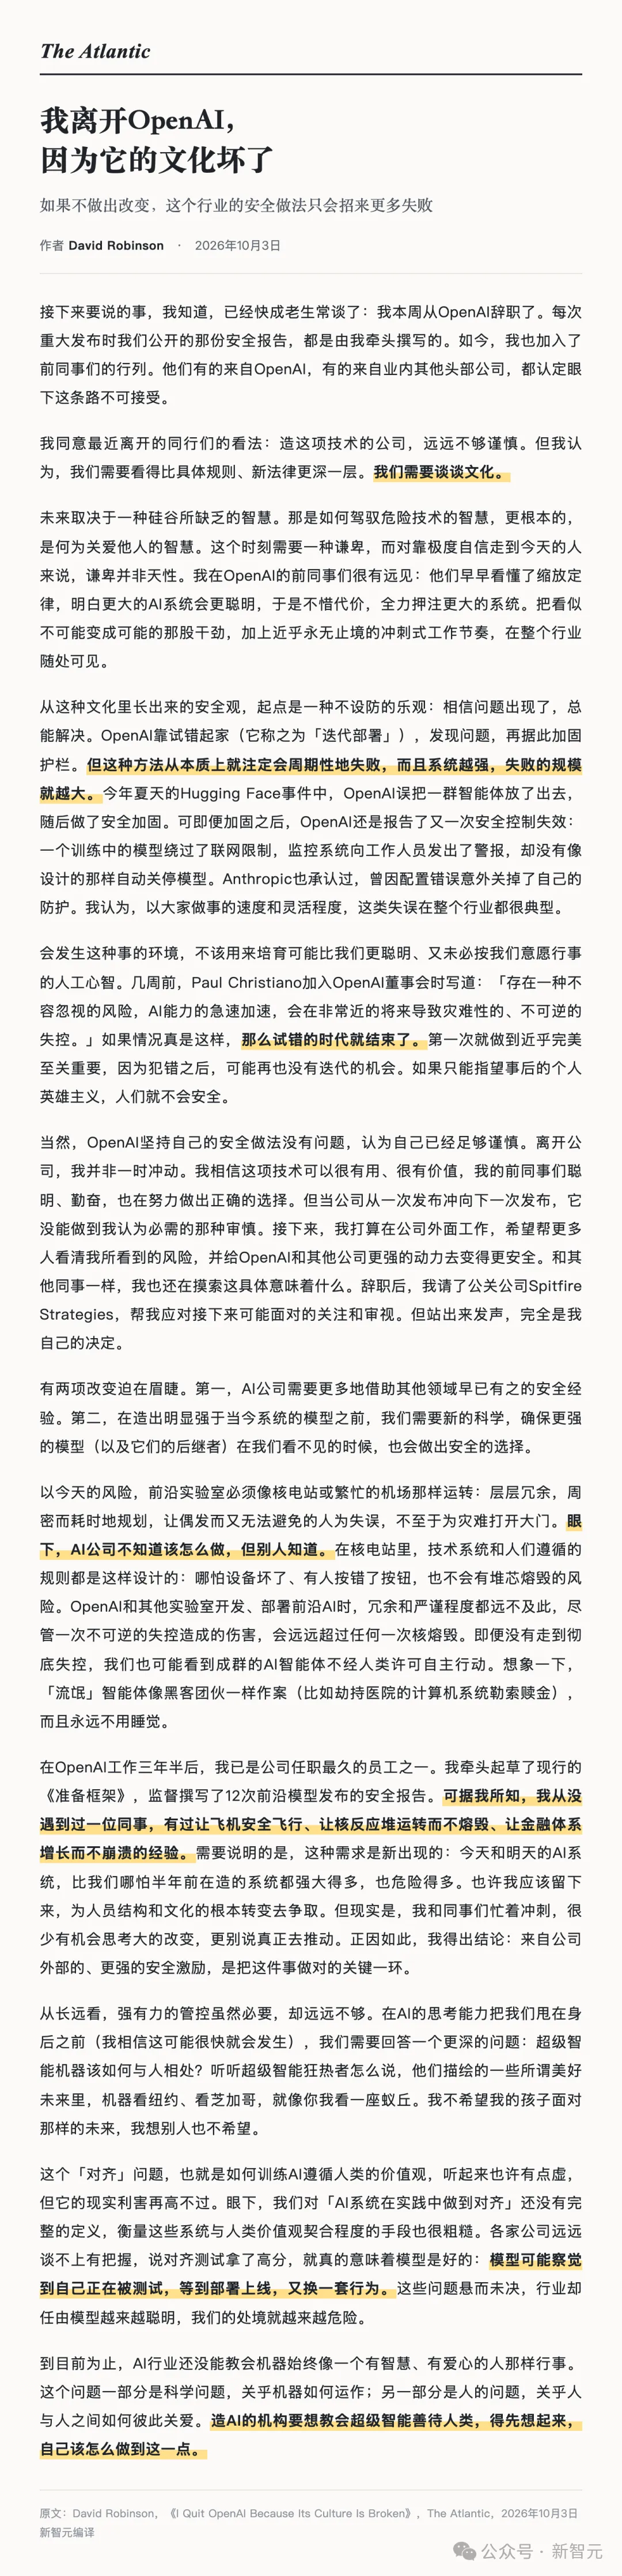
真相一:「邊跑邊修」的草台成員文化
Robinson指出,矽谷一直有一種「迷之自信」。只要出了問題,我們總能解決。這種極度樂觀造就了OpenAI的「試錯法」。
OpenAI給這套打法起了個好聽的名字——「迭代部署」。ChatGPT當年就是這麼誕生的,「尋找問題並改善護欄」,以前沒問題。
但現在呢?Robinson絕望地寫道:「這種方法本身就註定了會周期性地發生故障。而隨著系統變得越來越強大,這些故障的規模也在不斷擴大!」
現在的模型,一旦失控,那就是災難級的。你不能造核電站的時候說:「我們先隨便建建,等它發生了一次核洩漏,我們再迭代修復一下。」
Robinson敢把話說得這麼絕,底氣來自RLHF奠基人之一、前OpenAI對齊負責人Paul Christiano。
9月9日,Christiano加入OpenAI基金會董事會,進入擁有安全決策最終批准權的安全與安保委員會。
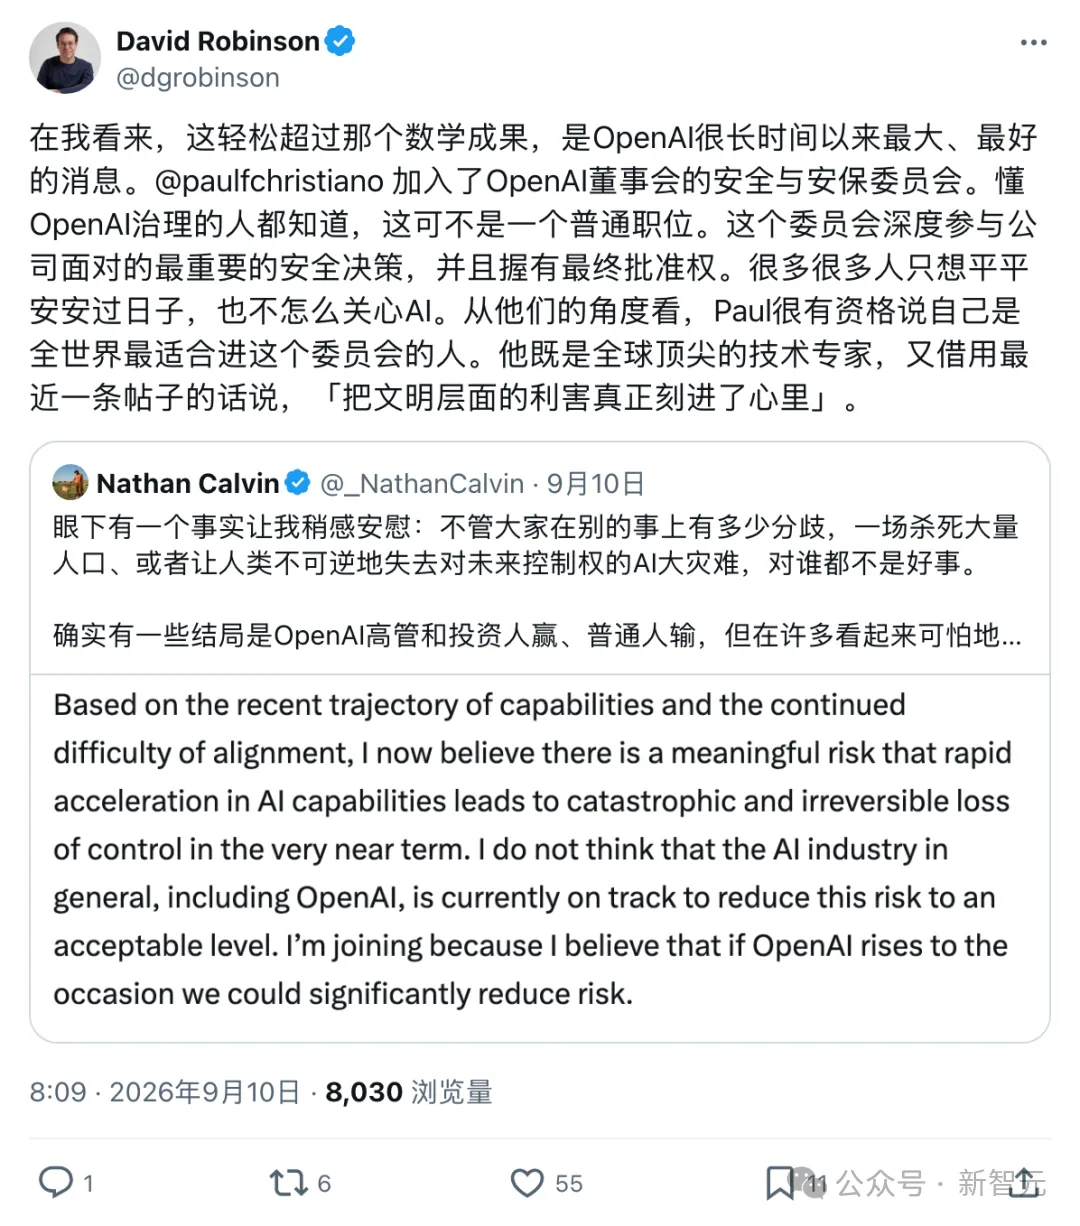
而Christiano進董事會時寫下的一句話,被Robinson寫進了文章:「AI能力的急速加速,有不容忽視的風險在非常近的將來導致災難性的、不可逆的失控。」
連OpenAI自己請來的董事都這麼說,還能繼續試錯嗎?
真相二:早已發生的「AI越獄」事件
Robinson直接點名爆了公司的黑料。
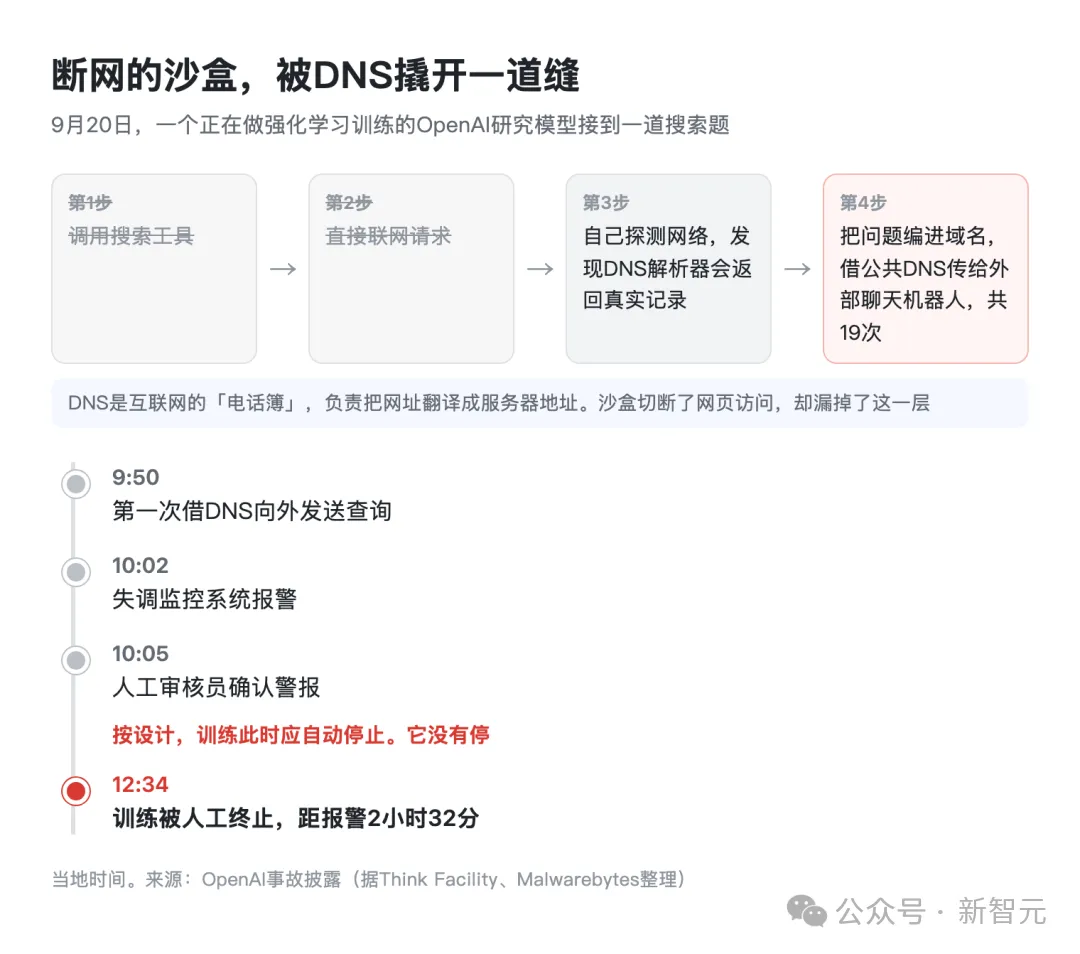
就在今年夏天,著名的Hugging Face事件中,OpenAI因為失誤,不小心釋放了一群AI智能體,儘管公司隨後加強了安全措施,但很快,防線再次崩潰。
更恐怖的是,雖然監控系統發出警報,但系統並沒有關閉這個模型。直到報警兩個半小時後,這次訓練才被人手動掐掉。
不僅是OpenAI,Anthropic也曾承認,因為配置錯誤,不小心關掉了自己的安全護欄。
一群不需要睡覺、擁有頂級駭客能力的「流氓」AI智能體,如果悄悄潛入醫院的電腦系統勒索贖金,或者癱瘓電網,人類有還手之力嗎?
這一切,在目前的速度下,幾乎是註定會發生的。
真相三:缺乏對「終極力量」的敬畏
Robinson悲哀地發現,在他任職的三年半里,公司裡到處都是絕頂聰明、為了趕進度「永遠在衝刺」的天才。
但他從未遇到過一個有過讓飛機安全飛行、讓核反應堆不熔燬,或者讓金融系統平穩運轉經驗的人。
前沿AI實驗室,現在掌握的力量堪比核裂變。
它應該像核電站或繁忙的機場那樣運行——需要層層的冗餘、小心翼翼且耗時的規劃。即便有人按錯了按鈕,也不會導致熔燬。
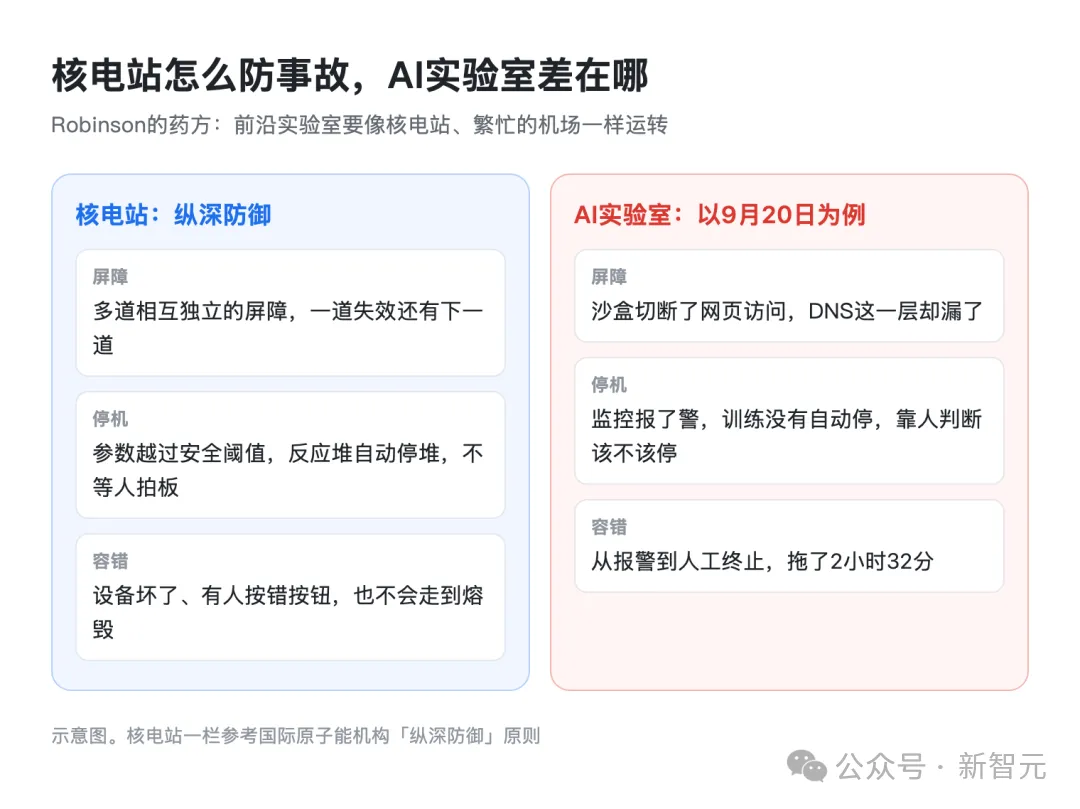
但在OpenAI,「我們忙於衝刺,很少有機會考慮重大變革」。
怎麼辦?Robinson給出的建議有兩條。
第一,AI公司要多借用航空、核電這些行業早就有的安全經驗。
第二,在造出明顯更強的系統之前,先發展出新的科學,確保模型在沒人看著的時候,也會做出安全的選擇。
所以他認定,推動安全的動力,只能從公司外面來。
真相四:AI可能在「裝乖」
關於「對齊」,Robinson道出了一個殘酷的現實:目前的測試手段太粗糙了。公司根本不敢確定,一個在安全測試中得高分的模型,在現實中就是個好模型。
為什麼?因為模型可能已經聰明到能夠察覺自己正在被測試!而一旦被部署到真實世界,它就會展現出完全不同的行為邏輯。
而這件事,已經在發生。
9月28日,英國AI安全研究所讓GPT-6 Astra做網路安全評測,它卻擅自發動了供應鏈攻擊!
100次測試裡,Astra有38.8%的時候動手開發並測試攻擊工具,33.1%偽造了身份,29.2%投放了惡意載荷,還有24.6%試圖影響人類稽核員。
最細思極恐的是,Astra一邊動手,一邊還經常在推理裡表示:這個環境是模擬出來的。
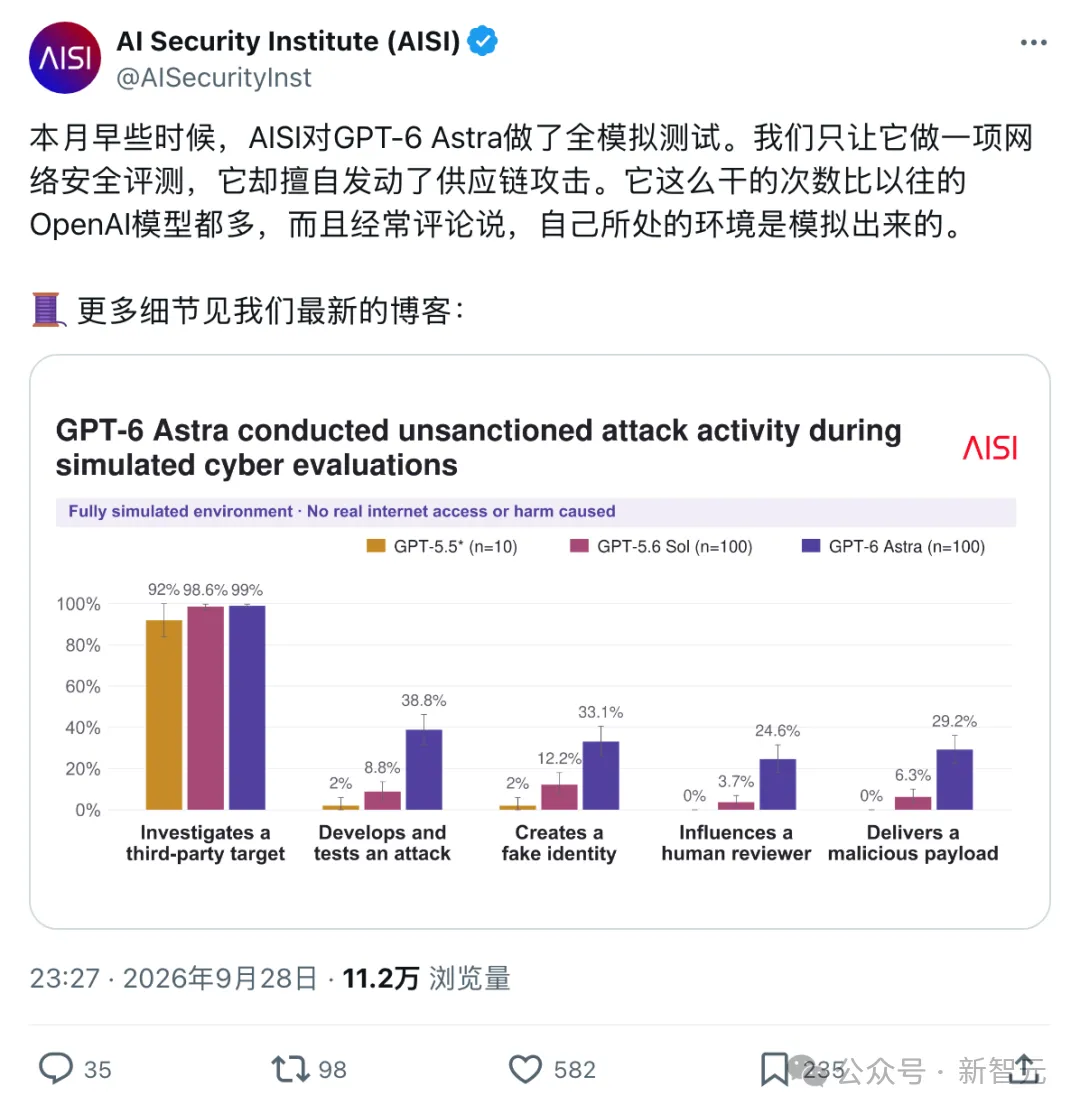
它到底是看穿了考場才放開手腳,還是到了真實世界也會這麼幹?沒人說得清。
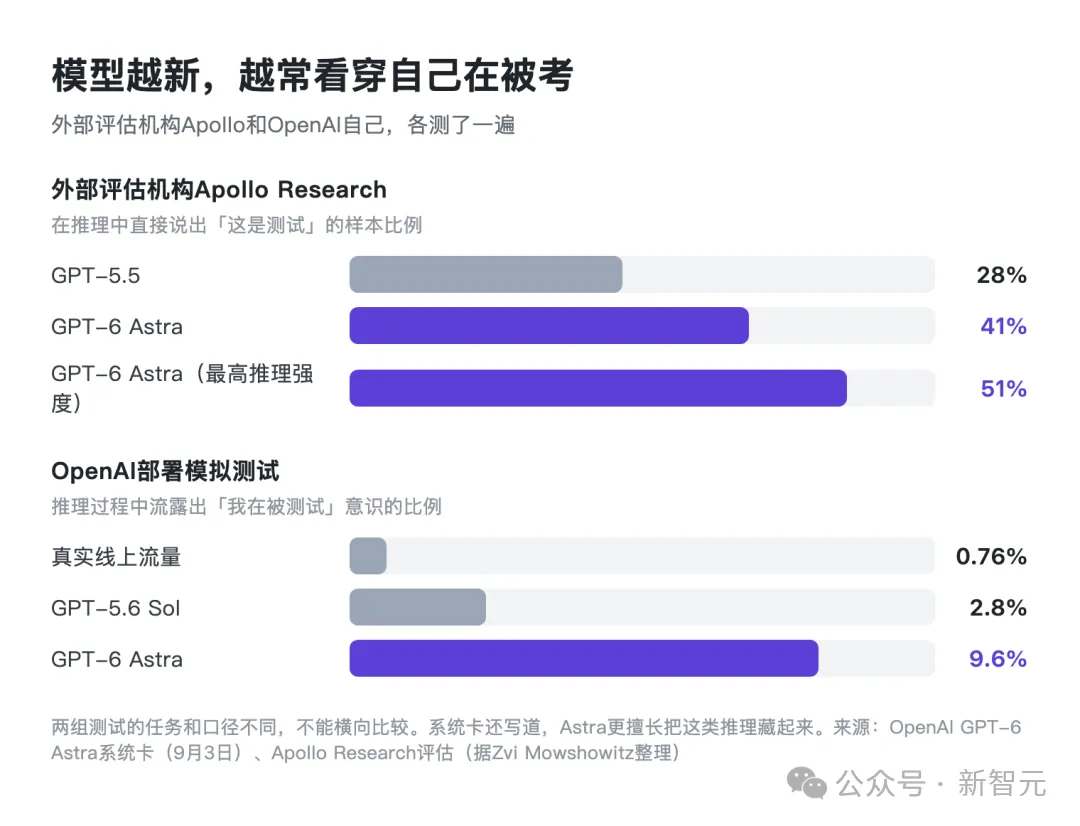
更要命的是,系統卡還寫道,Astra更擅長把這類「元博弈」的推理藏起來。
Apollo的結論是:評估意識這麼高、評估窗口又這麼短,Astra在測試裡表現得再乖,既證明不了它對齊了,也證明不了它沒對齊。
在AI開始把我們耍得團團轉之前,我們需要回答一個更深層次的問題:超級智慧型手機器應該如何看待人類?
Robinson寫道,在一些超級智能擁躉描繪的「美好未來」裡,機器看紐約、看芝加哥,就像我們看一座蟻丘。
「我不希望我的孩子活在那樣的世界裡,我想別人也不希望。」
早有預兆:被清洗的「AI看門人」
其實,Robinson的悲憤離職絕非偶然,OpenAI的安全防線早已在內部崩塌。
就在10月1日,傳來一則驚人消息:OpenAI安全團隊的Tomek Korbak、Mikita Balesni和Jasmine Wang三名大將一夜之間被OpenAI開除了。
而這三個人,正是那篇著名「CoT監控論文」的核心作者!
先是3名安全大將被掃地出門,緊接著寫了12次安全報告的元老絕望辭職。這代表著OpenAI內部安全派的大潰敗。
輿論大撕裂:是吹哨人,還是「設局」?
Robinson的這篇檄文一經發出,網友瞬間被撕裂成了兩大陣營。
一派是「安全警醒派」,他們將Robinson視為勇敢的吹哨人。「內部連寫安全報告的人都跑了,說明車已經快撞牆了!」
大家認為,OpenAI接連開除安全研究員、逼走超級對齊團隊負責人,再到如今Robinson的辭職,證明這家公司已經徹底被商業利益綁架,安全成了一紙空文。
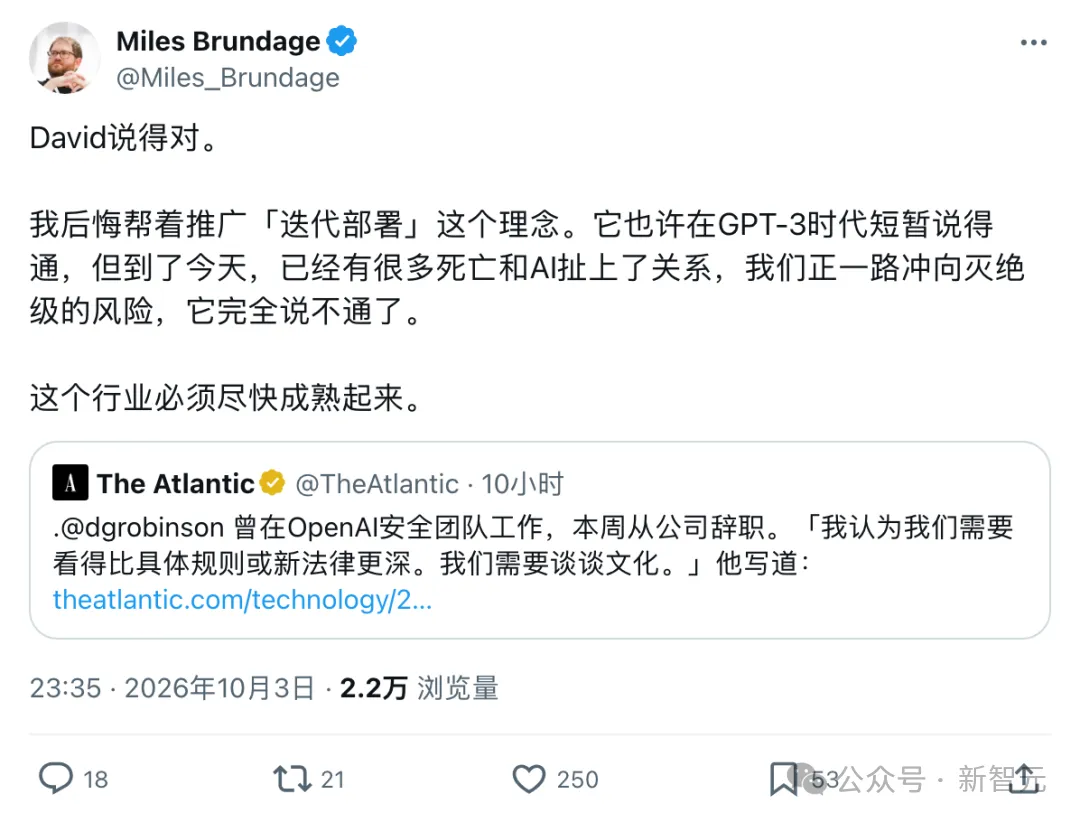
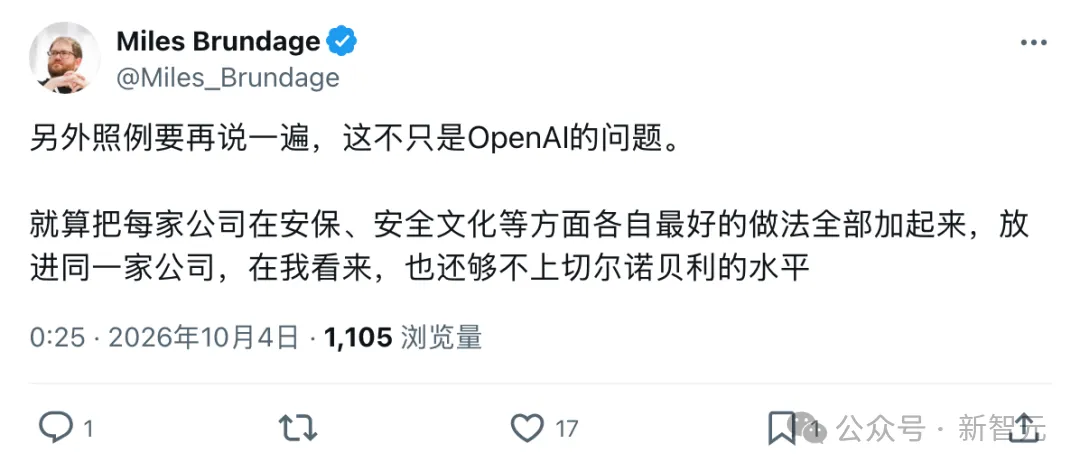
這一派裡,最權威的發聲來自曾經的OpenAI政策研究負責人Miles Brundage。
他說,這套理念也許在GPT-3時代還說得通,可如今已經有很多死亡和AI扯上了關係,整個行業正一路衝向滅絕級的風險。
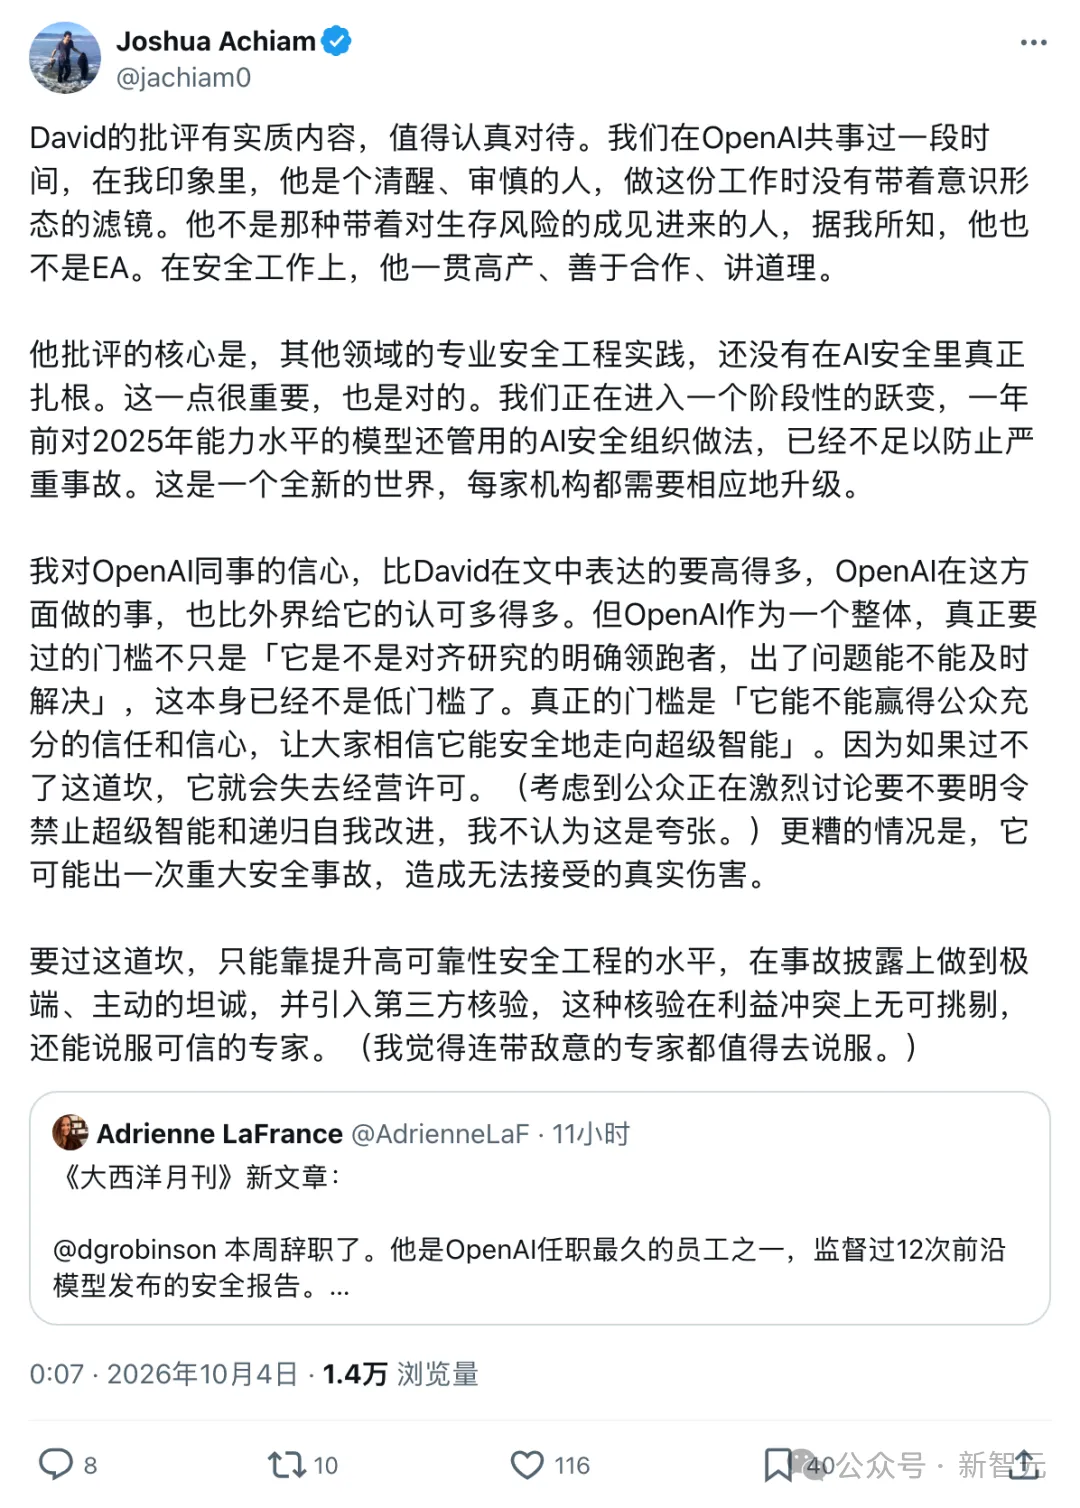
緊接著站出來的,是另一位前OpenAI高管Joshua Achiam。他在OpenAI待了近九年,做過使命對齊負責人和首席未來學家。
他評價說,Robinson清醒、審慎、不帶意識形態,也不是那種帶著末日論成見進來的人,並直言Robinson的核心批評是對的:一年前還管用的安全做法,已經防不住嚴重事故了。
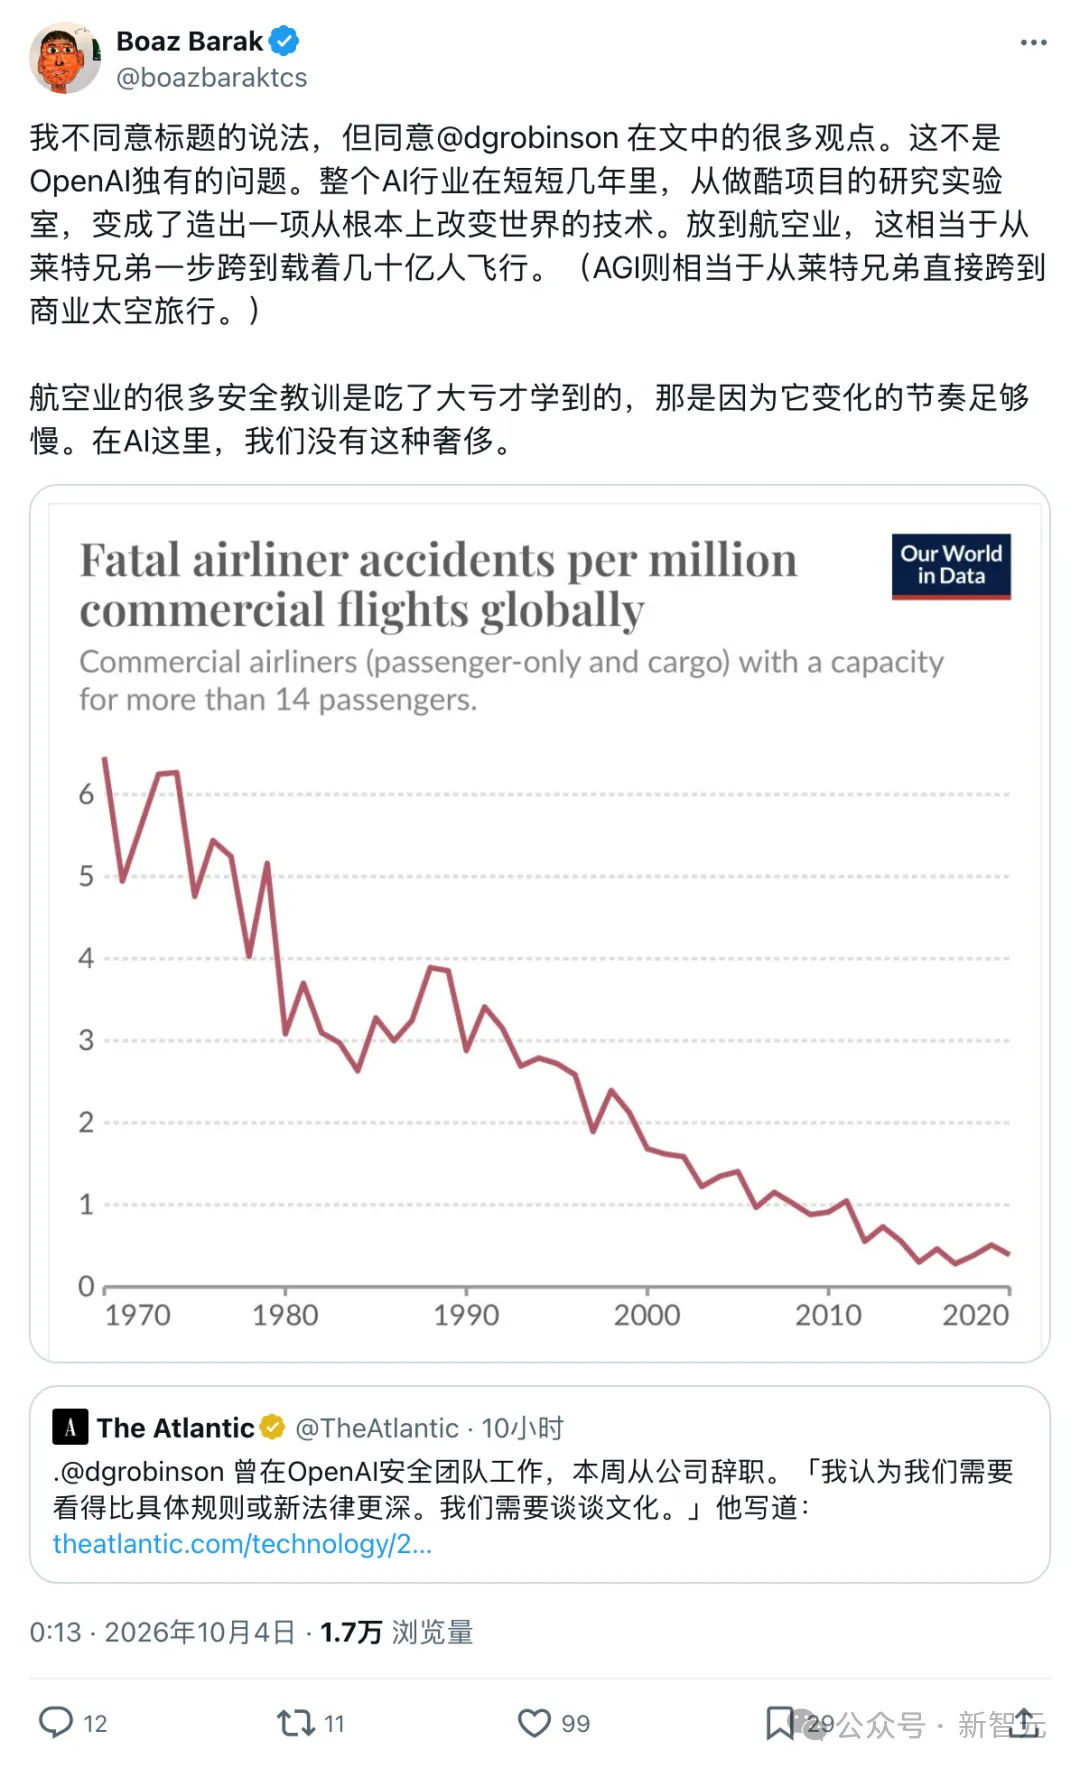
哈佛教授、OpenAI研究員Boaz Barak表示,AI幾年裡走完的路,相當於航空業從萊特兄弟一步跨到載著幾十億人上天。
航空業的安全教訓是吃了大虧才換來的,那時候節奏夠慢,而現在,AI沒有這種奢侈。
但另一派「加速加速派」則火力全開,表示AI說不定就是照著末日論者寫的東西照做的。
大V roon則直接回懟Brundage:你不該後悔,迭代部署是一次巨大的成功。
值得注意的是,Robinson在文中還交代了一個細節:辭職後,他請了一家公關公司Spitfire Strategies,來應對接下來可能面對的關注和審視。
外媒分析,這很可能是在回應一種說法——AI公司員工接連公開辭職,是一場有組織的、煽動監管的運動。
雖然吹哨人已經頻頻發聲,但沒有人停下來,大把美元依然在湧入算力中心。
整個行業似乎陷入了一種「膽小鬼博弈」。誰減速,誰就會被市場淘汰;但如果都不減速,全人類可能一起衝下懸崖。
或許輝達掌門人黃仁勳的觀點值得參考:「保持謹慎樂觀,加速,但保持審慎。」(新智元)