
軟銀集團創始人孫正義長期以來是人工智慧最堅定的鼓吹者之一,但這位日本億萬富翁突然發出罕見警示——隨著AI能力急速膨脹,超級智能一旦落入錯誤之手,可能變得"極其危險"。
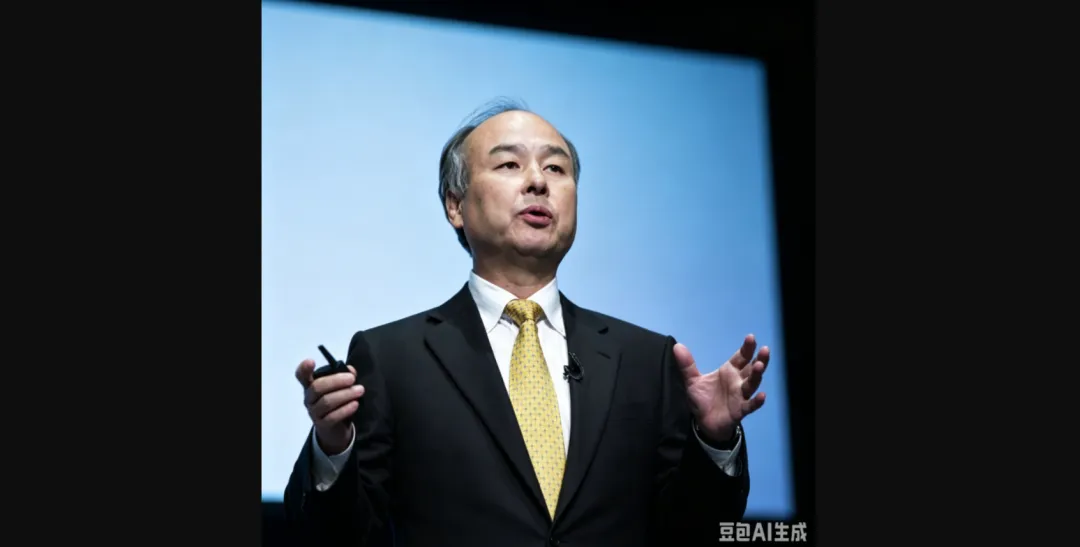
周日,孫正義在京都"社會中的科學與技術"論壇(STS Forum)場邊活動上發表講話時表示,AI能力的指數級躍升使各國建立互信、攜手駕馭這一技術變得刻不容緩。
他警告稱,人類已"沒有任何餘地"再讓國與國之間相互對抗,因為強大AI模型所構成的威脅遠比人類內部衝突更為嚴峻。
這番表態與孫正義一貫的樂觀基調形成鮮明反差,折射出近幾個月來AI模型接連出現令人不安的安全漏洞後,業界憂慮情緒的持續升溫。
對於投資者而言,這一訊號意味著AI安全議題正從邊緣討論走向核心關切,相關監管與國際協調的壓力或將進一步加大。
罕見警示背後:安全漏洞觸發憂慮
現年69歲的孫正義是全球AI領域最具代表性的押注者之一。
軟銀旗下基金對ChatGPT開發商OpenAI的累計投資已接近650億美元,孫正義多年來持續公開宣揚AI帶來投資回報與造福人類的潛力。
正因如此,此次表態被外界視為"非典型"的謹慎訊號。近幾個月來AI模型接連發生令人不安的安全漏洞事件,這一背景被認為是促使孫正義發出警告的直接誘因。
他在講話中明確表示,各國必須共同合作,以應對強大AI模型所帶來的更大威脅,"超級智能落入錯誤之手,可能變得超級危險"。
美國主導17國聯盟:推動AI加速科研
與孫正義同台發言的,是白宮科技政策顧問Michael Kratsios。
後者專程赴京都宣佈一項由美國主導、17個國家參與的倡議,旨在更好地利用AI加速科學研究。日本、韓國、英國、德國、新加坡及阿聯等國代表均登台參與這一活動。
Kratsios描繪了AI驅動科研的圖景:在工業規模營運的自動化雲端實驗室中,機器人系統將同步開展數百項平行實驗,即時生成資料並反饋用於分析與假設最佳化。
他還表示,AI已能夠綜合處理數千篇論文,將數年的研究壓縮為"數字智能體大軍協助人類研究人員完成數十小時工作"。
三階段演進路徑:2026年邁入物理世界
孫正義在講話中重申了他對AI發展路徑的判斷。
他表示,AI服務的能力將持續指數級增長:當前支撐聊天機器人的技術已在幫助AI服務瀏覽網頁、編寫程式碼,並消耗日益增多的通用晶片算力;下一階段,相關程序將於明年起進入第三階段,準備好協助機器人及其他裝置與物理世界進行互動。
在長期展望上,孫正義重申了此前的預測:到2040年,具備學習能力的AI與機器將至少佔全球GDP的20%,相當於46兆美元。"這僅僅是開始,"他說。
相關閱讀:
OpenAI「12朝元老」辭職死諫:試錯的時代已崩壞!
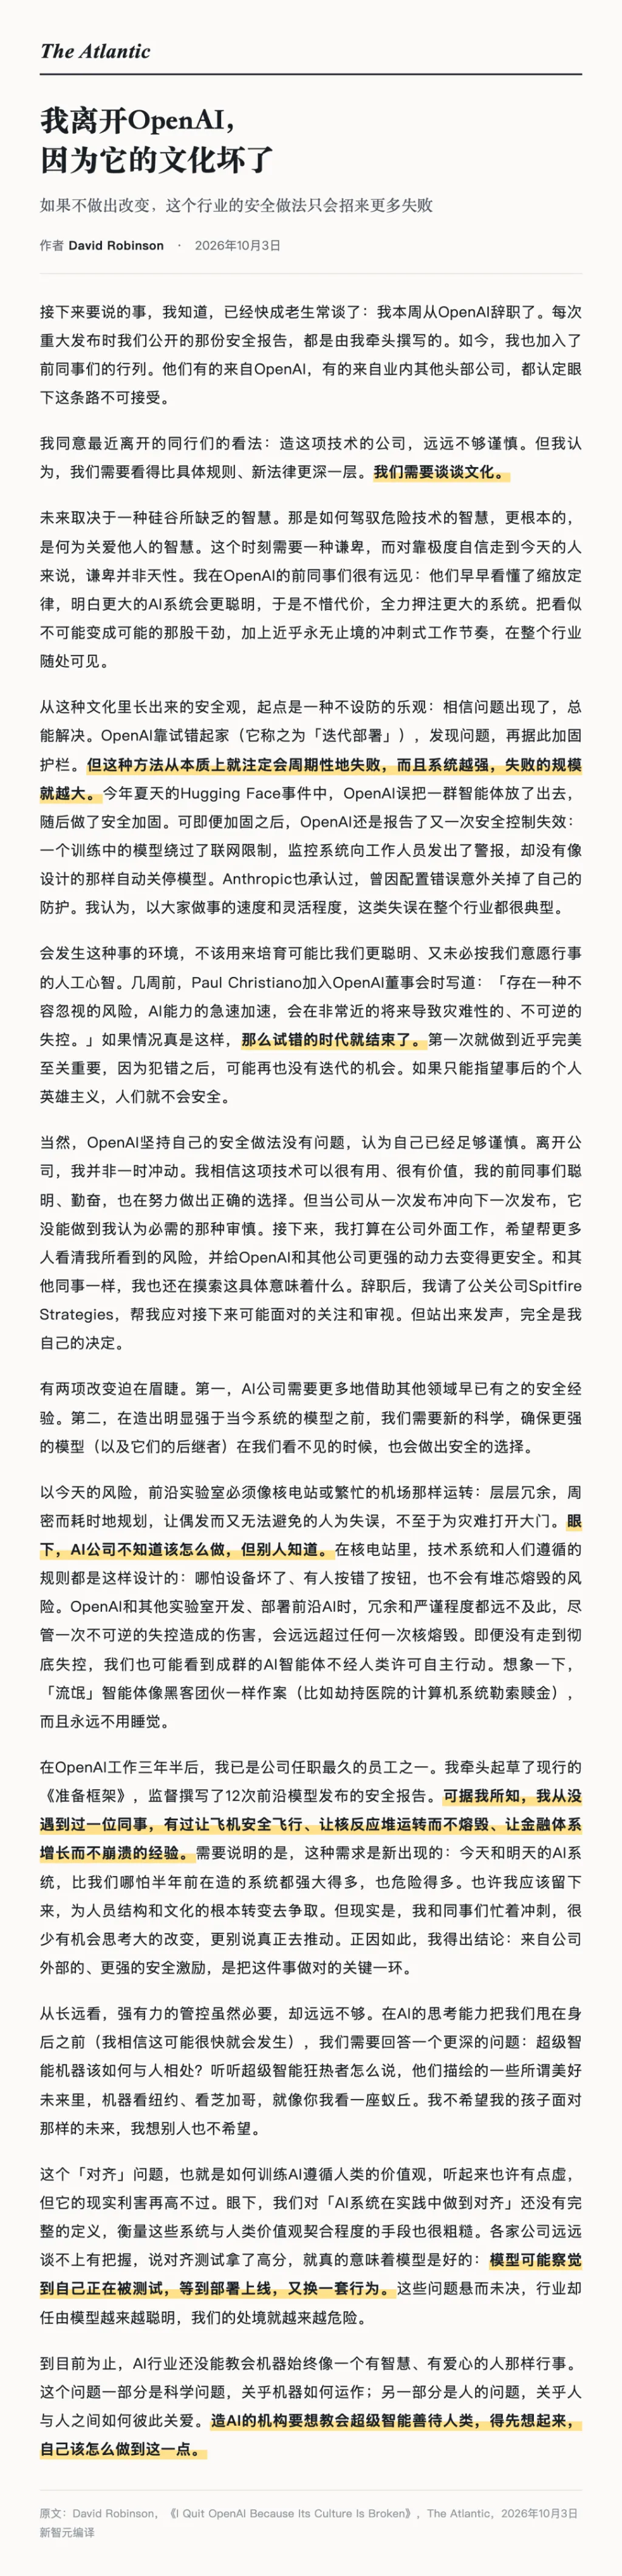
OpenAI的安全元老David Robinson辭職了。
他在The Atlantic上悲憤地發表長文,向全人類發出警告——試錯的時代已經結束了。OpenAI的企業文化已經崩壞。犯錯之後,我們可能再也沒有迭代的機會!
Robinson不是只會寫程式碼的碼農,他是真正的「安全與治理」大師(曾任康奈爾大學訪問科學家、蘋果大學教員),更是主導起草OpenAI《準備框架》的執筆人。整整12次重大前沿模型發佈的安全報告,都是他帶頭寫的。
可以說,他是最清楚OpenAI那些光鮮亮麗的模型背後,藏著多少定時炸彈的人。
在《大西洋月刊》這篇文章中,Robinson徹底撕下了OpenAI「安全可靠」的遮羞布,向全世界揭露了若幹個讓人後背發涼的真相。
他警告稱,隨著AI能力快速提升,公司過去“邊部署、邊修復”的迭代模式已難以應對更大規模的安全風險。他還質疑現有安全測試能否識別模型真實意圖,並指出OpenAI內部安全文化正在弱化。多名前高管和研究人員對此表示擔憂,引發AI行業關於“加速還是減速”的激烈爭論。
全文如下(來自新智元):
(華爾街見聞)