
蘋果最強大的Mac晶片已經上市六周,它帶來的實際改變也逐漸清晰起來。該公司於2026年8月25日發佈了M5 Ultra,這款晶片將36核CPU、80核GPU以及最高512GB的統一記憶體整合到全新升級的Mac Studio中。蘋果稱其為“有史以來最強大的晶片”,而從紙面參數來看,也確實如此。
更有趣的是,這款晶片預示著蘋果的AI戰略走向。這是Ultra級晶片首次配備專用神經網路加速器,記憶體頻寬也提升至1.2TB/s。蘋果押注Mac Studio使用者希望完全在本地運行大型語言模型,無需支付API費用,資料也不會外洩。然而,在2026年10月,這一策略與一年前相比,顯得截然不同。如今,開發者們通常會權衡託管推理的成本與一次性購買硬體並在本地運行模型的成本。
蘋果確認M5 Ultra的最終規格
蘋果公司在8月25日公佈了當前Mac Studio系列產品的規格,該系列產品將於2026年9月22日上市。頂配機型搭載36核CPU(分為12個“超級核心”和24個性能核心)、80核GPU以及32核神經網路引擎。蘋果官方技術規格頁面顯示,統一記憶體頻寬為1.2TB/s,最高配置可達512GB統一記憶體。
蘋果公司毫不含糊地表明了這款晶片的目標使用者。在其新聞稿中,蘋果表示,借助 M5 Ultra,“Mac Studio 的 CPU 最高可擴展至 36 核,GPU 最高可擴展至 80 核,並配備驚人的 512GB 統一記憶體,使使用者能夠在裝置上完全運行龐大的 LLM(邏輯邏輯模型)。” 這段直接引自蘋果官方新聞稿的文字,顯然是針對特定使用者群體:那些希望在本地而非通過託管 API 運行生成式 AI 工作負載的開發者和研究人員。
對搭載 M5 處理器的 Ultra Mac Studio 的實際評測已經證實,其在實際工作負載方面實現了顯著的代際性能提升,這與蘋果在發佈會上公佈的性能倍數相符。六周過去了,蘋果的宣傳與獨立測試結果之間的差距已基本縮小。
核心數量本身對蘋果來說就是一個全新的領域。之前的 Ultra 晶片將核心分為性能核心和能效核心兩類。而 M5 Ultra 則將 12 個超級核心和 24 個性能核心組合在一起,總共 36 個核心。蘋果目前尚未在其發佈的資料中對這種命名方式的架構細節做出完整解釋。該公司目前公佈的是性能結果:根據蘋果的公告,“搭載 M5 Ultra 的新款 Mac Studio 配備最高 36 核的 CPU,其中包括 12 個超級核心和 24 個性能核心,其多線程性能比 M3 Ultra 提升高達 1.3 倍。”
1.3倍的多線程性能提升,按晶片代際標準來看,雖然可觀但並不算顯著,這與M3 Ultra從32核增加到36核的幅度相符。但這次的重點並非CPU,而是蘋果對GPU的改進。
M5 Ultra 的故事真正精彩之處就在這裡。它的 GPU 核心數依然高達 80 個,與 M3 Ultra 的最高配置相同。核心總數沒有變化,改變的是每個核心內部的配置。蘋果官方宣稱,這款晶片“最高可達 80 個核心的 GPU,是迄今為止最強大的Apple Silicon GPU,首次將神經加速器引入 Ultra 晶片,與 M3 Ultra 相比,峰值 AI 計算性能最高可提升 4.3 倍。”
在GPU核心數量相同的情況下,AI計算能力提升4.3倍,這意味著性能提升幾乎完全來自每個核心內建的專用矩陣運算硬體,而非晶片規模的擴大。這與整個GPU行業的趨勢相符,即廠商越來越多地將張量加速器直接嵌入著色器核心,而不是依賴通用計算來處理AI工作負載。輝達仍然以絕對優勢主導著更廣泛的獨立GPU市場,最近的出貨量統計資料顯示,輝達的桌面GPU市場份額接近90%,這更加印證了這一點。但蘋果並非試圖在出貨量上與輝達競爭,而是著眼於單台機器在無需網路連線的情況下所能完成的任務。
記憶體是另一半優勢,而且對於人工智慧領域來說,它或許更為重要。M5 Ultra 支援高達 512GB 的統一記憶體,可供 CPU、GPU 和神經網路引擎共享,讀寫速度高達 1.2TB/s。蘋果Mac Studio 的規格頁面也證實了這兩個數字是頂級配置的上限。
在本地運行大型語言模型意味著要將所有參數以及活動上下文窗口都放入可定址記憶體中。僅一個以 16 位精度記憶體的 700 億參數模型就需要超過 100GB 的空間,這還不包括上下文和開銷。512GB 的記憶體池足以讓一台 Mac Studio 同時運行多個大型模型,或者運行一個具有超長上下文窗口的模型,而無需交換到磁碟。這正是蘋果反覆強調“完全在裝置上運行大型語言模型”而不是首先討論遊戲或視訊渲染的實際原因。
目前,這些記憶體價格都不便宜。整個行業的記憶體價格已經連續數月上漲,最近的一份報告顯示,由於供應持續緊張,記憶體甚至佔到某些裝置物料清單的 60%。512GB 的記憶體配置遠高於大多數消費級電腦的標配,這使得蘋果的高端 Mac Studio 系列產品進入了一個不僅取決於晶片性能,也取決於記憶體價格的細分市場。
蘋果的 Ultra 系列發展歷史較短,且略顯不均衡。該公司完全跳過了“M4 Ultra”,直接從 M3 Ultra 跳到了 M5 Ultra。與前三代產品相比,這一代產品的變化情況如下:
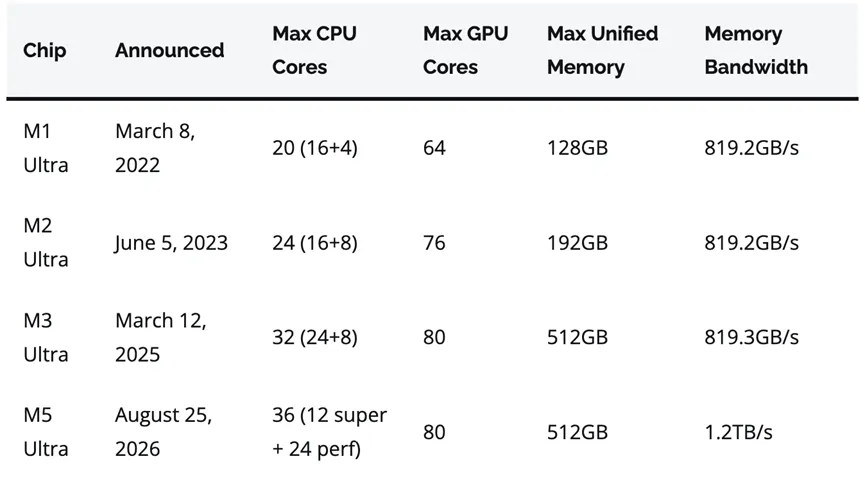
有兩點尤為突出。首先,自 M3 Ultra 以來,GPU 核心數量一直穩定在 80 個,這意味著 M5 Ultra 的 AI 計算能力提升源於架構改進,而非單純的擴展。其次,記憶體頻寬從連續三代保持不變的約 819GB/s 躍升至 1.2TB/s。這是表格中最大的架構變化,也是任何需要將大型模型載入到記憶體中的使用者最為關注的指標。
蘋果並沒有將M5 Ultra定位為與輝達工作站和資料中心顯示卡直接競爭的GPU產品,而且它也不應該這樣做。桌面GPU市場依然處於一邊倒的局面:根據上文引用的出貨量資料,輝達佔據了近90%的市場份額,而且僅其股票回購計畫近期就超過了蘋果的回購支出,這表明人工智慧晶片的繁榮為輝達帶來了巨額現金流。消費級GPU的價格也變得異常高昂,像RTX 5090這樣的旗艦顯示卡在美國零售市場已經售罄,在供應緊張的情況下,轉售價格接近9500美元。
蘋果的策略有所不同:只需一次購買,一個電源插座,以及一個足以容納原本需要多個獨立GPU連接才能運行的模型的統一記憶體池。這比“GPU性能最大”的策略更窄,但對於那些不想管理GPU叢集的團隊來說,這確實是一個切實可行的方案。今年早些時候,蘋果在人工智慧領域一個重要的市場里程碑上也曾短暫超越輝達,但這種領先優勢僅僅維持了兩個月就被逆轉。這再次提醒我們,人工智慧硬體競賽的贏家是那些能夠最快推出下一代產品的人,而不是那些上個季度領先的人。
統一記憶體的製造成本並不低,而且整個行業都在上漲,不僅僅是蘋果公司。另一份報告指出,DRAM 的成本現在比台積電最先進的 2nm 邏輯晶片高出 54%,這與記憶體和計算定價之間的通常關係截然相反。當機器內部的記憶體晶片每平方毫米的成本高於處理器本身時,高記憶體配置就不再是小幅的附加功能,而是成為機器價格的主要驅動因素。
這種動態讓蘋果公司陷入了不尋常的境地。統一記憶體是M5 Ultra晶片的核心賣點,因為該晶片在人工智慧領域的價值主張取決於能否將龐大的模型整合到單個記憶體池中。但如果DRAM供應持續緊張到2027年,512GB配置可能會成為最難保證庫存的版本,而不是最容易溢價銷售的版本。
這裡更廣泛的背景是三年前幾乎不存在的一種硬體類別:專為運行無需雲連接的前沿規模人工智慧模型而設計的桌上型電腦。雲GPU租賃在訓練的原始吞吐量方面仍然具有優勢,但在推理方面,尤其對於運行精細化模型的小型團隊而言,直接擁有硬體在經濟效益上越來越有利。一台配備512GB統一記憶體的Mac Studio可以省去一整類決策,例如如何將模型分片到多張顯示卡上,而云GPU使用者必須不斷地做出這些決策。
蘋果並非唯一一家爭奪這一市場的公司,而且它的產品也並非在所有情況下都是最便宜的。但它擁有大多數基於PC的競爭對手所不具備的優勢:一種無需切換架構即可從筆記型電腦擴展到工作站的單晶片設計。這種一致性對於那些希望本地測試環境與生產環境高度相似的開發者來說至關重要。 (半導體行業觀察)