
算力進入“資產時代”:它有了估值公式,有了殘值曲線,也開始有了自己的融資管道。
建一座AI工廠,按輝達官方口徑,每兆瓦約6000萬美元,吉瓦級項目就是約600億美元的資本開支,如同修一座大型電站。當地時間上周四,輝達在部落格裡給出這類“大型電站”的回報公式:產出、壽命、需求。
當前市場上多數玩家,還在按“買IT裝置”的老辦法來計算AI工廠的資產價值:三五年計提折舊,到期減值,殘值按零處理。至於這座“工廠”一年能產出多少、裝置能運轉多少年、產出能不能賣掉,這些真正決定回報的問題,在採購環節很少有人提及。
輝達想把這套新的AI工廠資產計算公式推給整個市場。今年8月,它與Apollo、貝萊德、黑石、博楓、高盛、KKR六家機構宣佈共建融資平台(目前僅為合作備忘錄,尚無交易簽約),計畫撬動超過5000億美元的第三方資本投入AI基礎設施,算力第一次被信貸市場按基礎設施而非裝置定價。
而這其中,空頭的讀法正相反,Michael Burry認為前沿晶片的實際壽命只有兩三年,折舊拉長掩蓋的是透支的需求。
01. 電站的估值公式
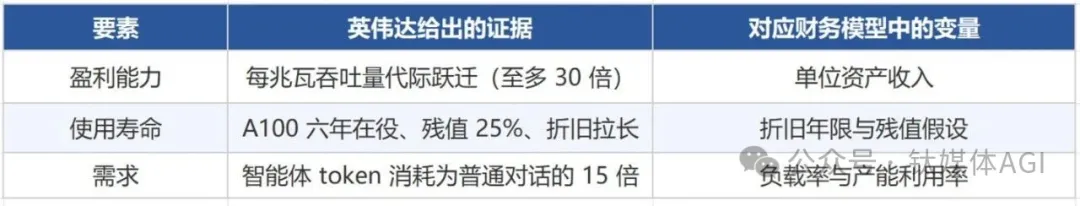
輝達把AI工廠的回報歸結為三個變數:盈利能力(滿負荷運轉一年能賣出多少token)、使用壽命(硬體保持產出的年限)、需求(這些token究竟能賣出多少)。熟悉基礎設施投資的人對這套語言並不陌生。電站、油田、船舶的估值,用的正是同一個公式:單位產出、資產壽命、負載率。
三個變數相互牽制,無法互補。按博文的說法,盈利能力再強,若只能賣出一半產能,也無濟於事;需求再旺,若裝置一年後就跑不滿,同樣無效。投資一座AI工廠,等於對三個變數同時下注,押錯任何一個,另外兩個做得再好也無法彌補。
三個變數裡,先看產出。
評估電站,行業看度電成本;評估AI工廠,對應指標是每秒每兆瓦token數。電力是建廠繞不開的硬約束,能耗指標、變壓器容量、並網排隊,在每個市場都是最稀缺的許可。在固定的電力包絡裡,產出的token越多,單位電力的收入就越高。
兩代裝置之間的產出差距,已經不是百分比能形容的。據SemiAnalysis AgentX基準(回放真實智能體編碼會話測算),在DeepSeek V4-Pro負載、每使用者每秒160 token的條件下,Vera Rubin NVL72每兆瓦吞吐量較上一代GB300 NVL72高逾30倍,每百萬token成本至多低45倍;GB300較H200機群每百萬token成本又至多低10倍。廠房和電力指標不變,吞吐量在代際之間相差兩個數量級。
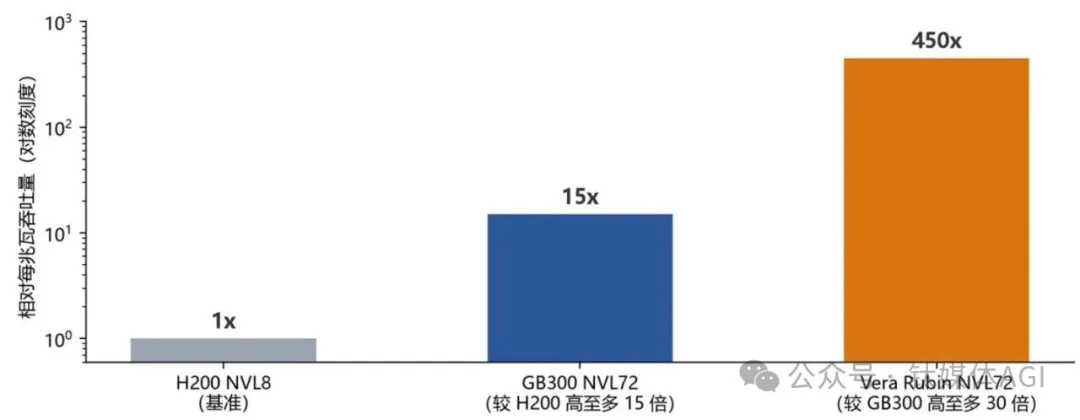
每兆瓦吞吐量代際對比(對數刻度)。口徑:SemiAnalysis AgentX,DeepSeek V4-Pro 智能體編碼負載,特定條件下的至多值
這些增益並非主要來自製程的線性進步,而是更多來自從模型、編譯器、推理框架到計算、網路、記憶體的全端協同設計:MoE服務執行階段、低精度數值格式、KV快取復用、預填充與解碼分離調度,每一層都在為“每兆瓦token數”服務。晶片可以對標,全端難以複製。
效率提升自然會引出一個擔憂,token越來越便宜,需求會不會被自己消減掉?
市場資料恰恰相反,據OpenRouter統計,單個智能體請求消耗的token是普通聊天的15倍,平均提示token已增長約四倍。一個做投資研究的智能體,會查資料庫、讀財報、呼叫子智能體做橫向比較,再綜合成結論:token的消耗隨任務複雜度增長,而不再隨對話輪數封頂。
降價釋放的空間,正被智能體的消耗重新填滿。這是傑文斯悖論在算力市場的又一次應驗。
02. 使用壽命:會計與市場的分歧
效率回答“每一兆瓦能賺多少”,資產的另一半答案是“能賺多少年”。使用壽命是三個變數裡口徑最分裂的一個:在資產負債表上,它由會計政策決定;在現實中,它由物理衰減和市場需求共同書寫。兩套口徑的差距,正越拉越大。
以A100為例,A100發佈於2020年,六年後仍在商業服役;CoreWeave把2020年批次的機器一直預訂到2029年,一台2020年的晶片,收入周期接近九年。多年期合同,是營運商為“舊機器還能持續產出”付出的實際代價。
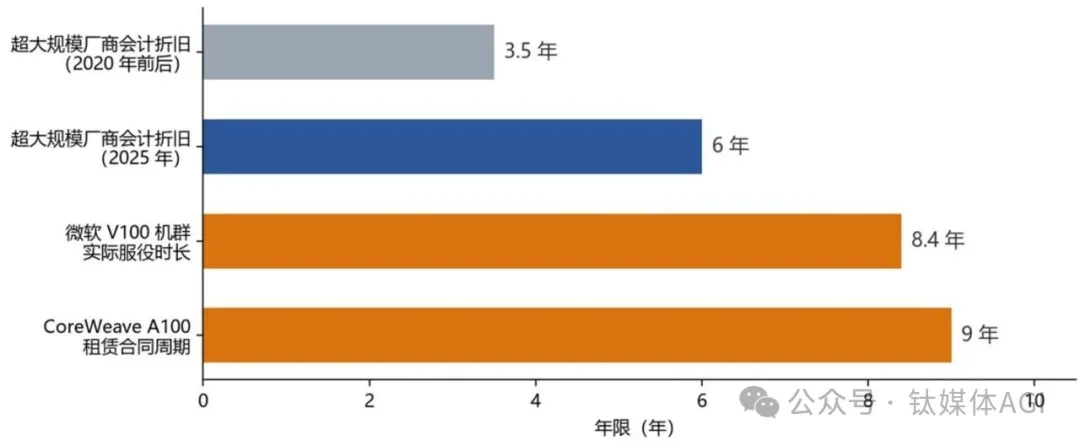
個案之外,行業整體的會計政策也在調整。據Sprout 2026年9月報告,超大規模營運商已將伺服器會計折舊從三四年普遍拉長到六年;據Introl等第三方彙總,這一調整合計每年減少折舊約180億美元,相當於給全行業多出同等規模的帳面利潤。微軟在2022年把伺服器折舊年限從四年延長到六年,估計使其2023財年營業利潤增加約37億美元;微軟的V100機群帳面六年,實際跑了8.4年。
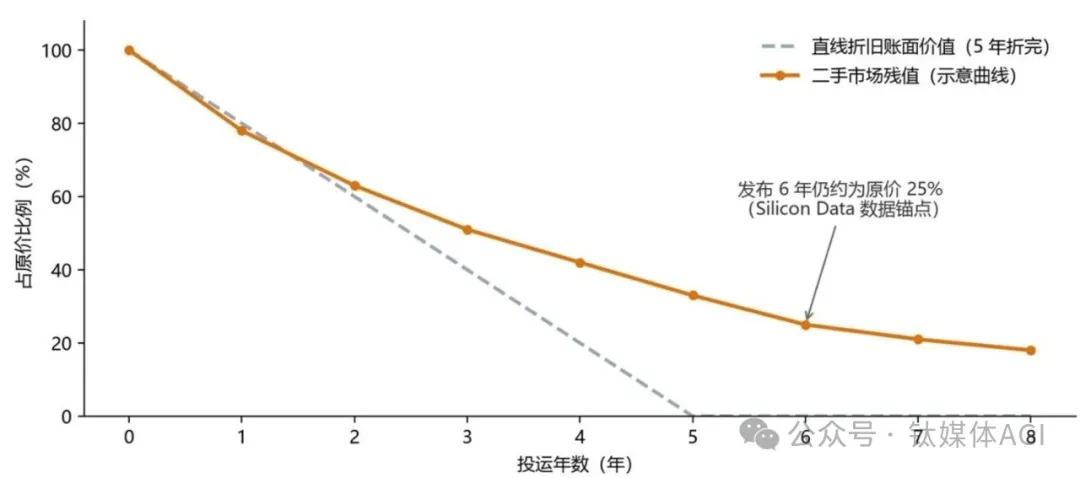
市場的定價提供了另一重參照。Silicon Data的資料顯示,發佈六年的A100在二手市場仍能賣到原價的四分之一;Ornn Data的租賃指數顯示,它的五年期長租價格約為一個月租約的八成。一座按五年折舊就該“一文不值”的資產,市場上仍有人願意出價。
03. 通用性,和一個未曾言明的賭注
資產壽命的長短,一個關鍵變數是它能處理的負載有多少種。為單一負載定製的算力,賭的是需求永不遷移:演算法一次換代,專用資產可能整體報廢;通用平檯面對需求波動,只需把算力轉去處理其他負載。
專用算力並不罕見,比特幣礦機就是一例。晶片為一種雜湊演算法定製,演算法之外沒有用途,行情回落時只能按廢金屬價格處置。同期的以太坊礦工用的是通用GPU,2022年以太坊轉向權益證明機制後,這批卡大量轉入遊戲和推理市場,殘值遠高於礦機。輝達的GPU屬於後一類,它的通用性來自架構和生態兩層。
架構層面,語言、視覺、生物、模擬、圖形,這些負載的底層都是大規模平行計算,本就在GPU的能力範圍之內;在可程式設計架構內嵌入Transformer引擎等專用單元,又兼顧了運行效率。生態層面,1000多個CUDA-X庫和約1000萬開發者,讓新負載出現時有現成的軟體棧可用,不必從零適配。
Pinterest在14000塊GPU上跨Blackwell、Hopper及更早架構混合調度訓練與推理,新任務持續落在舊架構上;德州農工大學超算跨26個項目、7家機構,利用率維持在95%—98%;禮來在自己的千卡級本地叢集上,同時承載製藥模型與內部智能體。
通用性由此轉化為資產壽命。但這一切成立的前提,是過去兩年算力始終稀缺。
堅挺的殘值、滿負荷的利用率,究竟是資產本身優秀,還是僅僅因為供不應求?空頭Michael Burry去年11月估算,超大規模廠商2026—2028年的折舊被低估約1760億美元(個人估算,未經證實),前提是前沿GPU的實際經濟壽命只有兩三年。
他引用的事實與輝達並無二致,結論卻截然相反。在他看來,折舊拉長掩蓋的是透支的需求。輝達隨後向分析師發出長篇備忘錄反駁,稱客戶實際按四到六年折舊,A100至今仍在高負荷運轉。亞馬遜在2025年初把部分伺服器折舊年限從六年縮回五年,理由是AI硬體迭代加速,按其2025年報口徑,全年多提折舊約14億美元。
輝達與空頭用的是同一套資料,究竟那種更接近真相,要看未來兩年供給與需求的賽跑。倘若新一代供給放量、需求增速放緩,二手價格和長租折價會最先轉向。
無論輝達的敘事成色幾何,這套估值框架本身值得被認真對待,尤其對正在大規模建設智算中心的中國市場而言,三要素恰好對應三個懸而未決的問題。
最直接的問題留給雲廠商與智算中心:折舊年限定在那。從國內營運商年報的折舊政策看,多按四五年計提。若資產實際壽命八年以上,當期利潤就被系統性低估,項目回報被看錯;若需求根本撐不滿裝置的一生,問題就不在會計,而在經營。要回答這個問題,得翻各家財報的折舊政策和利用率資料:是會計口徑的問題,還是經營的問題,修正方向截然相反。
折舊之外,投資者還需要注意營運商調整折舊年限的公告(管理層對資產壽命的真實判斷往往先出現在這裡)、二手GPU交易與長租價格(殘值的獨立參照)、新代際發佈後舊型號的租金變化(需求端的讀數)。不過國內市場目前還缺少公開、連續的二手算力價格資料,這些訊號大多隻能從營運商公告和海外資料商處間接獲得。
產業政策層面,算力重資產化之後,土地、電力指標、能耗審批已經成為實際的市場准入門檻。評價一座智算中心,標準應該從裝機規模換成“每兆瓦產出”:前者衡量資產質量,後者只統計數量。
高效、耐用、通用。輝達用三個詞宣告算力進入“資產時代”:它有了估值公式,有了殘值曲線,也開始有了自己的融資管道。這套敘事能否立住,要看未來兩年供給與需求的賽跑。10月21日,黃仁勳將在GTC柏林發表主題演講,Vera Rubin的量產節奏與AI工廠參考設計,會給出這場賽跑的下一組資料。 (鈦媒體AGI)