
很少有 AI 廠商篤信發佈的產品能夠「以數量換質量」,OpenAI 偏偏是其中之一。
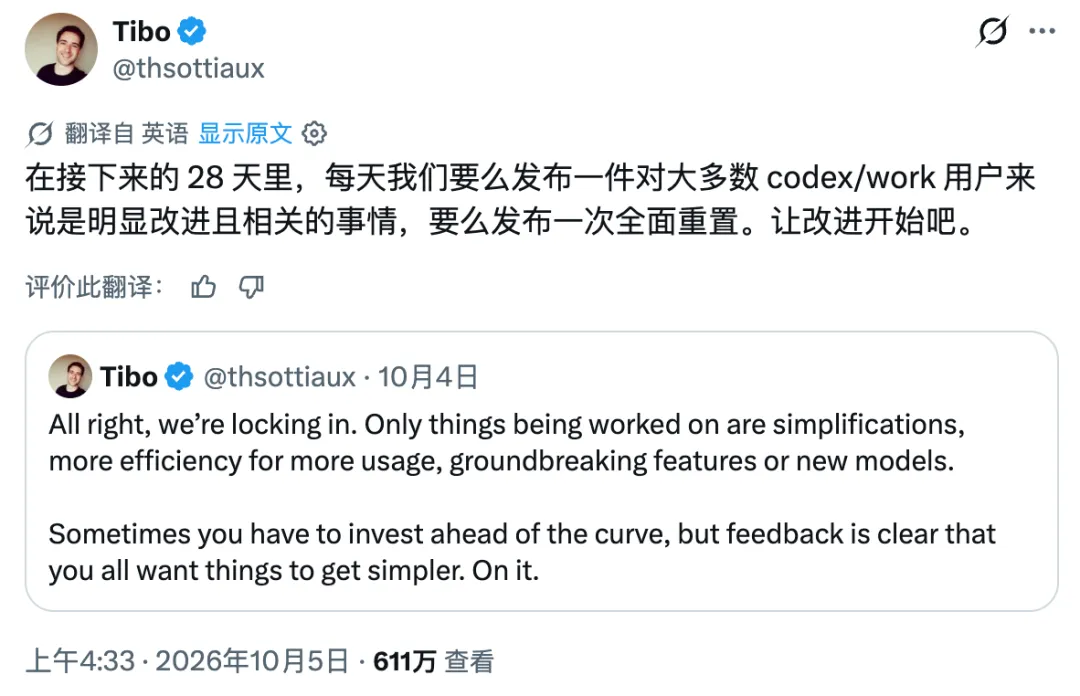
一如之前連開 12 天發佈會的豪舉,昨天,OpenAI Codex 負責人 Thibault Sottiaux(也就是大家熟悉的 Tibo)宣佈了一項持續 28 天的承諾:
接下來的每一天,團隊要麼發佈一項對大多數 Codex 或 ChatGPT Work 使用者有明顯價值的更新,要麼執行一次完整額度重設。
活動來到 Day 1,OpenAI 交出的答卷是提速。通過訂閱使用 GPT-6 Astra 和 GPT-6.1 Sol,默認速度將提高約 50%,使用者無需調整設定。
同一天,OpenAI 還公佈了兩項方向完全不同的變化。ChatGPT 和 Codex 的部分文字輸出將開始加入不可見水印,ChatGPT 的廣告業務則準備引入更直觀的圖片展示形式。
放在一起看,幾項更新很能說明 OpenAI 目前的處境。它需要讓付費使用者覺得訂閱更值,也需要向監管解釋 AI 內容從那裡來,同時還得讓越來越大的使用者規模,成為廣告主願意買單的生意。
模型之外,AI 平台要面對的日常事務,正在越來越接近我們熟悉的網際網路。
每天都要更新,使用者期待一份可用的改進
Tibo 的承諾有一個值得留意的限定,每天發佈的改進,需要與大多數 Codex 或 Work 使用者相關,而且效果足夠明顯。
換句話說,一項藏在角落裡的小功能,很難滿足使用者對這份承諾的期待。對於每天使用 AI 工作的人,等待時間、操作是否方便、額度夠不夠用,都會直接影響他們願不願意繼續付費。
Day 1 的提速,正好回應了這種需求。
按照 Tibo 的說明,GPT-6 Astra 和 GPT-6.1 Sol 的默認速度最佳化覆蓋 OpenAI 的訂閱產品,也覆蓋支援 Sign in with ChatGPT 的合作夥伴,包括 OpenCode、Pi、Amp 和 Devin。
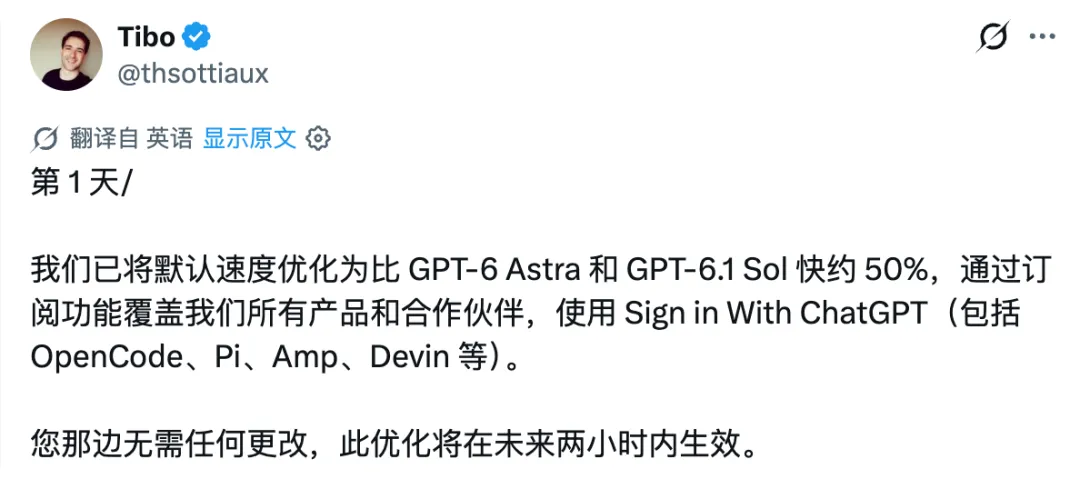
使用者通過 ChatGPT 帳號在這些工具裡使用訂閱能力,也在此次調整的範圍內。他表示,變化會在公告發佈後的兩小時內逐漸被使用者感受到。
隨後,Tibo 又給出了一個更具體的數字,生成速度從每秒 30 token 提升到每秒 50 token。
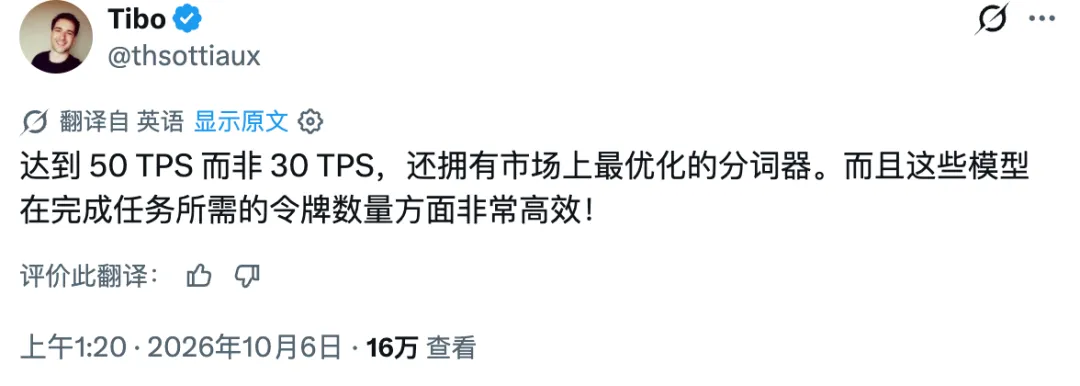
對於需要連續與模型互動的工作,提速仍然有實際意義。寫程式碼需要反覆讀取檔案、修改、測試和糾錯,整理資料也可能經過多次搜尋與生成,單次等待縮短後,累積下來的體驗差異會更明顯。
不過,比起提速,或許重設額度來的更實在些,我們也期待這 28 天能看到多幾次。
給文字留下水印,也要承認水印的侷限
提速讓使用者更容易使用 AI,文字水印則回應了另一個問題。當生成內容進入郵件、文章、報告和公共討論,外界還能不能識別它與 AI 的關係?
同樣是今天,OpenAI 公佈了應對歐盟文字來源規則的方案。按照其公告,歐盟《AI Act》要求生成式 AI 提供商,讓生成文字能夠以機器可讀的方式被識別。
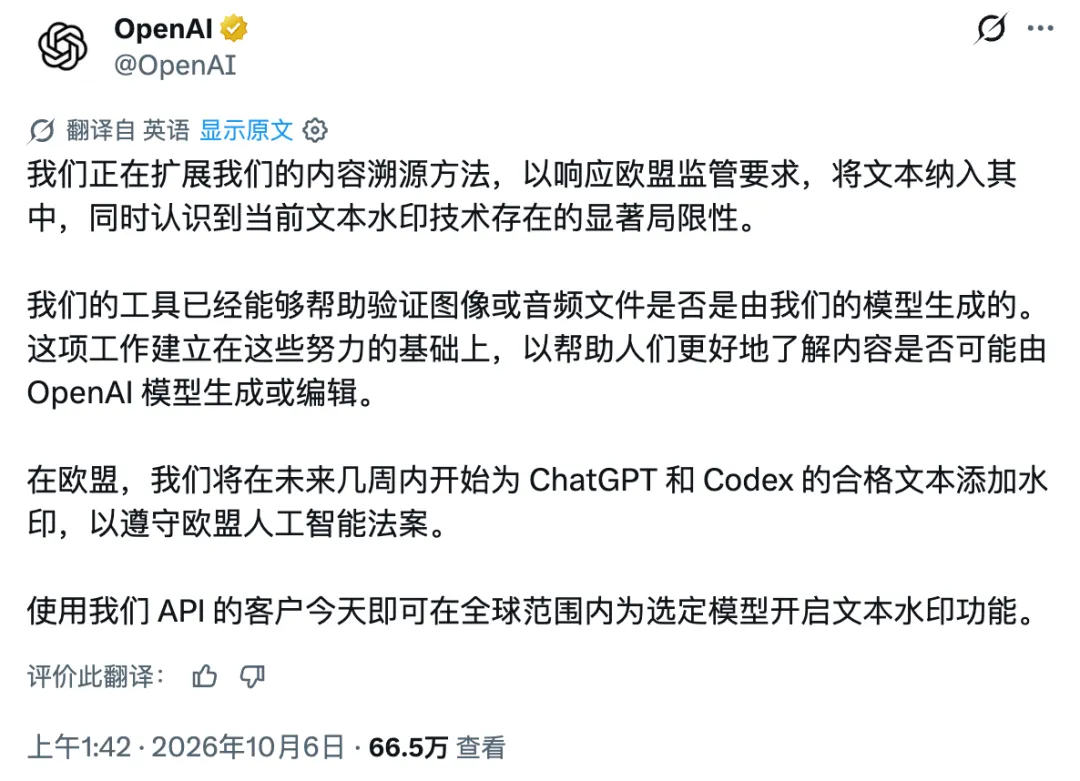
全球 API 客戶從當天起,可以為部分模型主動開啟文字水印,默認狀態仍然關閉。
未來幾周,OpenAI 會在歐盟範圍內,為符合條件的 ChatGPT 和 Codex 文字輸出加入不可見水印,覆蓋各類套餐,但首發階段不會將它設為全球默認功能。
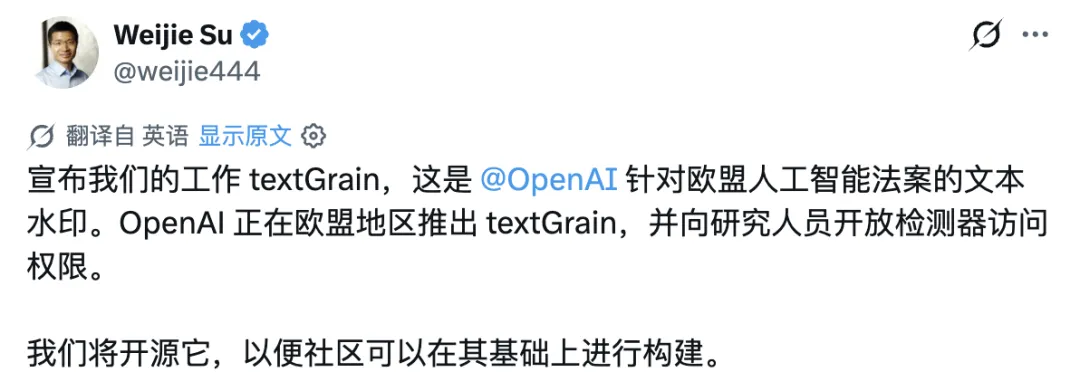
OpenAI 將這項技術稱為 textGrain。它會在模型選擇詞語時加入不可見的統計訊號,檢測工具再尋找這些訊號,判斷一段文字是否含有 OpenAI 水印。OpenAI 還計畫將技術開源。
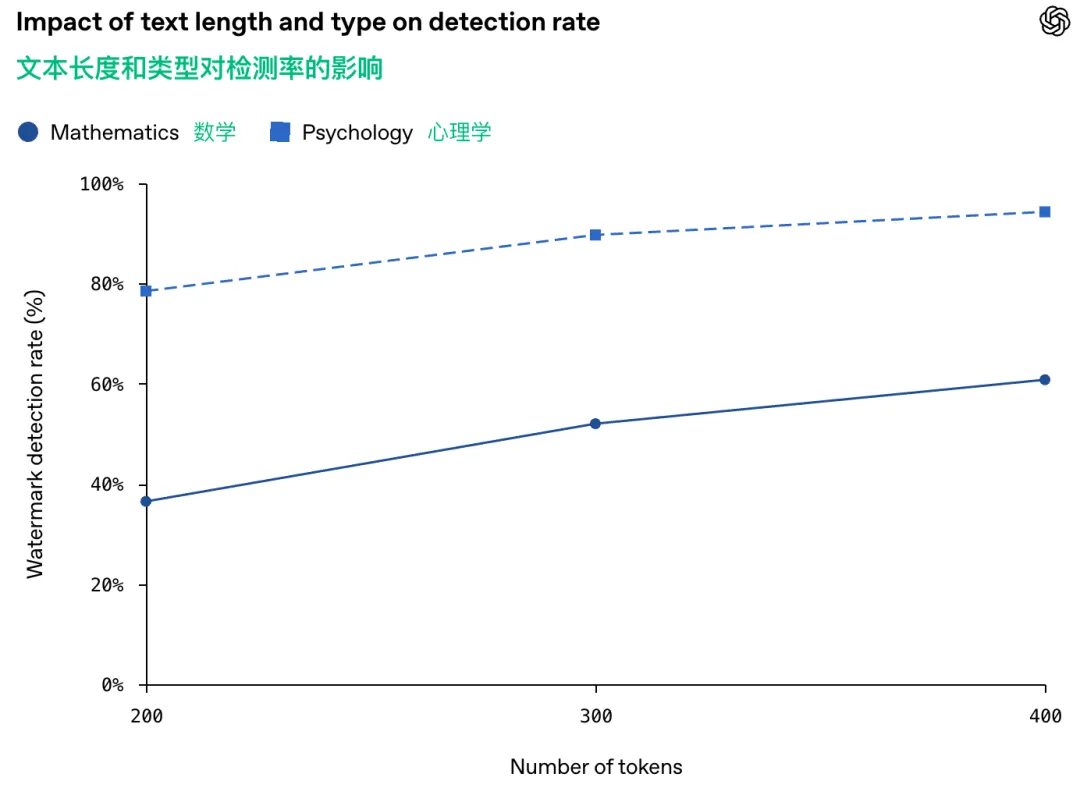
難點在於,文字太容易被改動,而可供模型選擇的表達方式,也因內容而異。
在目標誤報率為 1% 的測試條件下,對於心理學等內容,檢測工具能識別約 80% 的 200-token 水印文字,長度增加到 400 token 時,識別率約為 95%。數學內容的表達空間更小,檢測表現明顯更低。
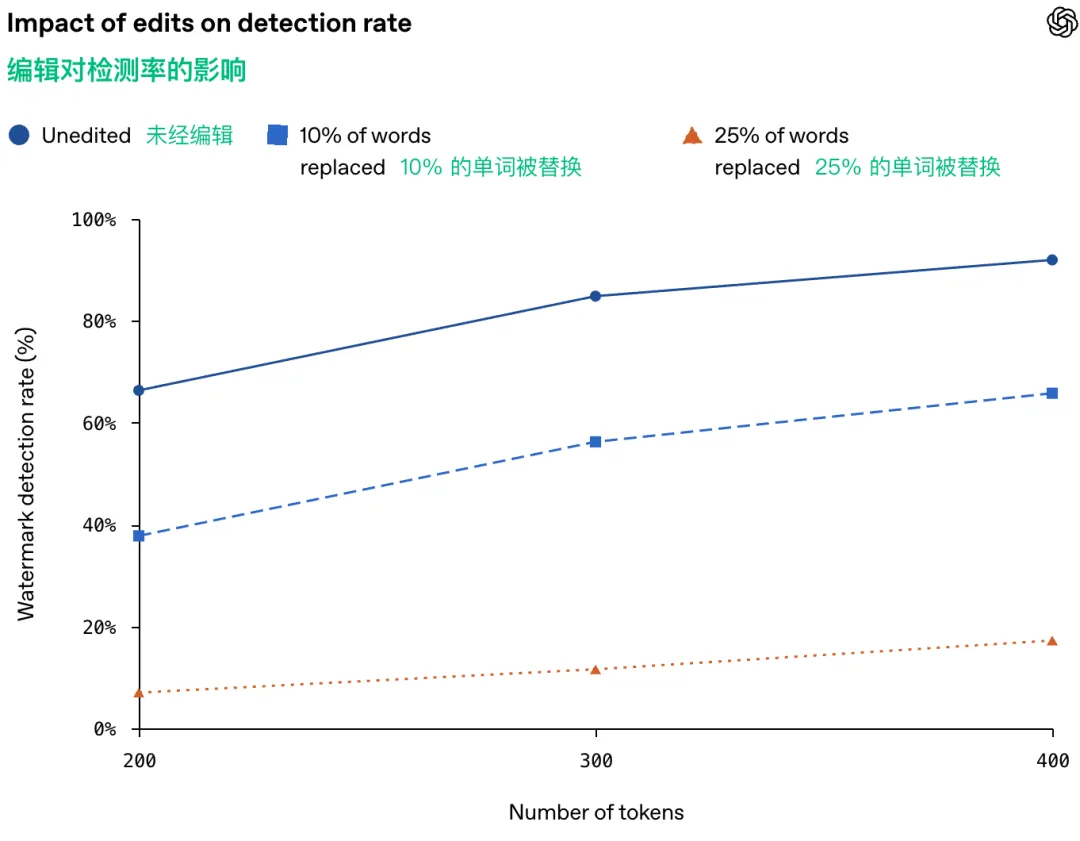
編輯也會削弱訊號。在另一組 400-token 文字測試中,將 10% 的詞語取代為同義詞,檢測率會從約 92% 降至 66%;替換比例達到 25% 後,檢測率只剩 17%。
幾組數字說明,文字水印能提供線索,但距離可靠判斷一篇文章的創作過程,還有相當大的距離。OpenAI 也表示,在其用於評估 Astra 的基準測試中,沒有觀察到加入水印前後存在有意義的性能差異,不過這些測試仍然不能覆蓋所有實際寫作場景。
更關鍵的邊界,是水印無法衡量人類貢獻。
一個人自己完成文章,再讓 AI 調整表達,和讓 AI 生成全文,都可能涉及模型對文字的處理。檢測到水印,無法說明作者投入了多少判斷、編輯與創意,也不能據此判定版權、責任或內容真假。
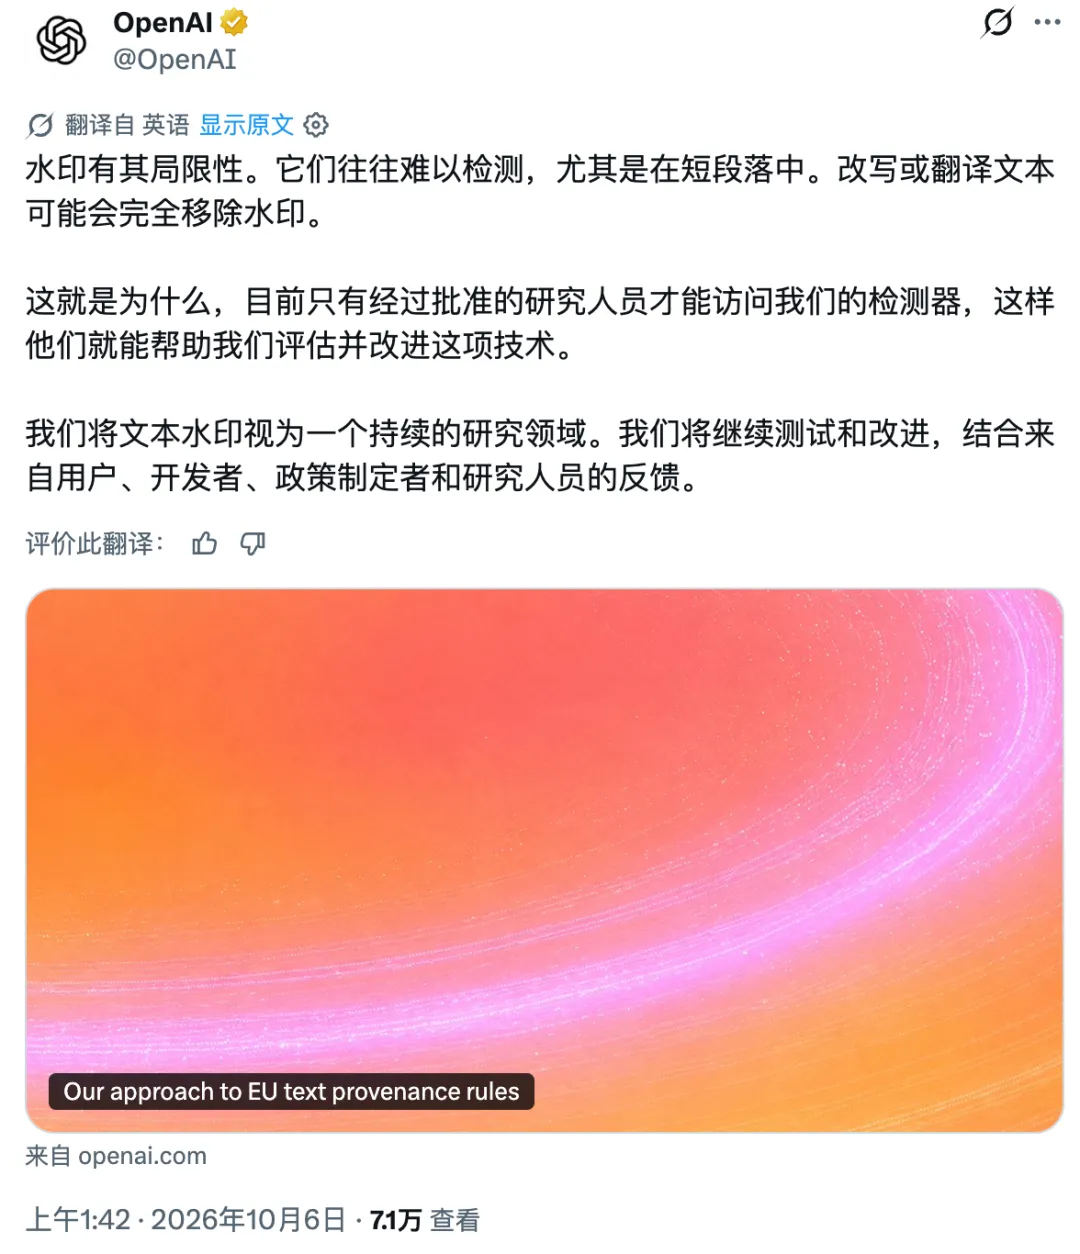
水印同樣不會關聯具體使用者、帳號、提示詞或對話。反過來,沒有檢測到水印,也無法證明文字由人類獨立完成,文字過短、經過編輯或翻譯、來自不支援水印的模型,都可能讓訊號無法被識別。
由於誤報和漏報仍然存在,OpenAI 暫時只向獲批的研究人員和專業機構開放檢測工具的申請,沒有在上線時向公眾全面開放。
當 ChatGPT 每周觸達 12 億人,廣告開始長出熟悉的樣子
比起水印,視覺廣告更容易讓普通使用者感受到產品的變化。
OpenAI 在同日公告中稱,ChatGPT 每周觸達 12 億人。對於這樣規模的平台,訂閱之外的商業收入,已經成為產品發展的一部分。
此次公佈的新廣告形式,將通過圖片展示產品靈感、使用方式或相關體驗。首批測試計畫在本月晚些時候於美國啟動,與一組初始廣告主合作,展示場景選在 ChatGPT 生成圖片的過程中。
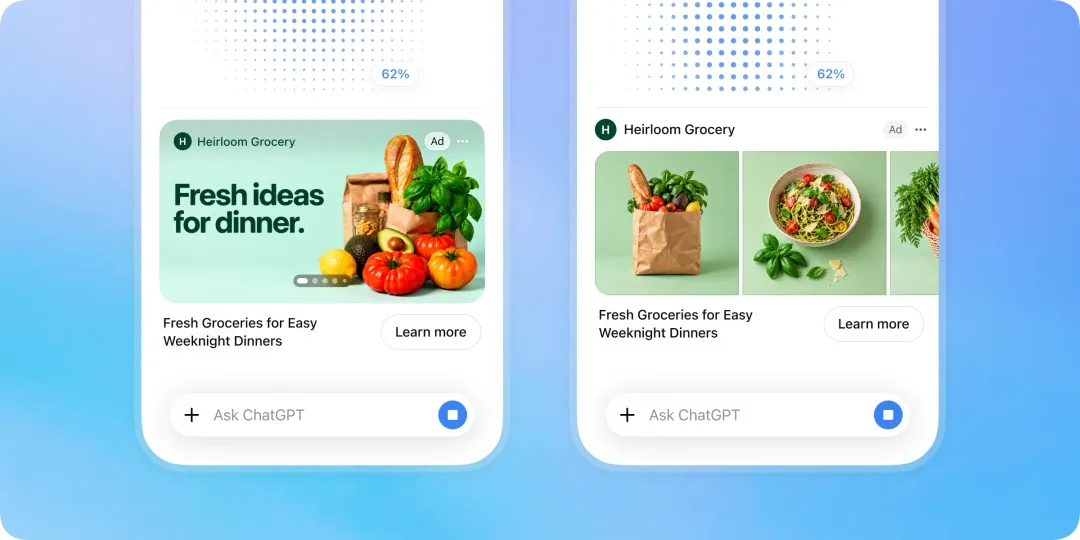
按照 OpenAI 的說明,廣告會被明確標註,並與正在生成的圖片保持分離,廣告也不會影響 ChatGPT 提供的回答。
選擇圖片生成作為測試場景,有它的商業邏輯。
使用者在構思房間佈置、活動方案或生活方式時,圖片能讓商品的使用場景變得更直觀,也更容易讓品牌進入使用者的考慮範圍。當然,是否能帶來足夠好的體驗,還要等測試給出答案。
OpenAI 同時擴充了廣告效果衡量工具,與 Hightouch、Tealium、LiveRamp 等平台合作,方便廣告主將已有系統中的轉化資料傳回 ChatGPT Ads,並引入更多歸因和效果評估夥伴。
對廣告主而言,真正需要回答的問題是,使用者看過廣告之後,是否產生了購買,以及這些購買有多少原本就會發生。
OpenAI 公佈了幾組合作夥伴提供的早期結果。
DV Rockerbox 稱,WeightWatchers 在 ChatGPT Ads 上的歸因獲客成本,比其綜合付費搜尋基準低 15.3%;WorkMagic 稱,健康品牌 Dose 的增量購買中,67% 來自全新客戶;Triple Whale 則稱,Portland Leather 從 ChatGPT Ads 獲得的訪問者中,93% 是新訪客。
此外,廣告展示的位置,也需要新的規則。OpenAI 表示,會評估對話是否適合展示廣告,避免在情緒脆弱、敏感或其他不適宜的語境中投放,並與 DoubleVerify、Integral Ad Science 探索品牌適配評估。
按照公告,這些合作方將在受控測試環境中評估相關保護機制,不會訪問真實使用者的私人對話。
傳統網站的廣告通常圍繞頁面內容,ChatGPT 的廣告則出現在一段持續變化的對話旁邊。平台越能理解使用者當前想做什麼,商業機會就越具體;同樣,使用者也會更在意,自己得到的建議究竟受到什麼影響。
OpenAI 承諾廣告不影響回答,未來我們也將拭目以待。
28 天更新承諾才剛開始,接下來每天會交出什麼,仍然值得關注。不過,首日的幾項變化已經讓競爭的範圍更清楚了,OpenAI 同時要經營付費使用者的效率、生成內容的透明度,以及廣告主的商業回報。 (APPSO)