
半導體行業正經歷一場重大的架構轉型,在3納米及以下先進邏輯節點中,環柵(GAA)納米片電晶體正在取代FinFET。GAA納米片電晶體技術可擴展至A10邏輯層,並支援5.5軌(T:Track)標準單元——軌數(T)是標準單元高度的計量單位。
在人工智慧革命的推動下,應用需求日益多樣化,A7節點的可選方案也日趨豐富。根據imec最新的路線圖,一種方案是圍繞imec的CMOS 2.0微縮範式設計系統。CMOS 2.0將片上系統(SoC)劃分為異構功能層,每個層都採用最合適的技術進行最佳化,並通過3D互連技術重新連接。對於其他應用場景,GAA納米片技術可以達到其微縮極限,電源可以從正面或背面傳輸。此外,業界也可以過渡到互補型場效應電晶體(CFET)器件架構。通過將p型和n型MOS電晶體堆疊在一起,標準單元可以進一步縮小到3T,從而將傳統的CMOS邏輯路線圖至少擴展到A3技術節點。
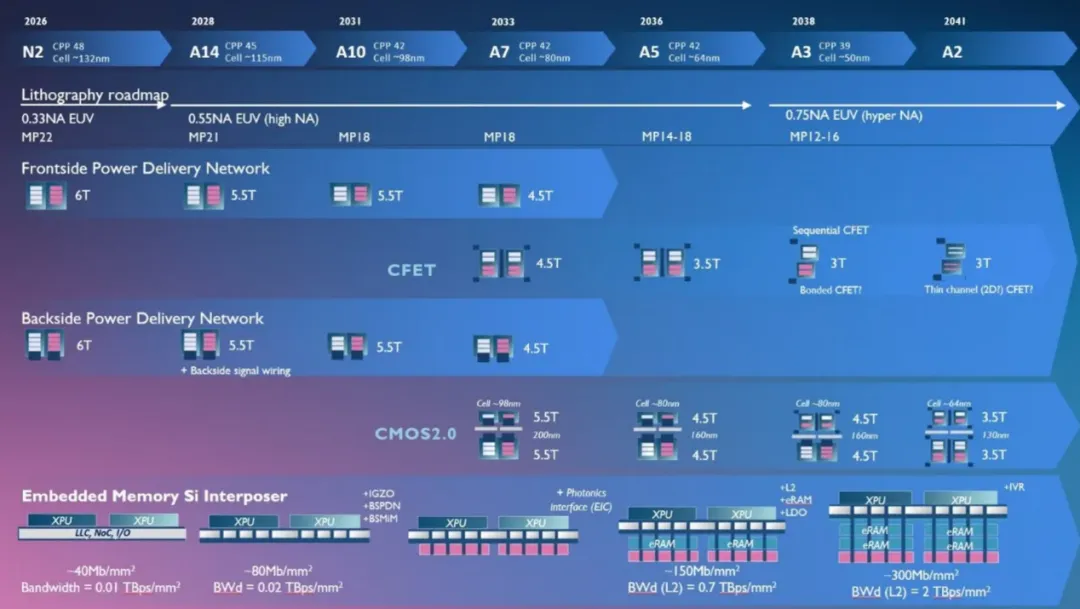
Imec及其工業合作夥伴正致力於使基於CFET的器件可製造。近年來,他們為關鍵的整合方法奠定了基礎,這些方法分為單片CFET(mCFET)和順序CFET(sCFET)。
兩種方法都從垂直堆疊Si/SiGe層開始,並由此製造n型和p型場效應電晶體(FET)。對於mCFET,具有共用上下柵極的垂直器件結構在一系列工藝步驟中完成圖案化和加工。高深寬比器件結構周圍和之間的材料的圖案化、沉積和選擇性去除,在模組開發方面需要投入大量精力。相比之下,sCFET使用專用掩模獨立地對上下器件進行圖案化。與mCFET相比,sCFET的各個工藝步驟更簡單,但一些關鍵步驟需要執行兩次——分別針對頂部和底部器件。此外,sCFET還涉及兩次晶圓翻轉,這會造成晶圓變形,並對前後器件連接的精確對準提出挑戰。在對準精度方面取得進一步進展之前,mCFET被認為是實現工業化應用的最快途徑。
CFET整合技術的進步輔之以設計技術協同最佳化(DTCO)研究,該研究從電路級角度審視CFET器件架構。這些研究旨在確定可擴展的標準單元組態和性能提升方案,以在功耗、性能、面積和成本之間實現最佳平衡。
在這篇分為兩部分的文章中,我們報告了 CFET 器件整合方面的主要進展,並利用 DTCO 研究討論了 CFET 的可擴展性。
在第 1 部分中,介紹了兩個對 mCFET 和 sCFET 器件都至關重要的工藝模組:(1)背面接觸模組,以及(2)柵堆疊整合方法,該方法可在納米片和 CFET 器件中實現多個閾值電壓 (V t )。
在第二部分中,我們將介紹一種可擴展的sCFET架構,該架構支援分柵和共柵兩種組態。除了推進邏輯路線圖之外,DTCO的工作還展示了這種分柵架構如何促進基於CFET的SRAM的微縮。最後,我們展示了改進的後端布線(BEOL)能力,從而支援CFET標準單元的微縮。
報告的成果是在imec主辦的歐洲NanoIC試點生產線的框架下取得的,該生產線旨在開發2nm以下的片上系統。CFET的開發,特別是CFET專用設計、工藝步驟、模組和基準流程的開發,已被選為將邏輯路線圖擴展到埃級時代的關鍵使能技術之一。這將有助於歐洲在下一代半導體創新和製造領域保持領先地位。
改進的背面接觸模組
在CFET專用整合模組的開發過程中,我們發現直接從晶圓背面接觸底部器件的源極/漏極結比正面接觸具有明顯的優勢。背面接觸不僅可以降低底部器件的接觸電阻,還可以拓寬頂部器件源極/漏極形成的工藝窗口——imec在2024年VLSI大會上對此進行了展示。此外,它還為進一步降低標準單元高度和減少晶圓正面BEOL(後端互連)的布線擁塞提供了有效途徑。
背面接觸通常需要額外的工藝步驟,包括晶圓鍵合和背面襯底減薄。此外,還需要一個額外的模組來將源/漏極外延層與下方的襯底進行電隔離——該模組被稱為背面介質隔離(BDI)模組。
- 傳統BDI模組:底部源/漏結構可變,且接入電阻較大
一種常見的背面接觸方法是在工藝流程的末端,整合一個完全由晶圓背面形成的BDI模組。但這種工藝流程存在一些侷限性。首先,由於底部SiGe:B源/漏結構在SiGe:B外延生長過程中同時受到底部Si溝道和下方Si襯底的影響,導致底部SiGe:B源/漏結構的體積存在相當大的偏差。其次,同樣的原因,SiGe:B結構會佔用大量空間,而這些空間無法被接觸金屬利用,從而增加了器件的接入電阻。第三,該工藝方案會造成背面接觸的良率損失,這不利於其在工業領域的應用。
- 一種新型BDI模組:提高了底部器件的性能和存活率
在2026年VLSI展會上,imec展示了一種改進的CFET器件背面接觸模組[4]。與傳統整合方案相比,該新方案使底部pFET器件的驅動電流IS提高了五倍。性能的提升主要歸功於底部pFET器件接入電阻的降低,其從1753Wµm降至378Wµm。此外,底部pFET器件的存活率也從45%提高到85%,高於之前的報導結果。
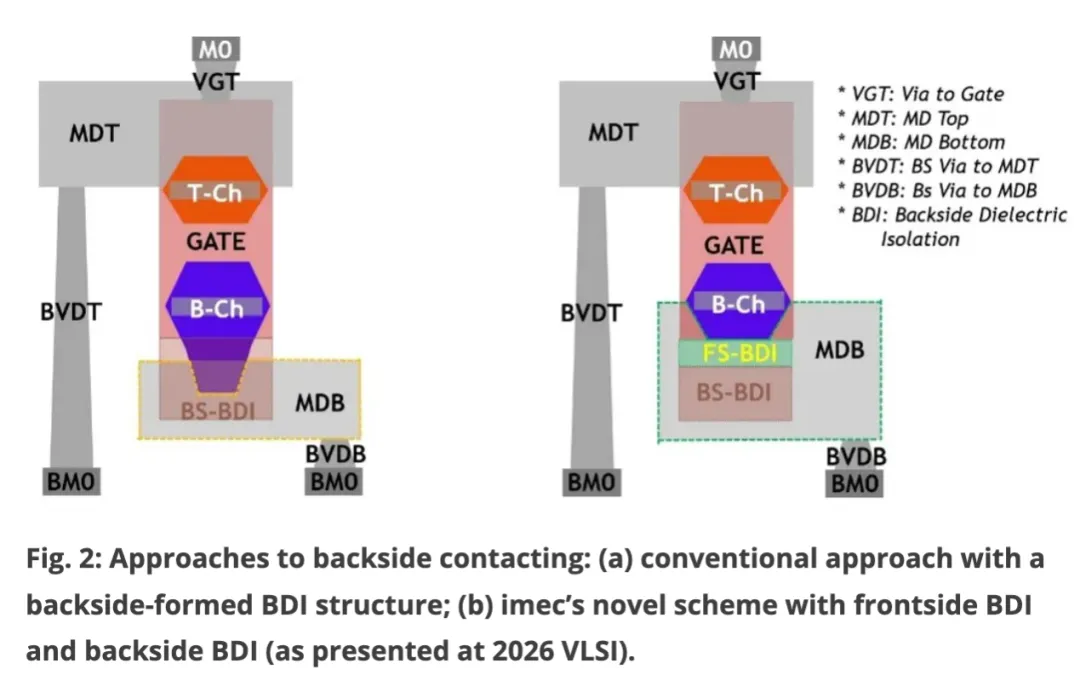
新模組的關鍵要素是在源/漏極下方形成額外的正面BDI(FS-BDI)結構,從而將源/漏極外延結構與下方襯底完全隔離。因此,底部SiGe:B源/漏極外延在生長過程中不再受下方Si襯底的影響。這改善了SiGe:B體積的變異性以及器件的接觸電阻。正面BDI在工藝流程早期形成,方法是在Si/SiGe疊層中加入一層額外的富鍺SiGe層,該層在中間介質隔離(MDI模組)形成過程中被介質層取代。因此,正面BDI的形成步驟不會顯著增加工藝複雜性。在工藝流程的下游加入了額外的背面BDI結構。整體背面工藝最佳化——包括晶圓鍵合、極薄晶圓和背面接觸蝕刻——也有助於提升pFET的性能。
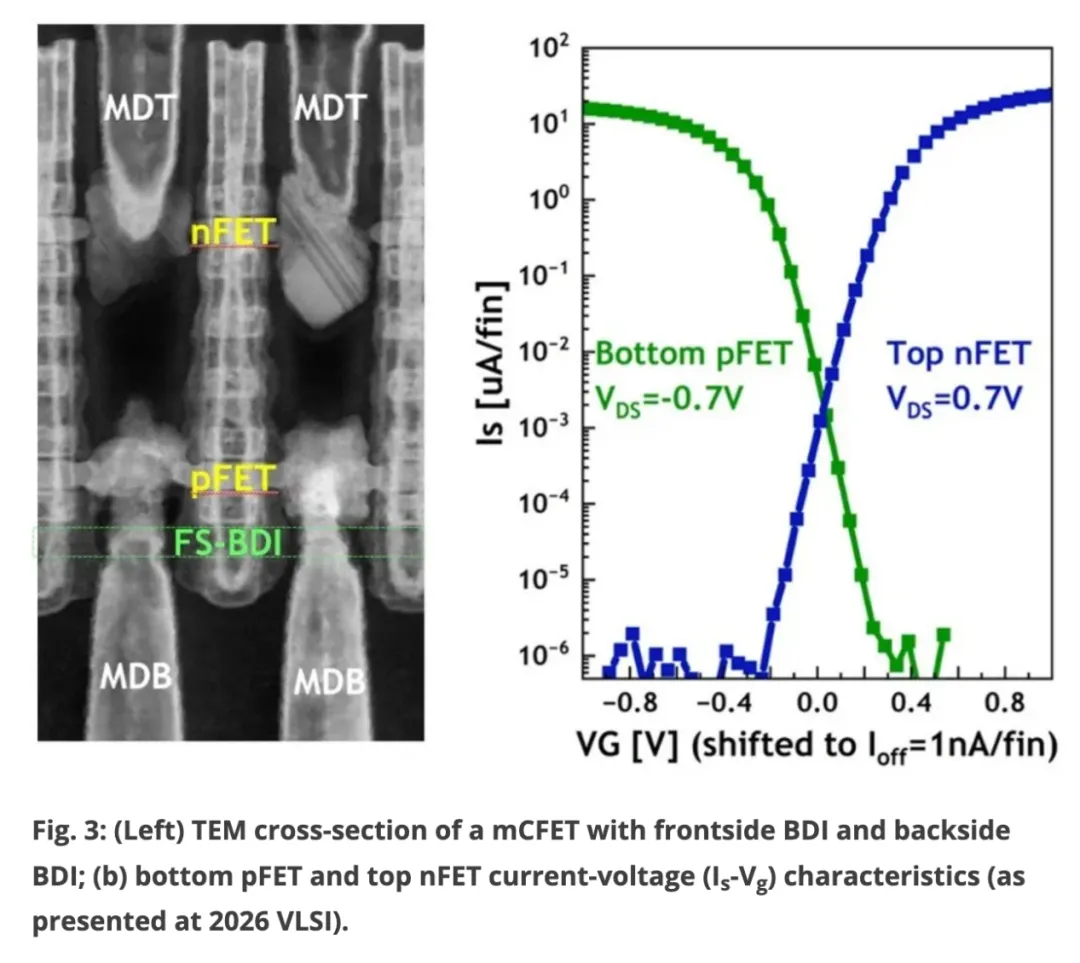
雖然改進後的背面接觸模組已在 mCFET 測試晶片上得到驗證,但該工藝流程被認為是通用的,也適用於 sCFET 器件。
一種新型的基於偶極子的柵極堆疊結構
堆疊的納米片構成了GAA納米片和CFET器件架構的核心,它們充當有源器件的溝道。但是,即使在同一積體電路中,不同GAA納米片或CFET器件的閾值電壓(或Vt,即器件開始導通時的柵極電壓)也不一定相同。理想情況下,器件應在不同的閾值電壓下工作,以完美平衡例如高性能計算和超低功耗運行等相互衝突的需求。
實現閾值電壓 (Vt) 調控最直接的方法是改變柵極金屬的成分和厚度,從而改變柵極的有效功函數。但在先進的納米片器件中,堆疊納米片之間的空間極其狹小,幾乎沒有改變柵極金屬厚度的空間。因此,業界需要尋找其他不增加器件體積的方法。
- 基於偶極子的多重Vt調諧
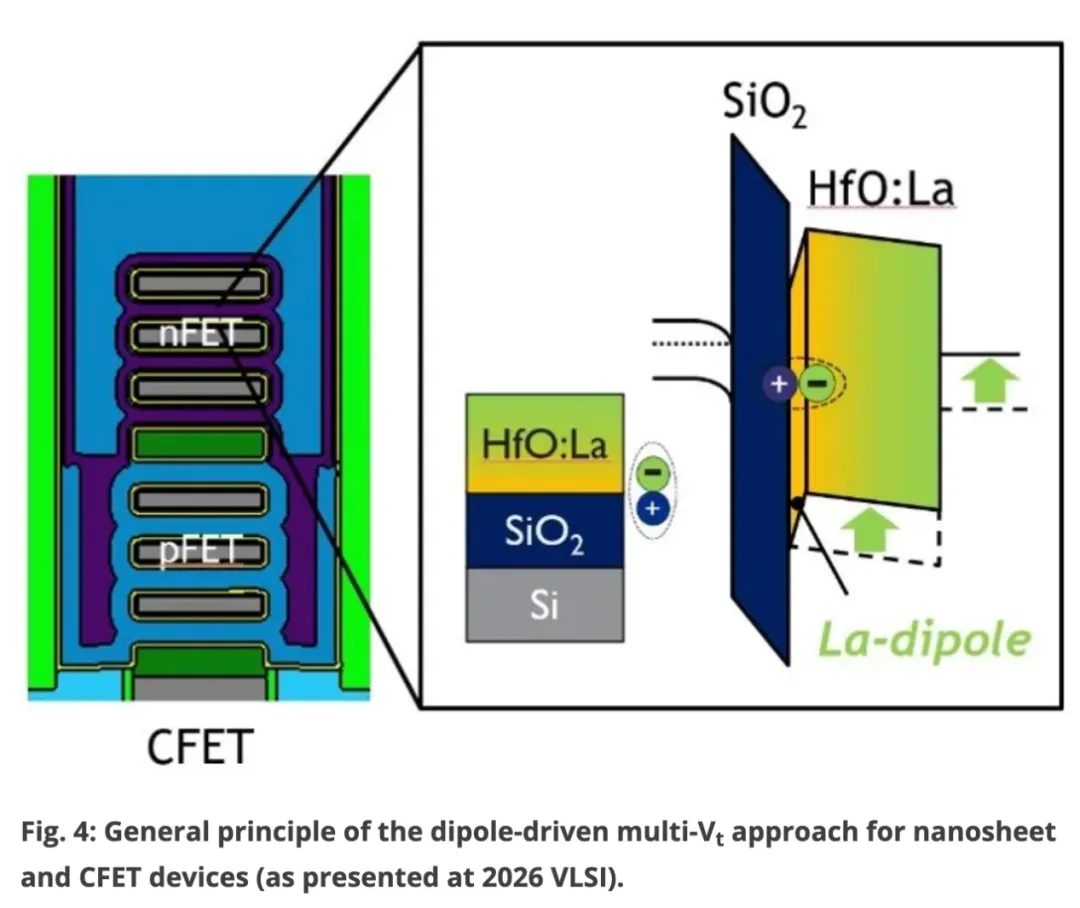
基於偶極子的多閾值電壓(Vt)調諧已被證明是一種很有前景的無體積替代方案。通過偶極子整合,在柵堆疊結構的SiO2中間層和HfO 2高介電常數層之間加入諸如鑭(La)原子之類的偶極子形成金屬。這種移位材料在SiO2 /HfO2介面處形成偶極子,從而影響器件的閾值電壓(Vt)。通過摻入不同濃度的La,可以獲得不同的閾值電壓(Vt)值。
- 偶極子後置與偶極子先置整合方法
目前應用最廣泛的移位材料整合方法是偶極子後置法,即將氧化鑭沉積在HfO₂高介電常數層上。在高溫退火步驟中,移位材料會擴散穿過相對較厚的高介電常數層,到達HfO₂ / SiO介面形成偶極子。雖然這種方法適用於前幾代CMOS器件,但其較高的熱預算對採用低溫金屬柵極置換工藝的CFET器件構成了挑戰。
因此,幾年前,imec的研究重點轉向了偶極子優先的方法,將移位材料直接沉積在SiO₂層上,從而避免了高溫退火步驟[5]。然而,研究發現,對氧化鑭移位層進行圖案化會損傷下方的SiO₂中間層,從而影響器件的性能。
- Imec的新型偶極子中間體方法
在2026年VLSI大會上,imec展示了一種新型柵堆疊整合方案,稱為“偶極子中間層”,它融合了兩種方案的優勢[6]。在該方案中,移位層沉積在一層薄薄的HfO₂層上。然後,通過溫和的退火步驟將移位層“鎖定”,該步驟足以使HfO₂擴散穿過薄的高k介電層。這層薄薄的HfO₂層還能在移位層圖案化過程中保護下方的SiO₂中間層。去除未反應的移位層後,沉積第二層HfO₂,然後再次進行退火。與“偶極子後置”方案相比,這種方法可以降低總熱預算,尤其是在需要整合多種移位層材料時。這使得這種新型柵堆疊整合方案與mCFET器件相容。
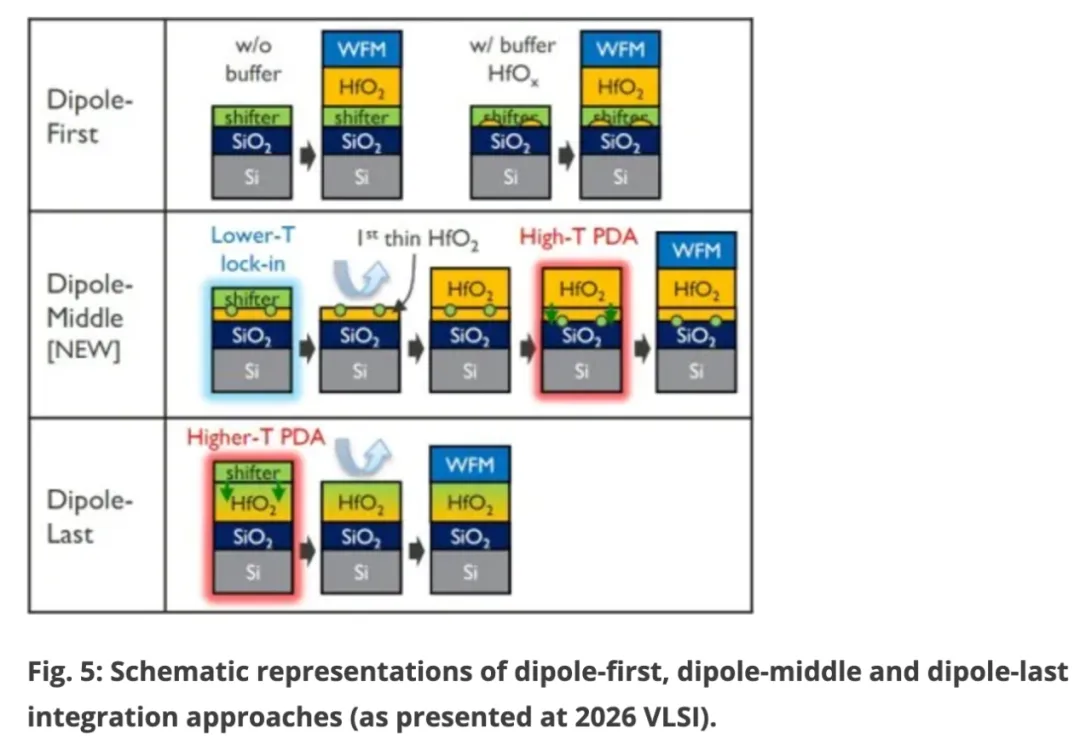
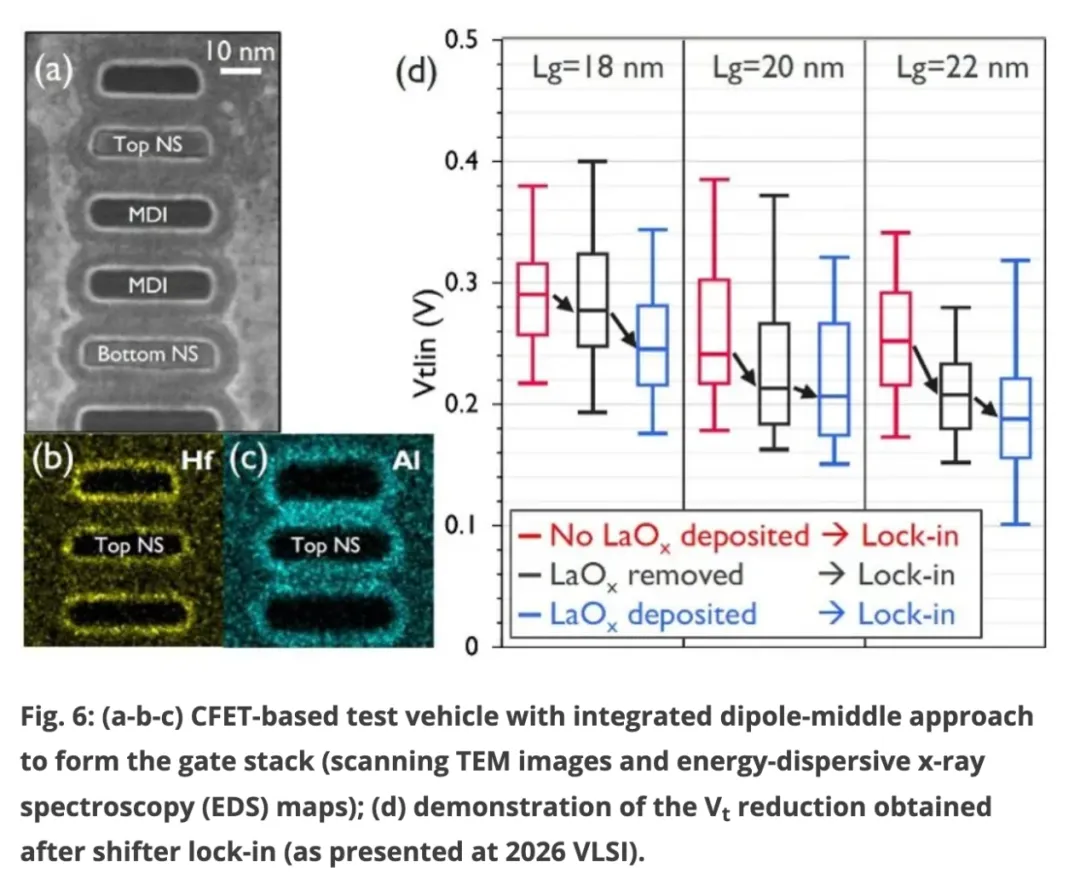
在基於 CFET 的測試平台上,偶極子中間層方法已成功得到驗證。在該平台上,僅對 nFET 頂部器件進行電氣評估。電氣資料顯示,與在鎖相放大前去除氧化鑭的參考器件相比, nFET 閾值電壓略微但穩定地降低了約 30 mV。
憑藉改進的背面接觸模組和與 CFET 相容的多閾值電壓調節方法,imec 及其合作夥伴生態系統在整合 CFET 關鍵模組方面取得了持續進展。這些整合工作對於確保 CFET 被納入邏輯技術路線圖至關重要——很可能從 A7 開始。
在後面文章中,我們將通過 DTCO 研究重點介紹 sCFET 的創新標準單元架構,確保 CFET 在多個邏輯節點上的可擴展性。
一種新型的sCFET架構
早期的DTCO研究已經證明了CFET技術在後續邏輯節點上的可擴展性——這是半導體行業採用這種新型器件架構的先決條件。例如,對於mCFET,imec此前已確定雙排(DR:double-row)CFET架構是將mCFET整合到A7標準單元中的最佳方式。雙排CFET標準單元包含兩排堆疊的器件,中間共享一個垂直訊號過孔,單元邊界處設有功率牆(見下圖)。之後,針對佈局效率低下的問題,開發出了雙排CFET的最佳化版本:半高雙排(hDR: half-height double-row )架構。在IEDM 2025上,為了支援向A3方向的激進面積縮減目標,引入了諸如混合通道整合等其他可擴展性增強技術。
- 共柵器件和分柵器件
mCFET器件的製造工藝流程本身就提供了共柵極器件:nFET和pFET的柵極在結構上是相互連接的。這對於90-95%的基本邏輯閘來說都適用——例如執行取反邏輯運算的反相器電路(或非門)。但對於其他邏輯電路,例如觸發器和多路復用門,則需要獨立控制nFET和pFET的金屬柵極。一種解決方案是使堆疊式CFET器件的一個極性未被使用(例如,僅使用nFET,而移除pFET)。雖然這種方法解決了柵極控制問題,但它並沒有充分利用堆疊nFET和pFET的面積優勢。
sCFET器件架構中,頂部和底部器件獨立進行圖案化,可以更自然地實現分柵器件。但傳統的sCFET架構卻帶來了相反的問題:需要額外的模組來連接那些需要分柵電路的柵極。
- 雙翻轉sCFET架構
在 2026 年 VLSI 展會上,imec 推出了雙翻轉 sCFET 架構,該架構在不影響面積效率的情況下,同時提供了分柵和共柵器件選項。
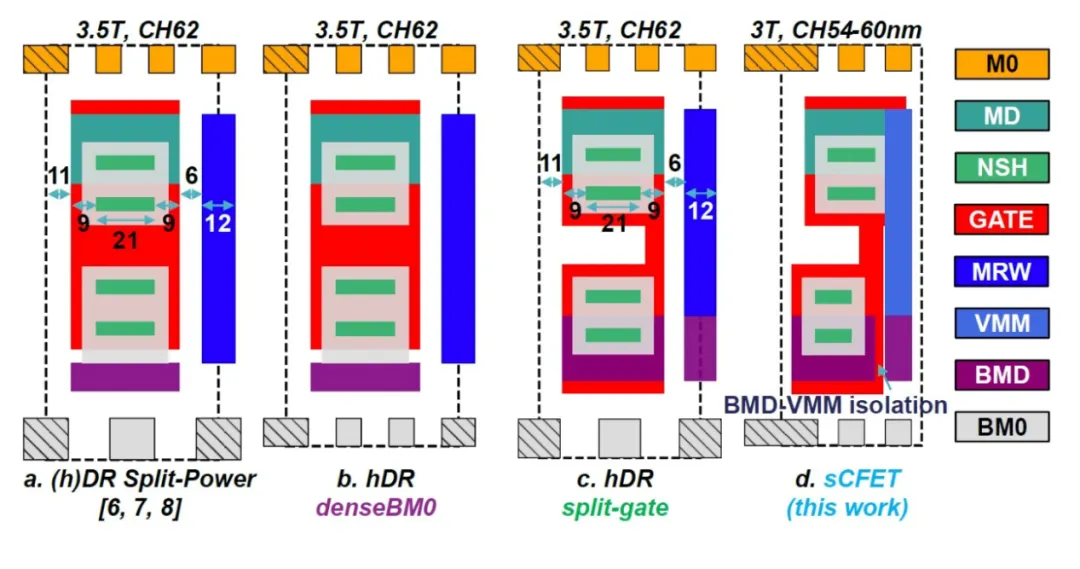
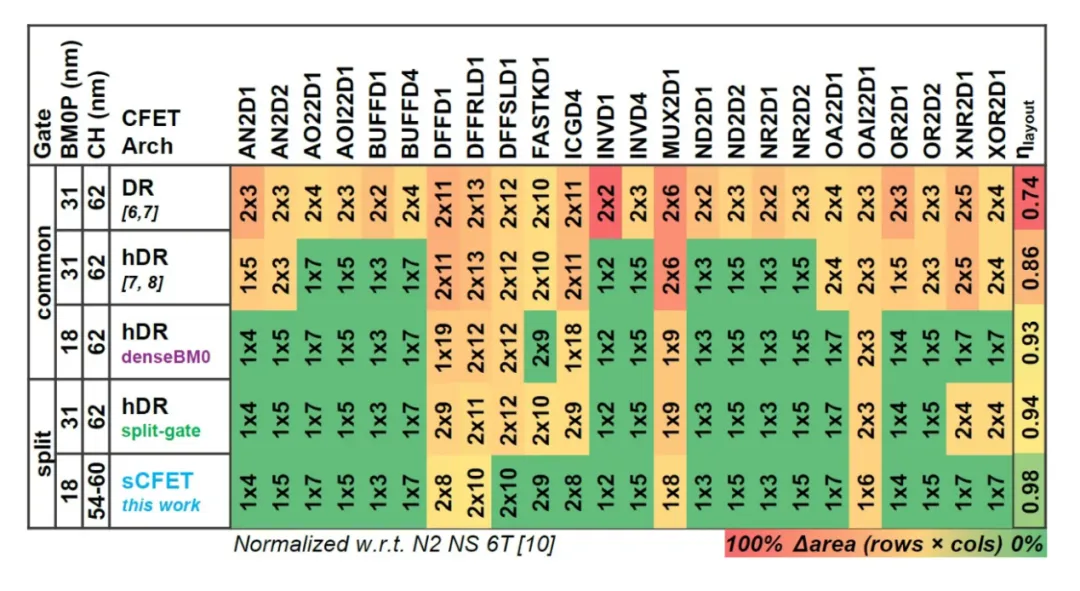
我們評估了新架構在面積效率和布線能力方面對各種基於 CFET 的庫的影響,這些庫的設計基於例如 AND、OR 和反相器電路。新 sCFET 雙翻轉架構的整體庫效率 (h) 高達 98%,與雙排 (DR) 和半高雙排 (hDR) mCFET 架構相比,它提供了最高的面積利用率。結合高密度背面金屬 0 (BM0) 布線,新架構支援 3T 標準單元,而根據 imec 最新的技術路線圖,這些單元將在 A3 和 A2 邏輯節點中得到應用。
雙翻轉sCFET工藝流程始於鍵合堆疊結構,其上下器件之間嵌入了中間介質隔離層(eMDI)。首先,從正面對頂部器件進行圖案化,並在更換金屬柵極模組的過程中部分完成頂部柵極的加工。晶圓翻轉和減薄後,從背面對底部器件進行圖案化。接下來,可選擇在底部柵極和頂部柵極之間建立過孔連接,該過孔可用於共柵極應用場景。經過第二次晶圓翻轉後,完成頂部和底部器件的加工。
通過引入混合溝道(分別針對n溝道和p溝道FET進行最佳化),可以進一步擴展器件尺寸。例如,可以考慮頂部和底部器件採用不同溝道方向的CFET器件,或者採用非對稱片層寬度的CFET器件。這不僅能帶來額外的功耗、性能和面積優勢,還能增強設計的靈活性。
延長SRAM 尺寸縮小路線圖
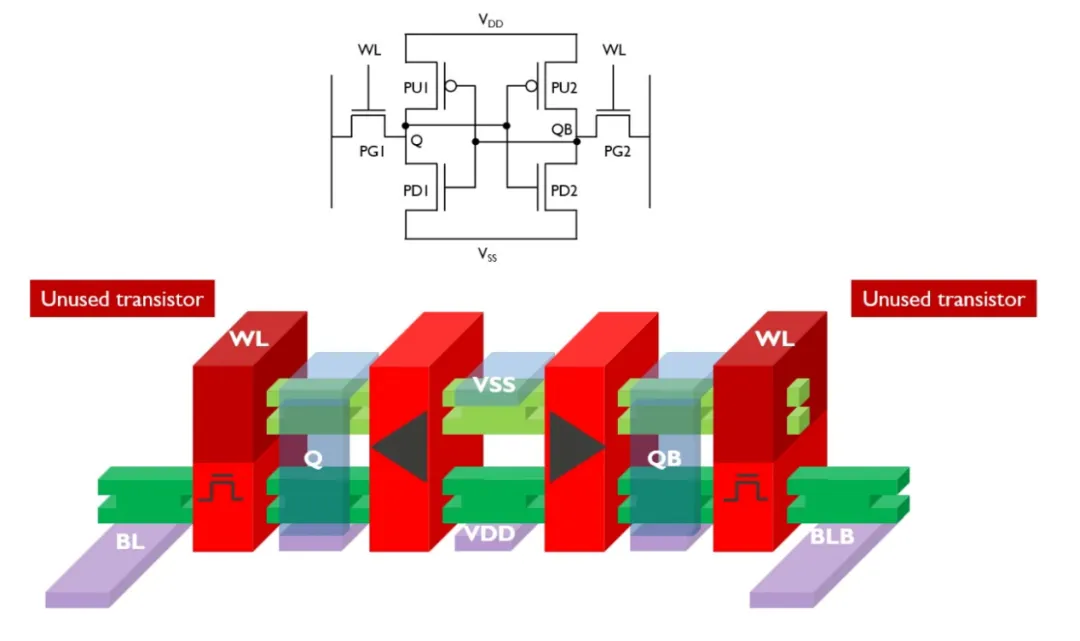
靜態隨機存取儲存器 (SRAM) 仍然是業界提供片上快取記憶體的主要手段——這種高速儲存器連接著動態隨機存取儲存器 (DRAM) 和擴展處理器 (XPU)。一個傳統的 SRAM 儲存位單元由六個電晶體組成:四個 nFET 和兩個 pFET(或者,也可以是兩個 nFET 和四個 pFET)。在這些 FET 中,兩個 nFET 和兩個 pFET(下面圖中的 PUx 和 PDx)兩兩配對,形成兩個交叉耦合反相器,能夠儲存一位資訊。其餘的 nFET 設計為傳輸柵電晶體 (PG),連接到位線和字線 (BL, WL),並在讀寫操作期間控制資料流。
- SRAM密度危機:CFET能否帶來緩解?
與邏輯技術類似,SRAM 儲存器的密度提升依賴於位單元尺寸的縮小以及器件架構的創新。但自 7nm 技術節點以來,SRAM 位單元的縮小速度遠不及邏輯 CMOS 器件。這種尺寸縮小潛力的不對稱性給晶片設計人員帶來了巨大的挑戰。即使過渡到基於 GAA 納米片的 6T SRAM 單元,也無法提供所需的功耗、性能和面積優勢。基於 CFET 的 6T SRAM 技術有望帶來初步的緩解,因為堆疊(部分)n 型和 p 型 FET(即 PUx 和 PDx)可以顯著提高 SRAM 位單元的密度。
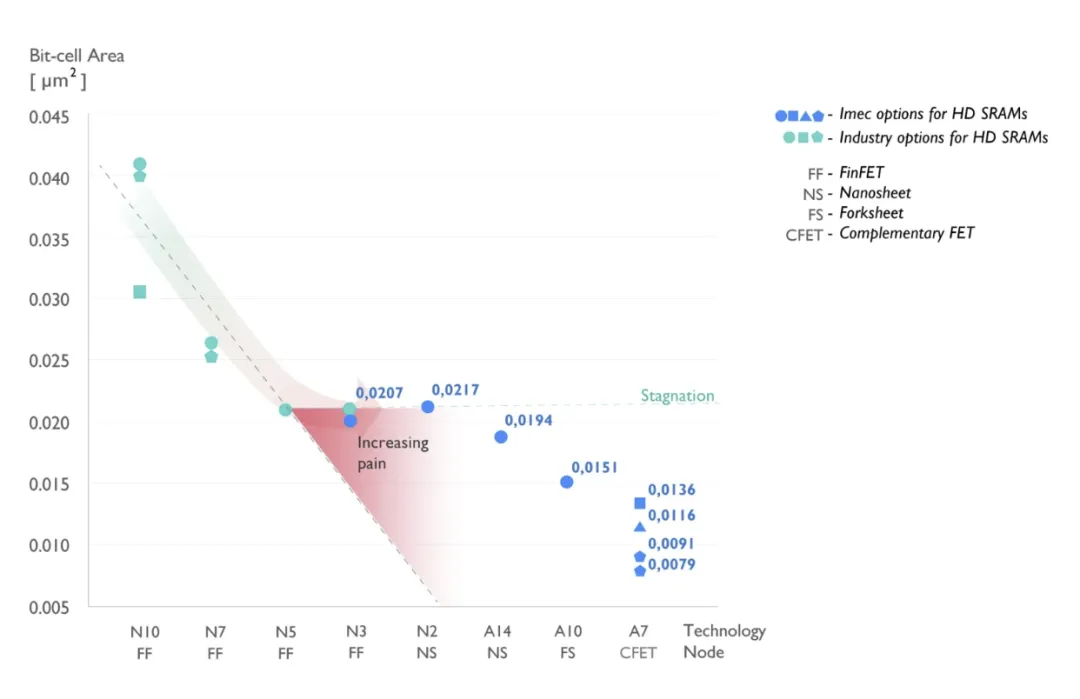
即使在CFET SRAM時代,進一步縮小面積仍然面臨挑戰,因為6T SRAM位單元無法有效地對應到基於CFET的架構上。雖然兩個反相器可以通過堆疊的n/p器件架構(PUx和PDx)進行對應,但作為單通道柵極電晶體(PG)的兩個nFET使得CFET器件堆疊頂部的兩個p型電晶體處於閒置狀態。因此,CFET固有的垂直密度優勢無法完全轉化為6T SRAM位單元面積的縮小。人們曾研究過僅使用一個單通道柵極電晶體的5T SRAM位單元組態作為一種面積高效的替代方案,但其可寫性和噪聲問題阻礙了其應用。
- 一種前景廣闊的 5T+1 SRAM CFET 架構
imec 的新型 sCFET 分柵器件架構為 SRAM 密度的持續微縮開闢了道路——該架構已在 2026 年 VLSI 大會上發佈 [5]。在這種新型 5T+1 架構中,兩個單通道柵極電晶體 (PG) 被一個 CFET 傳輸柵極器件 (TG) 所取代,該器件將一個 nFET 和一個 pFET 配對。這種傳輸柵極需要獨立的 n 柵極和 p 柵極控制,而 imec 的新型 sCFET 分柵器件可以實現這一點。因此,可以在保持 5T 封裝尺寸的同時,實現類似 5T 的 SRAM 位單元(即帶有 sCFET 傳輸柵極的單端 SRAM 位單元)。與“經典”的 5T 實現相比,使用傳輸柵極作為訪問器件也提高了寫入性能。
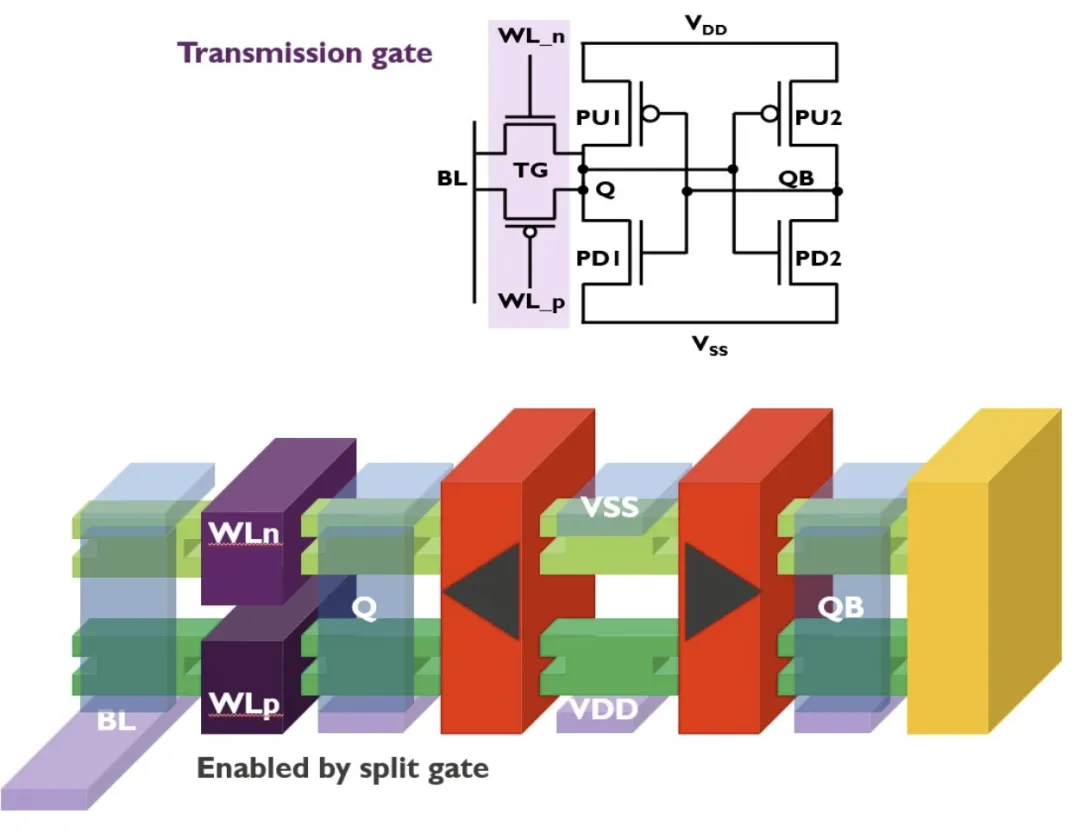
通過最佳化儲存器陣列等級的佈局和布線,可以進一步提升 SRAM 的性能。imec 的 DTCO 研究表明,採用這種創新的 5T+1 組態,其位單元尺寸比傳統的 6T CFET SRAM 單元縮小了 12.5%,寫入速度提高了 7-15%。這使得 5T+1 CFET SRAM 位單元成為將 SRAM 尺寸縮小路線圖延伸至 A7 及更高版本的理想選擇。
- 改進的BEOL布線能力以支援CFET微縮路線圖
在多項DTCO研究中,imec已證明其能夠借助創新的標準單元組態和擴展加速器,將CFET器件架構擴展到後續的邏輯技術節點。但隨著我們邁向埃級時代,根據imec在2026年VLSI大會上發表的一項新的DTCO研究[6],標準單元等級的面積優勢很容易被BEOL(後端工藝)的擴展問題所抵消。換句話說:互連各種基於CFET的標準單元變得越來越困難。
在理想的尺寸縮放方案下,所有尺寸均按比例縮放,布線能力在不同節點之間保持不變。然而,從 2nm 節點開始,一些基本規則(例如接觸多晶硅間距 (CPP,由柵極長度和源漏接觸長度共同決定) 以及金屬層間距)的縮放速度開始放緩。這加劇了晶圓正面布線的擁塞,進而影響性能、功耗和面積。此外,激進的標準單元尺寸縮放也限制了輸入輸出引腳的訪問。
- 改善基於 CFET 的埃級節點技術的後端互連布線能力
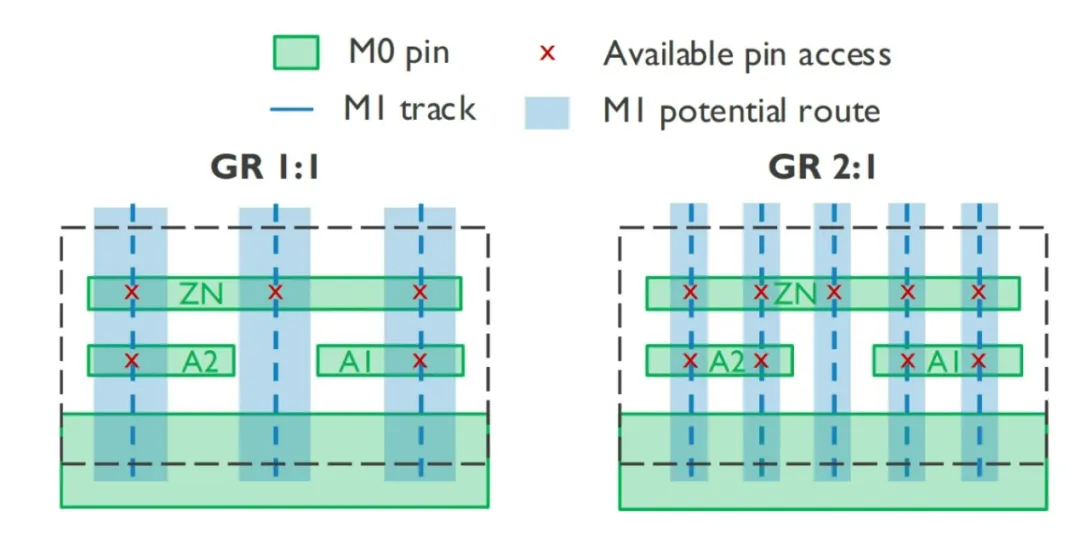
幸運的是,有多種方法可以改善後端互連(BEOL)的布線性能。其中一種方法是提高所謂的齒輪比(gear ratio),它代表了CPP(晶片間距)與金屬層1間距的比值。在2nm節點處理器設計中,該齒輪比通常約為1:1。imec在2026年VLSI大會上通過DTCO研究表明,對於基於A7 CFET的設計,將齒輪比提高到2:1可以改善引腳可訪問性和面積利用率,而不會影響功耗和性能[6]。實際上,這將導致金屬層1的間距更小,需要更先進的光刻技術,例如單次曝光高數值孔徑EUV光刻技術。
總而言之,imec推出的雙翻轉sCFET是一種全新的CFET器件架構,並將其納入邏輯產品路線圖。雙翻轉sCFET具有極高的微縮潛力,可在不增加面積的情況下同時提供分柵和共柵兩種器件方案。這種新型架構不僅有利於邏輯產品路線圖,還能通過實現5T+1 SRAM CFET位單元儲存器,為停滯不前的SRAM產品路線圖提供解決方案。在另一項DTCO研究中,imec展示了改進的BEOL布線能力如何進一步支援基於CFET的標準單元的快速微縮。 (半導體行業觀察)