
AI正在用降低單機配置、拆分推理任務和共用記憶體繞過短缺。記憶體周期是否延續,取決於節省下來的容量與新增需求誰跑得更快;連接晶片和專用推理架構的收益,則要看系統效率能否轉成真實收入。
一、記憶體周期的分歧,落在短缺能持續多久
AI伺服器降低記憶體配置,直覺上會削弱記憶體廠商的收入。但截至2026年10月5日,大摩仍對美光和閃迪維持超配評級,同時把Astera Labs、邁威爾科技和Cerebras列為架構調整的潛在受益者。這幾個方向可以同時成立,原因在於供給受限時,少用一點記憶體可能讓更多系統交付,新增機器又會消耗更多記憶體。
大摩預計,短缺強度會波動,但AI在可見未來仍會吸收可用供應。這裡的判斷建立在AI建設繼續增長的前提上,不能理解成任何價格、任何品種、任何時間都缺貨。HBM、高頻寬之外的DRAM和NAND承擔不同任務,價格與盈利也會有各自的節奏。
真正的分歧在於周期的長度。若算力公司堅持最高配置,卻因為拿不到記憶體而無法交付,記憶體廠商可能獲得更陡峭的短期漲價。但客戶會選擇降低配置、改變資料存放位置,儘量維持建設進度。價格峰值因此可能溫和一些,需求持續的時間卻可能更長。對於記憶體企業,連續幾個季度的出貨、產品組合和利潤水平,比某一個月的報價更接近經營價值。
這種持續性還包含恢復配置的需求。供給不足迫使客戶購買較低規格,供應改善後,部分工作負載可以重新增加容量。能否恢復,要看增加記憶體帶來的性能收益和客戶預算;不能把潛在需求全部提前計入收入。但因“拿不到”而少買,與因應用價值不足而不願意買,確實對應不同的後續需求。
最強的反證來自建設約束。大摩明確提醒:如果AI部署被土地、電力或機房條件卡住,記憶體可能受到算力公司沒有同步承受的衝擊。晶片訂單、備貨和機房投運之間有時間差,不能只憑算力公司的遠期增長指引判斷記憶體庫存一定安全。周期延續的前提,是建好的系統能夠投入使用。
二、降配的數字,必須先把系統形態對齊
Rubin的降配包含幾個尺度,不能把機櫃總容量、模組容量和單顆GPU容量直接放在一起比較。大摩預計,輝達可能提供較低記憶體配置的Rubin方案:機櫃LPDDR5由原來的54TB降至28TB,SOCAMM2模組由192GB轉為96GB;GPU的HBM由288GB降至192GB。
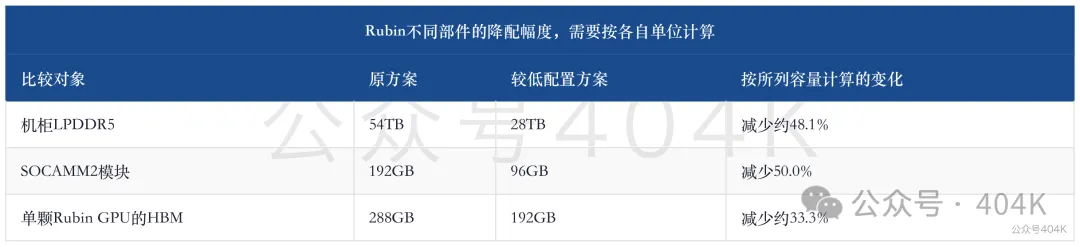
這些是大摩討論的配置預期,不能寫成已經確認的最終交付清單。三個百分比也不能平均成“整機記憶體減少多少”:它們分別對應不同器件、不同分母,系統數量和裝配結構還會影響總需求。
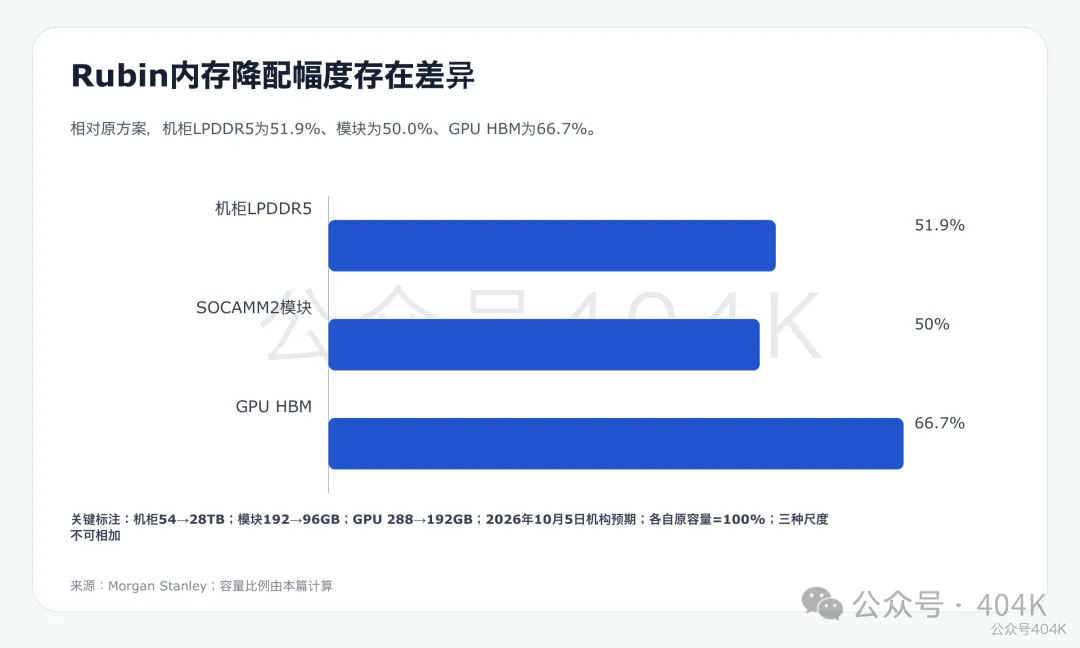
HBM的變化尤其值得細看。288GB方案採用8個12層堆疊,192GB方案仍是8個堆疊,但改為8層。容量減少來自堆疊高度變化。對記憶體廠商,這會改變單顆GPU消耗的記憶體容量;對計算廠商,它則可能在保留一定頻寬的同時降低物料壓力。
Rubin Ultra還有一個容易誤讀的比較。原先展示的1TB容量對應四個計算裸片,調整為兩個裸片後,512GB才是與原配置對應的比較基線。大摩進一步討論了繼續使用HBM4、選擇較低堆疊高度等可能性,潛在容量為192GB至384GB。把1TB直接與雙裸片方案相比,會把加速器形態變化也算成單純降配。
這類調整透露出計算公司的採購排序:先保證可以交付的系統數量,再按工作負載選擇記憶體規格。最高配置仍有需求,較低配置也有適用場景。對產業鏈的判斷應落到具體產品組合,而不是假設所有客戶都會同步購買同一種方案。
三、HBM頻寬未變,系統性能仍會付出代價
容量回答“能裝下多少資料”,頻寬回答“每秒能搬多少資料”。這兩個指標影響性能的方式不同。大摩指出,在介面和引腳速度不變的條件下,從12層堆疊改為8層可以減少HBM容量,而不必同比減少頻寬。對於模型較小、上下文較短的任務,這種配置有可能保留較好的運行效率。
限制來自資料是否仍能放在近端。模型權重、上下文和同時服務的請求增加後,原先能放進HBM的資料可能需要分散到更多GPU,或者移動到主記憶體和其他記憶體層。前者增加跨GPU通訊,後者增加讀取和搬運。單顆器件的頻寬保持,不等於整套系統的吞吐、延遲和成本全部保持。
因此,降配節省的記憶體成本,需要和新增GPU、互聯、控製器以及軟體運行成本合併比較。只有節省大於新增支出,且應用性能滿足要求,較低配置才具有經濟優勢。若資料轉移導致GPU頻繁等待,便宜一點的記憶體配置也可能對應更貴的有效計算。
大摩觀察到的遷移方向很具體:LPDDR配置降低,會增加NAND承擔KV快取記憶體的需求;HBM容量減少,會增加scale-up互聯或CPU輸入輸出的壓力。KV快取保存推理過程中已經計算過的上下文資訊,規模會隨上下文和並行增加。把部分資料放入較慢層級,可以釋放昂貴的近端容量,但資料何時取回、取回多少,仍決定應用體驗。
機櫃內部連接得足夠緊密時,多個GPU可以更像一個整體工作。更大的scale-up域,讓系統在單顆GPU容量較低的情況下,通過更多GPU和共享訪問維持機櫃層面的能力。這也是Astera和邁威爾科技可能承接部分瓶頸的原因:記憶體少裝一點,系統對資料流動的要求反而更高。
另一個變化發生在HBM的價值分配。大摩引用的定製HBM4e示意給出相對標準介面30%的頻寬優勢,以及PHY和輔助區域面積減少67%的比較。PHY承擔物理介面功能;計算廠商參與定製底層裸片設計後,部分頻寬改善可以來自計算側的介面設計能力。
這兩個比例不能換算成整機性能提升30%,也不能理解為HBM總成本下降67%。它們說明,在容量、DRAM工藝之外,介面與封裝設計正在參與性能分配。記憶體廠商能否繼續取得高頻寬溢價,需要同時看自身技術優勢和計算客戶掌握的定製能力。
四、用總量模型檢驗HBM是否見頂
判斷HBM需求,至少要把GPU出貨數量與單顆容量相乘。在產品範圍、容量單位和其他條件不變時,可用一個簡單關係檢驗降配影響:
HBM容量總需求變化倍數=GPU出貨變化倍數×單顆HBM容量變化倍數。
從288GB降到192GB,單顆容量變為原來的三分之二。若出貨不變,總容量減少約33.3%;出貨增長50%,才能抵消這一配置下降。這只是圍繞大摩方案做的敏感性計算,不是GPU出貨預測,也沒有包含其他型號和其他HBM世代。
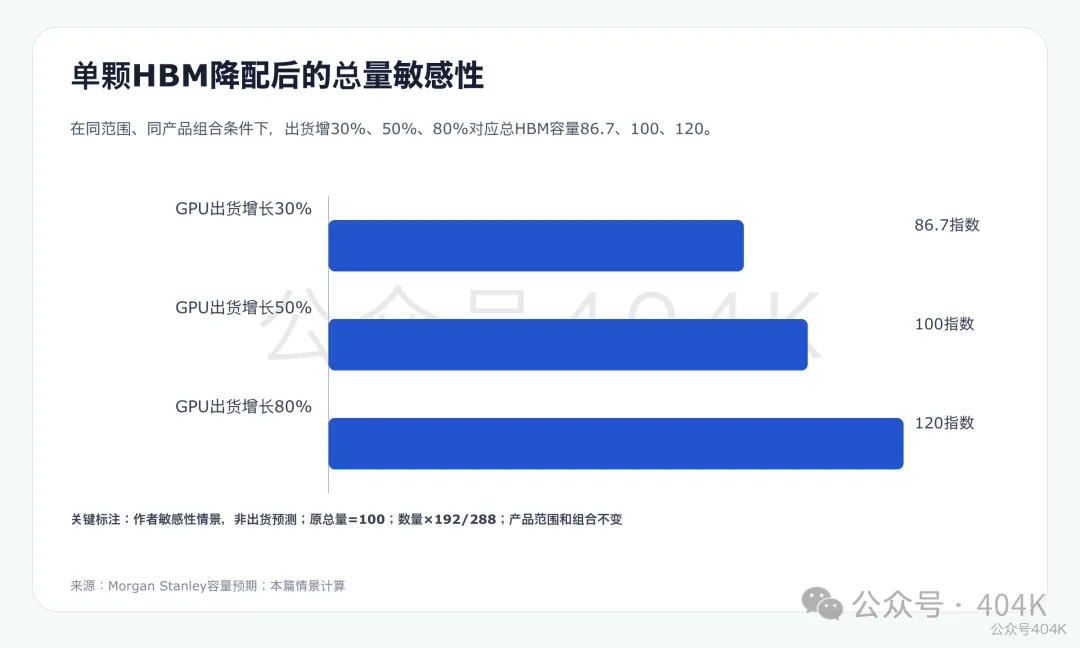
同樣的關係可以幫助識別市場預期中的隱含假設。若GPU出貨增長30%,所需HBM容量約為原來的86.7%;若增長80%,則約為原來的120%。結論取決於數量是否增長得足夠快,不能只看單顆容量變化,也不能只看算力訂單增長。
更複雜的情況,是較低容量導致一項任務需要更多GPU。系統既可能把省出的記憶體用於交付更多機器,也可能把更多機器用來承擔同一個更大的工作負載。兩條路徑都可能抵消單顆降配,但最終經濟性不同:前者擴大服務能力,後者可能只是維持原有體驗。
收入還需要加上單位容量價值。容量相同,產品世代、介面速度、封裝難度和合同價格不同,收入和利潤可能變化。HBM廠商能否維持價格溢價,以及先進產品的成本和良率是否改善,都會影響盈利。上述總量公式不能直接當作美光的收入或利潤模型。
NAND也不能只按“資料從DRAM流出”來推斷收入必然等比例增長。快閃記憶體承擔更多上下文記憶體,可以增加內容量;但需要區分新增採購、原有裝置利用率提高和不同系統之間的資料重複。大摩對閃迪的積極判斷,依賴記憶體需求持續,而不是每一次記憶體層級遷移都立即形成同額訂單。
對整個記憶體周期,最有用的組合證據是:系統交付量繼續增加,較低配置沒有引發庫存積壓,供應改善後高容量需求能夠恢復。若只有高報價,卻出現部署放緩和庫存增長,持續時間的判斷就需要下調。
五、推理拆開之後,SRAM拿到什麼位置
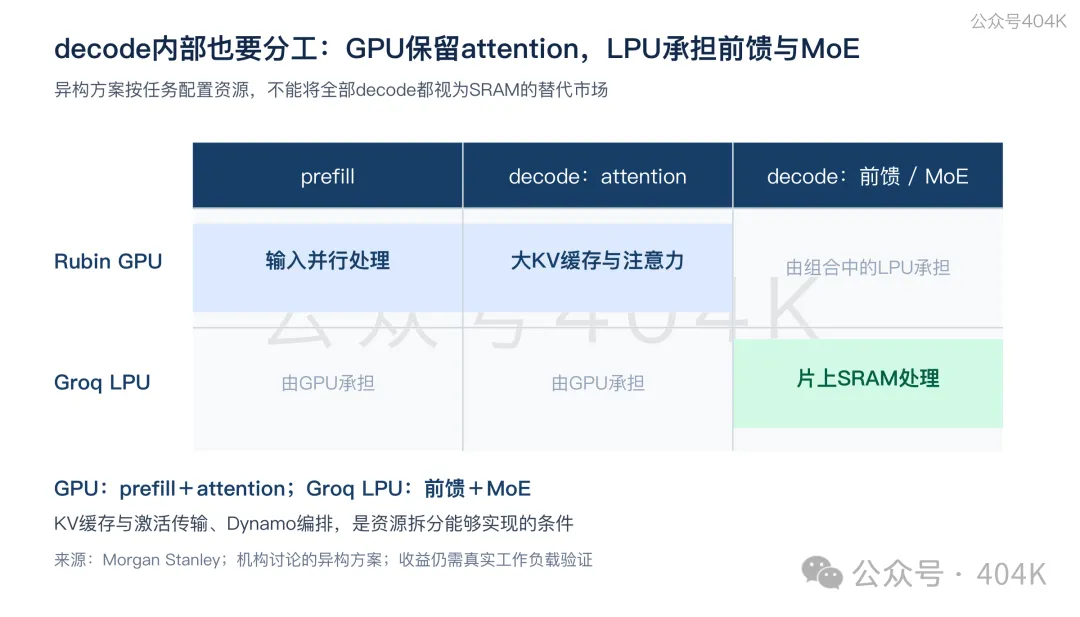
另一條繞路,是讓不同硬體承擔不同推理階段。Prefill處理輸入提示和上下文,能夠平行進行,通常更受計算能力約束;decode逐個生成輸出token,反覆訪問模型權重和不斷增長的KV快取,更依賴記憶體頻寬和容量。把兩類任務塞進完全相同的資源配置,容易出現某一種資源等待另一種資源的情況。
拆分之後,計算密集的裝置處理prefill,適合高頻寬或低延遲的裝置處理decode,兩側可以按負載分別擴張。收益來自更好的資源利用率,而不是簡單減少一個器件。代價則是任務編排、KV快取傳輸和跨裝置通訊;省下的硬體成本必須覆蓋這些新增開銷。
長上下文和智能體應用增強了拆分的動力。編碼助手可能先讀取大段程式碼,再持續生成輸出並反覆呼叫模型。若大輸入請求和已有使用者的輸出生成共用資源,前者可能干擾後者。把階段分開,有機會改善服務穩定性,同時避免所有階段都配置同樣多的昂貴記憶體。
SRAM位於晶片上,可以提供很高的本地頻寬,並減少訪問外部記憶體的資料搬運。但片上容量、晶片面積以及模型對應方式構成限制。大摩討論的幾家公司採用了不同方法,不能把它們合併成“SRAM替代HBM”這一種路線。
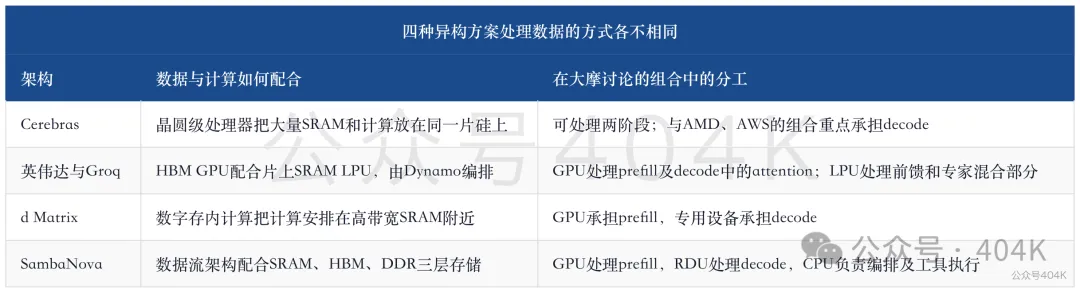
Groq的分工揭示了一個細節:即使進入decode階段,也不是所有運算都適合交給同一種晶片。涉及較大KV快取的attention仍由GPU承擔,前饋網路和專家混合部分則交給LPU。這種安排保留了HBM容量和GPU靈活性的價值,同時用另一種架構處理更適合它的工作。
d Matrix側重減少權重在獨立計算和記憶體之間反覆移動;SambaNova則把模型計算對應到資料流,並用不同記憶體層放置不同敏感度的資料。它們爭取的都是任務中的某些高成本環節。能否擴大部署,取決於真實模型、編譯器和營運條件下能省多少成本,不能僅靠晶片的理論頻寬排序。
六、Cerebras的變化,要從吞吐接到收入
Cerebras提供了一個把架構變化連接到經營結果的例子。大摩預計,與AMD組合的方案在2026年第四季度進入生產,與AWS組合的方案在2027年第一季度進入Amazon Bedrock。這裡是投產和服務落地預期,仍需由實際交付驗證。
兩組方案分別讓AMD相關系統或Trainium處理輸入階段,再由Cerebras承擔頻寬密集的decode。大摩轉述雙方披露的結果:組合系統在保持Cerebras推理速度的同時,吞吐量最多提高五倍。這個數字對應特定組合,不代表所有模型、所有並行水平、所有端到端響應都提速五倍。
速度與吞吐要分別理解。單個請求生成得很快,未必能同時承接很多請求;在既有速度下提高吞吐,意味著同一套Cerebras資源有機會服務更多輸出。因此,商業價值更接近“每套已經部署的裝置可以售出更多有效token”,而不只是宣傳中的速度紀錄。
Cerebras同時營運雲基礎設施,成本改善可以通過兩條路徑進入經營結果:維持售價並改善毛利,或者降低價格並爭取更多使用量,也可能兩者結合。具體結果取決於客戶需求彈性、可用容量是否被售出,以及新增配套裝置和網路的支出。
五倍吞吐不能直接換算成五倍收入。若客戶需求不足,增加的能力會成為閒置;若收益主要通過降價讓給客戶,收入增幅也會小於吞吐增幅。軟體維運、系統可靠性和服務穩定性同樣會影響客戶是否把任務遷入。 (404K)