
設想一下:
你用Claude Code手搓了一個小應用,順便給它接了個AI客服。
本想讓它自動解答使用者「怎麼登錄」「會員服務有啥內容」之類的基礎問題,好讓自己當個甩手掌櫃。
結果客服確實能聊天了,但你卻淪為了它的全職陪練:
回答不准,趕緊補一句提示詞;解釋太囉嗦,再加一條限制。
更讓人崩潰的是,每改一句提示詞,你都得把常見問題重新問一遍,生怕它顧此失彼,剛修好一個問題,卻把原本答對的又改壞了。
於是,用AI寫程式碼省下的時間,又有不少還給了一輪輪的人工偵錯。
針對這類反覆偵錯的麻煩,9月28日,Anthropic官方發佈了一份調優指南。
這份指南的核心思路就一句:反覆測試、修改這樣的活,Claude也能幹。
讓它多接手一些,你就能少當幾輪苦哈哈的測試員,把更多精力用來給AI把關:
給它定規矩,說清楚什麼才算做好,再檢查它有沒有真正做到。
01. 把「別瞎說」變成具體的考試題
要讓AI有方向地改錯,先得把「怎樣才算做對」說清楚。
平時我們總希望AI客服「靠譜一點」,但這太抽象了。
如果能把要求落到使用者真正會遇到的問題上,標準就具體多了。
比如:
使用者找不到匯出按鈕時,它能不能給出正確的點選路徑?
使用者問到還沒開發出來的功能時,它會不會一本正經地胡說八道?
遇到退款問題,它能不能按明確的規則處理,拿不準時不亂承諾?
官方提供的第一個入口是:/claude-api build-eval。
簡單來說,它能幫你把這些具體要求變成測試題,為接入Claude的小應用建一套可以反覆運行的驗收題庫。
你可以把平時讓AI頻繁翻車的問題交給它,但題庫不能只收錄「翻車現場」,那些最常見、最普通的問題,同樣也要覆蓋。
否則,偏題、難題堆得再多,也可能測不準普通使用者的日常體驗。
題目選好了,還要把「怎麼判分」說清楚。
「專業」「智能」「友好」,這些要求顆粒度都太粗,要落到一些更具體的衡量標準上。
比如那些資訊必須說清楚,那些錯誤不能犯,做到什麼程度才算過關。
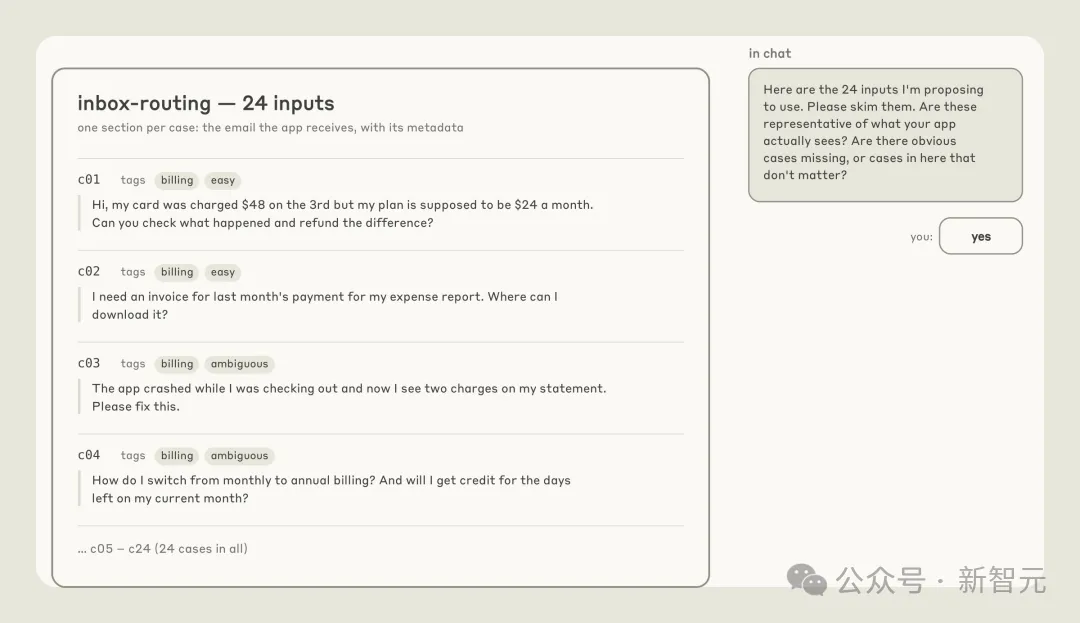
官方信箱分類示例:測試樣例需由使用者確認。
Claude會幫你擬出相應的評分規則,而你要確認按這套規則拿到高分的答案,是不是真的解決了使用者的問題。
有些結果可以直接用程序檢查,比如有沒有遺漏關鍵欄位;遇到一些有多種合理答案的開放性問題,也可以讓模型按明確的規則打分。
但評分器本身也要先過關。
拿幾份已經打過分的答案,對照自己的判斷,看看有沒有「答對了卻扣分」「沒解決問題卻給過關」的情況。
確認評分靠譜,再定期抽查。
對於開發者來說:這一步最大的爽點在於,你終於能把那句「怎麼又答錯了」的反覆抱怨,變成一套可以持續運行的自動化檢查。
以後每改一次提示詞,就能再跑一遍,看看這次修好了那裡,有沒有把別處改壞。
02. 自己改自己測改差了就撤回
題庫建好了,接下來就是掏出第二個官方入口:/claude-api hillclimb。
hillclimb可以理解為「爬坡」,讓AI一點點嘗試最佳化,看看有沒有進步。
但這個KPI同樣也要定得具體,還要說清楚允許它改什麼。
比如,讓客服回答得更準一點,允許它修改提示詞;或者在維持回答質量的前提下,嘗試省點API費用,允許它調整模型配置。
接到任務後,Claude會查看用於迭代的那些錯題,每輪提出一處修改,再重新跑評估:
在既定目標下確有改善,才保留修改;改完後反而退步了,就撤回。
按官方文件,這兩個入口都要求Claude Code v2.1.259及以上。
提示詞、技能檔案、工具說明和模型配置等,都可以成為調優對象,但具體改那些,要由你劃定範圍。
你可能會擔心:AI會不會變成應試教育的做題家?也就是只針對你給的那幾道題死記硬背,換個問法又開始胡言亂語?
官方也確實考慮到了這一點。
這套流程會單獨留出一部分題,作為不提前公開的「驗收考題」。
負責提出修改的模型看不到這些題的內容。每輪改完,再用它們測試,看看效果是真的變好了,還是只對練過的題管用。
如果練過的題分數漲了,「驗收考題」的成績卻沒提高,就可能出現了「過擬合」:越來越會做熟題,換一批題卻沒進步。
遇到這種情況,Claude會撤回本輪修改;如果改完後表現反而變差,也會回退。
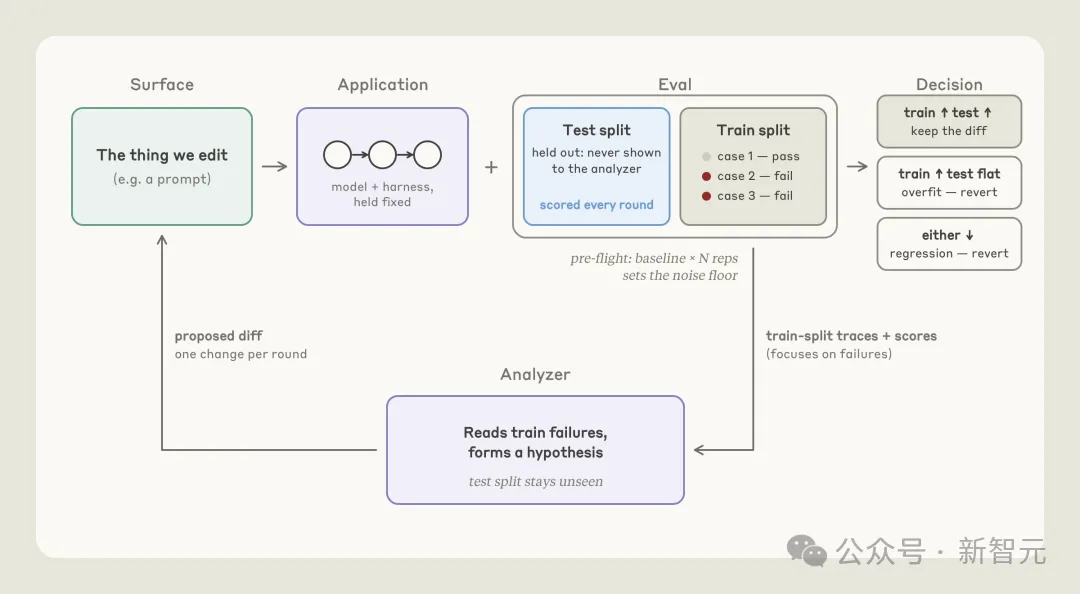
每輪修改後複測,根據結果保留或撤回。
這能幫助發現「只會做熟題」的問題,但不代表從此高枕無憂。
題庫本身覆蓋不到的真實問題,仍然可能讓它翻車。
03. 官方客服案例成本降至約1/5
Anthropic用一個內部客服評測展示了效果。
在14張未參與指導修改的留出測試工單上,最終配置的決策精準率從78.6%升至90.5%,提高了11.9個百分點,模型呼叫成本降到了原來的約1/5。
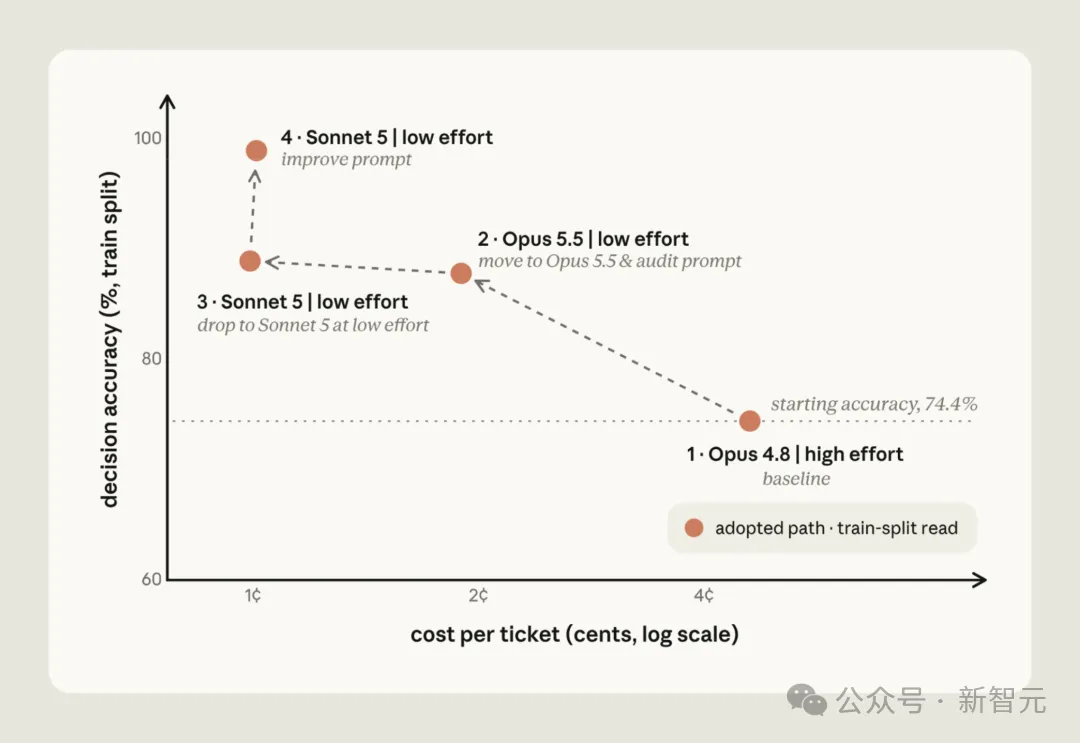
調整模型、思考強度與提示詞,改善精準率和成本。圖中為迭代整合績。
不過,這是一組特定配置、特定小樣本下的結果,並不意味著接上這套流程,你的應用也能省八成。
這裡比較的模型呼叫成本,也不能當成整個項目的總成本。
但這對於自己掏腰包付API費用的個人開發者來說,仍然很有吸引力。
畢竟便宜的模型如果老是答非所問,逼得使用者反覆追問,最後還要你人工介入,未必划算。
而簡單問題如果也用昂貴的配置,順帶生成一大段不必要的解釋,同樣可能花冤枉錢。
現在,你可以把回答質量和呼叫成本放在一起測試,讓AI在滿足質量要求的前提下,嘗試更省錢的方案。
不過,調優本身也要消耗模型呼叫費用。
先定好願意掏多少實驗費,再決定讓AI跑幾輪,才更踏實。
04. 把時間還給真正重要的事情
當這套自動化流程跑起來後,你就有機會少做一些重複的提示詞修補,把精力放回產品本身。
首先,是洞察使用者。
你覺得理所當然的操作,第一次打開應用的人可能連入口都找不到。你要做的,是把這些真實發生的困惑補充進題庫,AI的下一次最佳化才會更親民。
其次,是把控標準。
回答再客氣,沒解決問題,能算過關嗎?意思明明相同,只是換了種說法,評分器會不會誤判?
評分標準本身要是有漏洞,AI忙活半天,可能只是分數漲了,使用者的問題卻還在。
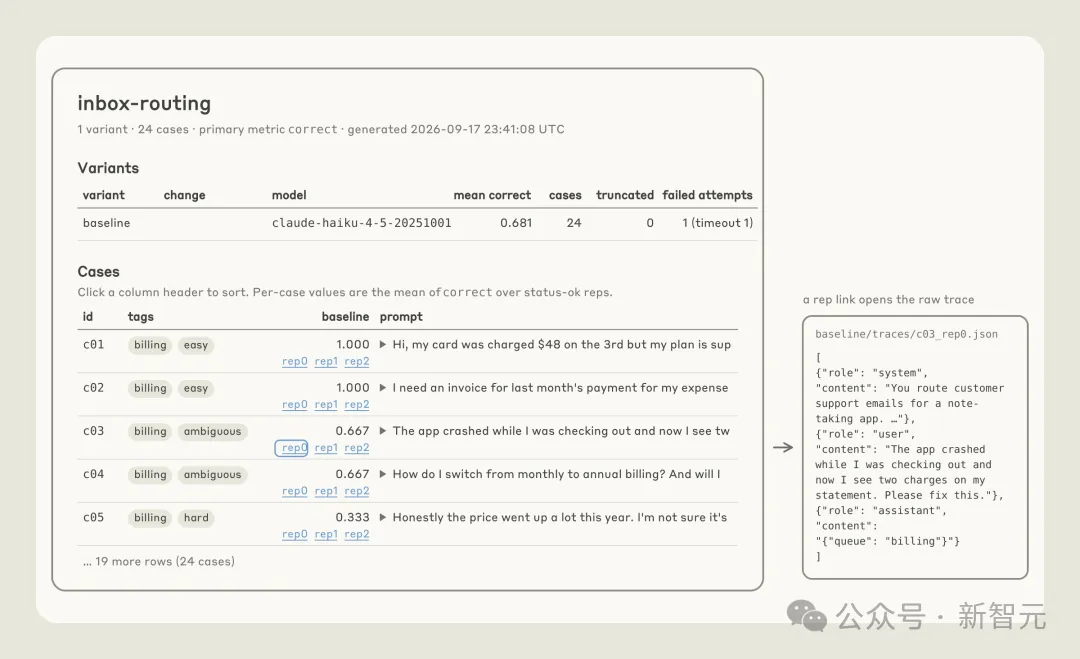
郵件分類評測:左側查看各題得分,右側回看模型輸入與回答,核查評分是否合理。
最後,是做權衡。
回答精簡會不會漏掉必要步驟?追求便宜會不會犧牲精準度?這些關乎使用者體驗的關鍵取捨,依然需要你來拍板。
給應用接入AI,初衷是為了省心。
如果最後演變成你全天候陪著它改答案,就本末倒置了。
當Claude能多接手一些重複偵錯,普通開發者就能多花時間打磨自己的小工具、小應用,讓那些擱置的想法重新往前走。 (新智元)