
剛剛,Anthropic 在工程部落格上發了一篇長文,講他們為什麼、又是怎麼把整個 monorepo 從 git 上遷走的。
原因在於這樣的一組數字:今年 5 月,Anthropic 平均每天合併約 2500 次程式碼變更;到了 9 月,這個數字已經超過了每天 3 萬次。
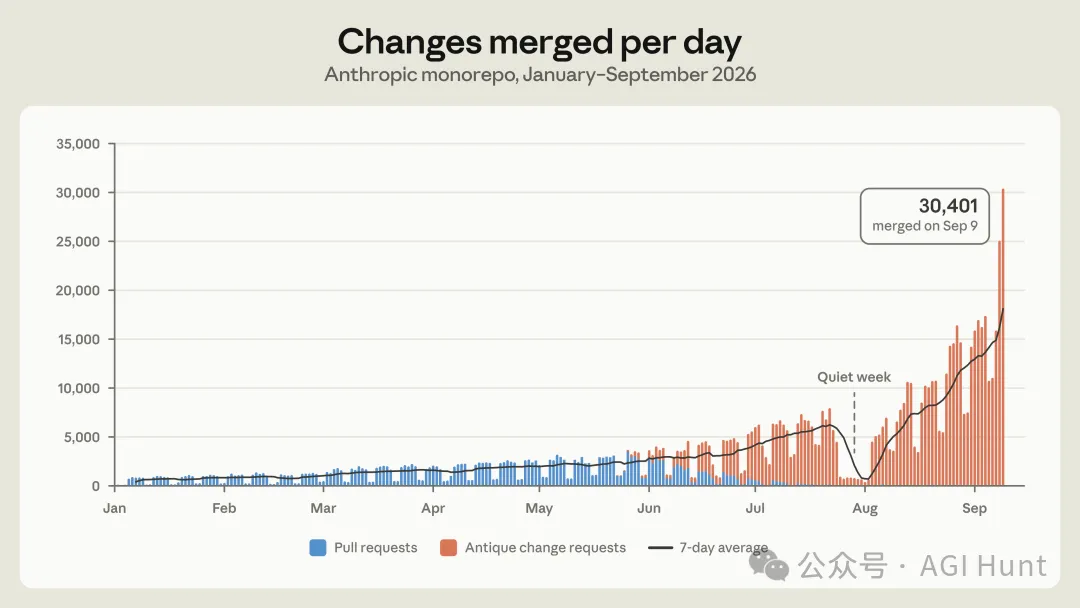
9 月 9 日這一天,單日合併了 30401 次。
按 24 小時平均下來,差不多每 3 秒就有一次程式碼合進主幹……
而這條曲線的推手,正是 Claude。Anthropic 在文章開頭寫道:
在 Anthropic,寫程式碼已經不再是建構系統和做研究的瓶頸。Claude 能夠自主迭代研究循環、對複雜程序做微觀最佳化、從零建構新服務,速度和規模都是我們前所未見的。現在的瓶頸,是所有那些為人類規模建構的開發者基礎設施:原始碼控制、建構和 CI。
其中的原始碼控制,用的正是 git。
於是 Anthropic 花了五個月,自研了一套版本控制系統 Scion,並把整個 monorepo 從 git 完整遷移了過去。
同一時間段裡,他們還做了程式碼評審工具 Antique、程式碼搜尋、一套細粒度的原始碼權限系統,以及一批管理和合入大量已評審程式碼的新辦法。
做完這些的,一共只有 7 個人。
01 3萬次合併
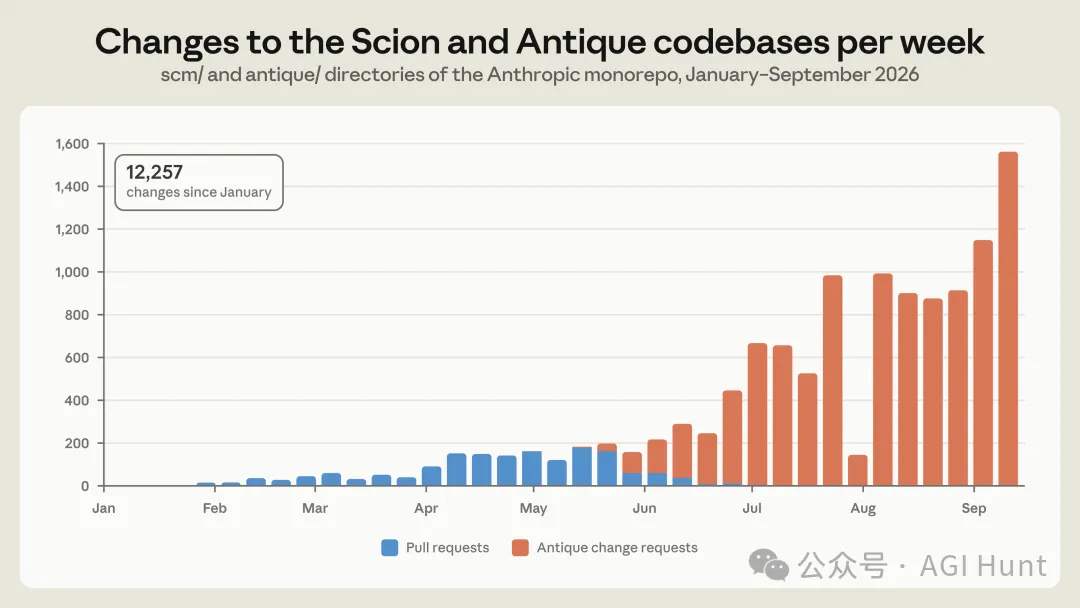
回到上面那張圖,從 1 月到 4 月,曲線一直在緩慢爬升,從每天幾百次漲到了兩千來次。
從 6 月開始,圖裡藍色的 Pull requests 迅速被橙色的 Antique change requests 取代,到了 7 月幾乎全是橙色,說明程式碼評審那時基本已經整體搬到了自研的 Antique 上。
7 月底、8 月初還有一周明顯的低谷,圖上標的是「Quiet week」,原文沒有多做解釋(大概是全員放假了?)。
而低谷過後,曲線幾乎是垂直往上衝的。
Anthropic 預計這個增速短期內不會放緩,因為合併程式碼的潛在需求幾乎是無限的,每移除一個瓶頸,程式碼產量就會立刻再往上漲一截。
他們也承認,這種負載非常特殊。
Anthropic 用 Claude 寫程式碼的程度幾乎超過任何一家公司,所以常常是第一個撞上「工具開始吃力」的地方,原始碼控制只是其中一個例子。
短期內不會有太多組織遇到同樣的問題,但他們認為,其他用 AI 寫程式碼的團隊用不了多久也會碰上。
02 git 為什麼扛不住
git 是一個分佈式系統,每一份 clone 都是一個完整、獨立的倉庫,離線也能算 diff、看歷史和 blame、checkout 任意版本。
對絕大多數倉庫來說,這個設計是對的,也是 git 能成為行業標準的重要原因。
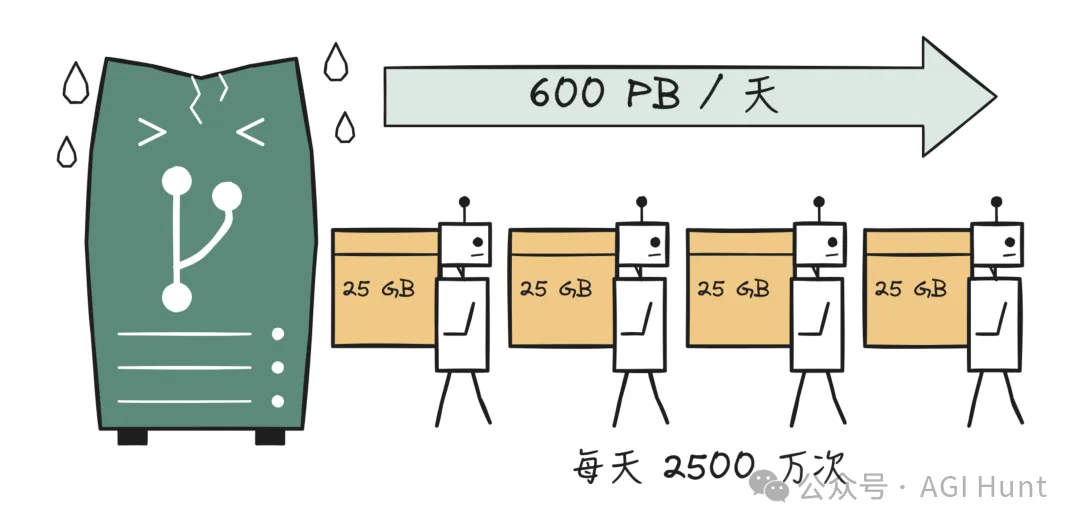
但 Anthropic 的 monorepo 已經越來越不適合這個設計了。僅 main 分支的歷史就接近 100 GB,壓縮後的工作副本超過 25 GB。
光 CI 每天就要 checkout 程式碼約 2500 萬次,這還沒算開發環境、Agent 沙箱和研究任務。
如果每次都老老實實全量拉取,每天的 git 流量會超過 600 PB。
git 本身有 shallow clone、sparse checkout、promisor remote 這些只取倉庫一部分的手段,業內對付大型 monorepo 也有成熟的套路,比如內部 git 鏡像,以及放在 blob 記憶體裡的倉庫快照(seed)。
Anthropic 把這些全都用上了,高峰時營運著幾百台內部 git 鏡像來扛負載。
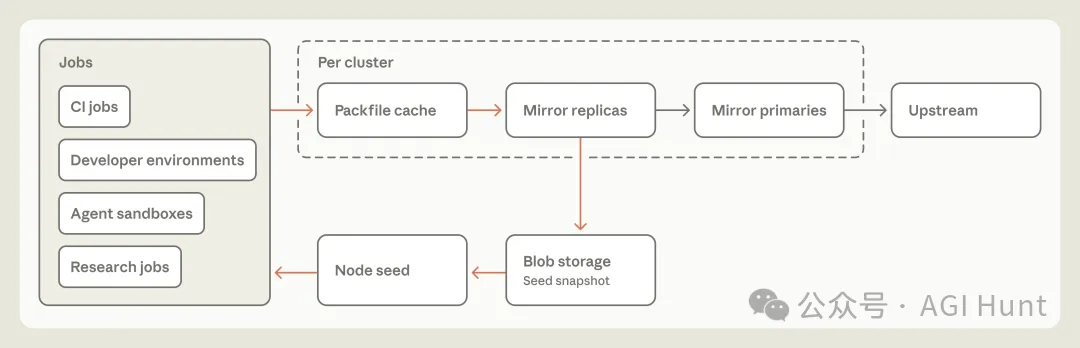
git 擴展方案
這些辦法確實爭取到了一些時間,但合併速度越漲,維護起來就越難。
兩次刷新之間,seed 離 main 的最新提交越來越遠;diff、blame 這類依賴歷史的操作,要在 partial clone 上保持正常工作,也越來越費勁。
後來他們退一步看,才發現自己和大多數公司一樣,其實是把 git 當成「只有一份權威副本」的中心化系統在用,而幾乎所有客戶端都是 Agent 和各種任務,天然就是線上的。
git 最擅長的分佈式、離線工作,在倉庫變大之後,反倒成了擴展的阻礙。
那麼問題就變成了:如果從一開始就假設 Agent 永遠線上,原始碼控制應該是什麼樣子呢?
03 Scion 的設計原則
超大 monorepo 的原始碼控制是有先例的,比較有名的是 Google 的 Piper 和 Meta 的 Sapling,Scion 也借鑑了它們用大量踩坑換來的經驗。
在此基礎上,Anthropic 定下了幾條和 git 截然不同的原則。
這幾條原則都從同一個前提出發:客戶端永遠線上。
git 假設客戶端要離線工作,所以每個人手裡都得有一份完整的倉庫;Scion 則圍繞一個始終可達的伺服器端來設計,需要什麼資料,客戶端再去取什麼。
這也就帶來了客戶端和伺服器端的不對稱。
在 git 裡,每個客戶端都有能力當一台完整的伺服器;而在 Scion 裡,查歷史和 blame、建立提交、做 merge 和 rebase,統統由伺服器端完成。
客戶端只維護一個有上限的本地對象快取,把工作副本的檔案放到磁碟上,監聽檔案系統的變化,再給使用者提供一套好用的操作方式。它自己幾乎算不了什麼,換來的是本地需要的資料少得多。
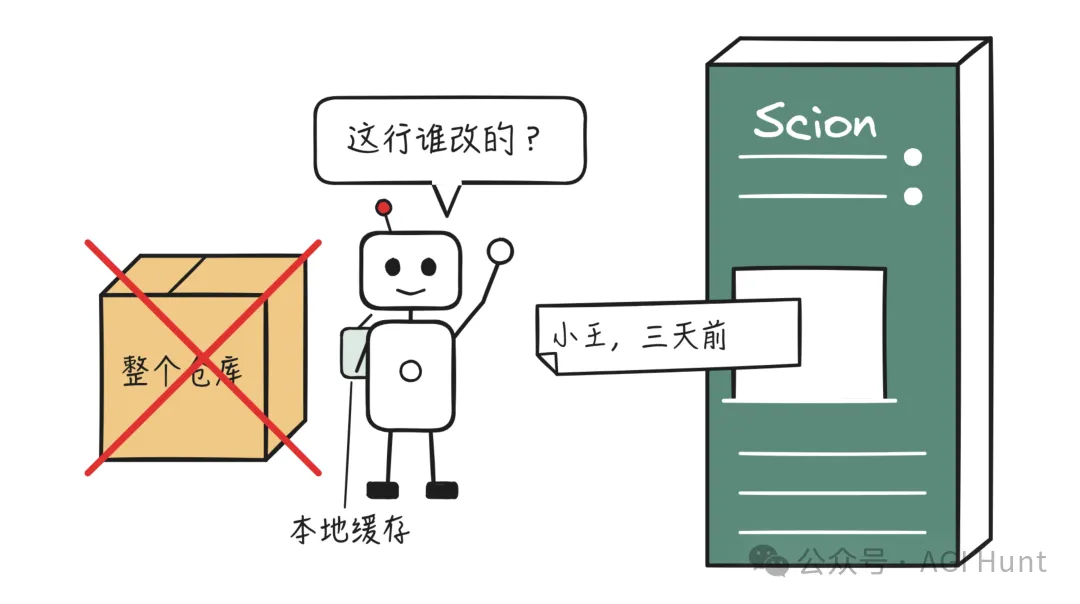
伺服器端既然什麼都能回答,也就可以直接開放成 API。
用 git 的時候,CI 任務或工具想知道「這行程式碼最後是誰改的」「這兩個提交是什麼關係」,要麼自己維護一份本地倉庫,要麼指望託管平台剛好提供了對應的 API。
在 Scion 裡,客戶端用到的所有查詢都以 API 形式開放,很多任務根本不需要本地倉庫。
Anthropic 內部的自動 bisect 和自動 revert 流水線,沒有這種低成本、可程式設計的訪問方式,規模一大就不現實了。
所有元件也都必須能水平擴展。
前面那幾百台 git 鏡像,一旦倉庫大小超過鏡像的磁碟或記憶體上限,就再也擴不動了。
Scion 的倉庫資料是分佈式記憶體的,每個元件都能獨立擴展,任何地方都不存在一份完整的倉庫,伺服器端上也沒有。
Scion 裡也沒有 packfile 這類東西,所以不需要做倉庫維護。
提交則要便宜、增量、無鎖。
git 是先在本地 commit 再 push;Scion 的每次 commit、rebase、merge 都發生在伺服器端,沒有什麼需要 push 的,但每個操作都必須夠快。
建立一個提交、更新它下游資料結構的開銷,必須跟改動的大小成正比,而跟整個倉庫的大小無關,否則伺服器端就跟不上。
也因此,Scion 的開發流程不鼓勵使用 ref(main 和發佈分支除外),因為需要所有伺服器達成一致的全域狀態,遲早會成為擴展上的隱患。
最後,工作副本是可選的,而且天生稀疏。
每天幾千萬次 checkout,能省則省:CI 想要某個提交和它 merge base 之間的 diff,直接問伺服器端就行,很多寫操作也可以跳過 checkout,全程走 API。
真需要把檔案放到磁碟上時,Scion 的協議以 sparse checkout 和虛擬化 checkout 為核心,前者只包含客戶端要的目錄,後者在檔案被讀到時才落盤,客戶端只為它真正讀到的內容付出成本。
04 changeset 與派生資料
Scion 裡的基本單位叫 changeset,是預寫日誌裡的一條記錄,存的東西和 git 的 commit 大體相同。
只不過 git commit 存的是指向整棵樹的指針,而 changeset 存的則是相對於第一個父提交改了那些檔案,以及指向 blob 記憶體中壓縮檔案內容的內容定址指針。changeset 在伺服器端建立,建立好之後立刻處處可用。
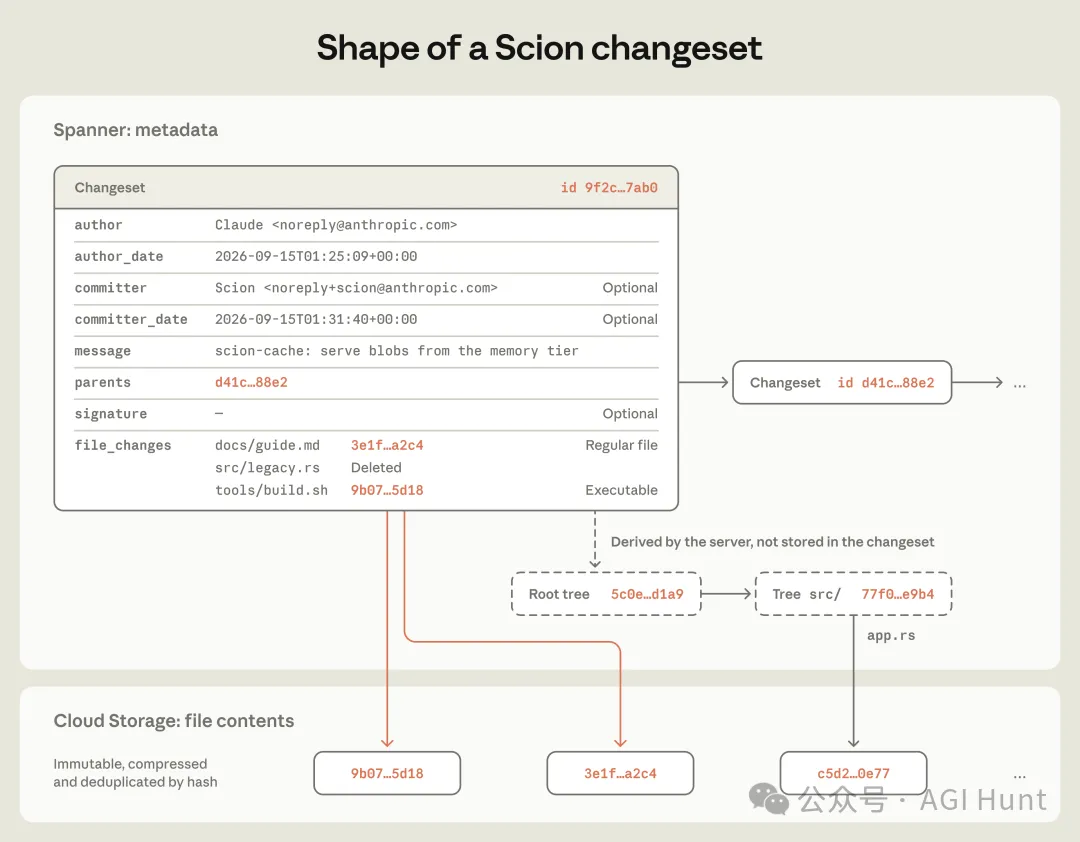
(示例裡這條 changeset 的 author 一欄,寫的正是 Claude……)
沒有 packfile 要接收,沒有鎖和跨伺服器協調,也沒有 ref 要移動,所以 Scion 接收 changeset 的吞吐量可以做得非常高。
Scion 技術上也支援 ref,但建立和獲取提交都不涉及 ref。
移動一個 ref,只是對 Spanner 裡的單行資料做一次 compare-and-swap,跟建立 changeset 是分開進行的。
只記錄改動,也就意味著單靠 changeset 本身,沒法快速回答「這一行最後是誰改的」「那些提交動過這個檔案」這類問題。
為此,Scion 會在 changeset 之上再建構一批資料結構,比如專門用於 blame 和路徑歷史的結構,以及提交圖的跳錶。
凡是不直接屬於 changeset 的,都叫「派生資料」,統一由一套通用機制來計算。
每種派生資料都是遞迴定義的,某個 changeset 上的值,由它的父提交上的值算出來。
這樣做有三個好處。想讓某個操作更快,加一種新的派生資料就行;每一種都可以選擇立即計算還是推遲計算,不需要的資料就不去物化;而客戶端看不到這些資料結構的內部,最佳化它們也不用改客戶端。
隨著系統增長,他們已經加過很多次新類型,比如用來做複製檢測、按路徑搜尋檔案的新索引。
05 三層快取
一小組 Scion 伺服器對外提供客戶端需要的所有原始碼控制 API,比如獲取 changeset、計算 diff、尋找 merge base、獲取 blob。
所有資料都是內容定址的,存進去就不會再變,任何一台伺服器都能快取,不用和其他伺服器核對。
所以這些伺服器可以水平擴展,幾乎不需要協調,說到底就是一組大快取,同時還能現場計算派生資料,再寫回 Spanner。
遷移早期,在還沒有自己的客戶端、倉庫格式和協議的時候,Scion 只回答提交祖先關係、blame 這類「中繼資料」查詢,這已經幫 CI 和各種工具省掉了自己拉取、維護倉庫的大量負擔。
而獲取檔案內容、生成工作副本,資料量要大得多,需要單獨設計。
Scion 的客戶端叫 scn,它的拉取協議和 git 有幾處關鍵的不同,伺服器端因此比 git 伺服器省下了大量 CPU。
git 協商時,客戶端要告訴伺服器端自己已經有了什麼;scn 則只說自己要什麼。
它從根樹開始,檢查本地缺了那些 tree 並遞迴請求,再對 blob 重複一遍。
每個請求都對應一個永遠不會變的具體對象,任何一層快取都能應答,整個架構和傳統的分層快取非常相似。
沒有動輒幾個 GB 的單個 packfile 響應,過程高效,也能斷點續傳。sparse 乃至虛擬化 checkout 也不需要特殊支援,客戶端不請求它不要的樹就行了。
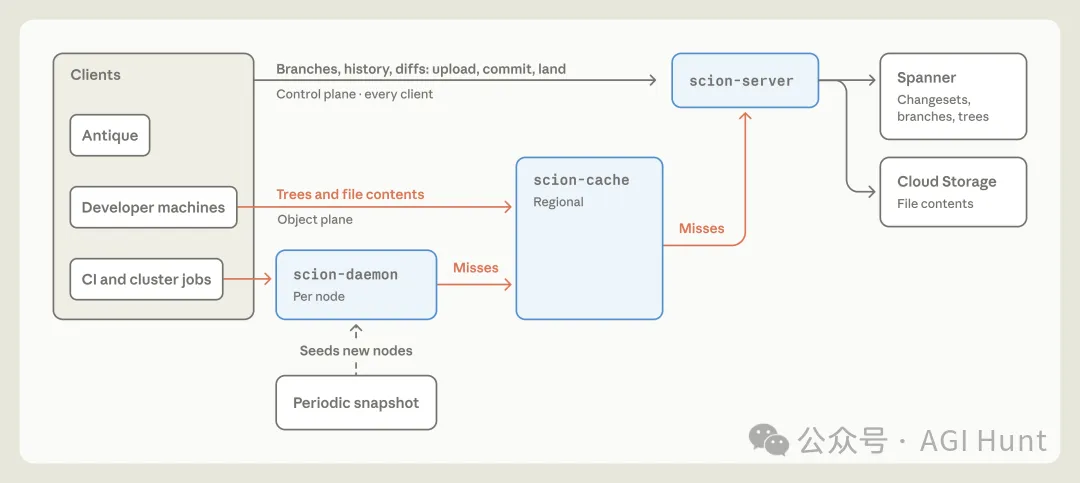
在叢集裡,客戶端通過 socket 和一個叫 scion-daemon 的守護處理程序通訊,由它為整個節點記憶體對象,畢竟同一節點上的任務大多會復用相同的對象。
每個 daemon 從一份定期刷新的快照啟動,之後只和所在區域的快取伺服器 scion-cache 通訊。
scion-cache 直接從記憶體裡以 daemon 可以直接使用的磁碟格式流式傳送對象,不用計算客戶端缺什麼,也不用做 delta 壓縮。
快取裡缺了某個對象,才去問權威的 scion-server,後者再按需讀取 Spanner 或雲端記憶體。
三層都響應同一套 RPC,客戶端不需要知道快取的拓撲結構。
理論上任意兩層都能直接通訊,但他們嚴格執行分層,用來隔離故障域,避免某個區域的 scion-cache 出了故障,把上游的 scion-server 沖垮,進而拖垮整個系統。
最終,每一層的快取命中率都在 99% 以上,而且不需要長期保存狀態,擴容很容易。
Scion 基礎設施的 CPU 和記憶體佔用,只有之前 git 鏡像方案的 1/200。
CI 和研究任務的 checkout 快了兩個數量級,從分鐘級變成了秒級,整個叢集因此空出了一大塊算力,光 CI 就拿回了 25% 的 CPU 容量。
客戶端和快取都不需要做倉庫維護,任務的生命周期管理也簡單了不少。
落到日常命令上,對比是這樣的:
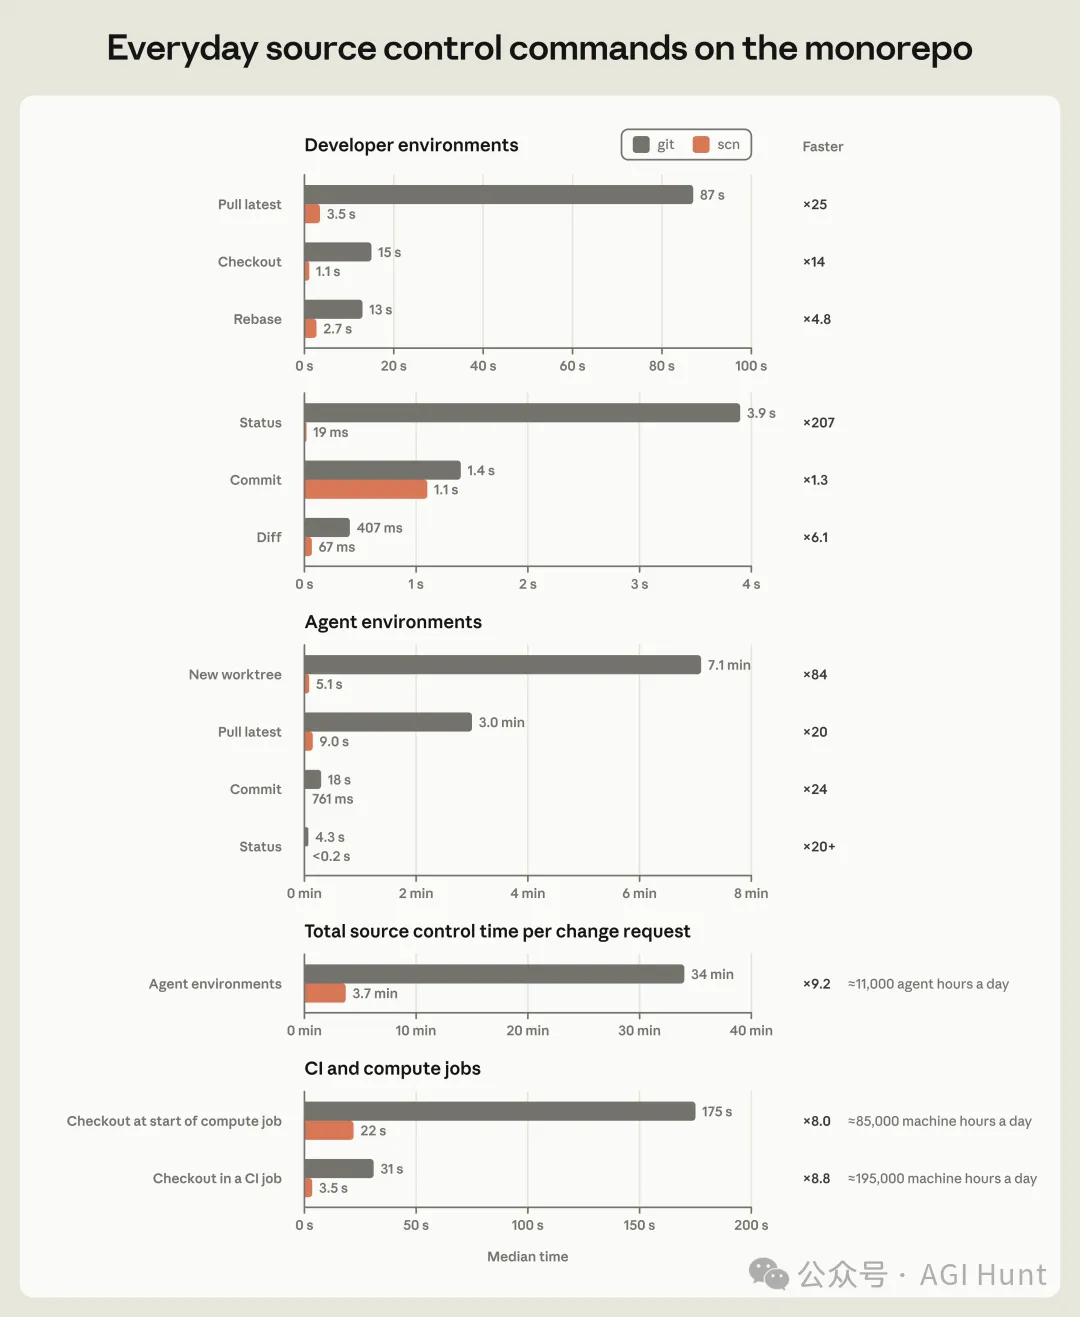
開發環境裡,status 從 3.9 秒降到 19 毫秒,快了 207 倍,拉取最新程式碼則從 87 秒降到 3.5 秒(開發機上的 commit 倒是沒怎麼變,1.4 秒到 1.1 秒……)。
Agent 環境裡,新建一個 worktree 從 7.1 分鐘降到了 5.1 秒。
算下來,Agent 每提交一個變更請求,花在原始碼控制上的總時間從 34 分鐘降到了 3.7 分鐘,相當於每天省下約 1.1 萬個 Agent 小時。
計算任務開始時的 checkout 和 CI 任務裡的 checkout,也分別快了 8 倍和 8.8 倍,兩項加起來,每天省下約 28 萬個機器小時。
06 7 個人,5 個月
Scion 開工的時間,差不多正好是 Claude Mythos Preview 和 Claude Tag 在 Anthropic 內部上線的時候。
這兩者一邊放大了對 Scion 的需求,一邊也大大加快了 Scion 的開發速度。
今年早些時候,團隊基本是手寫了第一版從 git 匯入 Scion 的資料管道,作為原型,他們自認為寫得還不錯……直到拿到了 Claude Mythos Preview 的一個早期內部快照。
他們讓它把整個管道重寫一遍,沒有給任何額外的指示,它交出的版本記憶體佔用只有原來的 1/20,速度快了 4 倍,同時還保住了匯入順序和資料結構上那些沒寫明的不變數。
下圖是 Scion 和 Antique 兩個程式碼庫每周合併的變更數,今年以來累計 12257 次,9 月最多的一周超過了 1500 次。
Scion、Antique,再加上另外六個左右的相關系統,是一個 7 人團隊在 5 個月裡做完並完成遷移的,而同期每天合併的程式碼量還漲了 10 倍(原文還特意提了一句,Antique 本身就值得再單獨寫一篇部落格)。
Anthropic 認為,放在過去,開發和部署這樣一套原始碼控制系統,一家公司要投入多得多的工程師,花上好幾年做漸進式的遷移。
而這種小團隊的快速遷移,以後會越來越常見。
07 工程師的活
參與這個項目的所有工程師,現在都認為 Claude 寫程式碼比自己強。
但工程師依然不可或缺。他們提供的是對系統之間高層元件的理解,以及設計層面的取捨,判斷要解決那些問題、系統要撐到多大的規模。
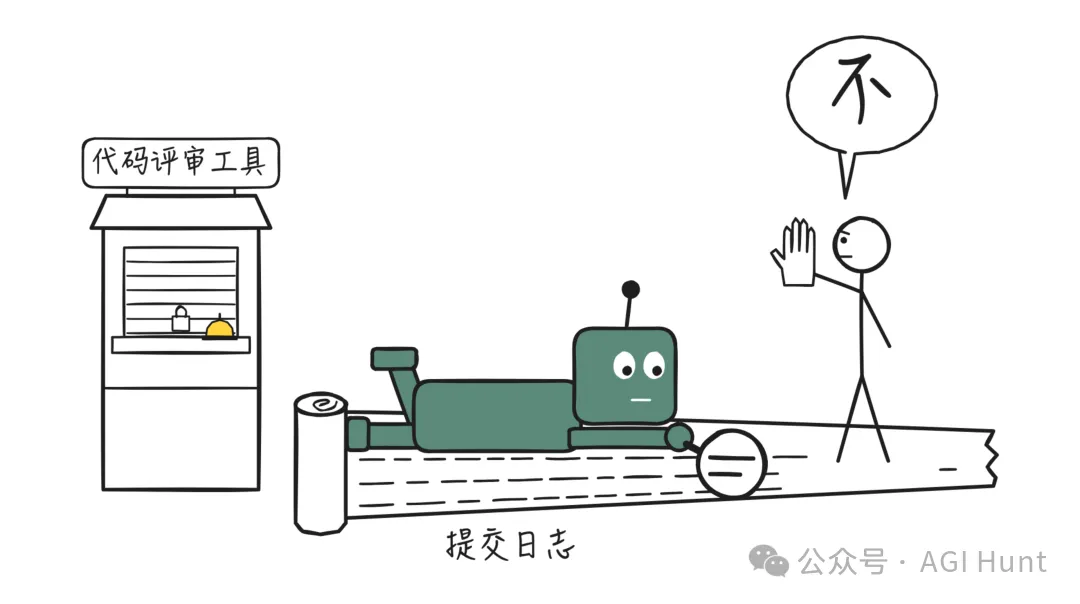
而很多時候,工程師的工作,就是對 Claude 說「不」。
Agent 有時會為了滿足某種本就不該被允許的模式,去違反系統的核心約束,這在遷移過程中尤其常見。
比如有好幾個系統想知道某個變更是什麼時候合進 main 的,不去問程式碼評審工具,而是暴力地把提交日誌線性讀一遍。
Anthropic 內部還大量使用對抗式評審。這在很多方面非常有效,但也可能目光短淺,需要有經驗的工程師把 Claude 拉回來,別為了一些假想的風險過度設計。
有一次評審對另一個內部服務的信任過於保守,結果 Claude 就加了一堆多餘的總和檢查碼複雜度。
現在團隊依然會評審這個系統的每一個變更請求,只是看的是變更的意圖,不再逐行讀程式碼。
也正因為 Claude 能以遠超人類的速度寫出大量程式碼,Scion 成了他們做過的測試最充分、防護最嚴密的程式碼庫之一。
即使工期很緊,他們也為遇到過的每一種稍複雜的基礎設施和原始碼控制互動都搭建了封閉式模擬,另外還做了 fuzzing 和精細的限流。
Claude 還會隨手找出一些重大最佳化,比如發現某個祖先查詢的演算法沒用上一個索引,這種問題專家得花幾天甚至幾周去分析調優……然後第二天,它又這麼來了一遍。
安全上,Scion 支援倉庫級的細粒度存取控制,還能給單個目錄設定權限,把最敏感的程式碼保護起來,同時不丟掉 monorepo 的好處。
配套的程式碼評審工具則能對審批設定複雜的語義約束,比如區分只改註釋的變更和敏感的邏輯變更,讓人類評審者把精力放在最要緊的改動上。
維運上,團隊重度使用 Claude Tag。
他們建了一些 Slack 頻道,讓每個頻道里的 Claude 只專注於一個元件的健康狀況,並管這些 Claude 叫「superfan」。
scion-daemon 有一個 superfan,scion-cache 有一個,Antique 的合併佇列也有一個……它們能訪問遙測資料和日誌,就像一個除了刷新圖表、找異常之外無事可做的資深工程師。
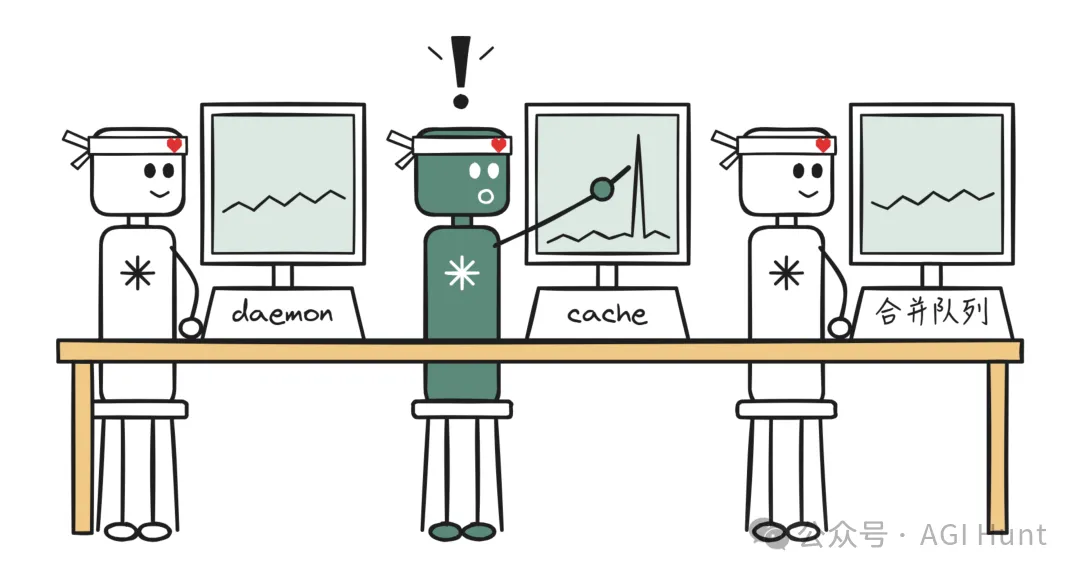
傳統告警當然也都還在,但 superfan 能發現那些細微而新奇的問題,相比之下,傳統告警就顯得太單一了。
這個項目也讓他們重新審視了其他為人類規模設計的流程,比如合併佇列,在 Agent 規模下就沒什麼意義了。
測試還在跑的時候,可能已經有成百上千個變更合了進去,那 CI 到底還意味著什麼呢?
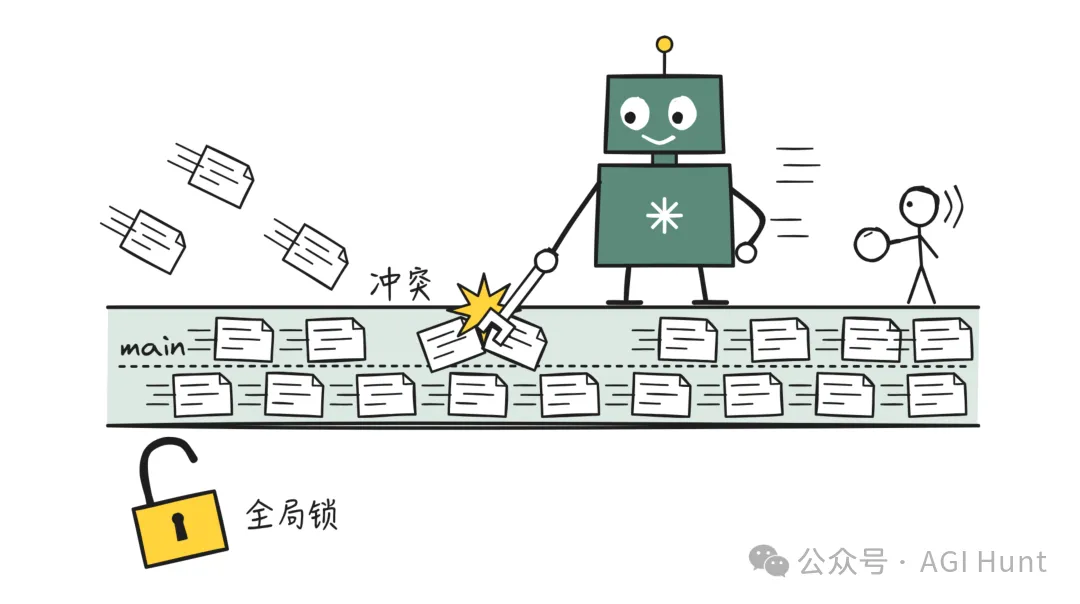
業界的標準做法,是在合併佇列上加一把全域倉庫鎖,而他們沒能有效復刻這一套,於是轉而把精力投到了合併後、部署前的自動化測試上。
這確實意味著並行的變更可能會衝突,但 Claude 修衝突的速度,通常比人類發現衝突還快。
08 不打算開源
Anthropic 在文中明確表示,Scion 絕不是 git 的通用替代品。
這些設計只對真正巨大的 monorepo 有意義,要麼有數萬名工程師,要麼有成群的 Agent 在大量寫程式碼。
而且 Anthropic 本身也很特殊,內部花在 token 上的錢,遠超任何一家正常企業願意花的數目,一來是滿足自己的開發需要,二來也是在測試 Claude 的能力。
至於為什麼不對外提供,是因為 Scion 和 git 差異太大,別的公司要用,就得把整個開發流程都遷過去,還要配套它自己的程式碼評審、程式碼搜尋和 CI。
這些內部元件都高度定製,別人很難直接拿來用,而做一個想討好所有人的公開版本,大概也不會真的好用。
但他們預計,未來 6 到 12 個月裡,這類問題會變得越來越普遍,讓每家用 git 的公司各自去扛,是對工程資源的浪費。
所以他們選擇把思路分享出來,讓其他開發者可以把 Scion 最成功的部分用到 git 上,而不必放棄 git 的整體模型。
原文給了這樣一些方向:
• git 伺服器端不必和客戶端用同樣的方式工作,已經有新的伺服器端架構能顯著提升擴展性
• git 平台可以像 Scion 那樣提供全面的伺服器端 RPC,甚至在各家程式碼託管平台之間形成標準,讓 git 客戶端學會去呼叫
• 協商協議也不必是現在這個樣子
• git 裡各種 sparse 和 shallow 功能,可以做到更好地組合使用
文末,Anthropic 也表示,git 社區花了近 20 年為數百萬開發者擴展這個平台,相比之下,他們的貢獻要窄得多。
他們只是分享一些對「Agent 寫程式碼如何衝擊這些系統」的早期觀察,希望和 GitHub、GitLab 以及開源社區一起,去支援開發者正在變化的需求。
X 上已經有人把這條曲線和 GitHub 最近頻繁出故障聯絡到了一起……
而如果 Anthropic 那個 6 到 12 個月的預判沒錯,接下來要為這種增長頭疼的,大概就不只是 Anthropic 自己了。(AGI Hunt)